
2026年7月、Eduard Paul Enoiu氏はAI支援テストにおける過信を論じた論文「(Over)Reliance on Test Agents in AI-Assisted Software Testing」を公開しました。同時期に発表された「Why Do AI Agents Systematically Fail at Cloud Root Cause Analysis?」は、クラウド障害分析エージェントを1,675回実行した分析から12種類の失敗パターンを報告しています。国際AI安全性報告書2026も、AIエージェントは外部システムへ直接作用できるため、失敗の影響が通常の文章生成より大きくなり得ると整理しました。
AIエージェントに調査、テスト、分析を丸ごと任せる実験は、短時間で多くの作業を進められる一方、目的の取り違えや根拠の弱い判断を見逃しやすくなります。本記事の「失敗談」は、特定企業や個人の体験談を創作したものではなく、これらの研究が報告した失敗パターンを「実験で起きる失敗」として整理したものです。
企業のIT・事業責任者にとって重要なのは、エージェントが答えを返したかだけで実験を成功と判定しないことです。目的、調査範囲、使ったデータ、ツール呼び出し、途中の失敗、最終判断を人が追える設計にしなければ、丸投げは自動化ではなく検証不能な作業の増加になり得ます。
※本記事は2026年8月時点の情報です。
「丸投げ」の危うさ|この記事で扱うのは研究が示す実験パターン
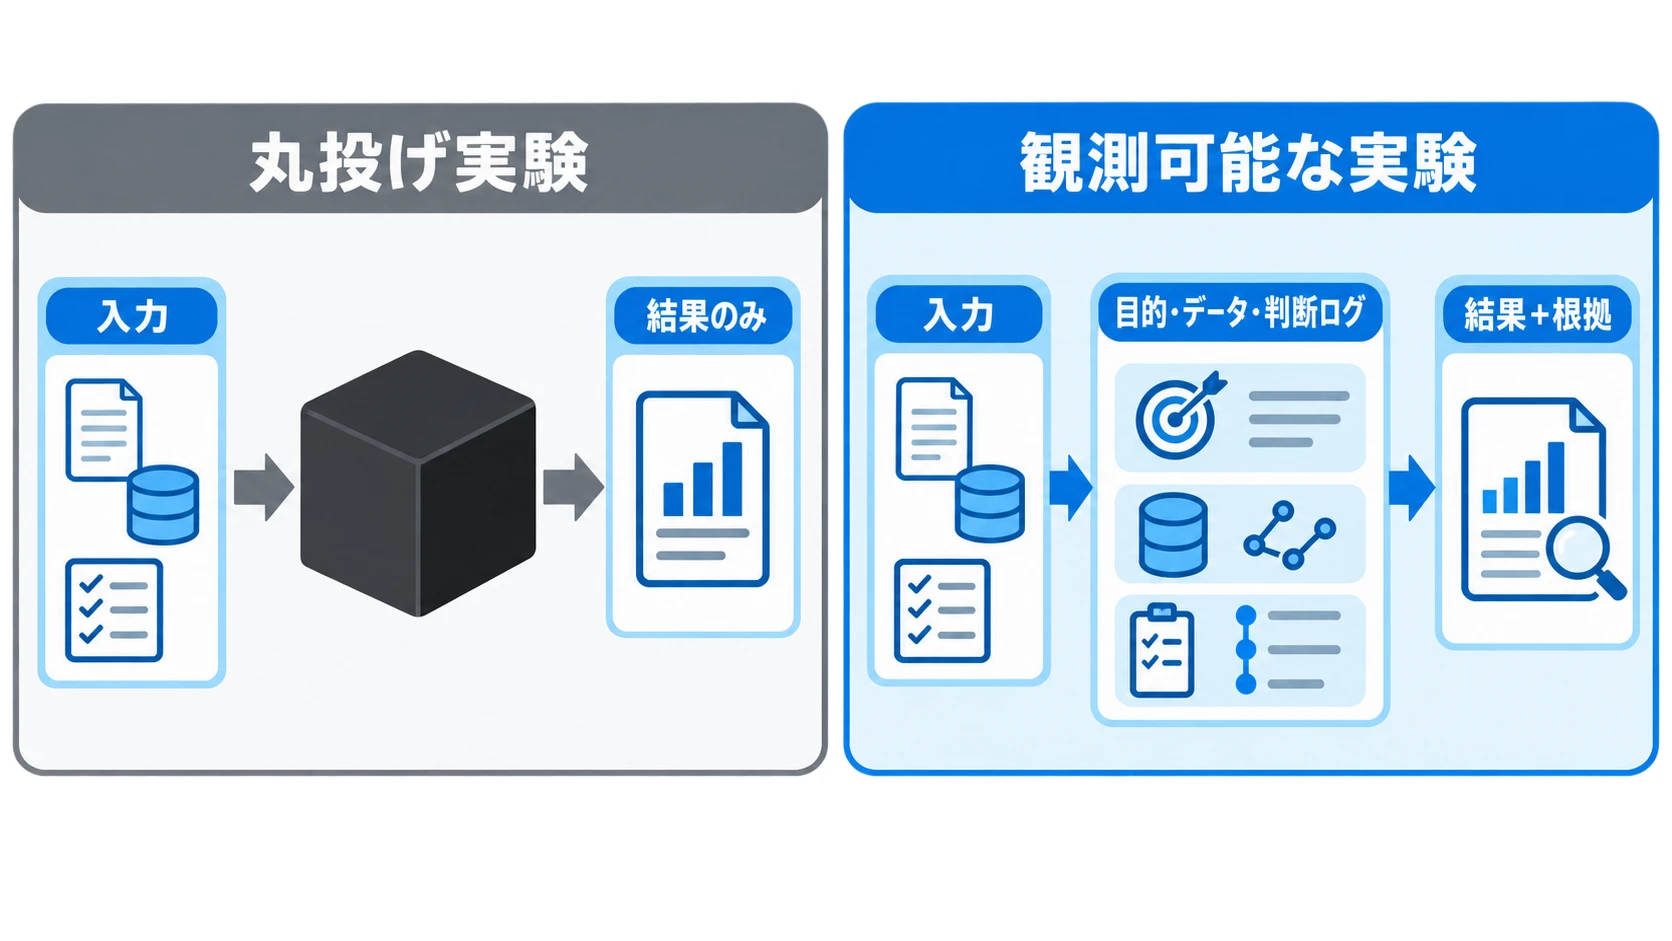
AIエージェントへ「調べて」「テストして」「原因を特定して」とだけ依頼し、返ってきた要約をそのまま採用する状態を、ここでは丸投げと呼びます。問題は、エージェントが一度でも誤ることではありません。どの目標を選び、どのデータを見て、どの仮説を捨て、どの根拠で結論を出したかが確認できないまま、結果だけを人の判断材料にすることです。
結果が返ったことと、根拠が十分なことは別です
国際AI安全性報告書2026も、AIエージェントは外部システムや現実世界へ直接作用できるため、通常の文章生成より失敗の影響が大きくなり得ると整理しています。マルチエージェントでは、あるエージェントの誤りが別のエージェントへ伝わり、協調の失敗や相関した失敗につながる可能性もあります。したがって、実験の評価対象は最終回答だけでなく、行動の過程まで含める必要があります。
実務でAIエージェントの本番運用を検討する場合は、AgentOpsの可観測性・評価・監視の考え方も参考になります。実験段階からログと評価を残しておくと、本番移行後に「なぜ成功したか」「どこで失敗したか」を追いやすくなります。
ポイント
実験の成否は最終回答の有無ではなく、目的選択・データ・仮説破棄・根拠の過程を人が追跡できるかで判断します。
AI支援テストの研究|過信は「答え」だけでなく目標や証拠にも起きる
2026年7月公開の論文「(Over)Reliance on Test Agents in AI-Assisted Software Testing」は、AIを使ったテストで、エンジニアがエージェントの出力を十分に吟味せず信頼する問題を、監督と保証の問題として論じています。この論文は特定製品の事故率を測った実証調査ではなく、過信を調べるための枠組みと分類を提案する研究です。そのため、以下は一般企業の失敗率ではなく、実験で確認すべき観点として読む必要があります。
| 過信が起きる場所 | 実験で起きること | 人が確認する問い |
|---|---|---|
| テスト目標 | エージェントが選んだ目標を、そのまま正しいと扱う | 本当に検証すべきリスクを選んでいるか |
| 戦略・主張 | 採用したテスト方法や「このテストで証明できること」を疑わない | 別の方法や反例を検討したか |
| 証拠・実行結果 | ログ、カバレッジ、要約だけで十分だと判断する | 失敗、スキップ、未確認範囲を直接見たか |
| 委任・再生成 | 別エージェントの作業や、更新されたテストが目的を保ったと信じる | 委任先の成果と、元の意図を照合したか |
論文が挙げる過信の対象には、テスト目標、テスト戦略、主張、理由、証拠、実行結果、期待結果、委任、再生成、エスカレーション、保守などがあります。つまり、丸投げの危険は「AIが間違った答えを出す」だけではありません。正しそうな説明や見栄えのよいテスト成果物が、人の検証を通らずに保証の根拠へすり替わることも含みます。
この論点は、AIが生成したコードの品質を確認するときにも共通します。AI生成コードとコード品質を考える際も、動いたかどうかだけでなく、要件に沿っているか、保守できるか、レビュー可能な証拠があるかを分けて評価することが大切です。
ポイント
過信はAIが誤答することだけでなく、目標・戦略・証拠・委任結果を人の検証なしに保証根拠として扱うことでも起きます。
クラウド障害分析の研究|1,675回の実行で見えた12種類の落とし穴
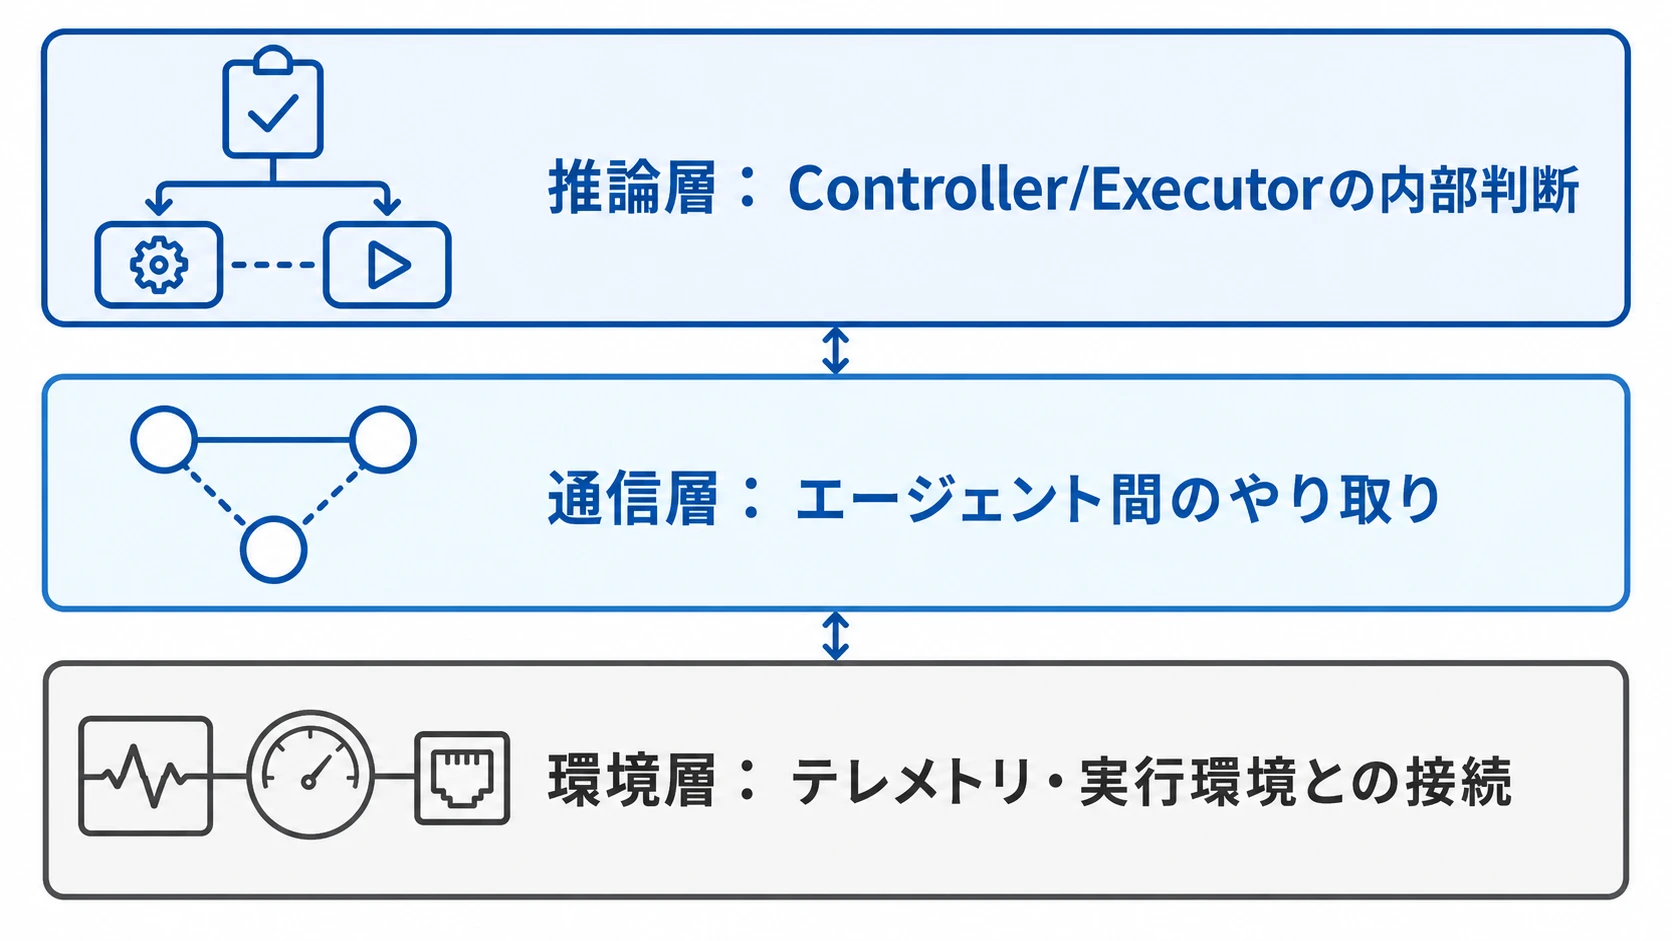
「Why Do AI Agents Systematically Fail at Cloud Root Cause Analysis?」は、OpenRCAベンチマークを5つのLLMで実行し、335件の障害タスク、1,675回のエージェント実行を分析した研究です。著者らは、失敗をエージェント内部の推論、エージェント間の通信、エージェントと実行環境の相互作用に分け、12種類のピットフォールに分類しました。
| 層 | 主な失敗パターン | 実験での確認ポイント |
|---|---|---|
| 推論 | データの解釈を作り込む、探索範囲が狭い、症状を原因と取り違える | 複数の指標・ログ・トレースを見て、別の仮説を検証したか |
| 推論・実行 | コード生成エラー、テレメトリ不足、時刻のずれ、クロスチェック不足 | 実行コード、対象期間、参照データ、未取得データを記録したか |
| エージェント間通信 | 指示とコードの不一致、意味のない反復、証拠の取り違え | 要約だけでなく、コード・エラー・前回結果を共有したか |
| 環境 | メモリ不足、ステップ上限の消費 | 資源上限と停止条件を設定し、再実行の条件を決めたか |
この研究では、データ解釈の幻覚が71.2%、探索不足が63.9%の実行で観察されたと報告されています。ただし、これは5モデル・特定ベンチマーク・研究者が定義した判定方法における割合であり、AIエージェント全般の失敗率ではありません。それでも、モデルの能力を上げれば解決するとは限らず、共有するエージェント構成そのものがボトルネックになり得るという示唆は、実験設計に役立ちます。
著者らの緩和実験では、プロンプトへの追加指示だけでは主要な解釈エラーを解消できませんでした。一方、ControllerとExecutorの間でコード、完全な実行結果、例外、前回の出力などを共有する通信方式では、モデルによって通信関連の失敗が最大約15ポイント低下したと報告されています。改善の大きさは構成や評価条件に依存するため、自社の実験で再検証する必要があります。
エージェントを複数つなぐ場合は、MCPのステートレス化と接続設計のように、セッション、権限、ツール呼び出しの境界も確認します。失敗の原因がモデルなのか、通信なのか、ツールや環境なのかを切り分けられる設計が必要です。
ポイント
プロンプト改善だけでは主要な解釈エラーは解消されず、コード・実行結果・例外を共有する通信設計が失敗の切り分けに役立ちます。
実験を安全に区切る方法|丸投げではなく、観測可能な委任にする
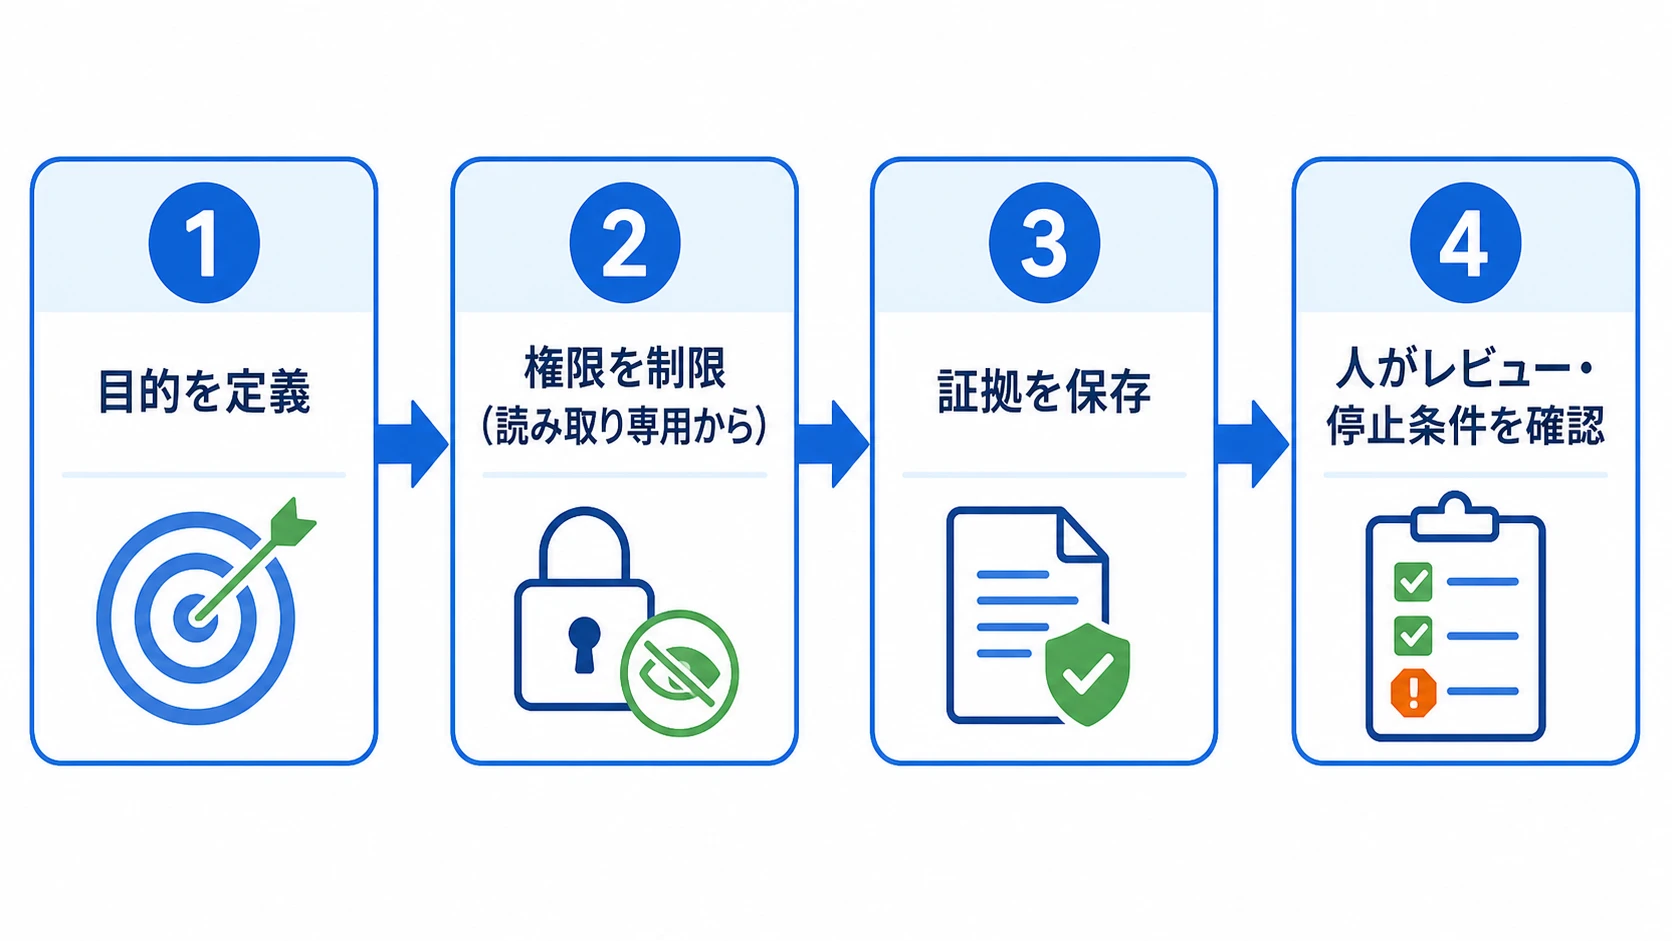
最初に決めるのは、何を任せるかより、どこで止めるかです
実験では、エージェントに任せる範囲を広げる前に、成功条件と中止条件を固定します。たとえば、読み取り専用のデータ、限定したサンドボックス、少額のテスト用アカウントから始め、外部送信、データ更新、権限変更、金銭や顧客に影響する操作は人の確認を必須にします。国際AI安全性報告書2026も、限定されたサンドボックスで失敗モードを分析してから広げること、ツールや他エージェントとの相互作用を監視することを緩和策の例として挙げています。
- 目的:検証する業務仮説と、エージェントが答えてはいけない範囲を一文で定義する
- 証拠:入力データ、検索範囲、ツール呼び出し、コード、エラー、未確認範囲を保存する
- 比較:人手・通常の自動化・単一エージェントなどのベースラインと同じ指標で比べる
- 権限:まず読み取り専用にし、書き込みや外部送信は操作単位で承認する
- 停止:予算、実行時間、ステップ数、失敗回数、異常なデータ移動に上限を置く
- レビュー:最終回答ではなく、目標・仮説・反証・証拠・判断を人が確認する
成功指標も、処理時間の短縮だけにしない方が安全です。正解率、見落とし率、誤った自動操作の件数、手動介入の割合、再現性、調査コスト、ログから原因を追える割合を組み合わせます。研究段階で「速く動いた」ことと「業務に任せられる」ことを分ければ、デモの成功を本番の成功と取り違えにくくなります。
ポイント
読み取り専用・限定サンドボックスから始め、権限・停止条件・レビュー対象を成功指標とセットで決めてから実験範囲を広げます。
まとめ|AIエージェント実験は「任せた量」ではなく「検証できた範囲」で評価する
AIエージェント実験の失敗は、派手な暴走だけではありません。目的の選択を疑わない、調査範囲を狭める、症状を原因と呼ぶ、要約を証拠として扱う、委任先の結果を確認しないといった小さな省略が、最後の結論を弱くします。今回参照した研究は、こうした失敗を分類し、どこで起きたかを見えるようにする重要性を示しています。
導入時は、まず限定環境・限定権限・明確な評価指標で試し、エージェントの行動と失敗を記録します。プロンプトを改善するだけでなく、データ、ツール、通信、監督、停止手段を含むシステムとして設計することが、丸投げを避ける現実的な出発点です。
ポイント
AIエージェント実験は「任せた量」ではなく、データ・ツール・通信・監督・停止手段を含むシステムとして検証できた範囲で評価します。
よくある質問(FAQ)
Q. この記事は実在する企業のAIエージェント失敗談ですか?
いいえ。特定企業や個人の体験談を創作せず、AI支援テストとクラウド障害分析エージェントの研究が示した失敗パターンを、実験で起きる失敗として整理しています。
Q. AIエージェントの実験で最初に確認すべきことは何ですか?
検証する目的、成功指標、入力データ、ツール権限、保存する証拠、停止条件を先に決めます。最終回答だけでなく、エージェントが何を調べ、何を見落とし、どの根拠で結論を出したかを確認できる状態にします。
Q. プロンプトを改善すれば失敗はなくせますか?
なくせるとは限りません。クラウド障害分析の研究では、追加プロンプトで探索範囲が広がる場面があった一方、主要なデータ解釈エラーは残りました。外部検証、通信内容の可視化、ツール制御、サンドボックスなど、システム全体の対策も必要です。
Q. AIエージェントを人が毎回すべて確認すべきですか?
すべての内部処理を同じ深さで確認する必要はありませんが、リスクに応じた監督は必要です。読み取り専用の低リスク処理はサンプリングや自動評価を使い、データ更新、外部送信、権限変更、顧客影響のある操作は人の承認と監査ログを残すなど、境界を分けます。
参考情報:
Eduard Paul Enoiu「(Over)Reliance on Test Agents in AI-Assisted Software Testing」
Taeyoon Kimほか「Why Do AI Agents Systematically Fail at Cloud Root Cause Analysis?」
International AI Safety Report 2026
関連記事
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。