Cloudflareは2026年8月上旬に公開したブログ「Engineering Standards Enforcement」で、AIによるコードレビューが30日間で約25万件の標準逸脱を検出し、16,000件のマージをブロックしたと明らかにしました。AI支援開発でコードの生成量が増えるほど、コードレビューが開発現場の新しいボトルネックになっている実態を示す事例です。
背景には業界全体の生成量の急増があります。GitHubのOctoverseによると、2025年にマージされたPRは518.7百万件で前年比29%増、GitHub Copilotのレビュー機能利用者の72.6%が効率向上を実感したという結果もあります。日本でもAI Watch/Impressが紹介したキッカケクリエイションの2026年調査で、レビュー担当者322名の約9割が負担増を感じたと報告されました。
日本の開発組織に必要なのは、AI導入の成否を生成速度だけで評価しないことです。人手、AIレビュアー、PRの粒度、承認ルールをどう組み合わせるか。2026年の事例と調査を横断すると、次の投資先はエディタではなくレビュー体制です。
※本記事は2026年8月時点の情報です。
なぜ開発のボトルネックがコードレビューへ移ったのか
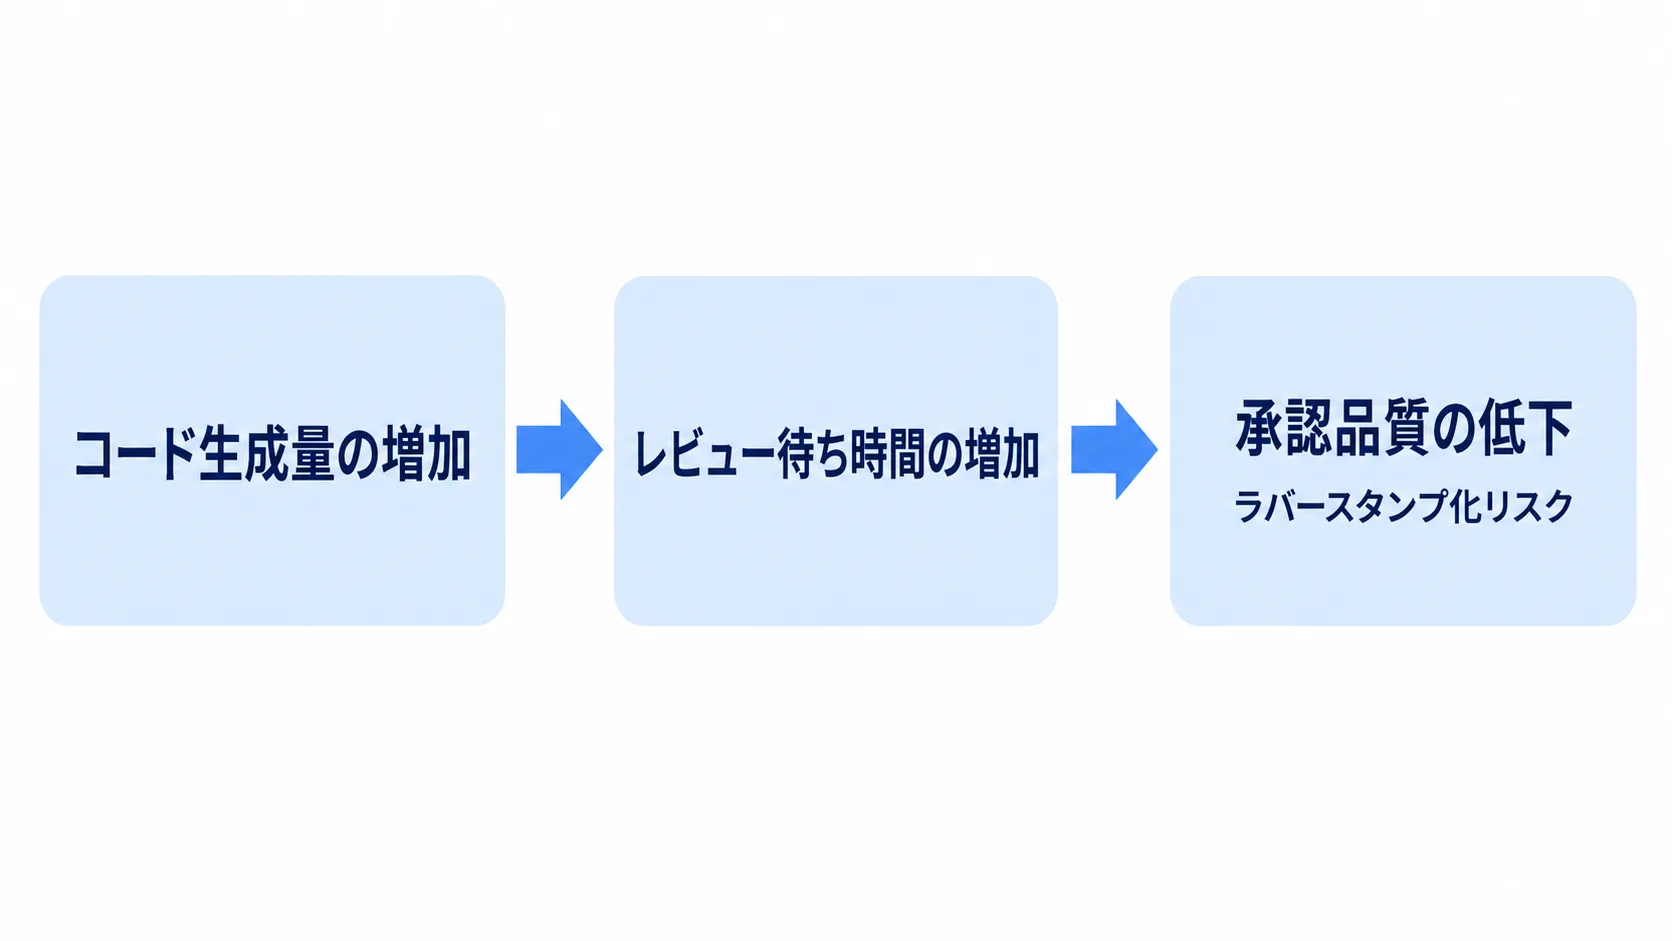
GitHubのOctoverseによると、2025年にマージされたPRは518.7百万件で、前年比29%増でした。GitHub Copilotのレビュー機能利用者の72.6%が効率向上を実感したという結果もあります。AIはレビューを助ける一方、レビュー対象そのものも増やしています。生産性向上が、そのまま人間の確認量の増加に変わる構造です。
この潮流を整理した一つが、Gergely Orosz氏のThe Pragmatic Engineerの記事です。ただし統計調査ではなく、各社への取材・聞き取りをもとにした分析です。市場全体の証明ではなく、一次ブログや定量データを結び付ける起点として読むべきでしょう。
日本でも兆候はあります。AI Watch/Impressが紹介したキッカケクリエイションの2026年調査では、レビュー担当者322名の約9割が負担増を感じ、78.6%がAI起因とみられるバグ修正を経験しました。Tabelog Tech Blogが紹介した「AI DevEx 2026」では、ボトルネックとしてコーディングは0%、コードレビューは約31%で2位です。対象は同一ではありませんが、国内でも論点が「書けるか」から「安全に流せるか」へ移る材料です。
AIが生成したコードの品質評価では、SlopCodeBenchのように、動作だけでなく保守性や複雑度も確認する視点が重要です。
ポイント
AI支援開発でPR数・コード量が増えるほど、レビューの確認量も比例して増えます。生成速度の向上を、そのままレビュー負荷の増加として受け止める必要があります。
実名企業はAIレビューをどう組み込んでいるか
Uberは増え続けるレビューにuReviewで対応した
UberのuReviewは、AI支援開発でコード量が増えてレビューが追いつかなくなった課題に対応するために、同社が内製したコードレビュー支援システムです。導入の背景には、生成されるコードの増加にレビュアーが対応しきれないという問題意識があったと説明されています。
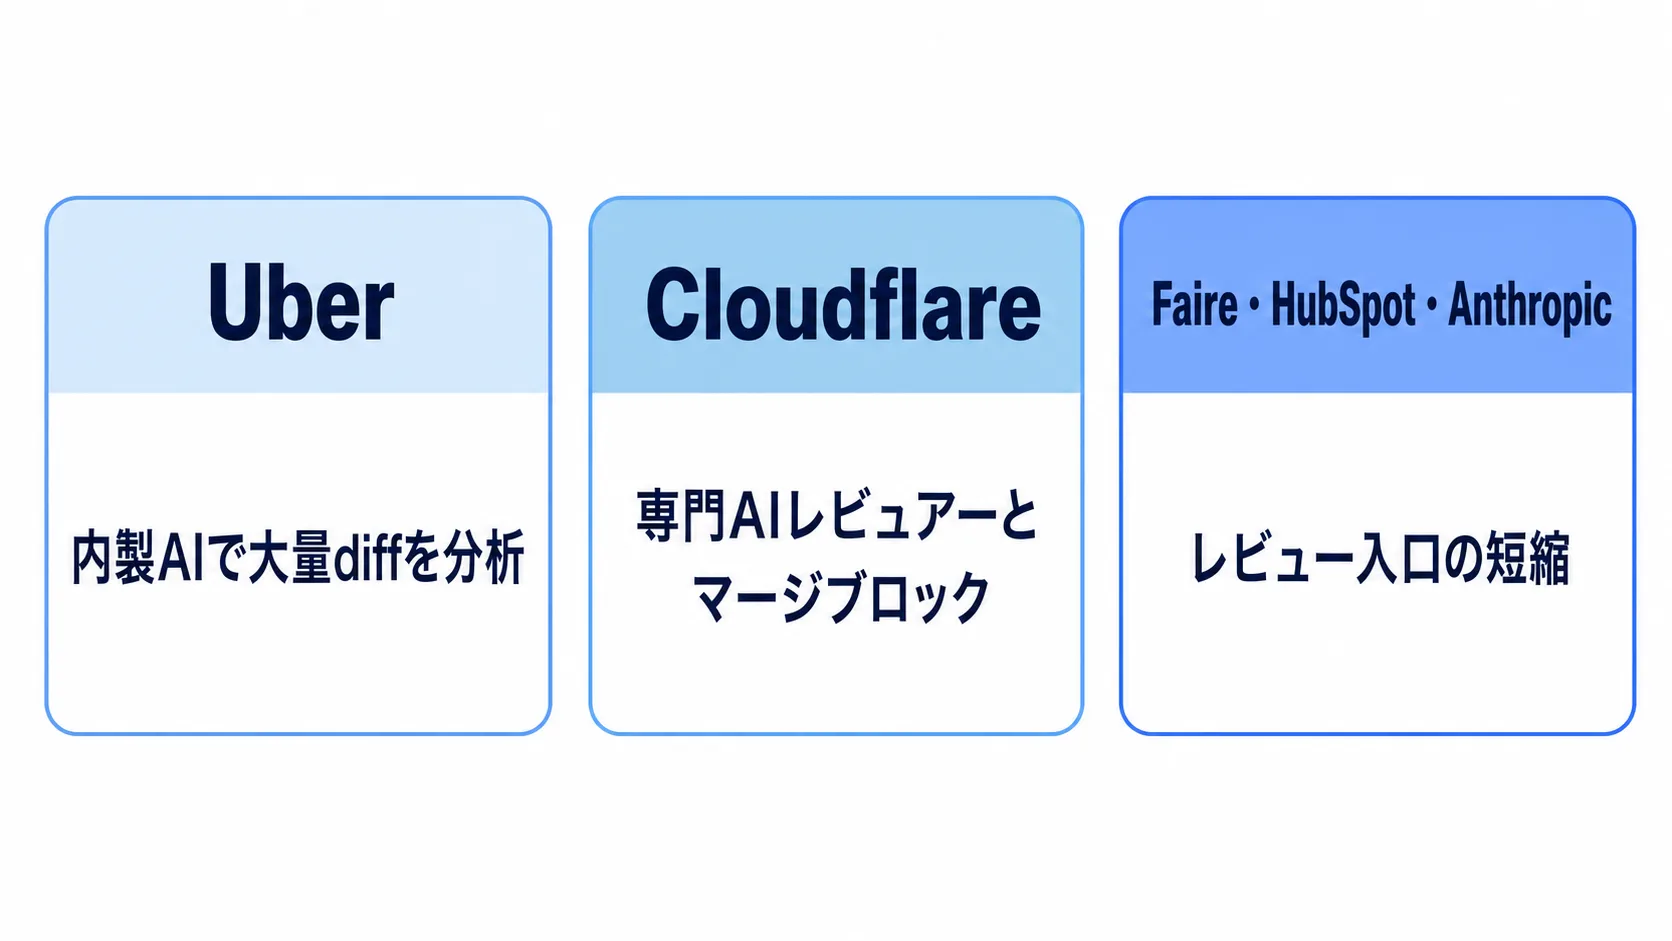
2025年8月の公式ブログによれば、uReviewは週次約65,000件のdiffの90%以上を分析し、コメントの75%が有用と評価され、65%以上が対応されました。週1,500時間を節約したとも説明されています。なお「Code Inbox」はUber公式の呼称ではなく、Pragmatic Engineer記事内の呼び方です。正式名称はuReviewです。
Cloudflareは専門性と強制力を分けて運用する
CloudflareのAI Code Reviewは、セキュリティ、パフォーマンス、品質、ドキュメント、リリース管理、コンプライアンス、AGENTS.mdを担当する最大7種類の専門AIレビュアーを動かします。2026年4月の公式ブログでは、30日間で131,246回、48,095件のマージリクエストと5,169リポジトリを対象にレビューし、平均レビュー時間は3分39秒、平均コストは1件あたり1.19ドルでした。
さらに2026年8月上旬のEngineering Standards Enforcementでは、AIレビューが約25万件の標準逸脱を検出し、16,000件のマージをブロックしたと説明されています。AIを補助にとどめず、標準違反でマージを止める制御点に組み込んでいる点が重要です。
Faire・HubSpot・Anthropicはレビューの入口を短くする
FaireのFaireyは、OpenAI Assistants APIとRAGを組み合わせた自動レビューです。2024年8月の記事で、2026年の事例より古い点には注意が必要ですが、組織固有の規約を検索してレビューに反映する発想を示しています。一次記事で確認できない処理件数は採用しません。
HubSpotのSidekickは、6か月で初回フィードバックまでの時間を90%短縮し、ピーク時は99.76%短縮したと報告されています。80%超の「いいね」承認率、7,000件超のAI完全生成PRのマージ、50,000件超の人間作成PRのレビューは、常設部品としての運用を示します。
AnthropicのClaude Codeレビューでは、実質的なコメントが付く割合が16%から54%へ上昇しました。1,000行超のPRでは84%、50行未満では31%の確率で指摘が入り、不同意率は1%未満、完了までの平均時間は約20分です。PRを小さく保つことが、AIと人間の確認可能性を高めそうです。
レビュー工程を継続的に改善するには、AgentOpsと同じく、実行ログや評価指標を残して変化を追える状態にします。
ポイント
Uberは大量diffの自動分析、Cloudflareは専門AIレビュアーとマージブロック、Faire・HubSpot・Anthropicはレビュー入口の短縮と、企業ごとにAIの役割が異なります。共通するのは、人間の確認を無くすのではなく設計し直している点です。
定量データが示す「速く書けるのに流れない」状態
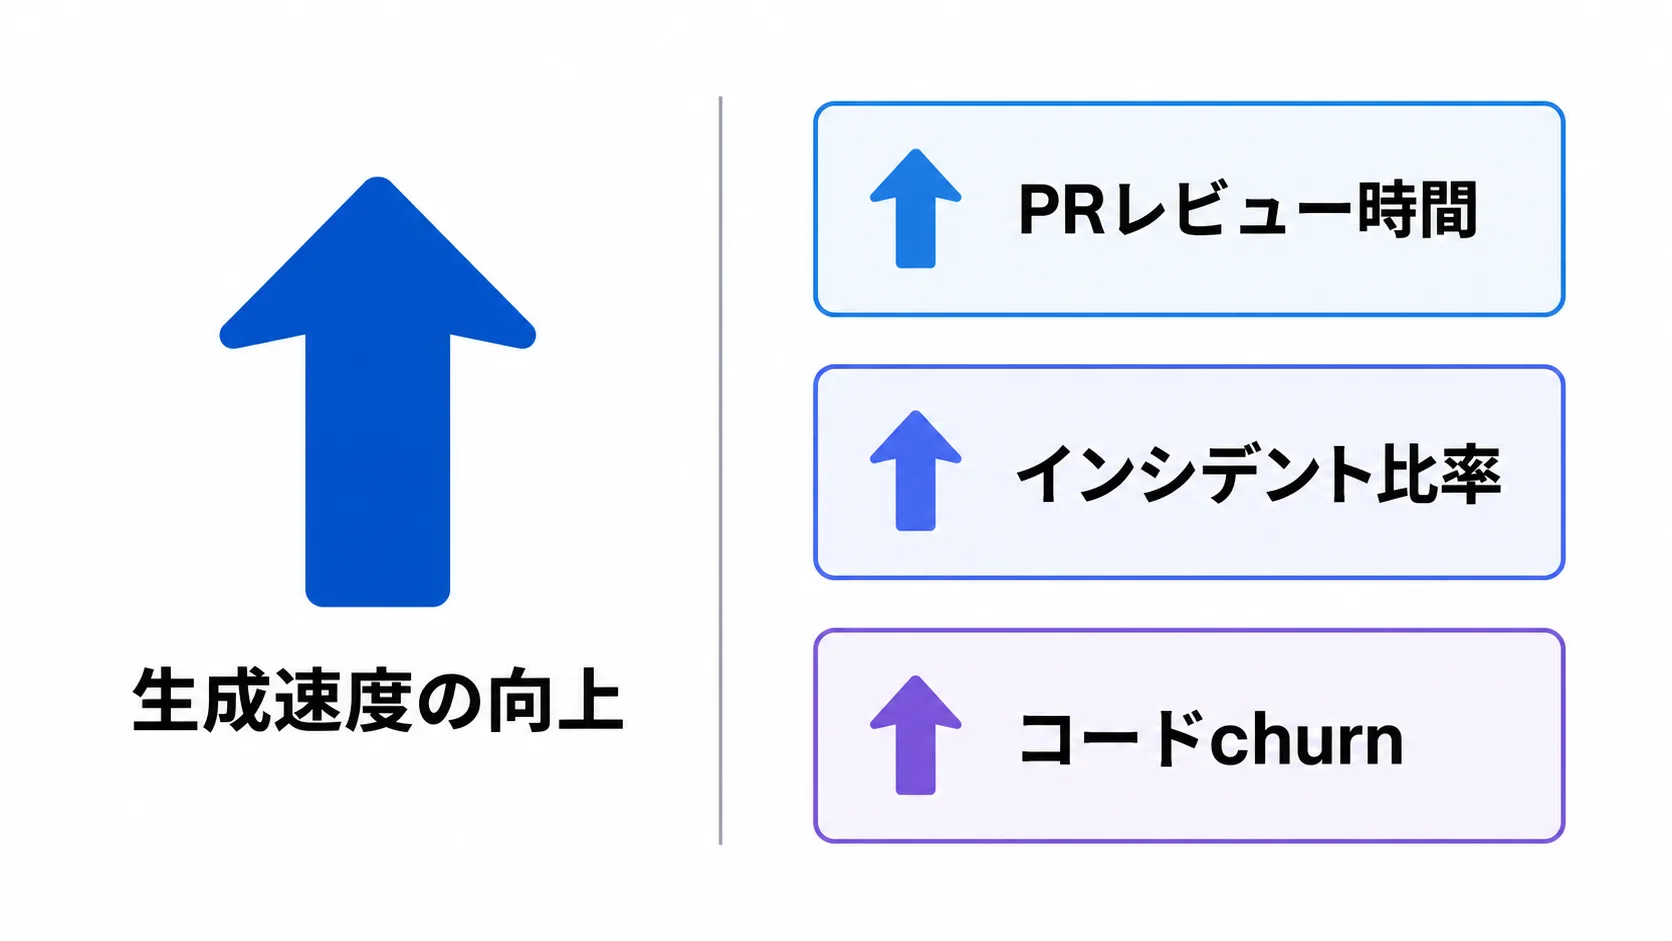
Faros AIは年度を分けて読む必要があります。2025年版(開発者10,000人・1,255チーム)は、タスク完了率+21%の一方、PRマージ率+98%、レビュー時間+91%、平均PRサイズ+154%、バグ+9%を報告しました。
2026年版「The Acceleration Whiplash」(開発者22,000人・4,000チーム)では、PRレビュー時間の中央値+441.5%、インシデント/PR比率+242.7%、コードchurn+861%でした。定義が異なるため単純比較はできませんが、負荷移転の方向は共通しています(出典:Faros AI 2025年版・2026年版)。
LinearBの2026 Benchmarks Reportも待ち時間を示します。810万件のPR、4,800超の組織を分析した結果、AI生成PRは人間作成PRより着手まで4.6倍、AIエージェント型は5.3倍でした。承認率もAI生成PRは32.7%、人間の手動PRは84.4%です。生成速度だけをKPIにすると、キューに積まれたPRを成果に数えることになります。
ポイント
Faros AI・LinearBとも、生成速度の向上と同時にPRレビュー時間・インシデント比率・コードchurnが悪化しています。生成量だけをKPIにすると、滞留したPRを成果として見誤ります。
ここからはriplaの見解:レビュー時間は「削る対象」ではなく設計対象
ここからはriplaの見解です。レビュー時間が伸びたこと自体を失敗と判断すべきではありません。生成コードの確認や仕様との照合にはコストがかかるためです。問題は、重要なPRも小さなPRも同じ列に並び、何を確認したか記録されないまま、最後にラバースタンプを押す状態です。品質を守る時間と、単なる待ち時間を分ける必要があります。
最初に投資すべきはAIレビュアーではなくレビューの流れ
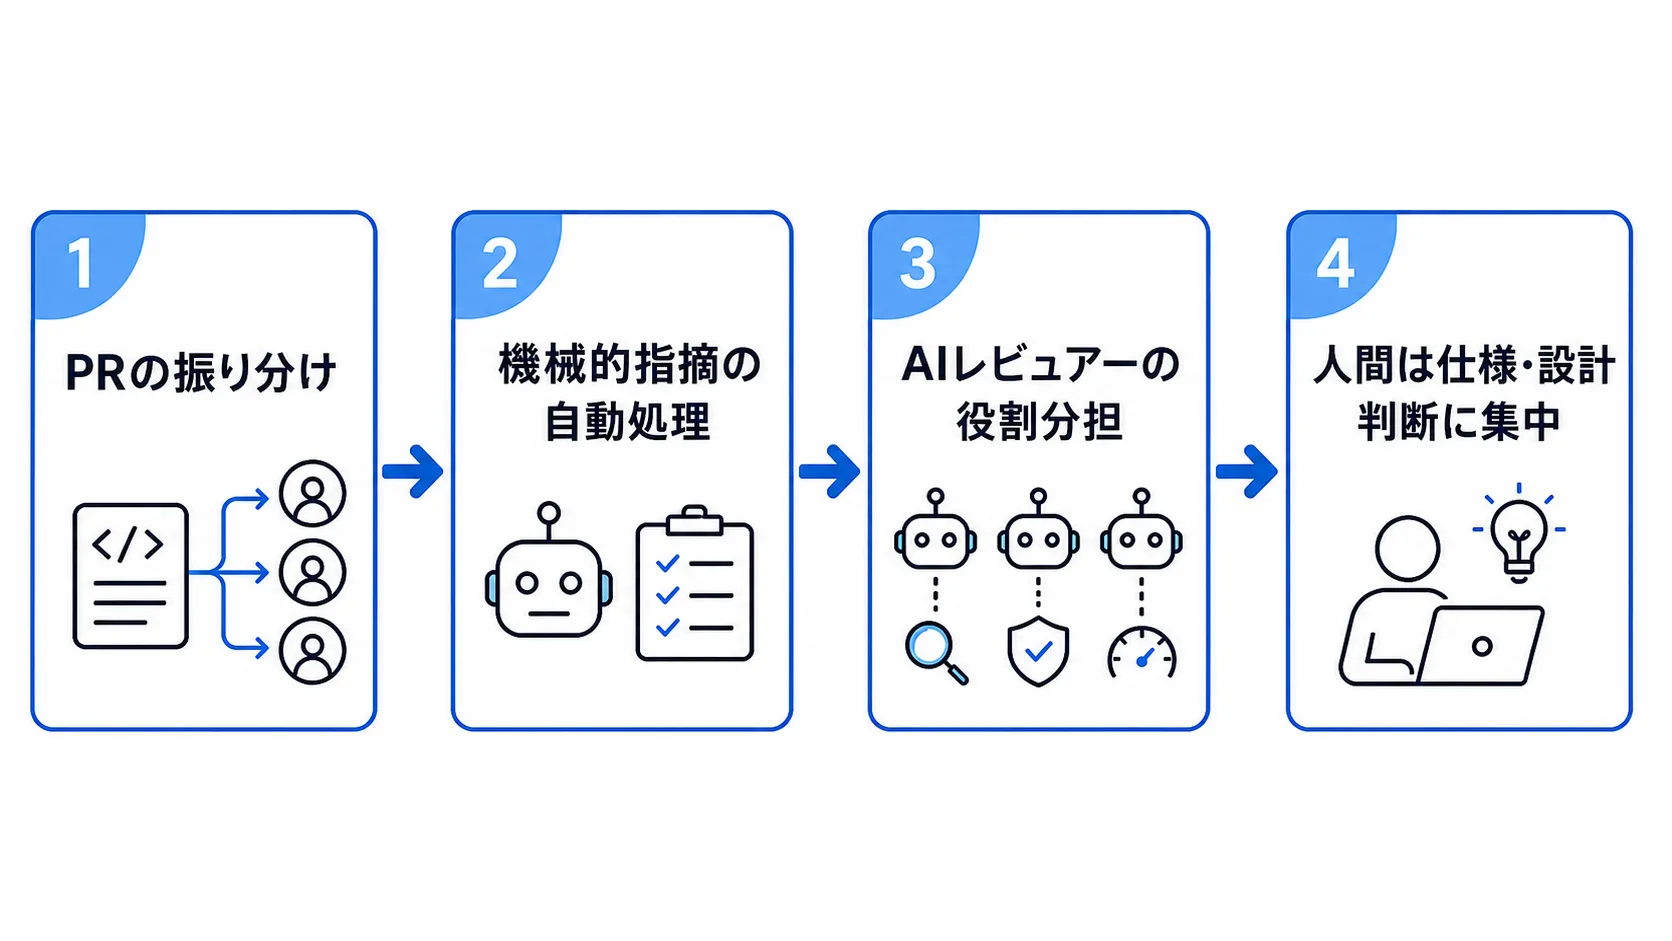
優先順位は次の順が現実的です。Cloudflareの専門AIレビュアーやUberのCommenter/Fixerは、確認作業を分解する設計として参考になります。
- PRの大きさ・変更リスク・担当領域でレビューを振り分ける
- 自動テストと静的解析で機械的な指摘を先に処理する
- AIレビュアーには社内規約・セキュリティ・性能など役割を持たせる
- 人間は仕様判断と設計上のトレードオフに集中する
導入効果は生成行数ではなく、レビュー待ち時間、初回フィードバック、再レビュー回数、指摘の対応率、マージ後の不具合、担当者の偏りで測るべきです。AIの採用率だけでなく、見逃しと人間の最終判断も記録します。ラバースタンプ化を防ぐには、高リスク変更に確認項目や根拠を残す仕組みが必要です。
2026年のレビュー体制は、「人間かAIか」の二択ではありません。AIに全PRを読ませれば解決するわけでも、人間の人数を増やせばよいわけでもありません。どの指摘を自動化し、どの判断を人に残し、どの変更をマージ前後で検査するかを決める、品質フィードバックの設計問題です。
ポイント
最初に整えるべきはAIレビュアーの導入ではなく、PRの振り分け・機械的指摘の自動化・AIと人間の役割分担という流れです。効果は生成行数ではなくレビュー待ち時間や不具合率で測ります。
AI支援開発とコードレビューのよくある質問
レビュー時間が伸びるのは悪いことですか?
必ずしも悪いとは限りません。重要な変更を丁寧に確認しているなら、レビュー時間は品質担保のコストです。ただし、待ち時間と実作業時間を分け、変更のリスクに応じてレビュー方法を変える必要があります。平均値だけでなく、中央値、長時間滞留したPR、マージ後の不具合も確認しましょう。
AIレビュアーを導入すれば人間のレビューは不要ですか?
不要にはなりません。AIは規約違反や典型的なバグ候補の検出を自動化できますが、仕様の妥当性、事業上の優先順位、設計のトレードオフは人間が判断します。まずは読み取り専用やコメント生成から始め、誤検知と見逃しを測定し、標準違反を止めるような強い制御は対象を限定して段階的に広げるのが安全です。
検索や生成AIの変化を開発組織の発信へつなげるなら、GEO(生成エンジン最適化)の論点も合わせて整理できます。
まとめ:AI時代の開発競争力はレビュー設計で決まる
AI支援開発でコードを書く速度が上がるほど、開発組織はレビューを「最後に人が確認する工程」として扱えなくなります。Uber、Cloudflare、Faire、HubSpot、Anthropicの事例は、レビューを既存基盤に統合し、専門化し、早期に返し、必要ならマージを止める仕組みへ変えている点で共通しています。
日本の開発組織が最初に見直すべきなのは、AIツールの契約数ではなく、レビューの流量と品質を測れる状態です。PRを小さくする、機械的な指摘を自動化する、AIと人間の役割を分ける、重要な判断に根拠を残す。この順で整えれば、AIによる速度向上を、レビュー渋滞と品質リスクだけで終わらせずに済みます。
参考情報:
Gergely Orosz「The Pulse: New trend — concern about massive increase in code review load」
Uber「uReview: Scalable, Trustworthy GenAI for Code Review at Uber」
Cloudflare「Orchestrating AI Code Review at scale」
Cloudflare「Engineering Standards Enforcement」
Faire「Automated Code Reviews with LLMs」
HubSpot「Automated Code Review: The 6-Month Evolution」
Anthropic「Code review with Claude Code」
Faros AI「Research」2025年版・2026年版
LinearB「2026 Benchmarks Report」
GitHub「Octoverse」
Hacker News「The review bottleneck」スレッド
関連記事
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。
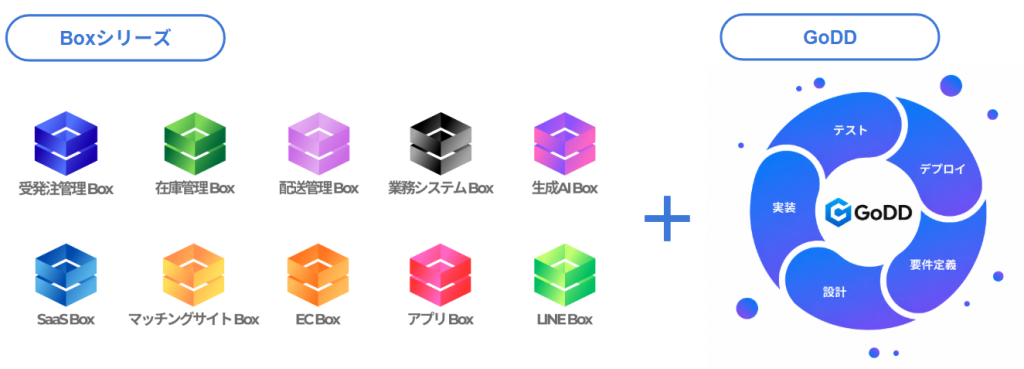
また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。
もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>
株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。
AI支援開発のレビュー効果は何で測ればよいですか?
レビュー待ち時間、初回フィードバック、再レビュー回数、指摘の対応率、マージ後の不具合、担当者の偏りで測るべきです。AIの採用率だけでなく、見逃しと人間の最終判断も記録します。