Google DeepMindは動画生成モデル「Veo 3.1」を音声を含む動画生成モデルとして公開し、Veo 3については効果音・環境音・台詞をネイティブに生成すると説明しています。OpenAIも動画生成モデル「Sora 2」を発表し、同期した台詞と効果音を特徴に挙げました。動画生成AIは、映像を作ったあとに音を別工程で加える従来の設計から、映像と音声を同時に生成する段階へ進んでいます。
ただし、これは広告や映像制作の全工程が自動化されたという意味ではありません。音声と映像の整合、ブランド表現、事実関係、権利・契約、公開前の確認は、引き続き人が担う工程です。
さらに、OpenAIのSora 2公式ページには、Sora製品が2026年4月26日から利用できなくなったとの注記があります。以下では、公式発表で確認できる機能と、企業が導入前に検証すべき論点を分けて整理します。
※本記事は2026年8月時点の情報です。
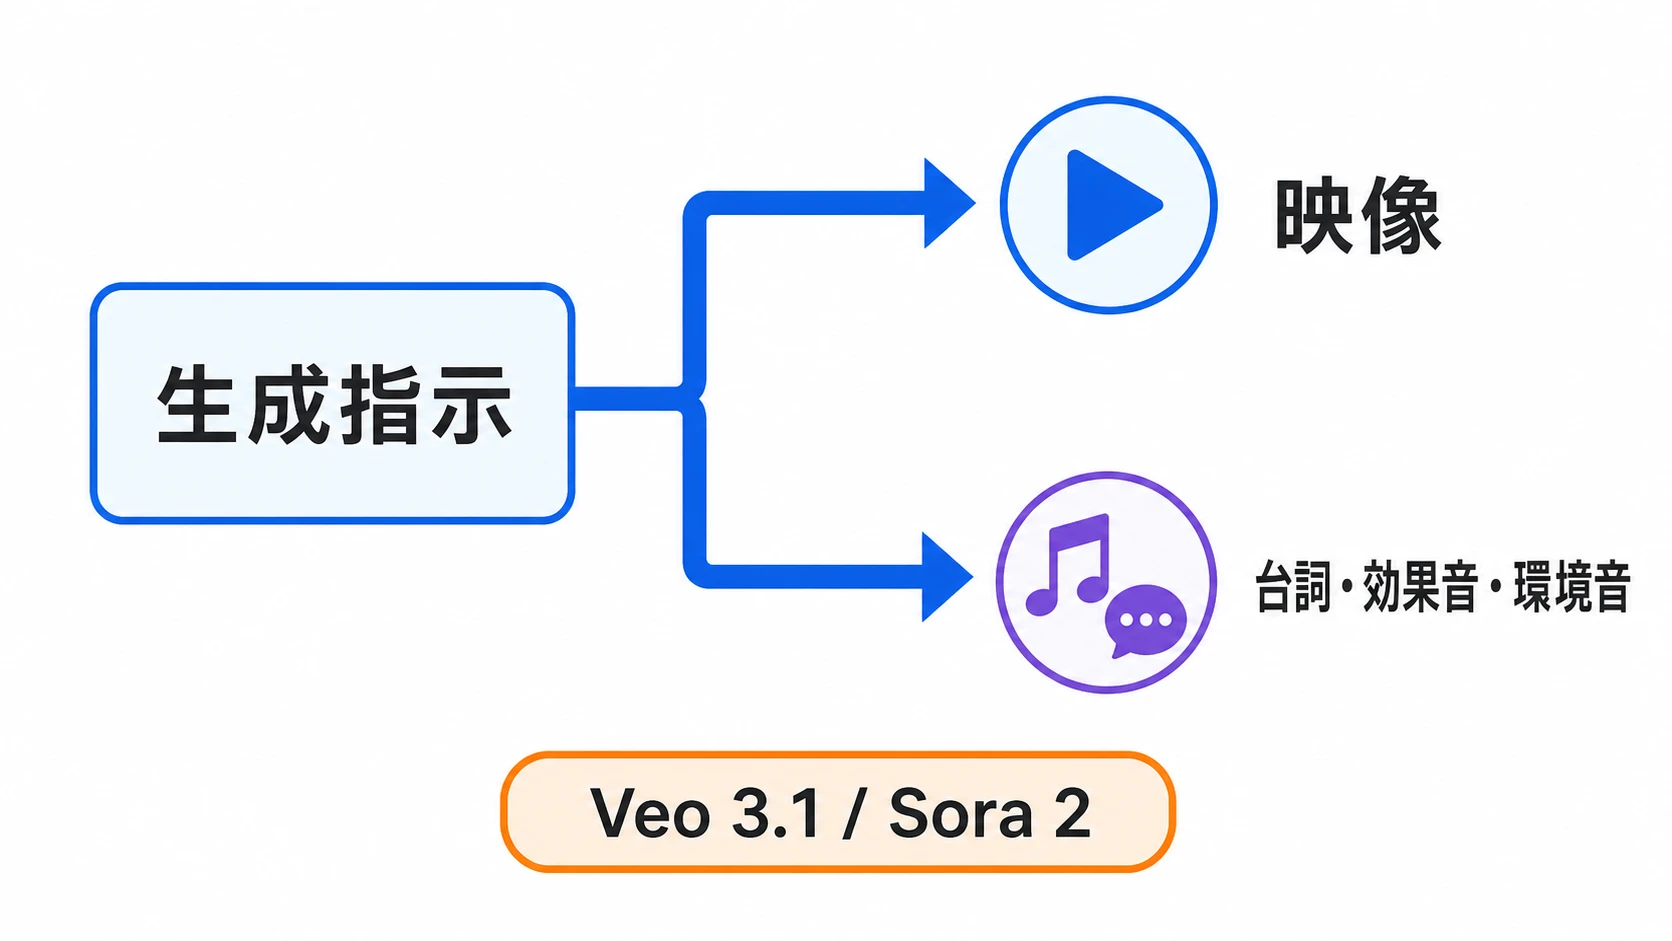
動画生成AIの変化|「映像を作ってから音を足す」から同時生成へ
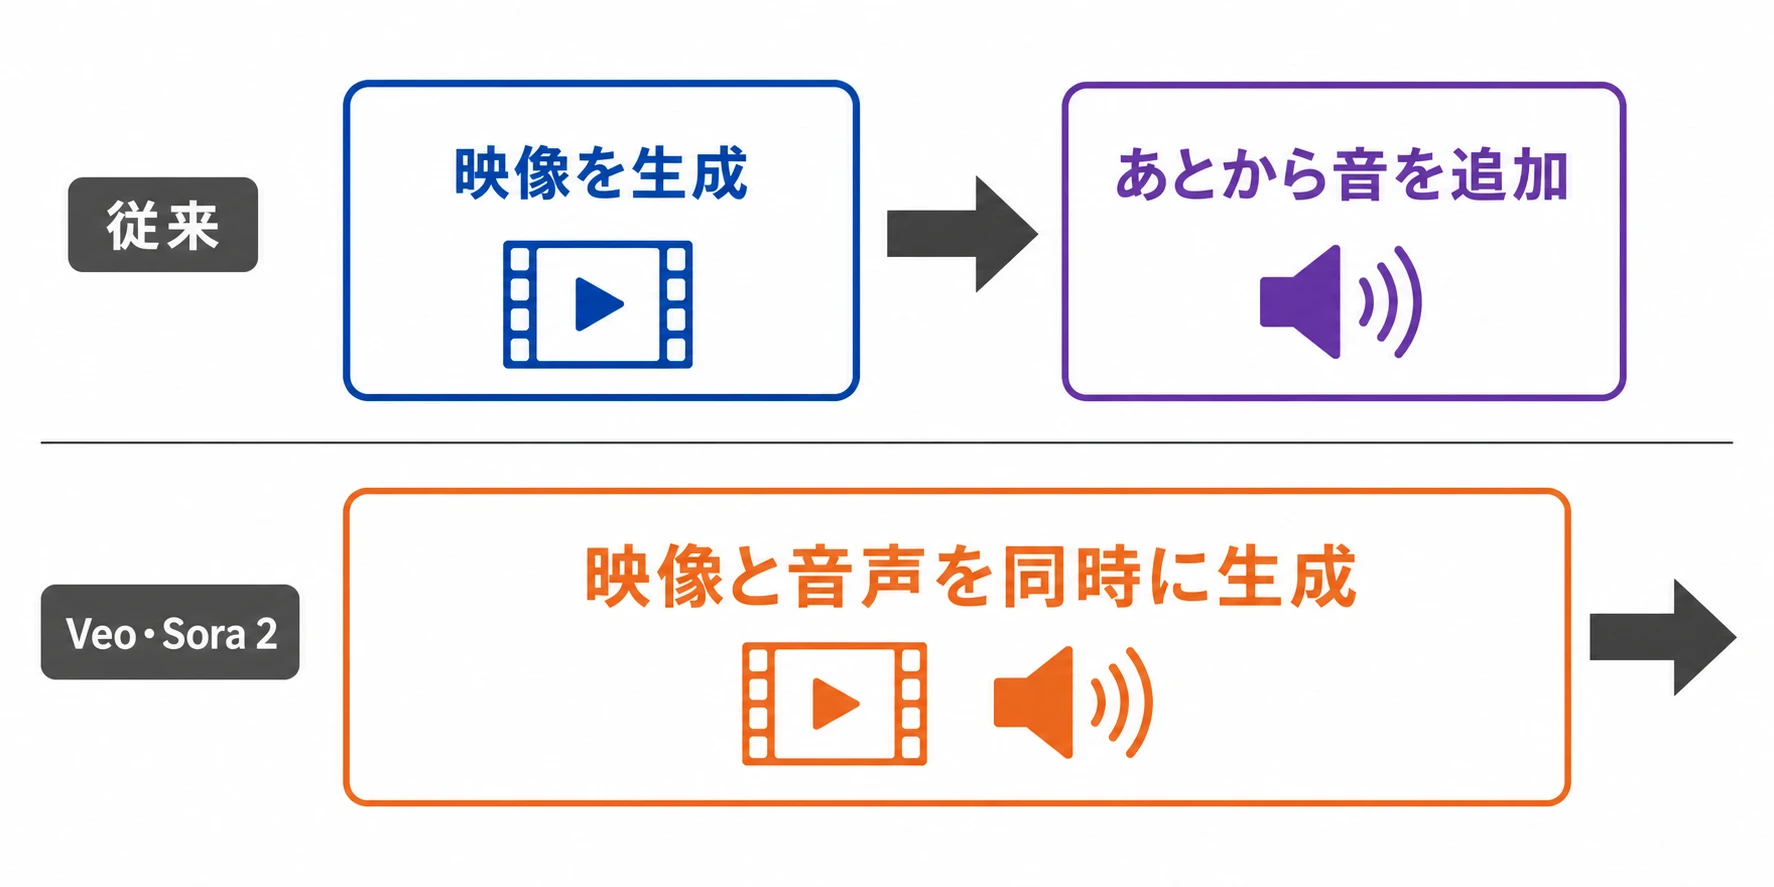
従来の動画生成では、映像を作ったあとにナレーション、効果音、環境音、音楽を別工程で加える設計が一般的でした。Google DeepMindは、動画から音声を生成するV2A(video-to-audio)技術について、映像のピクセルと自然言語のプロンプトを組み合わせ、画面上の動きに合うサウンドスケープを生成すると説明しています。
V2Aは、Veoのような動画生成モデルと組み合わせ、劇伴、効果音、台詞を作る研究として紹介されました。現在のVeoページでは、Veo 3.1が音声を含む動画生成モデルとして掲げられ、Veo 3については効果音、環境音、台詞をネイティブに生成すると説明されています。
映像の動きと音を別々に並べるだけでなく、プロンプトの場面・人物・雰囲気を音声側にも反映させることが、音声同時生成の中心的な価値です。OpenAIのSora 2発表も、動画と音声の生成モデルとして、同期した台詞と効果音を特徴に挙げています。背景音、発話、効果音を高いリアリティで生成できると説明する一方、モデルは完全ではなく、誤りも残ると明記しています。
ポイント
Veo 3.1・Veo 3・Sora 2はいずれも、映像とあわせて台詞や効果音を生成すると公式に説明されています。無音の初稿ではなく「音付きの初稿」が出発点になりつつあります。
Veo・V2A・Sora 2を比較|機能と提供状況を分けて見る
| 対象 | 公式情報で確認できること | 制作側の見方 |
|---|---|---|
| Veo 3.1 / Veo 3 | Veo 3.1は音声を含む動画生成モデル。Veo 3は効果音・環境音・台詞をネイティブに生成すると説明 | 映像と音の初稿を一つの指示で試し、画・台詞・音の整合を確認する |
| Google V2A研究 | 動画ピクセルとテキストプロンプトから、映像に同期した音声を生成。Veoなどとの組み合わせを説明 | 無音映像への音付けや複数の音声案の比較に向く可能性がある |
| Sora 2 | 同期した台詞・効果音、背景音・発話・効果音の生成を発表。公式ページは2026年4月26日からSora製品が利用不可と注記 | 発表時の機能と、現在使える製品・契約条件を分けて確認する |
表の「制作側の見方」は、公式発表の機能から導ける実務上の含意です。VeoやSora 2の名称だけで現在の利用可否や商用条件を判断せず、実際に使う製品の公式ページ、提供地域、契約、利用規約を確認します。
特にSora 2は、発表時の機能説明と公式ページに記載された現在の製品状況を混同しないことが重要です。
ポイント
Veo・V2A・Sora 2は機能の説明であり、利用可否の証明ではありません。導入検討時は必ず最新の公式ページで提供状況を確認します。
音声同時生成の仕組み|映像の動きとプロンプトから音を組み立てる
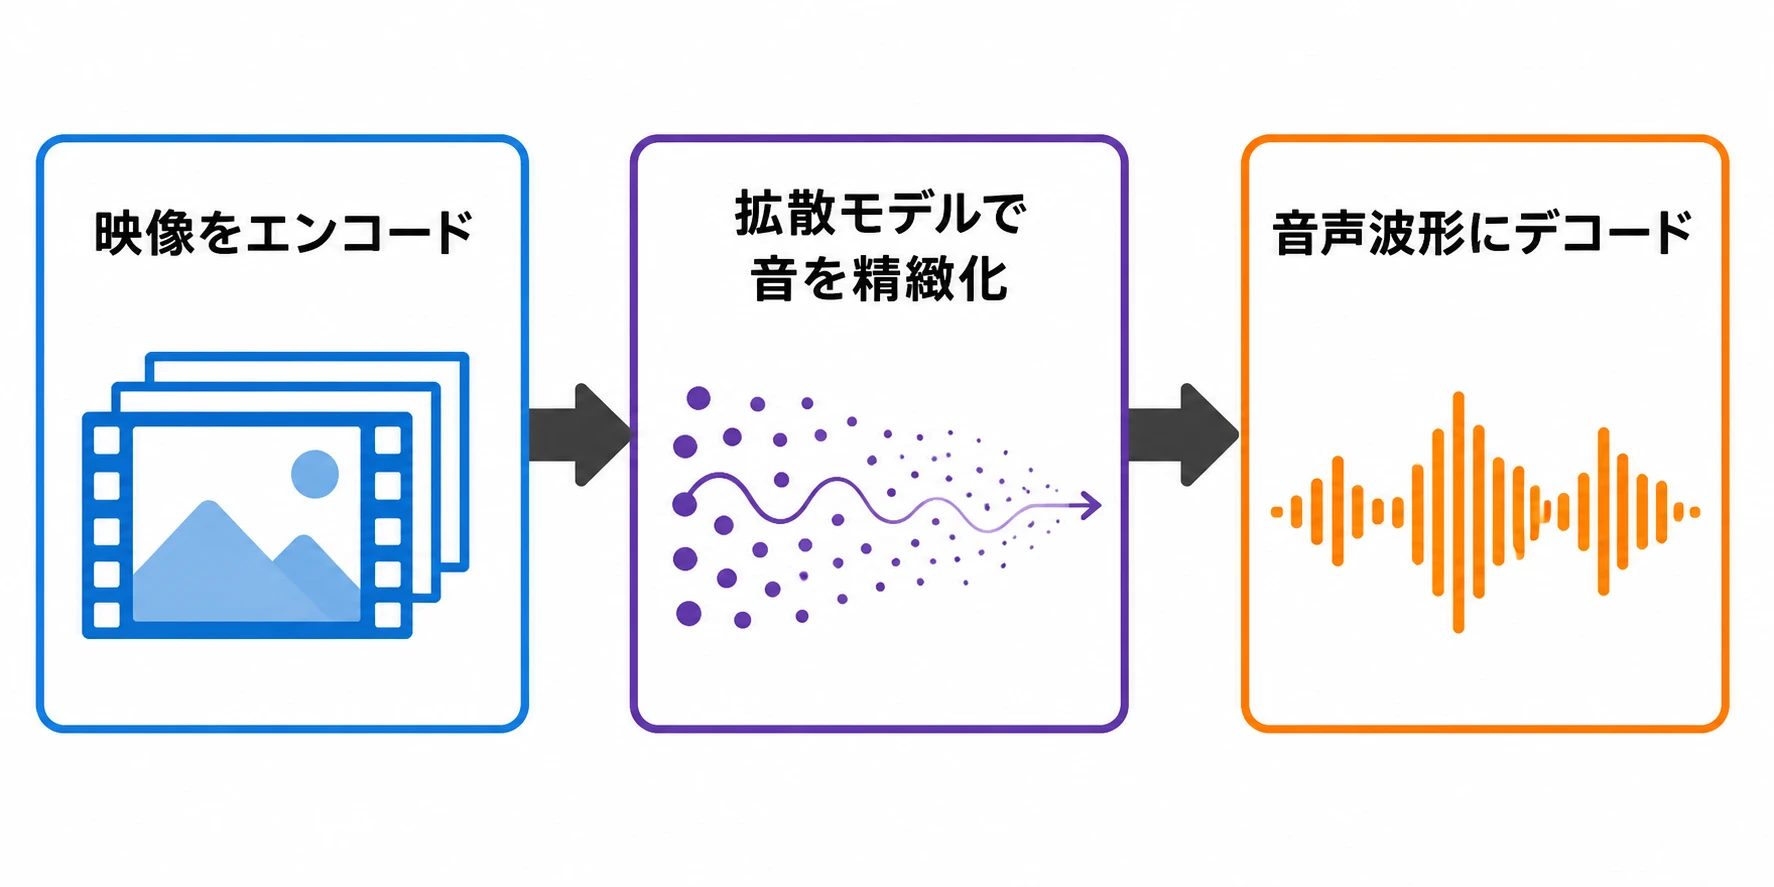
Google DeepMindのV2A研究では、まず動画入力を圧縮表現へエンコードします。次に拡散モデルがランダムノイズから音声を反復的に精緻化し、映像入力と自然言語プロンプトを条件にして、映像に合う音声を生成します。最後に音声波形へデコードして動画と結合します。テキストプロンプトは任意とされ、映像の画素自体からも場面に対応する音を学習する構成です。
音声の候補を一つに固定せず、肯定的なプロンプトで望む音を寄せたり、否定的なプロンプトで避けたい音を指定したりできます。Google DeepMindは、同じ動画入力に対して無制限のサウンドトラックを生成できると説明しています。広告の初期案で「落ち着いた環境音」「緊張感のある効果音」などを比較する用途は、この性質と相性がよいと考えられます。
一方で、映像入力の品質が音声品質に影響し、映像のアーティファクトや学習分布外の歪みが音声の低下につながる場合があります。発話では、音声側が台詞の文字起こしをもとに口の動きを合わせようとしても、動画生成モデルが同じ文字起こしで口元を条件付けていないと、リップシンクが不自然になり得ると説明されています。
ポイント
V2Aは映像に合わせて音の候補を複数生成できますが、映像品質がそのまま音声品質に影響し、口の動きと台詞のずれも起こり得ます。
広告・制作での使いどころ|初稿の速度を上げ、確認工程を残す
音声付き動画生成を広告や映像制作へ取り入れる場合、最初から完成品を任せるより、企画と試作の反復を短くする用途から始めるのが現実的です。絵コンテに近い短いカット、複数のナレーションのトーン、商品紹介の背景音、SNS向けの尺違いの方向性を比較し、採用案だけを人が編集・承認する流れが考えられます。
これは公式発表の機能から導く活用仮説であり、成果を保証するものではありません。工程ごとの役割を、次のように分けて考えます。
- 企画:目的、対象者、媒体、尺、画面に必須の要素を先に固定する
- 生成:カメラ、動作、台詞、効果音、環境音を一つのプロンプトに分けて指定する
- 比較:映像の分かりやすさ、台詞の聞き取りやすさ、音と動きの同期を同じ評価表で見る
- 編集:ブランド表現、事実関係、素材の出所、権利・契約、公開基準を人が確認する
- 公開:承認済みの版と生成履歴を保存し、再編集や差し替えを追跡できるようにする
生成映像を単独の新機能として見るのではなく、画像生成AI・動画生成AIのビジネス活用で整理されている素材管理・導入判断の論点とつなげます。特に、生成した音声を含む動画は、映像だけを確認していたときよりも、台詞や音の内容まで承認対象に含める必要があります。
ポイント
企画・生成・比較・編集・公開の5工程に分け、生成は初稿づくりに使い、確認と承認は必ず人が担う運用にします。
導入前の注意点|音ズレ・品質・提供条件を検証する
音声同時生成の評価では、映像の美しさだけを見ないことが重要です。短いサンプルを自社の代表的な広告・説明動画に近い条件で作り、音声の自然さ、台詞の正確さ、口の動きとの同期、効果音のタイミング、人物・商品・背景の一貫性を確認します。公式デモは技術の可能性を示すものであり、自社の素材やブランド表現で同じ結果が出るとは限りません。
また、生成機能の有無と、利用できる製品・地域・契約条件は別に管理します。Sora 2の公式ページは、モデルの機能を説明したうえで、2026年4月26日からSora製品が利用できなくなったと記載しています。制作計画に組み込む前に、現在の提供状況、APIやアプリの対象範囲、出力物の利用条件を公式情報で確認します。
安全と透明性の面では、Google DeepMindがV2A研究のAI生成コンテンツにSynthIDを組み込んだと説明しています。SynthIDとC2PAによるAI生成物の来歴確認で扱うように、ウォーターマークがあっても内容の真実性や利用許諾を自動で保証するものではなく、制作履歴の保存や社内レビューと組み合わせて使います。
ポイント
公式デモの品質を鵜呑みにせず、自社素材で音声・同期・ブランド表現を検証し、提供条件を公式情報で確認したうえで導入判断します。
企業の評価方法|1本の完成度より制作プロセスで比べる
導入可否を決めるときは、モデルの印象だけでなく、従来の制作工程と同じ題材を使って比較します。評価期間とサンプル数を決め、生成にかかった時間、採用できたカットの割合、音の修正回数、編集者の確認時間、再利用しやすさを記録します。品質が上がっても修正に時間がかかるなら、全体の効果は小さくなる可能性があります。
| 評価軸 | 確認する質問 | 合否を決める前の記録 |
|---|---|---|
| 映像 | 商品・人物・動作・カメラ指示が意図どおりか | 採用率、再生成回数、ショット間の一貫性 |
| 音声 | 台詞、環境音、効果音、音楽の内容と音量が適切か | 聞き取りやすさ、修正点、音声編集の時間 |
| 同期 | 口の動き、足音、衝撃音などが映像のタイミングと合うか | 音ズレの種類と修正可能性 |
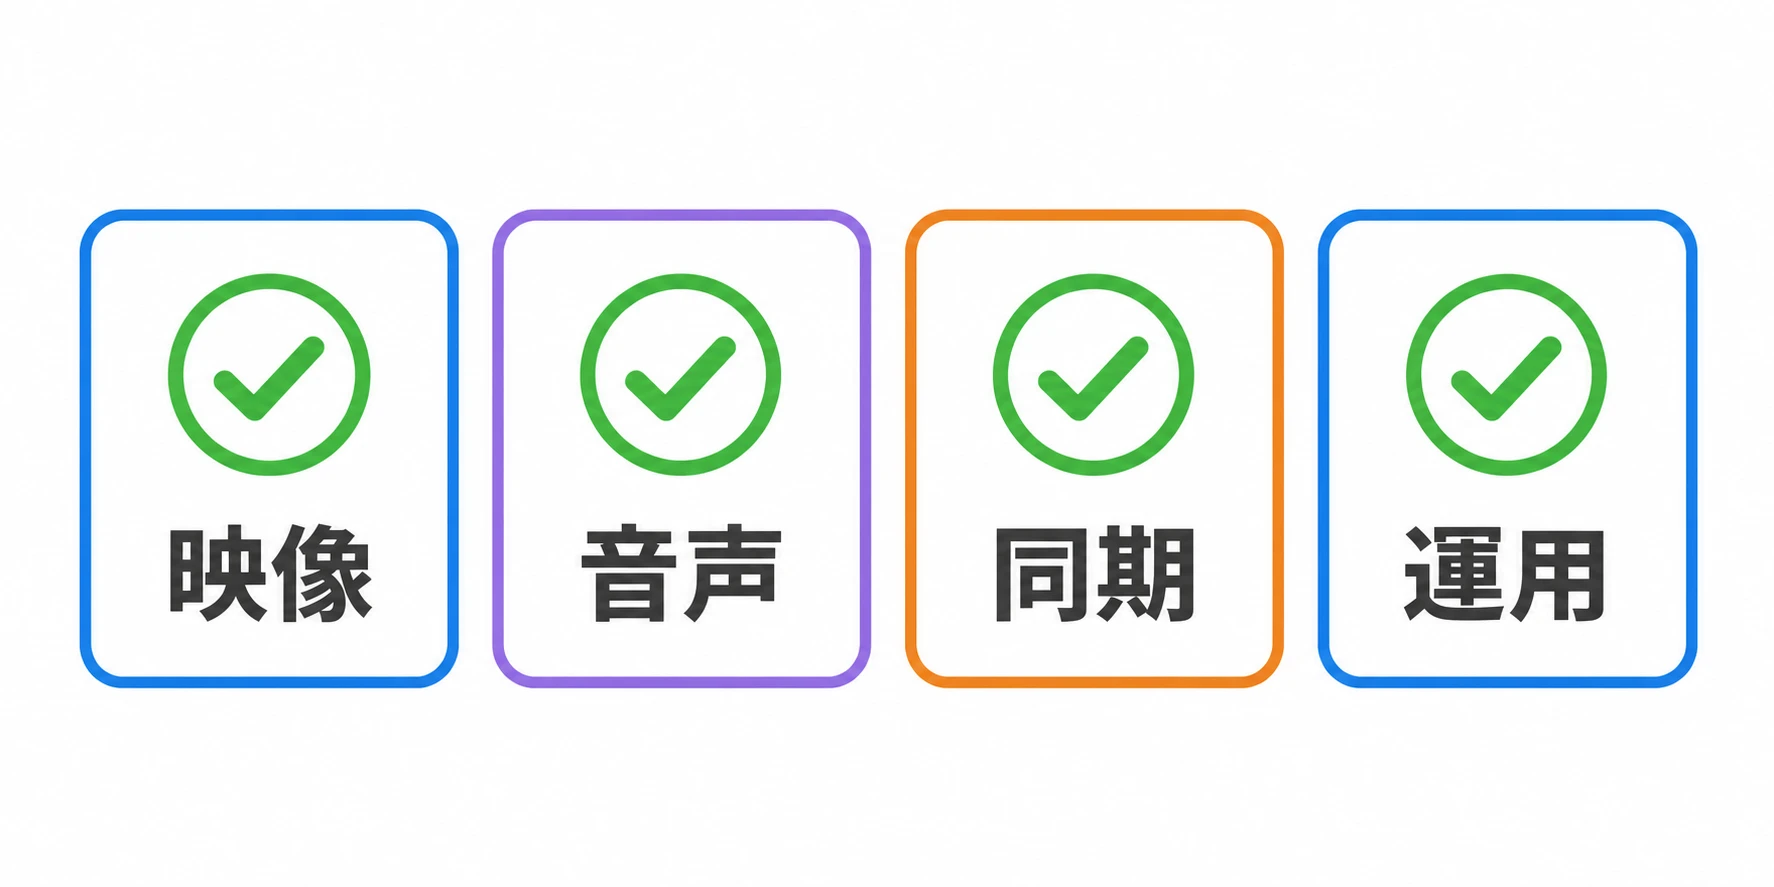
| 運用 | 履歴、出力版、承認者、提供条件を追跡できるか | 保存場所、確認者、差し替え手順、利用条件 |
モデル選定の考え方は、生成AI比較で扱う性能・料金・セキュリティの比較と同じです。最上位モデルを一つ選ぶのではなく、試作、編集、承認、公開という工程ごとに、必要な品質と人の確認を置きます。
広告の最終版では、生成速度よりも、意図したメッセージを崩さず確認できることを優先する判断もあり得ます。
ポイント
映像・音声・同期・運用の4軸で採用率や修正時間を記録し、1本の見栄えではなく制作プロセス全体の効率で評価します。
まとめ|音声同時生成は制作の初稿を変えるが、承認は残る
Veo 3.1は音声を含む動画生成モデルとして紹介され、Veo 3は効果音、環境音、台詞をネイティブに生成すると説明されています。GoogleのV2A研究は、動画ピクセルとテキストプロンプトから同期した音声を生成し、Sora 2も同期した台詞と効果音を特徴として発表されました。動画生成AIは、映像と音声を別工程で作る前提を見直すきっかけになります。
一方、音声品質は映像入力に左右され、リップシンクなどの課題も残ります。発表された機能と現在の提供状況も同じではありません。企業が広告・制作へ取り入れるなら、短い代表サンプルで映像・音声・同期・編集時間を評価し、提供条件と承認フローを確認したうえで、まず初稿や案出しから範囲を広げるのが現実的です。
ポイント
Veo・Sora 2は音声同時生成という初稿の作り方を変えますが、事実確認・権利・公開判断は引き続き人が担います。
よくある質問(FAQ)
Q. Veo 3.1は音声付きの動画を生成できますか?
Google DeepMindの公式ページでは、Veo 3.1を音声を含む動画生成モデルと説明しています。また、Veo 3については、効果音、環境音、台詞を作品へ追加し、音声をネイティブに生成すると案内しています。利用できる機能や提供条件は、実際に使う製品の公式情報で確認してください。
Q. GoogleのV2Aとは何ですか?
V2Aはvideo-to-audioの研究技術で、動画のピクセルと自然言語のプロンプトから、画面上の動きに合う音声を生成します。Google DeepMindは、Veoのような動画生成モデルとの組み合わせ、複数のサウンドトラック生成、音声と映像の自動同期を説明しています。
Q. Sora 2は現在も利用できますか?
OpenAIのSora 2公式ページには、Sora製品が2026年4月26日から利用できなくなったと記載されています。発表時のモデル機能と現在の製品提供を混同せず、利用を検討する時点の公式案内を確認してください。
Q. 生成した音声付き動画を広告にそのまま使えますか?
公式の機能紹介だけでは、個別の広告利用条件や契約上の可否までは判断できません。実際に使う製品の利用規約・契約・提供地域を確認し、映像、台詞、音楽、声、ブランド表現、事実関係を人がレビューしてから公開する運用にします。
参考情報:
Google DeepMind「Veo」
Google DeepMind「Generating audio for video」
OpenAI「Sora 2 is here」
関連記事
会社紹介
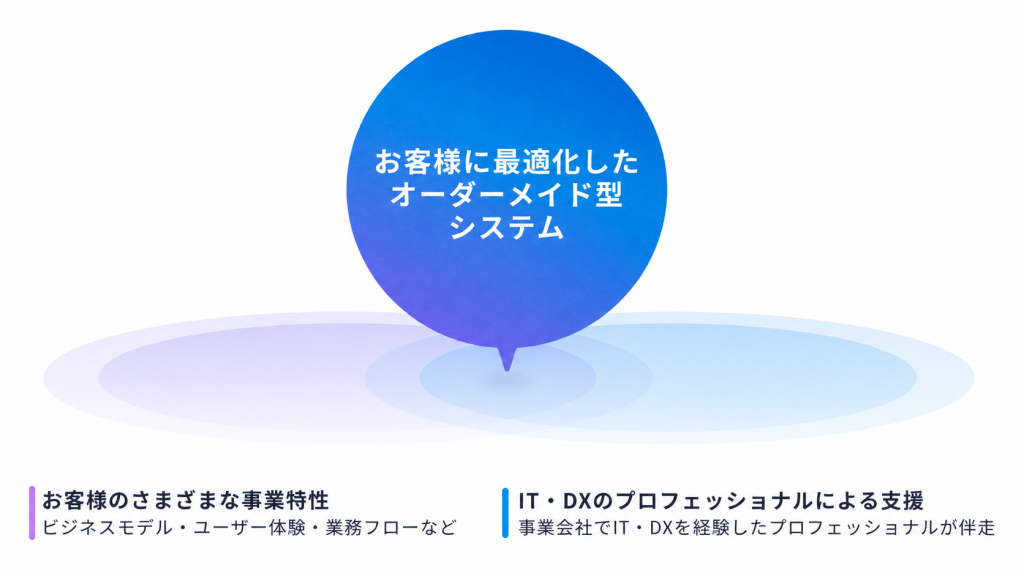
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。
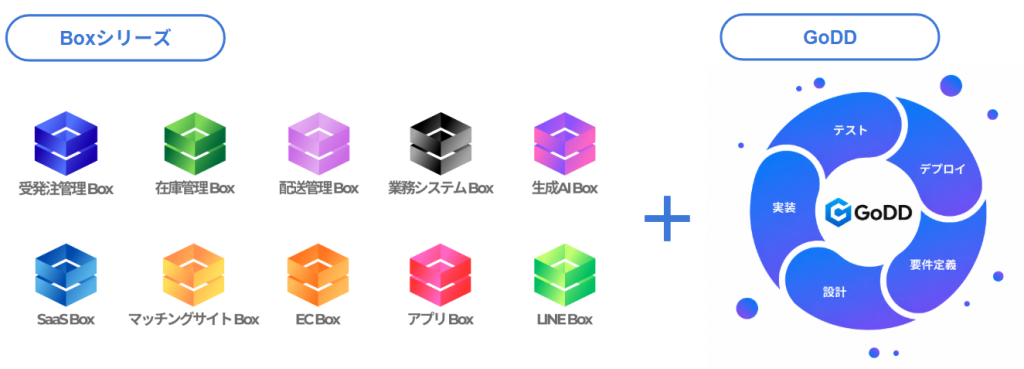
また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。
もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>
株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。