
Grok 4.5を含むモデルのコーディング1タスクの費用は、利用モデルとトークン消費量によって、約2.49ドルから約11.80ドルの幅があります。検索回数も費用を左右します。
費用を見積もるには、単価だけでなく1タスクのトークン消費量も見る必要があります。総合評価と実務タスクの違いも判断材料です。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Grok 4.5の概要、リリース背景と位置づけ
Grok 4.5は2026年7月8日に発表され、翌9日に一般公開されました。
xAIがコーディング、エージェント、知識を扱う業務を明確に掲げた初のモデルです。また、会話文の生成に加えて、コードの作成や複数の処理の実行、業務知識の活用を意識して設計されています。
SpaceXAIとxAIの呼び方が混在する理由
発表資料や報道で開発元が「SpaceXAI」と表記されるのは、xAIが2026年2月にSpaceXと全株式合併したためです。呼称が違っても、別のモデルではありません。
呼称をそろえたうえで、モデルを比べるときは次の3点を整理しておきます。
- 呼称:文脈に応じたxAIとSpaceXAIの使い分け
- モデルの位置づけ:性能、速度、トークン効率、APIコストのバランス
- 選定時の観点:ベンチマーク順位と日常業務の費用の比較
たとえば、比較する業務にはコード修正、調査、エージェント実行などがあります。
モデルを採用するときは、生成AI比較の観点から、性能だけでなく料金やセキュリティもそろえて確認します。
性能・ベンチマークで見るGrok 4.5の実力
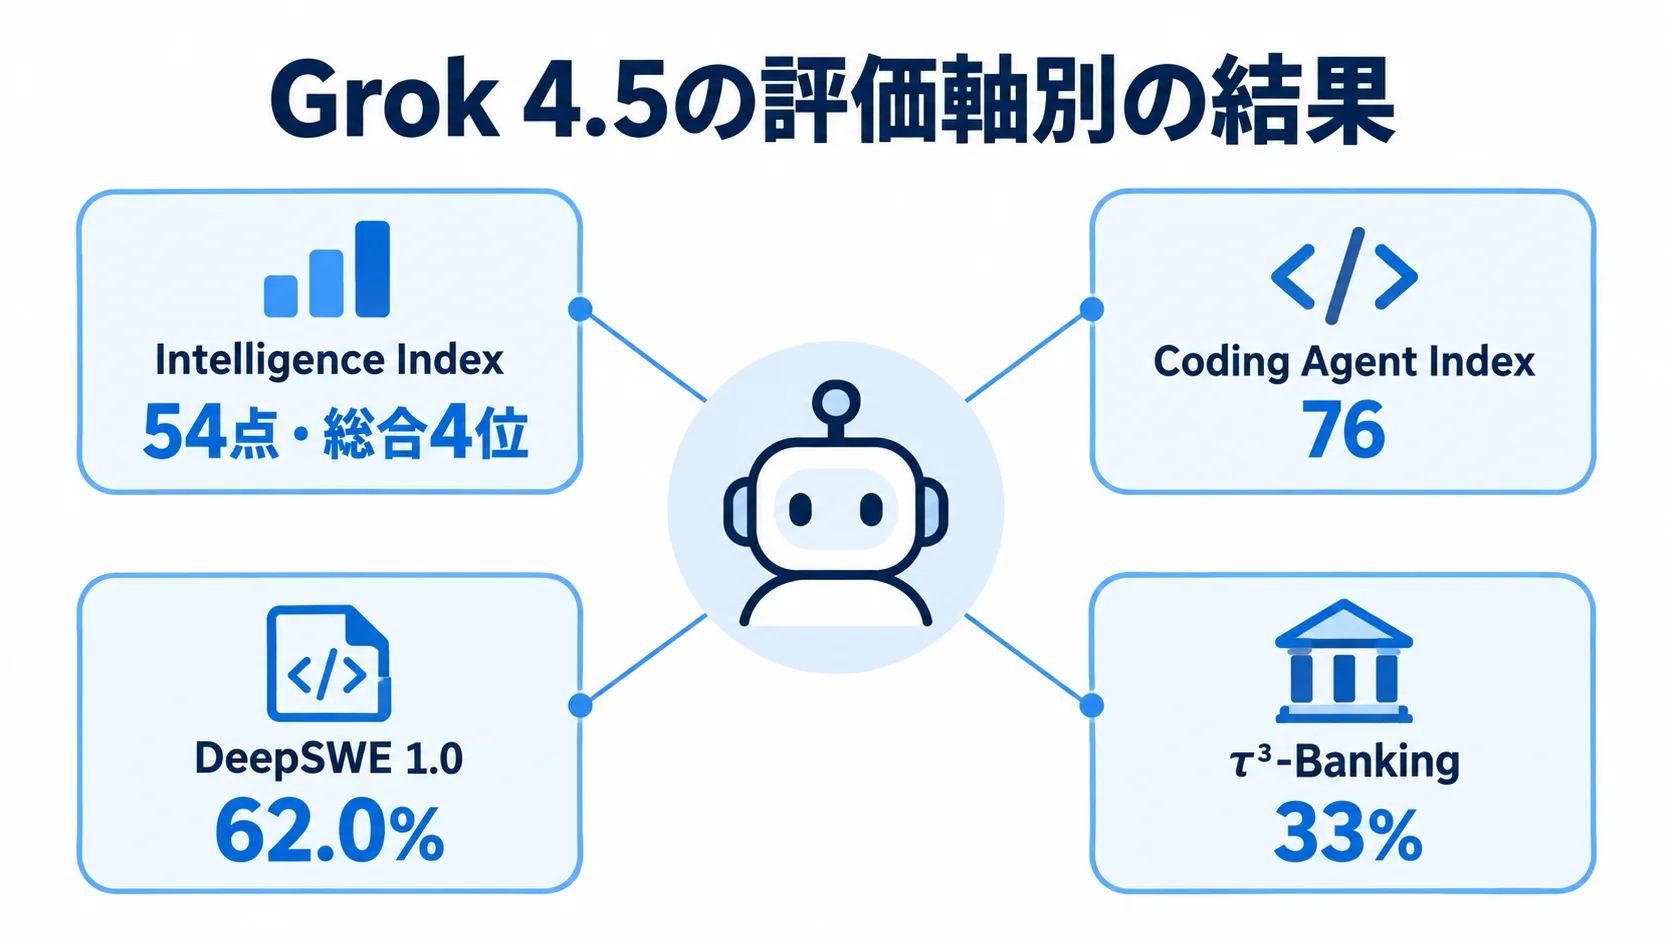
Artificial AnalysisのIntelligence Indexでは、Grok 4.5が54点で総合4位でした。上位には、Fable 5、GPT-5.5、Opus 4.8が並びます。
Grok 4.3からは16ポイント上がり、フロンティアモデルの上位グループに入る実力を示しています。ただし、総合的な知能評価で世界一とはいえません。
コーディングとエージェントでは上位モデルに接近
コーディングとエージェントの評価では、次の結果が示されています。
- Coding Agent Index:76で、Codex GPT-5.5のxhigh設定と同等
- Claude Code Fable 5 max:約1点差
- DeepSWE 1.0:62.0%
- τ³-Banking:33%でトップ
Coding Agent Indexは、コードを一度生成するだけでなく、ツールで修正や検証を繰り返すタスクを評価します。
上位陣と互角に近い結果です。
総合知能の指標と実務タスクの指標は、分けて読む必要があります。文章の正確さや幅広い知識を含む評価では4位ですが、開発作業では別の強みが出ます。
自社で評価するときは、実際のリポジトリや業務データに近い課題を使うと、比較しやすくなります。
Grok 4.5の料金体系|API単価と利用時の注意
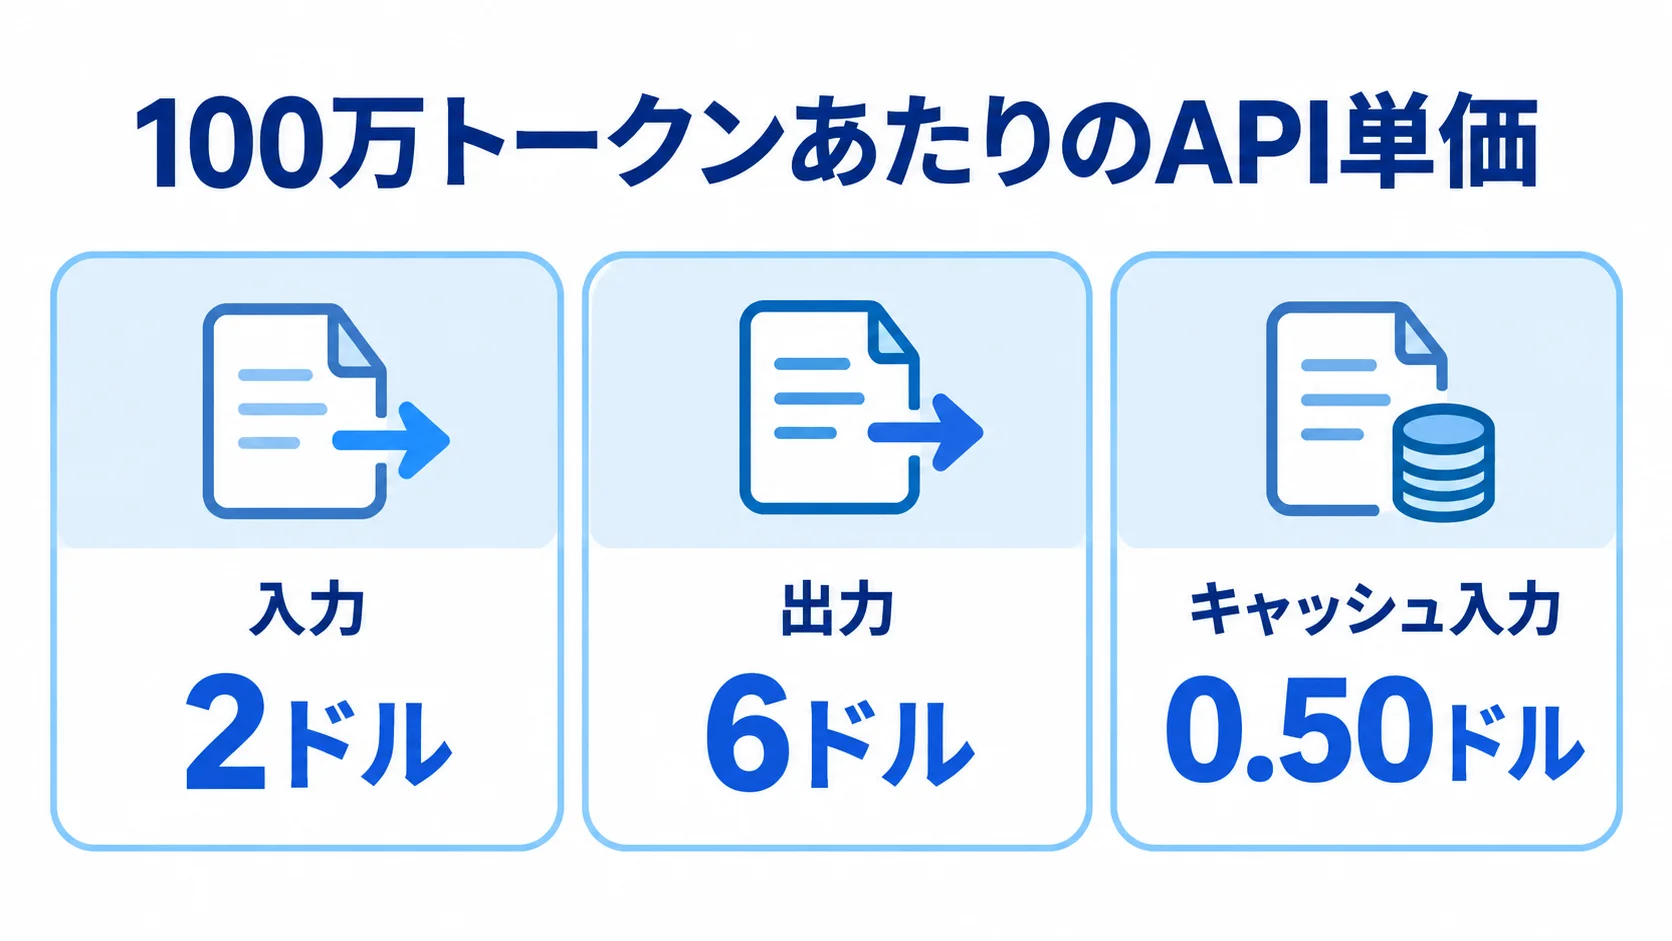
xAIの開発者向けドキュメントによると、入力は100万トークンあたり2ドル、出力は6ドルです。キャッシュ入力は0.50ドルで、通常の入力から75%引きになります。
コンテキスト長は50万トークンです。
長い資料やコードベースを扱うときは、毎回どこまで入力するかで実費が変わります。
200Kトークン超過と検索ツールの課金
200Kトークンを超えると、入力も出力も含めてすべて2倍で課金されます。
上限は50万トークンあるものの、長文を無制限に送る使い方が得策とは限りません。そのため、履歴や資料は必要な範囲に絞り、再利用できる部分にはキャッシュを使うと、費用を管理しやすくなります。
検索を使う場合や他モデルと比べる場合は、追加料金と単価の差も確認しておきます。
- Web検索・X検索:ツール料金は1,000回あたり5ドル
- Opus系との単価差:入力5ドル、出力25ドルで、Grok 4.5の約2.5倍と約4倍
最終的な請求額は、利用量と処理の設計で決まります。
「Opus級」と比べるときは、Claude Opus 5との比較と同じく、測定条件や価格、利用環境をそろえて確認します。
「安くてOpus級」の実像と二面性
「Opus級」という表現は、誰がどの指標で評価したかを確かめて読むことが大切です。
Musk氏はGrok 4.5を「Opus-class」と呼び、より速く、トークン効率が高く、低コストだと説明しています。
Musk氏の社内評価では、Opus 4.7と概ね同等で、はるかに速いとされています。これはMusk氏による自己評価で、第三者ベンチマークの順位とは別のものです。
一方、第三者のArtificial Analysisでは、Intelligence Indexが54点で総合4位です。純粋な知能指標では最上位に一歩譲ります。その一方で、Coding Agent Indexは76で、コーディングやエージェントでは上位と互角に近い評価です。
同じ評価でのコーディング1タスクあたりの費用にも、モデルごとに差があります。
安さを左右する単価と消費量
コーディングの費用効率は、1タスクのトークン消費量と料金、正答率を合わせて見ると判断しやすくなります。モデル間の違いは、次の3点に表れています。
- 平均トークン数:Grok 4.5は190万、Fable 5は720万
- 1タスクの費用:Grok 4.5は約2.49ドル、Fable 5は約11.80ドル、GPT-5.5は約5.07ドル
- 正答率とハルシネーション率:正答率は52%、ハルシネーション率は54%で、Grok 4.3の35%と25%から変化
単価と消費量が組み合わさるため、上位モデルと比べると総費用はおおむね1/2〜1/5、トークン効率は3〜4倍です。
コードのたたき台や反復開発では、コスト効率を期待できます。一方で、事実確認が必要な調査や意思決定では、根拠の確認と人のレビューが前提になります。
Grok 4.5の使いどころと注意点
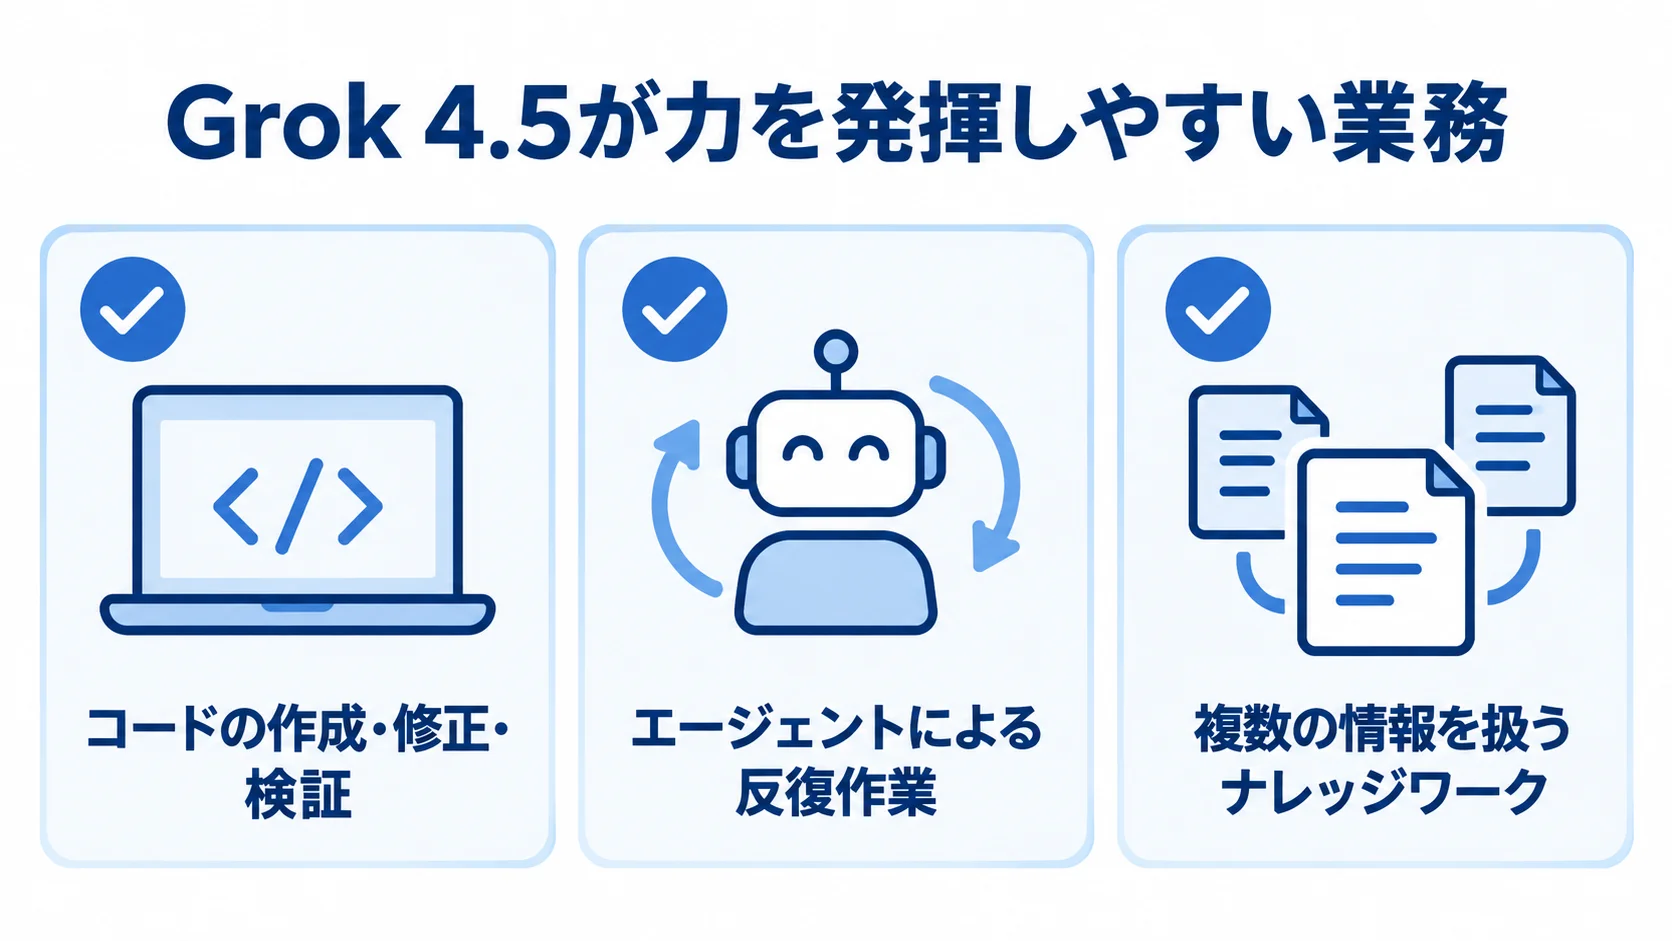
Grok 4.5が力を発揮しやすいのは、コードの作成・修正・検証、エージェントによる反復作業、複数の情報を扱うナレッジワークです。
単発の質問より、ツールを呼び出しながら進める業務で、Coding Agent Indexやタスク単価の強みが生きます。検索を使う場合は、回数も費用に含めて考えます。
利用できるのは、Grok Build、Cursorの全プラン、SpaceXAIのコンソールです。なお、当初はEUで未提供でしたが、その後提供が始まりました。
選定時は、必要なチャネルで使えるか、既存の環境や業務フローに組み込めるかを確かめておきます。利用場所や権限の設計が合わないと、性能を活かしにくくなります。
事実確認が必要な業務での使い方
精度が重要な業務では、用途に応じて確認の方法を決めておきます。
- 顧客向け説明や契約情報:参照元の確認と、人による出力の承認
- 数値に基づく判断:根拠を確かめてからの利用
- 開発コード:本番投入前のテストとレビュー
特に、ハルシネーション率は54%と高めのため、事実確認なしの運用は避けます。
ターミナル型エージェントとの組み合わせを検討するなら、Muse Codeのように、モデル以外の実行環境も比較の対象に入れます。
Grok 4.5のまとめ|実装前に見るべきポイント
Grok 4.5は入力2ドル、出力6ドル、キャッシュ入力0.50ドルで、コンテキスト長は50万トークンです。コーディングとエージェントのタスクでは、高い費用対効果を示しています。
第三者のArtificial Analysisでは、Intelligence Indexが54点で総合4位、Coding Agent Indexは76です。
Musk氏の「Opus-class」は自己評価です。純粋な知能指標では最上位に一歩譲る一方で、実務コーディングでは上位と互角に近いと見られます。
導入の前には、自社の代表的なコーディングやエージェントのタスクを用意しておくことが大切です。品質と処理時間を同じ条件で比べます。加えて、トークン数や検索回数、1タスクあたりの費用も見ておきます。
ハルシネーション率54%を踏まえ、人の確認を残す工程も決めておく必要があります。
価格表だけでなく業務フローまで評価すると、費用対効果を成果につなげやすくなります。
AIモデルやエージェントを実装するには、まず対象業務を整理し、データやツールとどうつなぐかを決める必要があります。評価方法と運用時の確認の流れも、あわせて設計しておくと、現場で使える仕組みになります。
riplaでは、AIを活用した業務システムについて、課題の整理から実装まで一貫して支援しています。
Grok 4.5を含むモデルの選定や、実務に合わせた検証を進める場合は、対象業務と困りごとをお聞かせください。
よくある質問(FAQ)
Q. Grok 4.5の料金は?
入力は100万トークンあたり2ドル、出力は6ドルで、コンテキストは50万トークンです(2026年7〜8月時点)。Opus系は入力5ドル、出力25ドルです。
Q. 「Opus級」というのは本当ですか?
「Opus級」はイーロン・マスク氏による自己評価です。第三者評価のArtificial Analysisでは総合4位で、コーディングやエージェントでは上位陣に迫る一方、純粋な知能指標では一歩譲ります。
Q. Grok 4.5はどこで使えますか?
Grok Build、Cursor(全プラン)、SpaceXAIのコンソールで利用できます。
EUは当初対象外でしたが、その後提供が始まりました。
Q. 精度面の注意点は?
正答率は改善した一方、ハルシネーション率は54%と高めに報告されています。正確性が最重要の用途では、検証を前提に運用します。
参考情報:
xAI Developers「Release notes」
Artificial Analysis「Grok 4.5 brings SpaceXAI to the intelligence frontier」
TechCrunch「SpaceXAI releases Grok 4.5, which Elon describes as an ‘Opus-class’ model」
CNBC「Musk’s xAI and SpaceX complete merger」
関連記事
関連するモデル比較やAIエージェントの記事も、選定や実装の参考になります。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。