
バックオフィスAIエージェントの開発は、企画・業務分析から運用・チューニングまで、5つのフェーズを順に進めます。
経理や人事などの間接業務では、AIエージェントの活用が増えています。全体像は完全ガイドでも解説しています。
▼全体ガイドの記事
・バックオフィスAIエージェント開発・構築の完全ガイド
- 全体像:5つのフェーズの流れと、業務領域ごとの自動化の範囲
- 導入手順:PoCから運用までの各段階の進め方と、契約形態の選び方
- よくある失敗パターン:スコープ肥大化、データ品質の過大評価、現場の反発と、それぞれの回避策
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
バックオフィスAIエージェントの背景と全体像
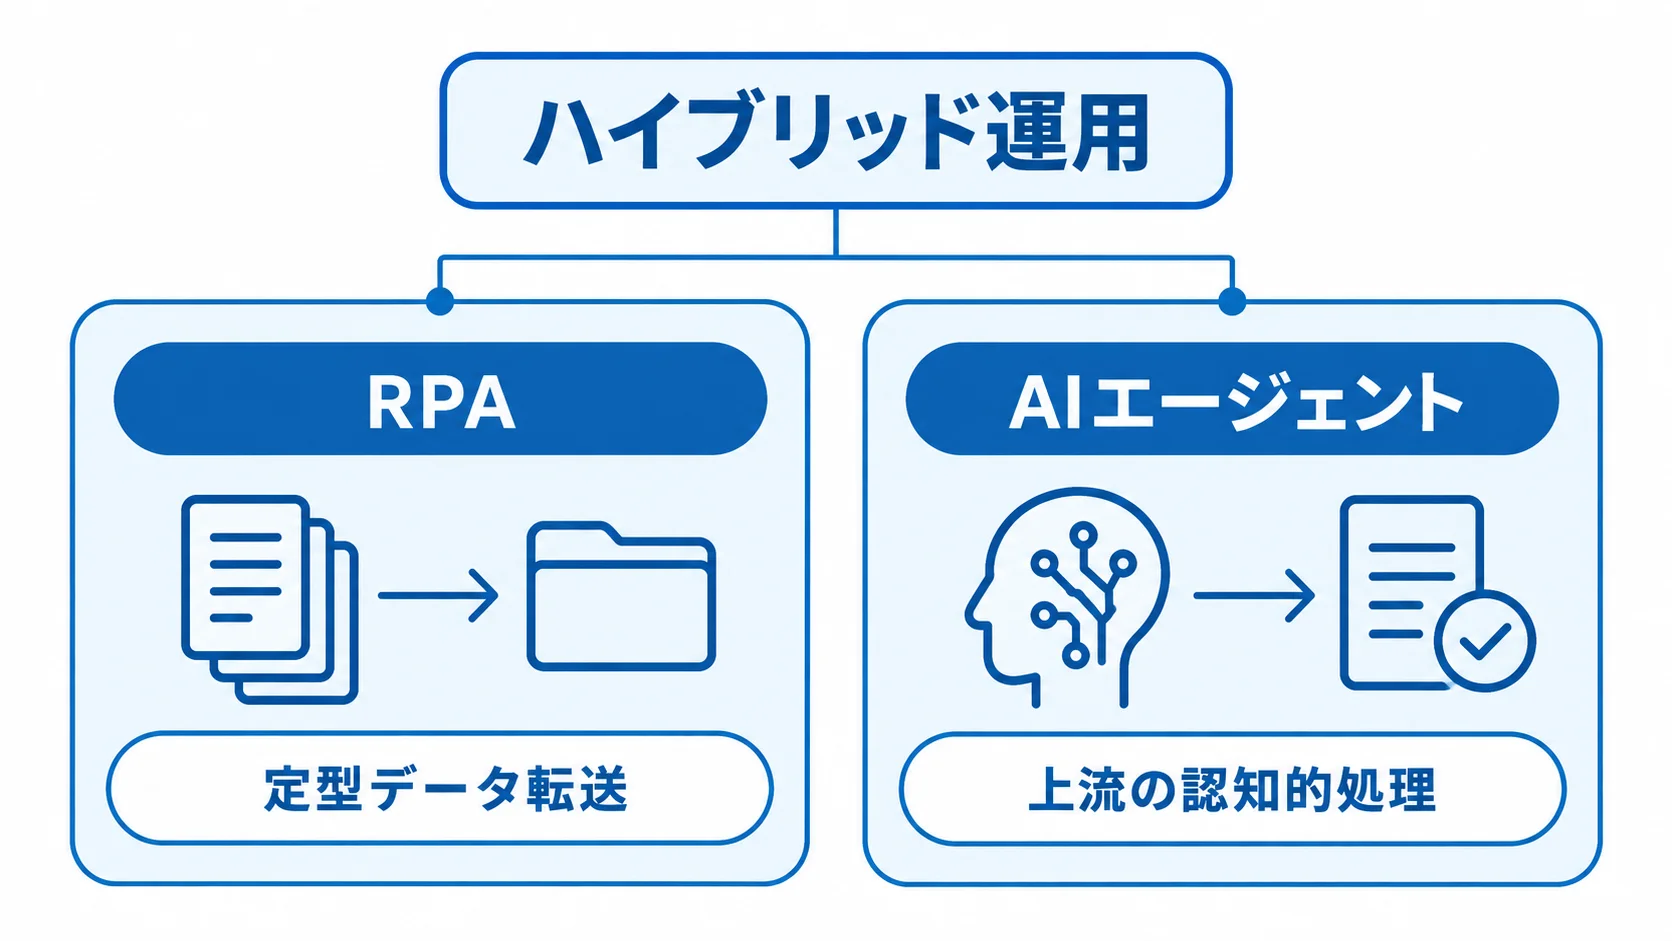
バックオフィス業務は、経理や人事、法務など多岐にわたり、企業規模が大きくなるほど処理量も膨大になります。従来はRPA(ロボティック・プロセス・オートメーション)や基本的なルールベースのチャットボットで自動化が試みられてきました。しかし、入力データの形式が変わったり例外が起きたりすると、うまく対応できず、保守コストが膨らみやすいという課題がありました。
一方、AIエージェントは、大規模言語モデル(LLM)を推論エンジンとして備えています。非構造化テキストの読み取りや文脈に応じた判断、外部APIの動的な呼び出しが可能です。これにより、従来のRPAが苦手としていた例外処理や書式の揺らぎへの対応が大幅に改善されています。
RPAとAIエージェントの違い
RPAは画面操作の自動模倣を得意とし、入力フォームが固定された反復業務で力を発揮します。一方、AIエージェントはLLMの推論能力を生かして、非定型な業務にも対応できます。たとえば、書式がばらばらな請求書を読み取り、社内規定と照合しながら仕訳を生成するといった処理が可能です。
多くの先進企業では、RPA単独ではなく、AIエージェントと組み合わせたハイブリッド運用を採用しています。具体的には、RPAは安定した定型データ転送に特化させ、上流の認知的処理をAIエージェントが担う形が主流になっています。
このような棲み分けを意識すると、既存のRPA資産を生かしながら、段階的にAIエージェントを導入できます。また、全システムを刷新するリスクを取らず、高い費用対効果を実現できる点が、ハイブリッド運用の最大のメリットです。
バックオフィスで自動化できる業務の範囲
AIエージェントがバックオフィスで高い効果を発揮しやすい領域は、大きく5つに分類されます。領域ごとに、読み取りや照合、問い合わせ対応、文書作成などの業務が自動化の候補になります。自動化の対象は、この5領域を順に確認して絞り込みます。
- 経理・財務:請求書読み取り・仕訳生成・経費精算の検証・売掛金消込
- 人事・採用:履歴書スクリーニング・社員からの問い合わせ対応・オンボーディング資料作成
- 法務・コンプライアンス:契約書レビュー・社内規定との差分チェック・稟議書ドラフト作成
- 情報システム:IT問い合わせ対応・ログ監視・トラブルシューティング文書の自動生成
- 調達・総務:在庫モニタリング・発注書自動生成・会議アジェンダ作成・議事録要約
一方で、税務申告への最終署名や高度な判断が求められる経営判断、デリケートな人事評価など、専門家や管理職の承認が欠かせない業務もあります。こうした業務では、AIエージェントを補助ツールとして位置づけるべきです。そのため、自動化できる領域と人間が担う領域を明確に切り分けることが、プロジェクトを成功させる出発点となります。
バックオフィスAIエージェントの導入ステップ全体像
企画から運用までの5つのフェーズは、「企画・業務分析」「要件定義・データ整備」「PoC(概念実証)」「本開発・統合」「運用・チューニング」の順に進めます。前のフェーズを飛ばして本開発に入ると、後工程での手戻りや品質問題のリスクが大きく高まります。そのため、各フェーズで達成すべき成果物と承認基準を明確にしたうえで、次のフェーズへ進みます。
フェーズ1:企画・業務プロセス分析
最初のフェーズでは、自動化の対象となる業務を細かく分解します。対象業務の各ステップを書き出し、データの入出力やシステムとの連携箇所も一覧にします。例外処理や人間の承認ポイントも、あわせて洗い出します。
同時に、現状の業務量(月次の処理件数・所要時間・エラー発生率など)をベースラインKPIとして計測します。この計測があれば、後工程でAIエージェントの効果を客観的に評価できます。
業務の分解が粗いまま進むと、AIエージェントに求める機能が曖昧になり、仕様変更が多発します。そのため、「どの業務のどのステップを自動化するのか」を具体的な粒度で決めることが、このフェーズの最も重要な成果物になります。
フェーズ2:要件定義・データ整備の概要
企画フェーズが終わったら、技術的な要件定義とデータ整備に進みます。AIエージェントが自律的に実行できる範囲(自律スコープ)と、人間の承認を必要とする範囲を、発注側と開発会社で明確に定義します。セキュリティ要件(データ暗号化・テナント分離・外部モデルへのデータ流出禁止)も、後から付け足さず要件定義の段階で文書にしておきます。
データ整備は開発コストの大部分を左右する工程です。そのため、社内に散在する文書の正規化や用語の統一、APIコネクタの設計を並行して進めます。データ前処理は外部ベンダーに丸投げするとコストが膨らみやすいため、基礎的なクレンジングは社内リソースで担当するのが、コスト削減の有効な手段です。
要件定義書とデータ仕様書がそろった段階で、開発パートナーとの正式な契約交渉に進みます。
各ステップの具体的な進め方
要件定義のあとは、PoC、本開発、運用定着の3段階で進みます。段階ごとの進め方と、押さえておきたい点を順に見ていきます。
PoC(概念実証)フェーズの進め方
PoCは、本開発にコミットする前にAIエージェントの中核機能を検証する段階で、費用の相場は概ね100万円〜500万円程度の投資になります。PoCで最も重視すべき検証項目は、「意図理解の精度」「APIレスポンスの安定性」「実務データでの動作確認」の3点です。
サンプルデータではなく、実際の業務データ(請求書・契約書・問い合わせメールなど)を使ってプロトタイプをテストすると、本番環境での挙動を現実的に評価できます。PoCの評価軸は、「意図マッチング精度」「API接続の成功率」「処理レイテンシー」などの定量指標で、事前に決めておきます。
合格基準を満たした場合にだけ本開発に進むと決めておけば、見切り発車による多大な追加コストを防げます。また、PoCの段階では準委任契約(jun-inin)を選ぶのが一般的で、AIの確率的な性質に起因する成果保証のリスクを双方が適切に分担できます。
本開発・システム統合フェーズの進め方
PoCで性能が検証されたら、プロダクションレベルのシステム開発に移ります。このフェーズでは、GUIの構築とセキュアなAPIコネクタの実装を中心に進めます。ログ取得・監査機能の組み込みとホスティング環境の整備も、並行して行います。
GUIやAPIインターフェースのように結果が定まっている成果物は、請負契約(ukeoi)への切り替えを検討すると、予算の確実性が高まります。また、開発コストはエンジニアの稼働工数に左右されるため、要件のスコープを明確に管理しておくことが欠かせません。
スコープを追加する場合は、都度コストとスケジュールへの影響を評価し、関係者の合意を得てから対応します。こうした変更管理の流れを、開発の初期にあらかじめ決めておきます。さらに、ユーザーが出力を検証・承認できる「Human-in-the-Loop」の仕組みも、この段階で本番環境に組み込みます。
運用・チューニングフェーズの進め方
リリース後は、AIOpsモニタリングの仕組みを整備し、モデルドリフト(時間経過による精度低下)や例外パターンを継続して監視します。そのうえで、人間のオペレーターが修正した例外ケースを集めてアノテーションし、プロンプトの調整やモデルの再チューニングに使うフィードバックループを作ることが、長期的な精度維持の鍵です。
また、現場スタッフがAIエージェントの動作を理解し、出力を適切に判断・承認できるように、AIリテラシー研修を計画して実施します。技術の完成度だけでなく、組織の文化的な変化も技術開発と並走させることが、運用定着を早める要素になります。
よくある失敗パターンと回避策
バックオフィスAIエージェントの開発・導入では、プロセスの各段階に特有の落とし穴があります。よくある失敗を事前に知っておくと、プロジェクトの設計段階から予防策を講じられます。
スコープ肥大化と要件定義不足
最も多い失敗は、最初から全機能を盛り込もうとしてスコープが膨らみ、開発期間とコストが想定を大きく超えるケースです。バックオフィス業務は部門横断的に連携しているため、一度自動化の話が進むと「ついでにこの業務も」という要求が次々に追加されがちです。
回避策としては、最初のリリースを「最小限の価値ある機能セット(MVP)」に絞り込み、追加機能は次フェーズに先送りするロードマップ管理を徹底することが有効です。加えて、要件定義の段階で「AIエージェントが担う範囲」と「人間が担う範囲」を文書にまとめ、関係者全員の合意を取り付けておきます。これが、後工程でのスコープ拡大を防ぐ根本的な対策になります。
データ品質の過大評価と整備不足
「社内に大量のデータがある」と思っていたものの、実際には散らばっていたり断片化していたり、書式がそろっていなかったりして使えないケースも、頻繁に起こります。AIエージェントはRAG(検索拡張生成)やファインチューニングのために構造化されたデータが必要であり、データ前処理にかかる工数とコストを事前に見積もっておくことが不可欠です。
データ前処理を外部ベンダーに丸投げすると、費用がかさみがちです。そのため、基礎的なクレンジング作業は内製化する体制を整えることをおすすめします。
プロジェクトの開始前に「データ棚卸し(データ品質監査)」を行い、実際に使えるデータの量と質を洗い出します。これにより、コスト見積りの精度が高まり、開発パートナーとも合意しやすくなります。
現場の反発と組織的な定着失敗
システムが完成しても、現場スタッフが使いこなせなかったり、抵抗感から利用されなかったりするケースは珍しくありません。
バックオフィス担当者は「AIに仕事を奪われる」という不安を抱えやすいため、導入の目的は、作業の代替ではなく「高付加価値業務へのシフト」だと明確に伝えます。並行して、AIエージェントの動作原理や出力の検証方法に関する社内研修も計画的に実施します。
業務プロセスを熟知しているフロントラインの担当者を、プロジェクトの初期段階から巻き込みます。UIの設計や例外処理ルールの策定に参加してもらうことで、現場起点の改善意識が育ちます。さらに、組織の文化的な変化を技術開発と並走させることが、長期的な定着に欠かせません。
契約形態と開発パートナー選定のポイント
AIエージェント開発は、従来のソフトウェア開発と違って、成果物の挙動が確率的です。そのため、契約形態の選び方が、開発パートナーとのリスク分担や品質管理に大きく影響します。
2フェーズ・ハイブリッド契約モデル
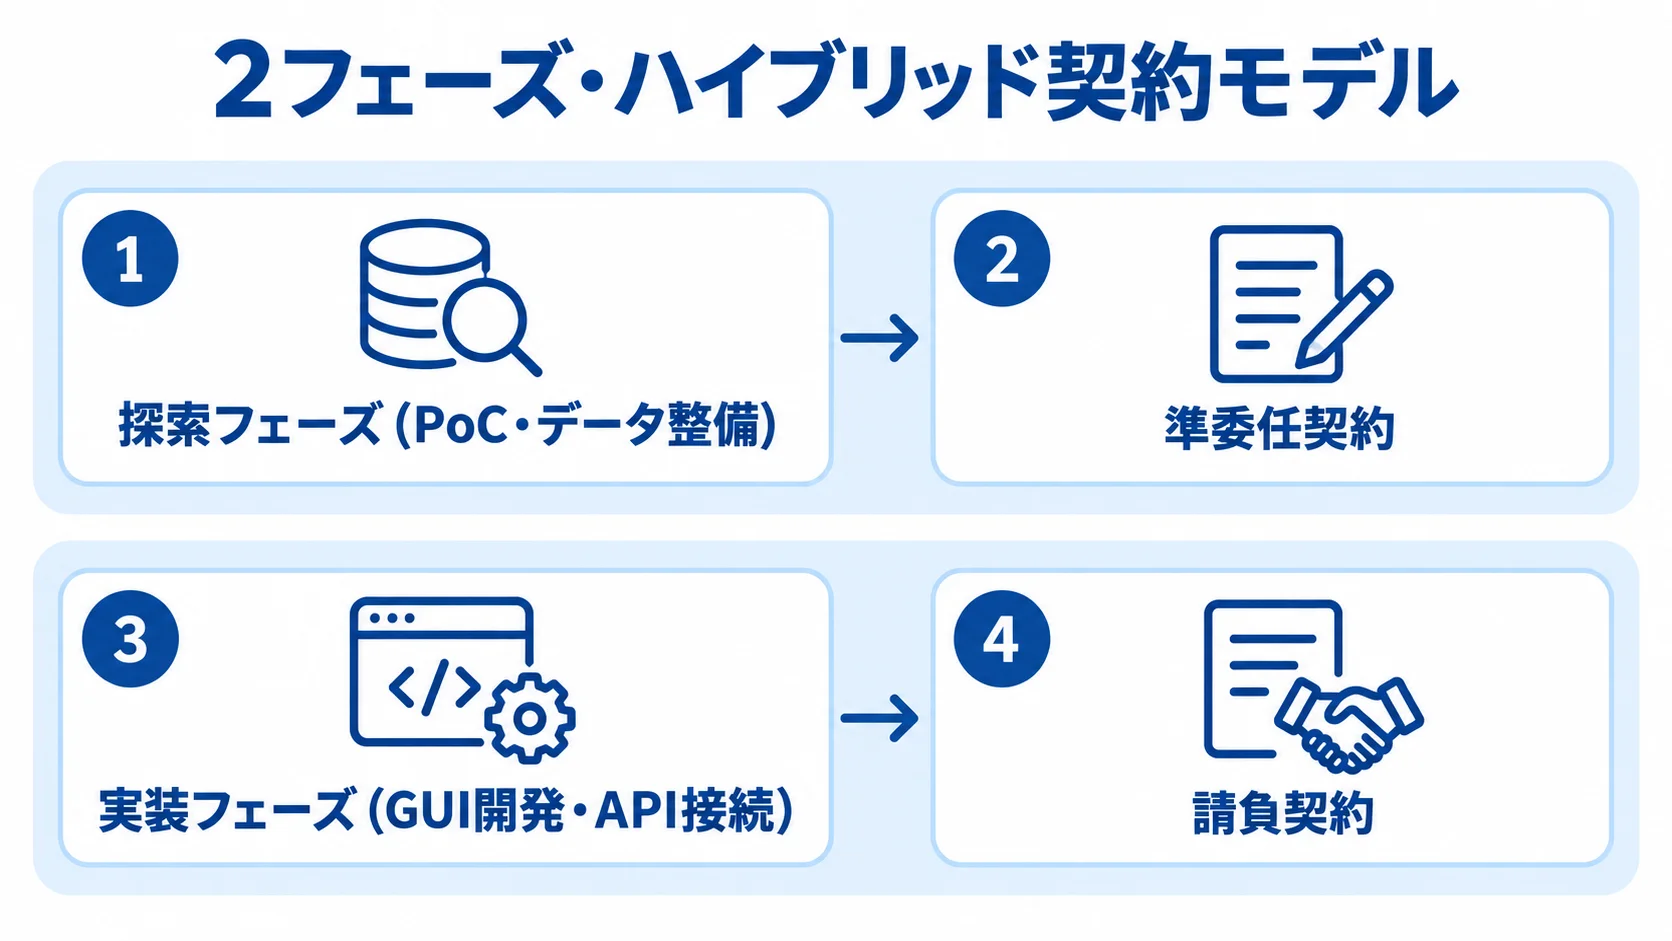
AI開発の現場では、探索フェーズ(PoC・データ整備)に準委任契約を、実装フェーズ(GUI開発・API接続)に請負契約を組み合わせる「2フェーズ・ハイブリッド契約モデル」が広まっています。
準委任契約は、業務の遂行(プロセス)に対して対価を支払う形式で、モデルの不確実性が高い探索段階に適しています。一方、請負契約は、UIやデータベース連携のように成果物が確定した段階で適用すると、予算の予測可能性が高まります。
この契約モデルを採用すると、発注者側はPoC段階での無制限な費用膨張リスクを抑えつつ、開発パートナーには本番実装に向けた明確な目標と予算枠を提示できます。加えて、契約書には「自社データを外部モデル提供者のパブリックトレーニングに使用しない」旨を明文化することも、セキュリティ管理の観点から不可欠です。
開発パートナー選定の基準
開発パートナーを選ぶ際は、費用だけでなく、バックオフィス業務への理解度や実績、セキュリティ対応の具体策を評価軸にします。テンプレートや既製コンポーネントを生かしてコストを抑える力も、判断材料になります。
企業規模によって候補も変わります。中小企業向けには「スモールスタート設計」に強いパートナーが適しており、大企業向けには複雑な基幹システムとの統合実績を持つ開発会社が候補になります。
また、補助金・助成金の活用も検討に値します。日本では働き方改革推進支援助成金など、AI・デジタル化投資に活用できる公的支援制度があり、対象となる中小企業では実装コストの相当部分を賄える場合があります。開発パートナーが補助金の申請サポートの実績を持つかどうかも、選定基準の一つに加えるとよいでしょう。
セキュリティとガバナンスの設計指針
バックオフィスAIエージェントは、請求書や従業員情報、契約書など機密性の高いデータを扱います。そのため、セキュリティとガバナンスの設計は、開発の後付けではなく要件定義の段階から組み込む必要があります。
データセキュリティとプライバシーの確保
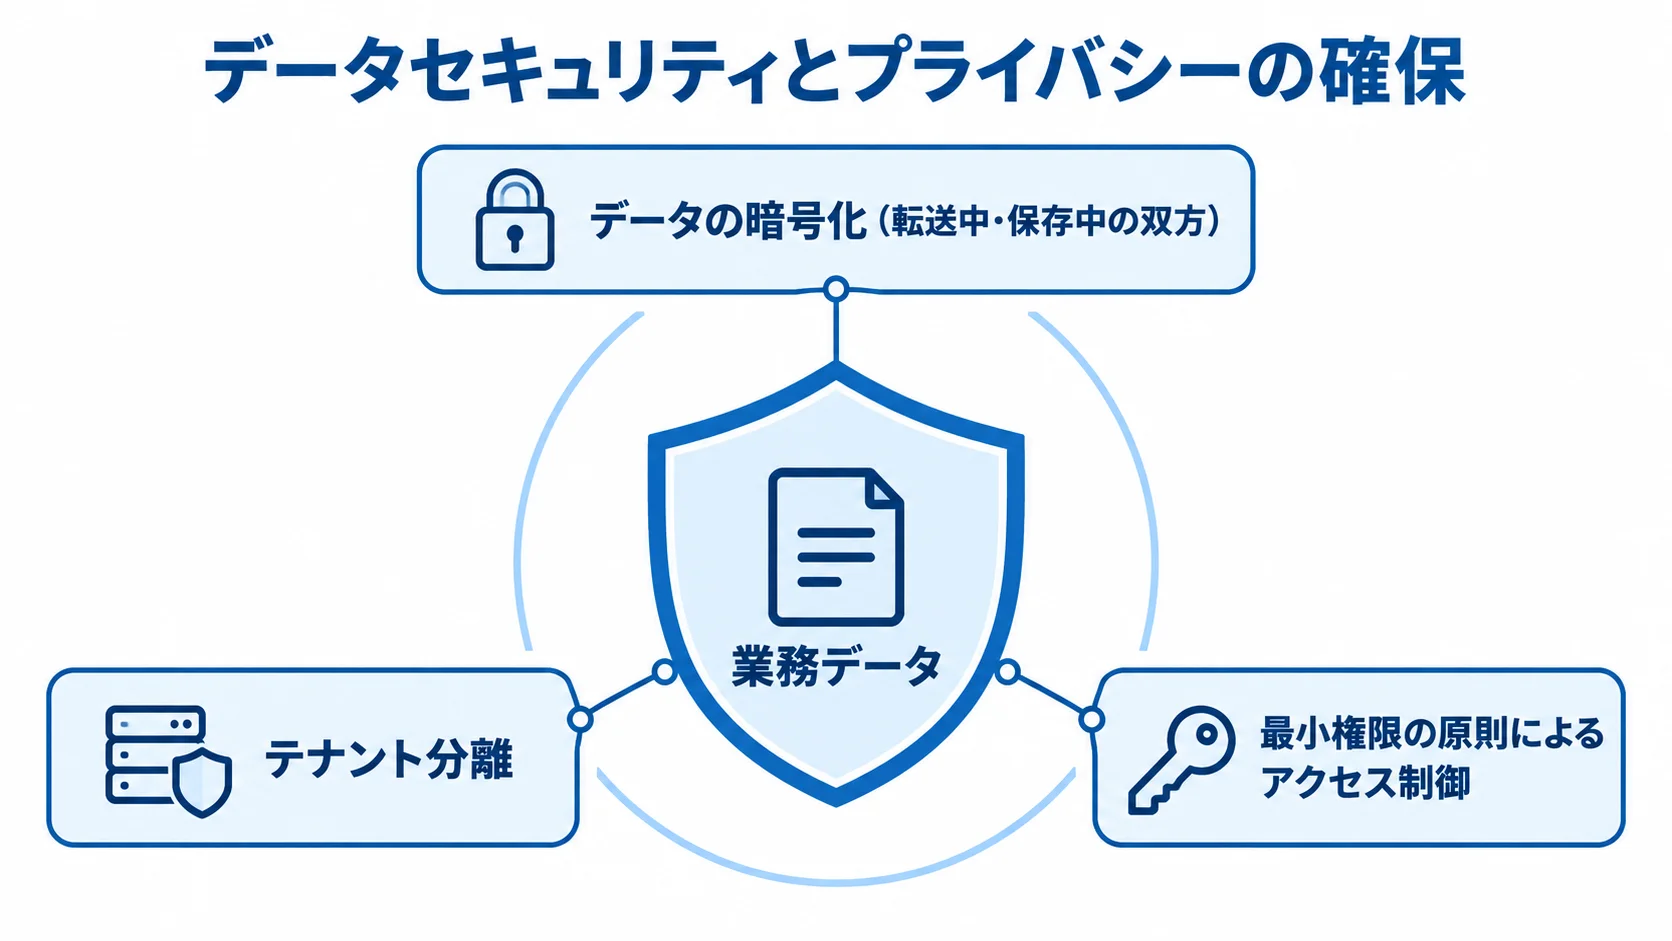
AIエージェントが処理する業務データには、個人情報保護法や社内のコンプライアンス規定の対象となるものが多く含まれます。そのため、設計の必須要件として、データの暗号化(転送中・保存中の双方)、テナント分離(他社データとの混在防止)、最小権限の原則によるアクセス制御を徹底する必要があります。
外部のLLMサービスを利用する場合は、APIリクエストに含まれるデータがモデルのパブリックトレーニングに使われないことを、サービス規約と契約書の両方で確認します。
社内の機密文書をRAGの知識ベースとして使う場合は、ベクターデータベースへのアクセス制御と定期的なデータ更新の仕組みも設計に含めます。従業員ごとのアクセス権限に応じて、AIエージェントが参照できる知識ベースの範囲を動的に制御する設計にしておけば、情報漏洩リスクを最小限に抑えられます。
精度管理と人間の監督体制(Human-in-the-Loop)
LLMの推論は確率的であり、100%の正確性を保証することはできません。バックオフィス業務では、誤った仕訳や契約書レビューの見落としが直接的な損失やコンプライアンス違反につながります。そのため、重要な業務については、必ず人間が承認・確認するワークフローを設計します。
たとえば、AIエージェントの出力に「信頼度スコア」や「要確認フラグ」を表示し、不確実性の高い出力を自動的に人間の確認キューに振り分ける仕組みが有効です。
著作権やIP侵害のリスクにも注意が必要です。生成AIは学習データの内容を意図せず再現することがあるため、生成されたテキストやコード、文書が第三者の知的財産権を侵害していないかを自動でフィルタリングする仕組みを検討します。ガバナンス設計の出発点は、「AIが何をできるか」より先に「AIが何をすべきでないか」を定めることです。
まとめ:バックオフィスAIエージェント開発の成功要因
企画からセキュリティ設計まで、成否を分けた判断は5点に集約できます。
- 企画フェーズ:業務プロセスを細かく分解し、ベースラインKPIを計測することが成否の分かれ目になる
- PoC:実務データで検証し、定量的な合格基準を事前に決めてから本開発に進む
- 契約形態:PoC・データ整備を準委任、UI・API実装を請負とする2フェーズ・ハイブリッドモデルが有効
- データ前処理:内製化できる部分を社内で担うことがコスト削減の鍵
- Human-in-the-Loopとセキュリティ設計:要件定義の段階から組み込む
組織面でも押さえておく点があります。
- 組織的な変革管理:現場スタッフのAIリテラシー向上を、技術開発と並走させる
バックオフィスAIエージェントの開発は、技術の問題と同じくらい、業務と組織の面が成否を左右します。段階的に進めてリスクを抑えながら、自動化の範囲を着実に広げていくことが、投資対効果を最大化するための基本戦略です。
▼全体ガイドの記事
・バックオフィスAIエージェント開発・構築の完全ガイド
関連記事では、活用事例や進め方を確認できます。
- バックオフィスのAIエージェント活用事例|間接業務を効率化する実例
- バックオフィスAIエージェント開発に強い開発会社・ベンダー6選|選び方も解説
- バックオフィスAIエージェント開発の費用相場|見積もり内訳とコストを抑えるコツ
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。