
在庫管理AIエージェントの外注は、まず内製と比べて方向を決め、発注前の準備、委託先の選定、フェーズごとの契約という順に進めるのが基本の流れです。
AI開発は狙った精度が出る保証がないため、準備と契約の設計が特に欠かせません。全体像は、次の完全ガイドで確認できます。
▼全体ガイドの記事
・在庫管理AIエージェント開発・構築の完全ガイド
- 内製と外注の違いを比べる
- 発注前の準備:要件・予算・体制
- 委託先の選定基準を見極める
AIシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
内製と外注の比較:在庫管理AIエージェントの開発方法
在庫管理AIエージェントの開発を内製にするか外注にするかは、自社のデータサイエンス人材の有無、開発期間の余裕、予算規模によって大きく変わります。需要予測モデルの構築にはARIMAやLSTMなど高度な機械学習の知識が必要なため、社内にAIエンジニアやデータサイエンティストがいない場合は、外注を検討するのが現実的です。
内製のメリット・デメリット
内製の最大のメリットは、自社の在庫データや業務フローへの深い理解を活かして、システムを設計できる点です。また、長期的には社内にAIのノウハウが蓄積され、継続的な改善が容易になります。一方で、AIエンジニアやデータサイエンティストの採用・育成には時間とコストがかかり、開発に着手するまでの準備期間が長くなりがちです。
在庫管理AIエージェントに必要な技術は、需要予測モデル(ARIMA・機械学習・LSTM等)、在庫最適化ロジック(安全在庫・発注点の動的計算)、外部システム連携(ERP・WMSとのAPI接続)と多岐にわたります。そのため、これらを内製で揃えるには、専門人材の確保が前提条件となります。
外注のメリット・デメリット
外注の最大のメリットは、即戦力となる専門チームにプロジェクトを任せ、開発の立ち上げを早められる点です。特にPoC(概念実証)の段階から経験豊富なパートナーと組めば、実現可能性の検証を効率よく進められます。
費用の目安として、リサーチの知見では、AIエンジニアの人月単価は一般的に80万〜120万円、AI専門の高度人材では160万円/人月前後が相場とされています。さらに、フルタイムで採用する場合と比べると、プロジェクト単位でコストを管理しやすい利点もあります。
一方、デメリットとしては、外部に任せるぶん自社にノウハウが残りにくい点、ベンダーロックインのリスク、そして委託先の選定を誤ると品質トラブルや追加費用が生じる点が挙げられます。こうしたリスクを抑えるには、発注前の準備と委託先の選定基準を先に決めておくことが大切です。
発注前の準備:要件・予算・体制
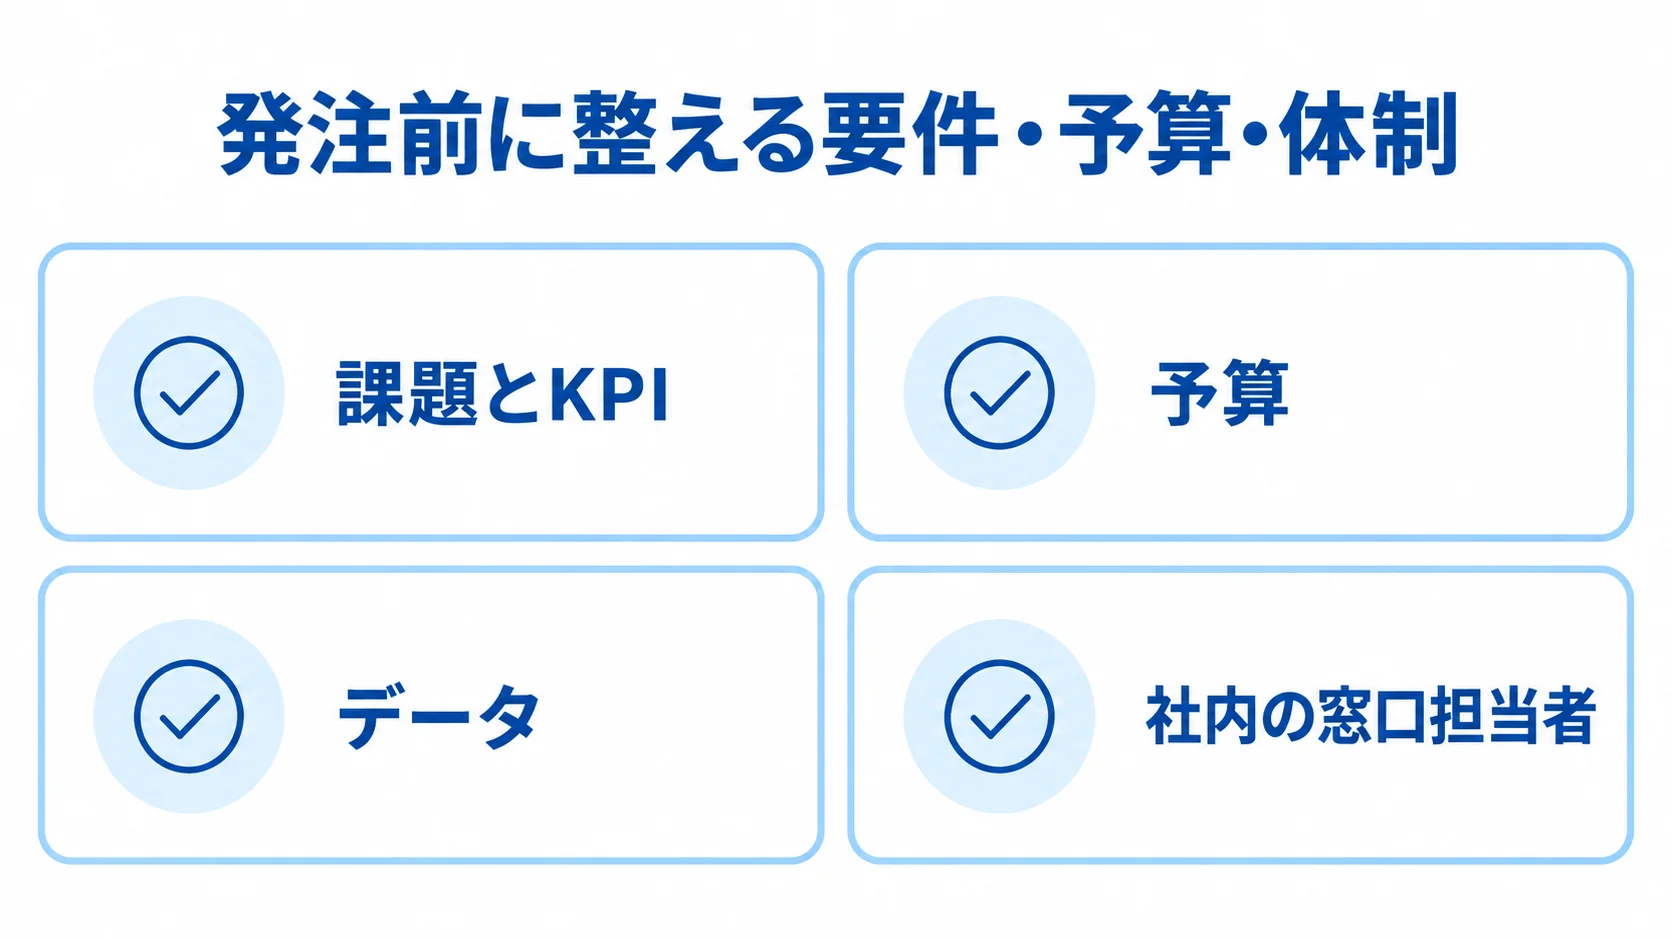
在庫管理AIエージェントを外注する際、発注前の準備が不十分だと、開発会社との認識がずれ、手戻りや追加コストの原因になります。特にAI開発は、狙った精度が確実に出るかを事前に保証できないという不確実性を抱えています。そのため、発注側が要件・予算・体制をしっかり整えておくことが、成功の鍵になります。
要件の整理:課題とKPIの明文化
発注前にまず取り組みたいのは、「何を解決したいのか」を言葉にすることです。在庫管理AIエージェントでは、具体的な業務課題に落とし込みます。たとえば「欠品による緊急配送コストを削減したい」「滞留在庫の早期検知と処分の判断を自動化したい」「需要予測の精度を高めて発注業務の工数を削減したい」のような形です。
課題が整理できたら、ビジネス成果に直接つながり、測定できるKPIを設定します。たとえば「出荷調整業務にかかる時間を30%削減する」「欠品起因の緊急配送コストを20%削減する」のように、数値で評価できる目標があると、開発会社と認識をそろえられます。
あわせて、対象とする商品カテゴリや事業所の範囲、連携が必要な既存システム(ERP・WMS等)も、この段階で特定しておくと、後の要件定義がスムーズに進みます。
予算とデータ・体制の準備
予算は開発の規模によって幅が大きく、検証用のMVP開発なら200万〜300万円程度、複数部署での運用を見据えた中規模システムなら500万〜600万円、取引先との外部連携を含む場合は700万〜800万円が一般的な目安です。加えて、稼働後のシステム保守(月額20万〜50万円)やインフラ費用(月額10万〜30万円)といった運用コストも、あらかじめ予算に組み込んでおくことが大切です。
データの準備も欠かせません。需要予測モデルの精度は、学習データの質と量に大きく左右されます。そのため、発注側はどの程度の品質のデータを、いつまでに、どの形式で用意できるかを明確にしておく責任があります。
学習に必要なデータが整っていないと、アノテーション等の追加加工費用が発生し、開発費が想定外に膨らむことがあります。さらに、社内の窓口担当者と意思決定権者を事前に決めておけば、プロジェクトを円滑に進められます。
委託先の選び方:在庫管理AIエージェントに強い開発会社の見極め
在庫管理AIエージェントの外注先は、「AIが得意かどうか」だけでなく、自社の開発フェーズと課題の性質に合うかで選びます。開発会社によって得意な領域や規模感は異なるため、自社の状況に照らして候補を絞り込むことが大切です。
自社フェーズ別の選定基準
選ぶ基準は、自社が今どのフェーズにいるかによって変わります。課題がまだ曖昧な段階では、現状診断と要件定義に強く、「何を作るべきか」より「何を解決すべきか」を軸に提案してくれる会社が適しています。一方、実証実験(PoC)を早く進めたい段階では、プロトタイプを素早く作り、低コストで有効性を検証できる開発会社を選ぶのが効果的です。
既存の基幹システム(ERPやWMS)との連携が必要な段階では、大規模なデータパイプラインの構築や、複数のシステムを安全に統合することを得意とするシステムインテグレーターが適しています。また、在庫管理や需要予測の業務ドメインの知識を持つ会社は、要件定義のスピードが上がり、実装品質も高くなる傾向があります。
提案・ヒアリング時のチェックポイント
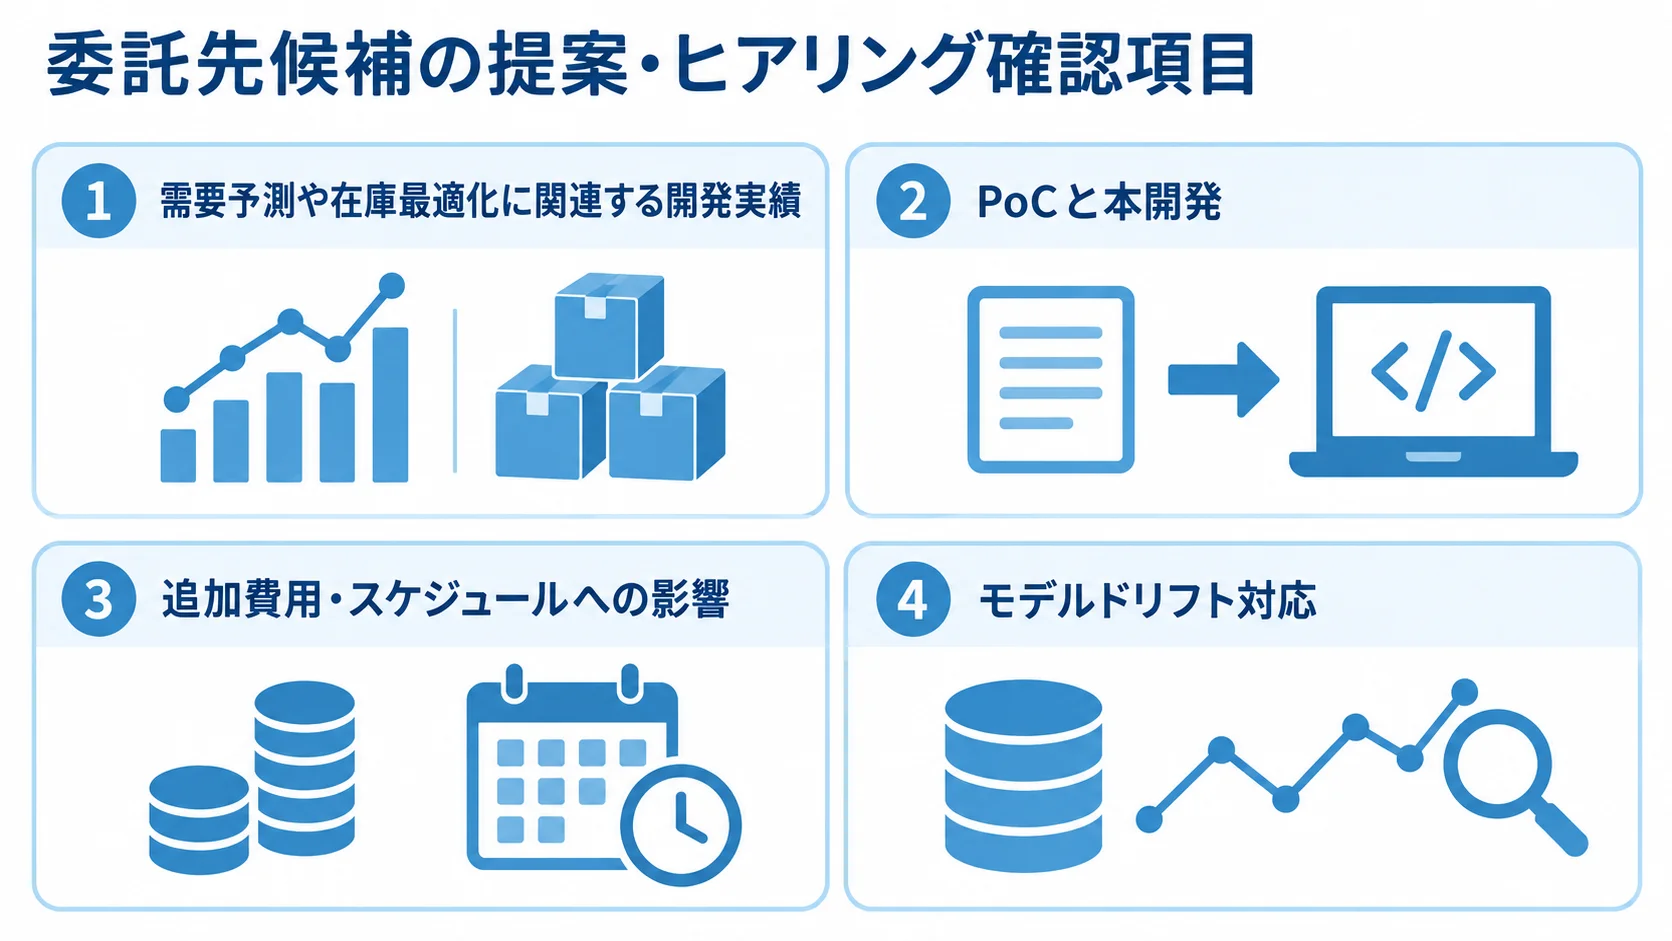
委託先候補に提案やヒアリングを依頼する際は、まず、需要予測や在庫最適化に関連する開発実績を、業界や規模感とあわせて示してもらえるかが、最初の判断材料になります。次に、PoCと本開発をフェーズに分けて提案しているか、準委任契約と請負契約の使い分けについて適切な提案があるかを見ます。
さらに、学習データの品質不足が判明した場合の対応方針(追加費用・スケジュールへの影響の明示)について、どこまで示せるかも確認しておきたい点です。また、本番稼働後のモデルドリフト対応(定期的な再学習・チューニング体制)についての考え方も、重要な確認項目です。
技術面では、Python・TensorFlow・PyTorch・AWSなど、オープンで汎用的な業界標準の技術を使っているか、ソースコードや設計書の所有権を納品物として明記しているかも押さえておくとよいでしょう。
契約形態と発注の流れ:AI開発の不確実性を踏まえた設計
在庫管理AIエージェントを外注する際に、従来のシステム開発と同じ契約の考え方で進めると、プロジェクトが行き詰まりやすくなります。AIには科学的な不確実性があるため、優秀なデータサイエンティストを投入し、高品質なデータで学習させても、特定の予測精度が確実に出るとは保証できません。そこで、この不確実性を前提にした契約の組み立てが必要になります。
準委任契約と請負契約の使い分け
AI開発の契約形態は、大きく「準委任契約」と「請負契約」の2種類に分かれます。準委任契約は、一定の業務を誠実に遂行することを約束するもので、成果物の完成は保証しません。
準委任の受託者は、専門家として「善管注意義務」を負います。一方、請負契約は特定の成果物の完成・納品を約束するもので、その瑕疵に対して「契約不適合責任」を負います。
AI開発では、要件定義・データ診断・PoC(概念実証)のフェーズは、検証の結果に応じてモデルを探索的に変える必要があるため、柔軟な運用指示ができる準委任契約が合理的です。一方、PoCで精度が実証された後の本開発(システムの結合やUI構築など)には、請負契約も使えます。ただし、請負で精度の保証を求めると、開発会社がリスクプレミアムとして見積り金額に1.3〜1.5倍の係数を上乗せする場合があります。
マイルストーン型の発注フロー
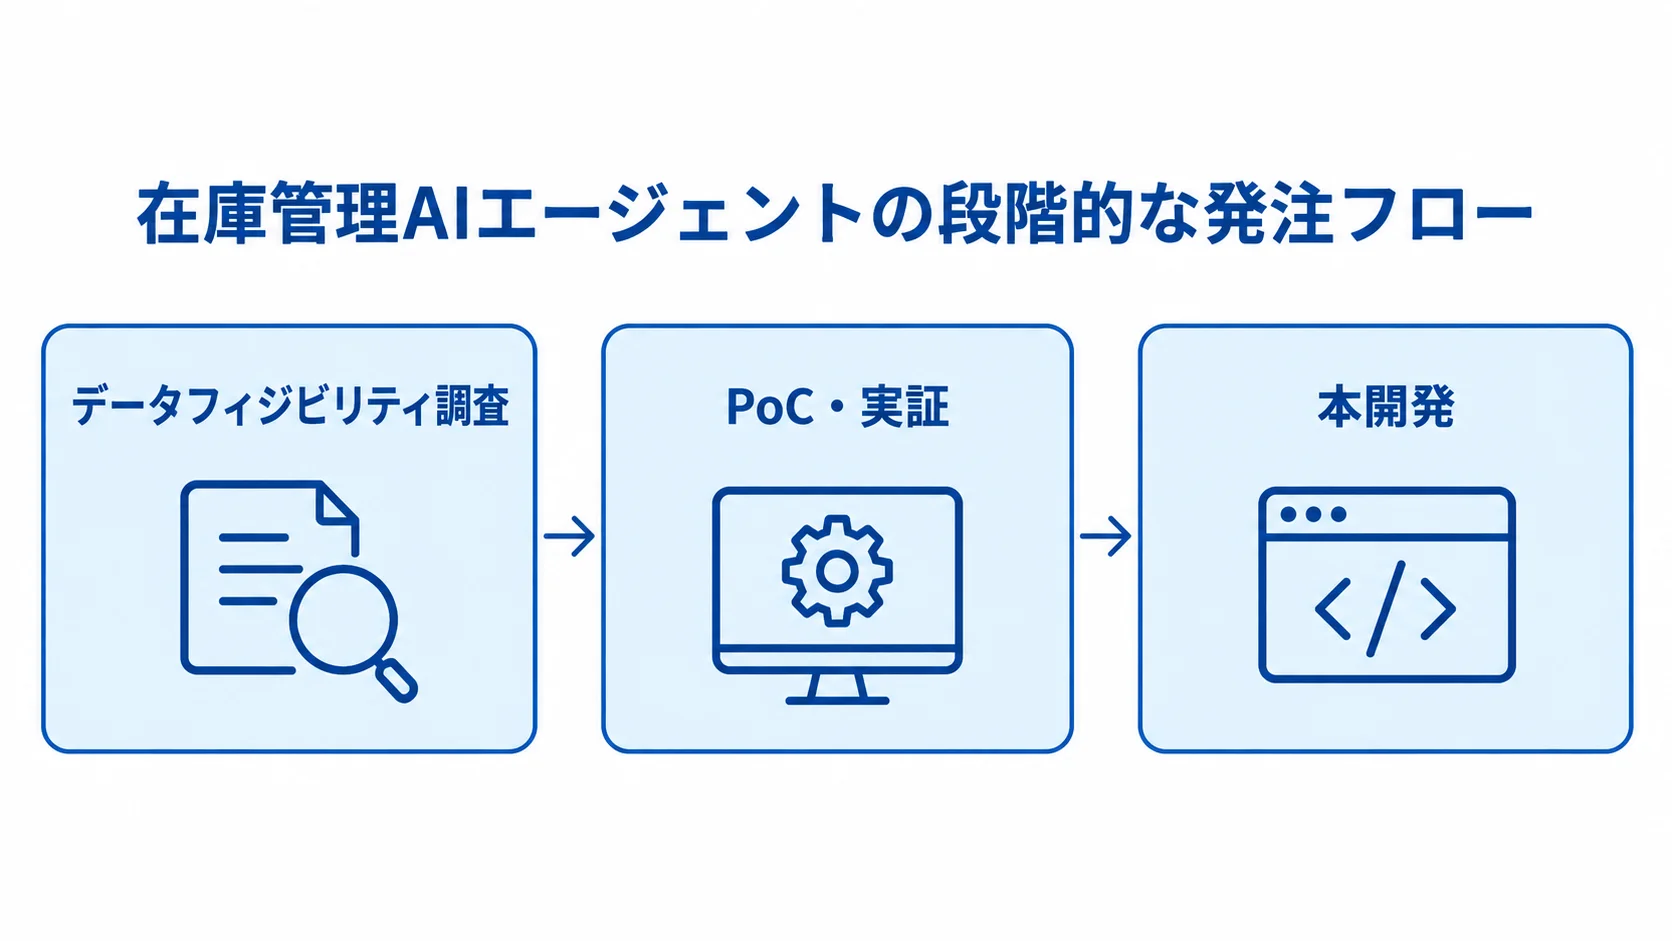
在庫管理AIエージェントを発注する際は、「データフィジビリティ調査→PoC・実証→本開発」という3ステップのマイルストーン型フローで進めるのが推奨されます。データフィジビリティ調査(費用目安:30万円〜)では、学習に使える在庫・販売データの品質と量を評価し、需要予測モデルの実現可能性を診断します。
次のPoCフェーズ(費用目安:100万円〜)では、限定したデータを使ってプロトタイプを作り、目標精度に届く見込みを検証します。
各ステップの終わりには、「期待するデータ品質が確保できているか」「目標精度の見通しが立ったか」を確かめます。目標に届かない場合は、そのフェーズでプロジェクトを一時凍結するか撤退するかの基準を、事前に両者で合意しておくことが大切です。さらに、契約時には検収基準(使用する評価データ・評価指標・合格水準)を書面で合意し、学習データの知的財産権は発注側が保持することを明記しておくとよいでしょう。
失敗しないための重要ポイント:AI開発外注特有の落とし穴
在庫管理AIエージェントの外注では、多くの企業が陥りがちな落とし穴があります。事前にそれらを把握しておけば、プロジェクトの失敗リスクを大きく減らせます。
精度保証の要求と一括発注の失敗パターン
最もよくある失敗のひとつが、「予測精度○○%以上を保証してほしい」という条件を契約に盛り込もうとするケースです。AIモデルの予測精度は、学習データの質や量、市場環境の変化によって左右されるため、科学的に保証することはできません。このような要求は、開発会社が受注を断るか、リスクプレミアムによって見積り金額が数倍に膨らむ原因になります。
また、「システム全体を一括で完成させてほしい」という大型発注も危険です。要件定義の時点では「精度が出るデータがあるか」が分からないことが多く、巨額の開発費を投じたあとに「目標精度に届かない」という事態になりかねません。そこで、フェーズを分けたマイルストーン型の発注フローを採り、各フェーズでGo/No-Goを判断できる設計にしておくことが欠かせません。
知的財産権・偽装請負・運用体制の落とし穴
知的財産権の扱いにも注意が必要で、自社が提供する学習用データの所有権は、発注側が完全に保持することを契約に明記します。一方、開発会社が構築した予測アルゴリズムのソースコードは、非独占ライセンス形式にしておくと、開発会社が他の案件でも再利用できます。こうすると、過剰な権利の囲い込みによる法務交渉の長期化と費用の高騰を防げます。
外部の開発チームを自社内に常駐させてアジャイル開発を進める場合、発注側の担当者が外部メンバーに直接業務命令を出すと、偽装請負(労働派遣法違反)に当たるおそれがあります。そのため、指揮命令の系統と受注者側の責任者窓口を、契約上で厳格に定義したうえで運用することが求められます。
また、本番稼働後にモデルの精度が徐々に下がる「モデルドリフト」に備えて、定期的な再学習やチューニングを担う運用体制も、事前に設計しておくと失敗を避けやすくなります。
まとめ:在庫管理AIエージェントの外注の進め方
在庫管理AIエージェントの外注を成功させるには、発注前の準備、委託先の選定、契約設計を整えることが欠かせません。
まず、課題の言語化とKPIの設定を徹底することです。「なぜAIを導入するのか」という目的を明確にし、測定できるKPIを設定したうえで、対象範囲をスモールスタートで絞り込むと、プロジェクトの成功率を高められます。
次に、データの準備と品質確認を先行させることです。需要予測モデルの精度はデータの質と量に直結するため、発注前に自社のデータの状態を把握しておく必要があります。
委託先は、自社のフェーズ(課題の曖昧さ、PoC重視、大規模システム統合)に合うパートナーを選ぶことが鍵です。契約設計では、要件定義とPoCは準委任契約、実証後の本開発は請負契約とする分け方が合理的です。また、精度保証の要求や一括の大型発注は避けるべきです。
知的財産権、偽装請負、モデルドリフトへの対応についても、事前に取り決めておけば、後のトラブルを防げます。
▼全体ガイドの記事
・在庫管理AIエージェント開発・構築の完全ガイド
活用事例や進め方は、次の記事で詳しく確認できます。
- 在庫管理のAIエージェント活用事例|需要予測・在庫最適化の実例
- 在庫管理AIエージェントの開発・構築の進め方|導入プロセスと成功のポイント
- 在庫管理AIエージェント開発に強い開発会社・ベンダー6選|選び方も解説
▼RFP作成前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。