
AIアルゴリズムの構築では、課題の性質とデータの特性に合わせて手法を選ぶことが、精度を高める基本です。本ガイドでは、AIの仕組みやアルゴリズムの種類、生成AIの活用、開発パートナーの選び方を、外部委託やDX推進を検討する方に向けて解説します。
関連する会社選びの記事
- AI・人工知能で注目の受託開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線
- ChatGPTを活用したAI開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線
- アルゴリズムやモデル構築が得意なAI開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
人工知能・アルゴリズム構築の全体像
世界のAI市場は2025年時点で約294億ドル規模に達しており、2034年には2,480億ドル超へと拡大すると予測されています。日本国内でも2025年に79億ドル規模を超え、2034年には391億ドルへの成長が見込まれています。こうした拡大を背景に、AIアルゴリズム構築への需要は加速度的に高まっています。
AIアルゴリズムとは、人工知能がデータを処理・学習・予測するために従う手順やルールの集まりです。単にルールを並べたプログラムとは異なり、データからパターンを自ら見つけ出し、精度を高めていく点に特徴があります。そのため、アルゴリズムの設計と構築の質が、AIシステム全体の性能とビジネスへの貢献度を大きく左右します。
AIアルゴリズムの分類と代表的な手法
機械学習アルゴリズムは、大きく「教師あり学習」「教師なし学習」「強化学習」の3つに分類されます。教師あり学習は、正解データを与えてモデルを訓練する方式で、売上予測や需要予測、顧客の離反予測に広く使われています。また、教師なし学習は、正解ラベルのないデータからパターンを見つけ出す方式で、顧客セグメンテーションや異常検知に活用されます。
強化学習は、試行錯誤を通じて報酬を最大化する方式で、ゲームAIや自律型ロボット制御での実績が豊富です。さらに近年は、ディープラーニング(深層学習)が急速に普及し、画像認識や自然言語処理、音声認識といった複雑なタスクで、従来手法を大きく上回る精度を実現しています。
テーブルデータの分類・回帰では、勾配ブースティング(XGBoost、LightGBMなど)が高水準の精度を誇る一方、非構造化データにはディープラーニングが最適とされています。また、2026年現在は、手法の選定そのものを自動化するAutoML(Automated Machine Learning)も実務で広く活用されています。
ビジネスへの適用領域とインパクト
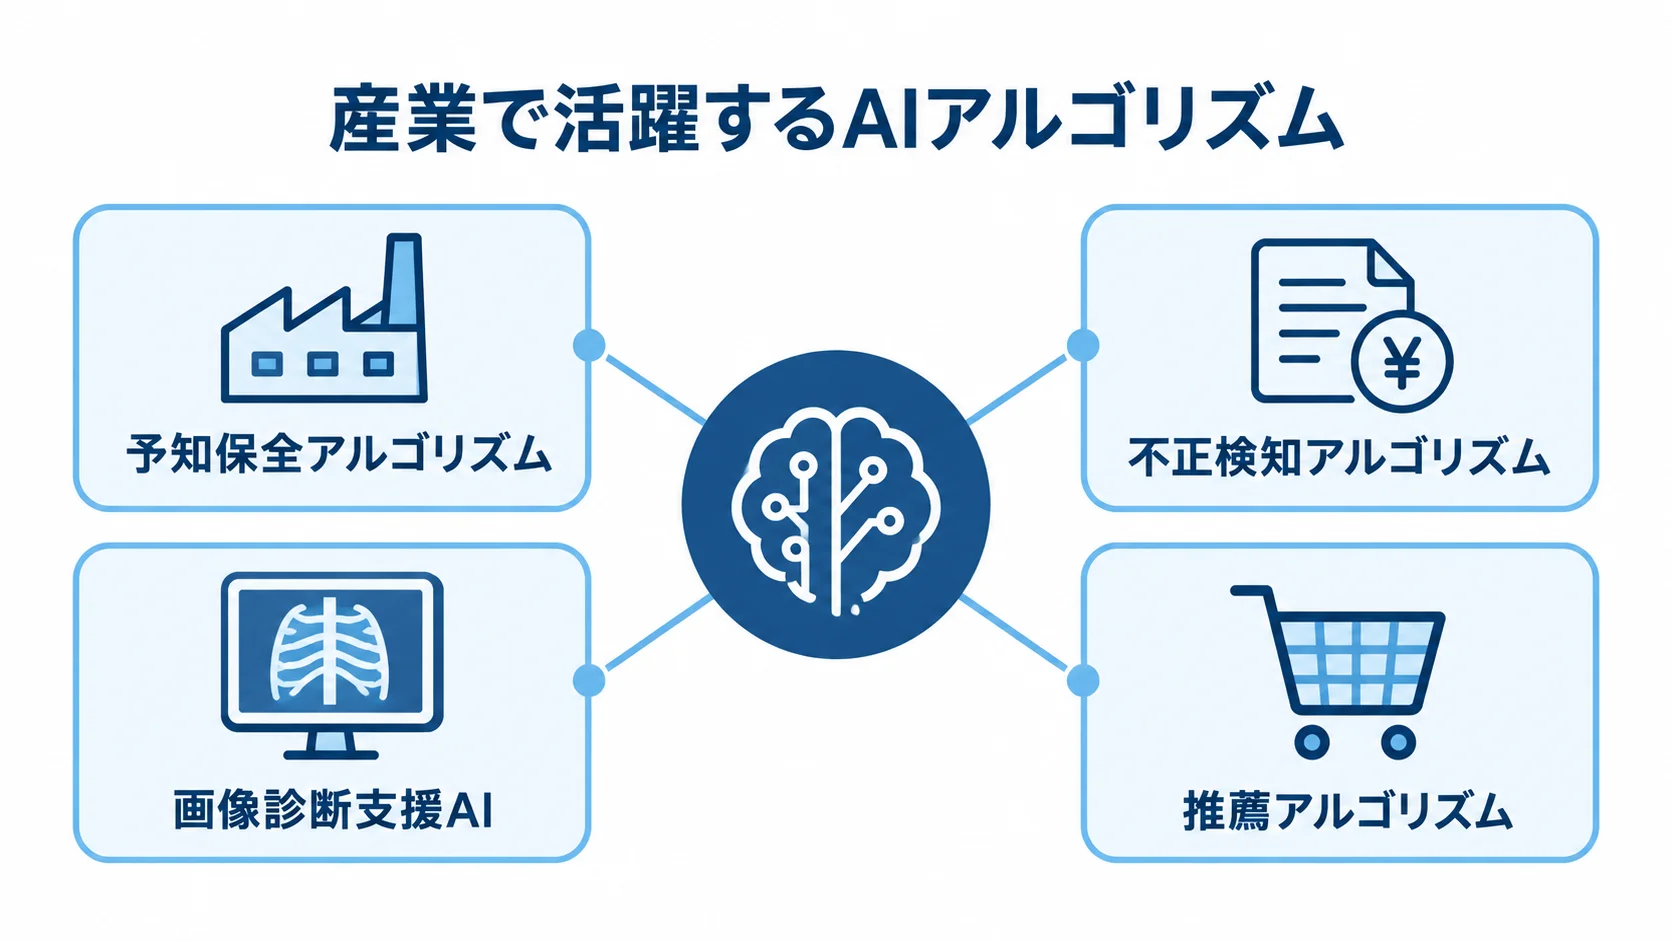
AIアルゴリズムの浸透は年々高まっており、今後も新たな適用領域が広がると見込まれています。活躍する領域は、製造・金融・医療・小売・物流など、ほぼすべての産業に及びます。たとえば、製造業では予知保全アルゴリズムが設備の故障を事前に検知し、突発的な生産停止を防ぐことで、大幅なコスト削減を実現しています。
金融業では、不正検知アルゴリズムがリアルタイムに取引を監視し、従来の人手による審査では対応できなかった速度と精度を実現しています。また、医療分野では画像診断支援AIが放射線科医の負担を軽減しながら診断精度を高めており、特に地方の医療機関での活用が広がっています。
小売・ECでは、購買履歴データを学習した推薦アルゴリズムがパーソナライズされた商品提案を自動化し、顧客単価と購買頻度の向上に直結しています。さらに、自然言語処理を活用したアルゴリズムも、カスタマーサポートの自動応答や契約書のレビュー、市場調査のテキスト分析など、ナレッジワークの効率化で存在感を増しています。
AI・人工知能の受託開発を依頼できるベンダー選びの視点
AIシステムの開発を社内だけで完結させることは、多くの企業にとって容易ではありません。データサイエンティストや機械学習エンジニアの採用難、学習環境の整備コスト、最新技術へのキャッチアップ負担を考えると、専門ベンダーへの受託開発は合理的な選択肢です。
一方で、受託先の選定を誤ると、期待した成果が得られないリスクもあります。だからこそ、ベンダー選びの基準を正しく理解しておくことが大切です。
AI受託開発ベンダーに求められる技術力と実績
AI開発ベンダーを選ぶ際にまず確認すべきは、対象業種における実績の深さと技術スタックの幅広さです。加えて、単にAIツールを組み合わせるだけでなく、課題に応じた適切なアルゴリズムを設計・チューニングできる能力があるかどうかが、重要な判断軸になります。
特にデータの前処理や特徴量エンジニアリングの品質は、モデル精度に直結します。そのため、データエンジニアリングとデータサイエンスの両方のスキルを持つチームが在籍しているかを確認しましょう。
また、開発後も継続的に運用・改善するMLOps(Machine Learning Operations)の体制が要ります。学習済みモデルは時間とともに精度が劣化する「データドリフト」が起きるため、再学習と監視の仕組みがなければ実務定着は難しくなります。PoC(概念実証)から本番運用まで一貫して支援できるベンダーを選ぶことが、プロジェクト成功の確率を大きく高めます。
発注前に確認すべきパートナーシップの質
技術力と並んで大切なのが、ビジネス課題への理解力とコミュニケーションの質です。AI開発の失敗は、技術より「現場が望まないシステムになった」「目的が曖昧なまま進んだ」といったプロセス上の問題に多く起因します。そのため、要件定義の段階から現場担当者を巻き込み、KPIを明確にして進められるかを見極めることが欠かせません。
発注前に、契約形態についても整理しておく必要があります。契約形態は、成果物が明確なら固定費用の請負契約が適していますが、探索的なAI開発では準委任契約を選び、仕様を柔軟に変えられるようにするほうが現実的です。また、開発後のモデルやデータの所有権と機密情報の扱いは、契約書で明確にしておくと後のトラブル防止につながります。
▶ 詳細はこちら:AI・人工知能で注目の受託開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線の記事はこちらです。
ChatGPT・生成AI活用によるアルゴリズム開発の新潮流
ChatGPTに代表される大規模言語モデル(LLM)の登場は、AIアルゴリズム開発の風景を大きく塗り替えました。テキスト生成・要約・翻訳・コード生成は、従来は高度な専門知識を要した処理ですが、APIを通じて手軽に利用できるようになりました。
これにより、企業のAI活用の敷居は一気に下がっています。また、世界の生成AI市場は2025年に53.7億ドル規模と評価されており、2035年には988.4億ドルへと急成長することが見込まれています。
生成AIをビジネスプロセスに組み込む実践的アプローチ
ChatGPTをはじめとする生成AIをビジネスに組み込む際は、「どの業務プロセスのどの部分にAIを当てはめるか」を明確にする課題定義が欠かせません。AIを導入すること自体が目的になると、導入後に使われないシステムができあがるリスクが高まります。
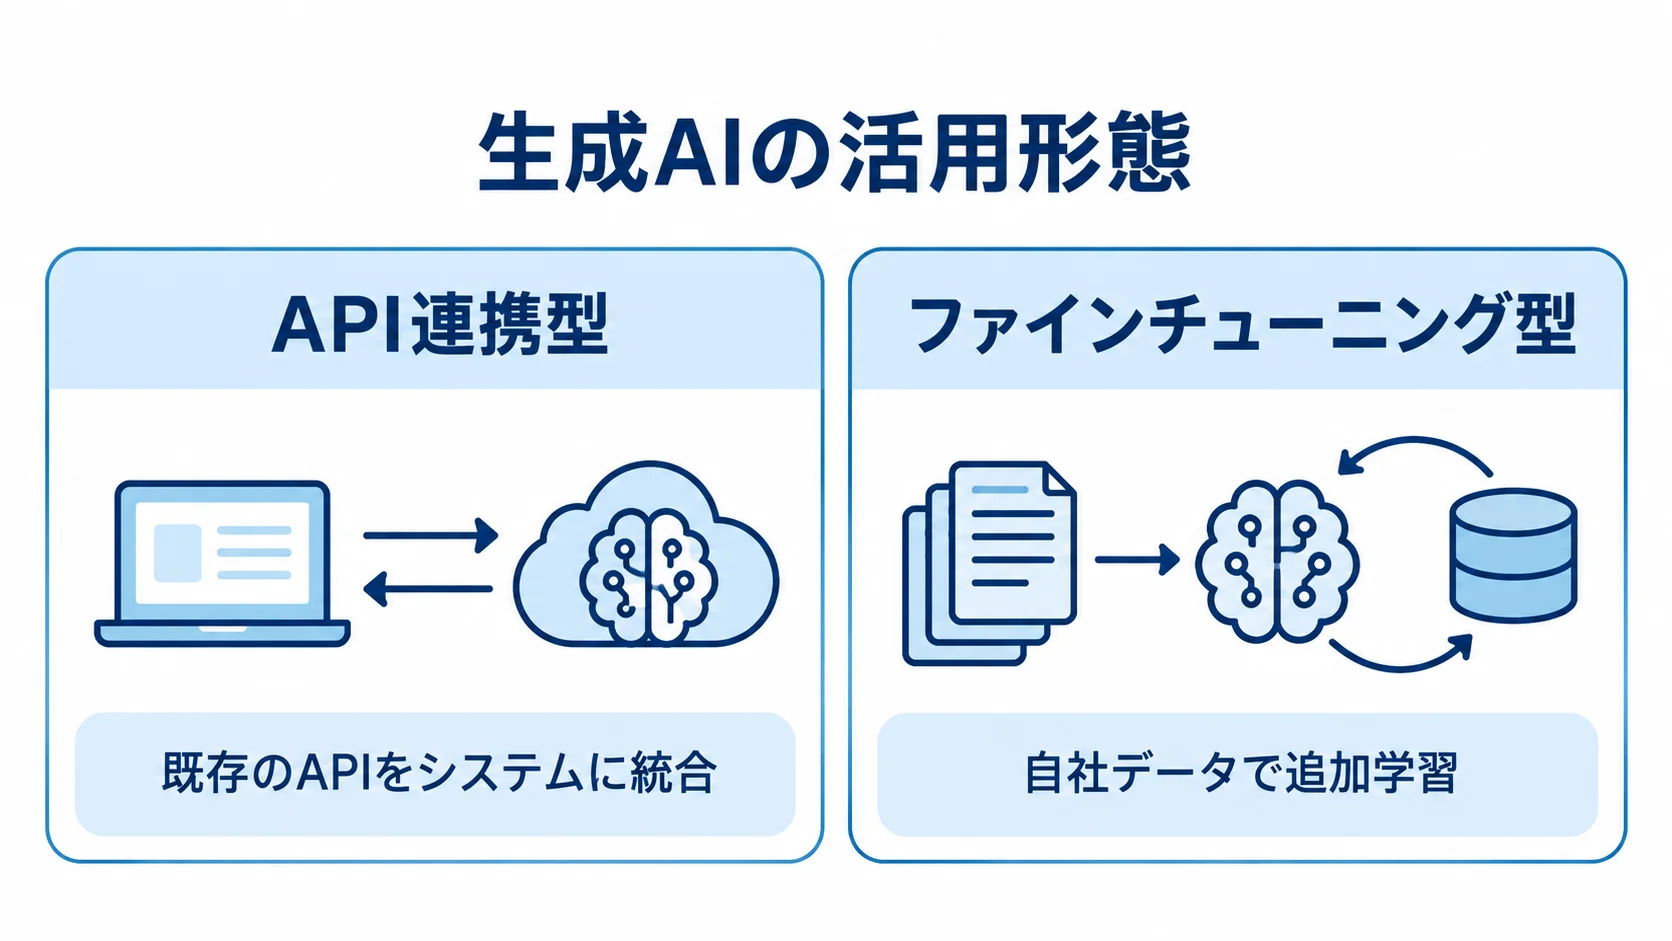
そのため、まずは業務フローを洗い出し、繰り返しが多く、判断基準が明確で、データが蓄積しやすい業務から、自動化の候補として検討するのが有効です。生成AIの活用形態は大きく、既存のAPIをシステムに統合する「API連携型」と、自社データで追加学習させる「ファインチューニング型」に分かれます。
API連携型はスピーディに導入できる一方、自社固有の専門用語や社内規定への対応には限界があります。ファインチューニング型は、自社特有の知識を学習させて高度なカスタマイズが可能ですが、質の高い学習データの準備と継続的なモデル管理が必要です。だからこそ、自社の目的と体制に合わせてアプローチを選ぶことが成功の鍵です。
ChatGPT活用に強い開発ベンダーを見極めるポイント
生成AIの活用支援を得意とするベンダーかどうかは、プロンプトエンジニアリングの設計力と、システムインテグレーション力の両方を備えているかで見極められます。単に生成AIの機能を使うだけでなく、CRMやERPなどの既存システム、社内データベースとの連携を設計できるかで、実際のビジネス価値は大きく変わります。
情報セキュリティの観点から、機密情報の入力制限やログ管理、利用ルールの整備を支援できるかも確認事項です。2026年現在、AIエージェント(自律的にタスクを実行するAI)の開発需要が急増し、複雑な業務フローの自動化に取り組む企業も増えています。こうした最先端の領域への対応実績は、将来のシステム拡張性を見据えた選定基準として有効です。
▶ 詳細はこちら:ChatGPTを活用したAI開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線の記事はこちらです。
アルゴリズム・モデル構築に特化した開発パートナーの選び方
AIシステム開発のなかでも、アルゴリズムの設計とモデル構築は、最も技術的な難易度が高い工程です。汎用的なAIツールの導入支援とは異なり、自社のデータ特性と業務課題に合わせたカスタムアルゴリズムを設計・実装するには、データサイエンスの深い知識と業務への理解が欠かせません。
そのため、この領域に強みを持つ開発パートナーを選ぶことが、プロジェクトの成否を大きく左右します。
カスタムモデル構築に必要な技術要件と評価軸
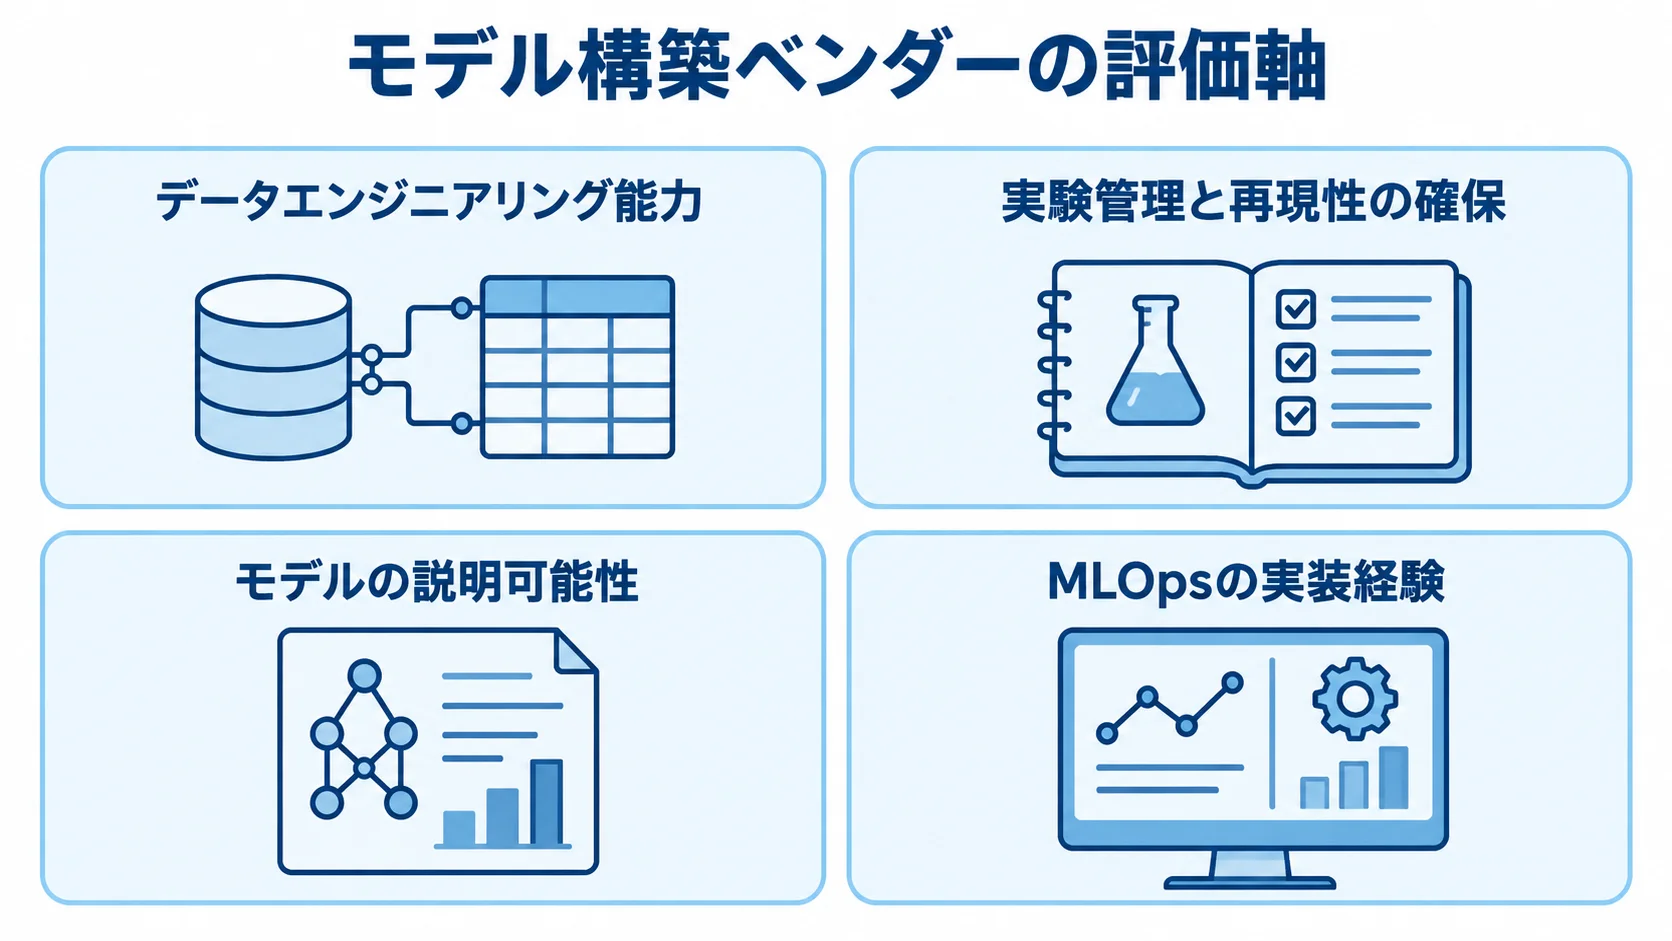
アルゴリズム・モデル構築を依頼する際の評価軸として、まず「データエンジニアリング能力」が挙げられます。どれほど優れたアルゴリズムを選んでも、学習に使うデータの品質が低ければ精度は出ません。だからこそ、データの収集・クレンジング・特徴量エンジニアリングまでを一貫して対応できるチームかどうかが、確認の基準になります。
次に見るべきなのは、実験管理と再現性の確保です。試行錯誤の過程を追跡し、ベストモデルを再現できる環境が整っているかが、実用化の前提になります。また、「モデルの説明可能性(Explainability)」への対応も、近年ますます重要視されています。
金融や医療など規制の厳しい業界では、AIがなぜその判断を下したのかを説明できなければ、実務への適用が難しいケースがあります。そのため、SHAP値やLIMEなどの説明可能AI技術を使い、モデルの意思決定プロセスを可視化できるベンダーかどうかも、選定の判断材料になります。
モデルの本番運用・継続改善を支える体制づくり
AIモデルは、本番環境に展開してからが本番です。実データで精度を監視し、劣化が検出されたら再学習・更新するサイクルを回し続けることで、持続的な価値が生まれます。MLOpsの実装経験が豊富なベンダーは、CI/CDパイプラインへのモデル展開の自動化や精度監視ダッシュボードの構築など、運用体制そのものを設計できます。
モデルの規模や用途によっては、クラウド(AWS、Google Cloud、Azure)上のインフラ設計も重要になります。そのため、学習ジョブのオンデマンド実行、推論APIのスケーラブルな設計、コスト効率の最適化まで、インフラとデータサイエンスの両面から設計できるベンダーを選ぶ必要があります。運用段階の予期せぬコスト増や性能問題を未然に防ぐことにつながります。
▶ 詳細はこちら:アルゴリズムやモデル構築が得意なAI開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線の記事はこちらです。
人工知能・アルゴリズム構築プロジェクトで失敗しないためのポイント
AI・アルゴリズム構築プロジェクトは、他のITシステム開発と比べて不確実性が高く、期待する精度や効果が出るまでに時間と試行錯誤が必要です。そのため、失敗事例に共通する教訓と、成功確率を高める要点を押さえておくことが役立ちます。
プロジェクト成功に共通する要因
AIプロジェクトの成功を左右する第一の要因は、課題の明確化と、測定可能なKPIの設定です。「AIで業務を効率化したい」という漠然とした目標のままでは、何をもって成功とするかを判断できません。たとえば、「月次の需要予測精度を現状の±15%から±8%以内に改善する」といった具体的な指標を置くと、開発の方向性がぶれにくくなります。
また、KPIには、作業時間削減率やエラー件数削減率、コスト削減額など、効果を測定しやすいものを選ぶことが推奨されます。第二の要因は「データ戦略」の先行整備で、AIの精度はデータの量と質に大きく左右されます。必要なデータが不足していたり品質が低かったりすると、どれほど優れたアルゴリズムを用いても、期待する精度は出ません。
プロジェクト着手前に、利用可能なデータの量や種類、更新頻度を洗い出し、不足していれば、データ収集の仕組みを先に整えておくことが欠かせません。また、スモールスタートで成果を確かめながら段階的に広げる進め方も、リスクを抑えるうえで有効です。
よくある失敗パターンとその回避策
AIプロジェクトでよくある失敗は、「PoCでは精度が出たのに、本番では使えない」ことです。その多くは、学習時と本番のデータ分布が乖離する「データドリフト」が原因で起きます。そのため、PoCでは実際の業務データをできるだけ忠実に反映させ、本番に近い条件で検証する「シャドーモード評価」を取り入れると、このギャップを事前に検出できます。
もう一つの典型的な失敗は、現場を巻き込まない開発です。技術的に優れたモデルを構築しても、現場の担当者が使い方を理解していなかったり、業務フローへの組み込みが不十分だったりすると、システムが活用されずに終わります。
開発の初期段階から現場のキーパーソンを巻き込み、プロトタイプへのフィードバックを開発に反映させながら進める、アジャイルな開発プロセスが、現場定着率を高める有効な手段です。また、責任者の明確化、機密情報の入力制限、利用ルールの策定と周知を最低限整えると、セキュリティリスクの低減にもつながります。
まとめ
ここまで、人工知能・アルゴリズム構築の全体像から、AI受託開発ベンダーの選定基準、ChatGPT・生成AI活用の実践的なアプローチ、アルゴリズム・モデル構築に特化したパートナー選びまでを、体系的に解説してきました。
AIアルゴリズムには、教師あり学習や強化学習、ディープラーニングなど多様な手法があり、課題とデータに応じて使い分けることが基本です。AI受託開発ベンダーの選定では、技術力と実績に加えて、ビジネス課題への理解力、MLOps体制、セキュリティガバナンスを総合的に見ることが求められます。
生成AIの活用では、業務課題を明確にすることと、システムインテグレーション力が成果を左右します。また、アルゴリズム・モデル構築の専門ベンダーを選ぶ際は、データエンジニアリングから説明可能AI、本番運用体制までを一貫して支援できるかを確かめましょう。
プロジェクトを成功に導く共通原則は、「測定可能なKPIの設定」「データ戦略の先行整備」「現場を巻き込んだ開発プロセス」の3点にまとめられます。さらに、PoCから本番運用まで伴走できる開発パートナーと組み、スモールスタートで成果を積み重ねながら段階的に広げる進め方が、AIアルゴリズムを組織に定着させる現実的な道筋です。
各テーマの詳細は、下記の関連記事で解説しています。自社の課題や開発フェーズに合わせて、参考にしてください。
各テーマの詳しい記事
- AI・人工知能で注目の受託開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線
- ChatGPTを活用したAI開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線
- アルゴリズムやモデル構築が得意なAI開発企業・ベンダー・SIer4選|システム会社・ソフトウェア・アプリ・サービスの最前線
開発相談前に確認できるホワイトペーパー
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。