
AI異常検知の開発期間は、PoC(概念実証)に1〜2ヶ月、本番構築にさらに3〜6ヶ月程度が目安です。企画から本稼働までは、全体でおよそ半年から1年を見込みます。
カード不正や外観不良、設備センサーの異常値、ログや通信の攻撃兆候などが対象です。品質保証やセキュリティ、金融、インフラ運用で導入が進んでいます。
▼全体ガイドの記事
・AI異常検知の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI異常検知開発にかかる期間の全体像
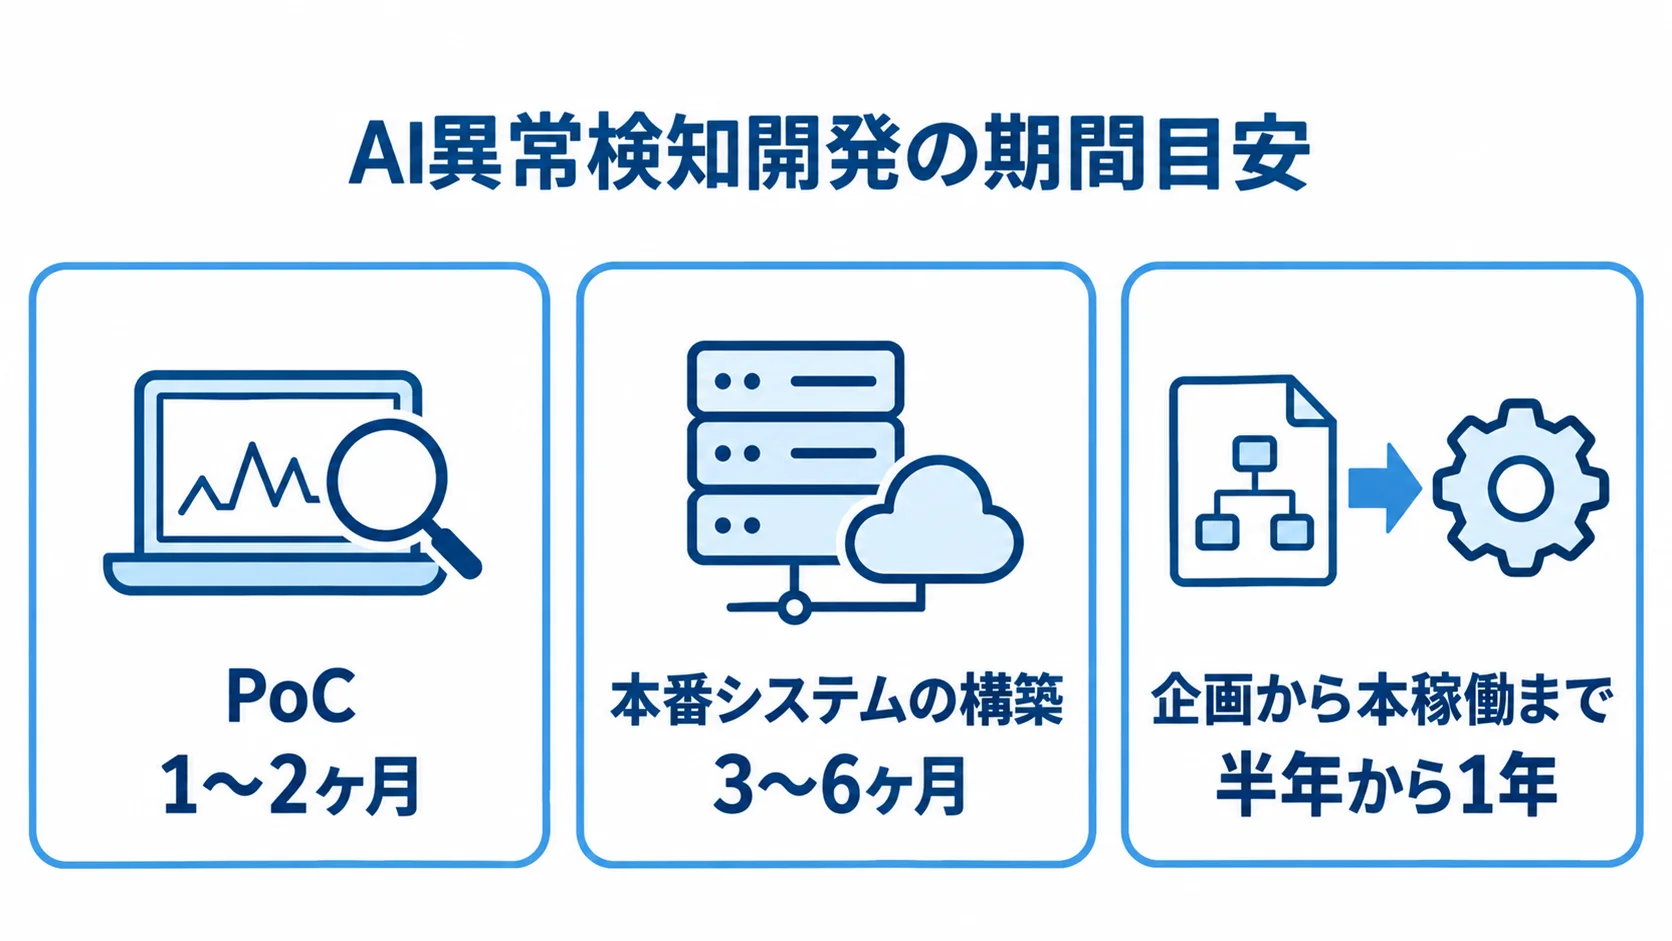
PoCは一般に1〜2ヶ月かかり、そのあとの本番システムの構築には、さらに3〜6ヶ月程度を要します。企画から本稼働までを含めると、全体でおよそ半年から1年が目安です。
期間は、規模や対象データの性質によって大きく変わります。通常のWebシステム開発と異なり、実データでモデルの精度が通用するかは、検証しないと分かりません。そのため、この不確実性が日程に影響します。
正常が大多数を占め、異常はごくわずかという偏りも多く見られます。偏りのあるデータでは、限られた異常サンプルで精度を担保できるかを見極める時間を、計画に含める必要があります。
AI異常検知の開発は、PoCで小さく検証し、成果を確認してから本番開発へ進めると、総期間の短縮とリスク低減につながります。
異常検知と故障予知の違いが期間に与える影響
両者は目的が異なるため、期間を見積もる前に、異常検知と故障予知(予知保全)の違いを押さえておきます。
- 異常検知:いまのデータが正常パターンから外れているかを見る仕組みです。
- 故障予知:劣化を時系列で追い、設備がいつ壊れるかや残存寿命を予測します。
異常検知が捉えるのは、製品のキズや不正の疑い、通常と異なるセンサー値など、いま起きている異常です。
異常検知は、正常データが十分にあれば、教師なし学習で構築できるケースが多くあります。一方で、故障予知では故障ラベル付きのデータを長期間集める必要があります。そのため、異常検知は着手から成果確認までを短く設計できる場合が多い傾向です。
以降で示す期間は、いま起きている異常を扱う異常検知を前提にしています。
規模別に見る開発期間の目安
対象の範囲や求める性能によって、最初の検証から本番運用までの期間は変わります。
- 小規模:単一の対象なら、PoCを含めて約2〜4ヶ月で現場試行まで進められる見込みです。
- 本格構築:複数の対象や拠点、連携を含む場合、6ヶ月〜1年程度が目安になります。
- 重要用途:リアルタイム処理や低い誤検知率が必要なら、1年を超えることもあります。
小規模の対象は、1製品ラインの外観検査や1種類のログの異常監視です。
本格構築では、通知やダッシュボード、基幹システムとの連携も対象に入ります。
特に金融の不正検知などでは、24時間365日の処理や極めて低い誤検知率が求められるため、精度調整と安定運用に時間がかかります。
限定した領域で価値を確かめてから対象を広げる設計は、期間とコストの両面で有利です。
フェーズ別のスケジュールと工数配分
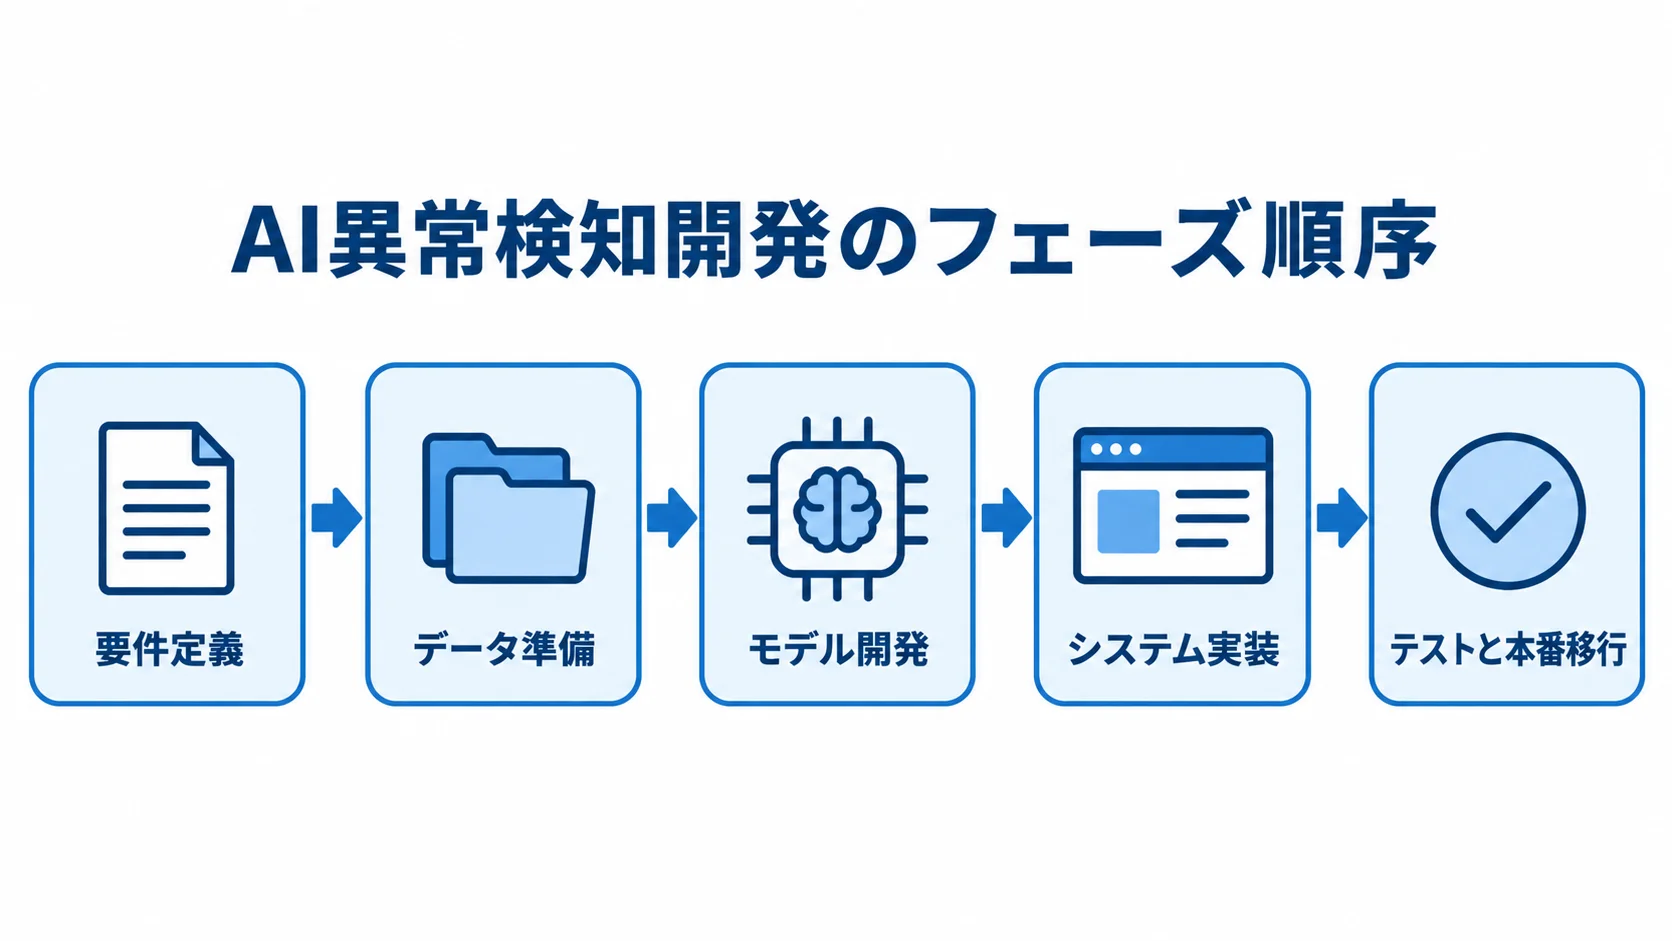
開発は、要件定義、データ準備、モデル開発の順に進みます。その後にシステム実装を行い、テストと本番移行へ入ります。
一般的な開発と比べると、工数はデータとモデルに偏ります。
実務では、データ収集・整備とモデルの試行錯誤に全体の半分近くを使うこともあります。特に時間がかかりやすいのは、データ工程とモデル工程です。
データ収集・前処理・アノテーションの期間
データ工程は、開発期間を最も読みにくく、全体の進みを左右しやすい工程です。正常データの量が、そのまま精度の土台になります。
- 収集:対象に応じた正常データを、一定期間分そろえます。
- 前処理:欠損やノイズ、形式の違いを整えて、学習に使える状態にする作業。
- アノテーション:実際の異常サンプルへのラベル付け。
たとえば、外観検査では良品画像、設備監視では正常稼働時のセンサー時系列、不正検知では正常取引履歴を集めます。ただし、集めたデータがそのまま学習に使える状態とは限りません。
撮影条件がばらついていたり、センサーに欠損やノイズがあったり、ログ形式が統一されていなかったりすると、整備に時間がかかります。
前処理にはクレンジングや正規化、特徴量の設計が含まれ、データに問題が多いほど想定以上に長引きます。
教師あり学習や評価用データのためにラベルを付ける場合は、現場の専門家の協力や日程調整が必要です。作業には数週間から数ヶ月かかることもあります。
データ工程が全体の30〜50%を占めることも多くあります。そのため、データ整備に先行着手できるかが納期を左右します。
モデル開発・学習・評価の期間
データが整ったら、モデルを開発・学習し、対象に合う手法と評価方法を決めます。
- 統計・機械学習:3σ、ホテリングのT2統計量、Isolation Forest、One-Class SVM、Local Outlier Factorなど。
- 深層学習:オートエンコーダ、VAE、LSTMオートエンコーダ、PatchCore、PaDiMなど。
教師なし学習では、正常データから正常パターンを学び、そこから外れたデータを異常とみなします。
画像や時系列のデータには、深層学習の手法がよく用いられます。
複数の手法を試して選ぶため、1〜2ヶ月程度の試行錯誤が生じます。
異常検知では、精度の評価設計にも時間がかかります。
正常が大多数を占める不均衡データでは、単純な正解率では精度の良し悪しを判断しにくくなります。
適合率は誤検知の少なさ、再現率は見逃しの少なさを示します。
F1スコアやPR-AUCも使って評価します。
見逃しと誤検知の許容範囲を現場と合意し、閾値を調整します。この評価と調整の往復が、モデル工程の期間を決める大きな要素です。
開発期間を左右する主な要因
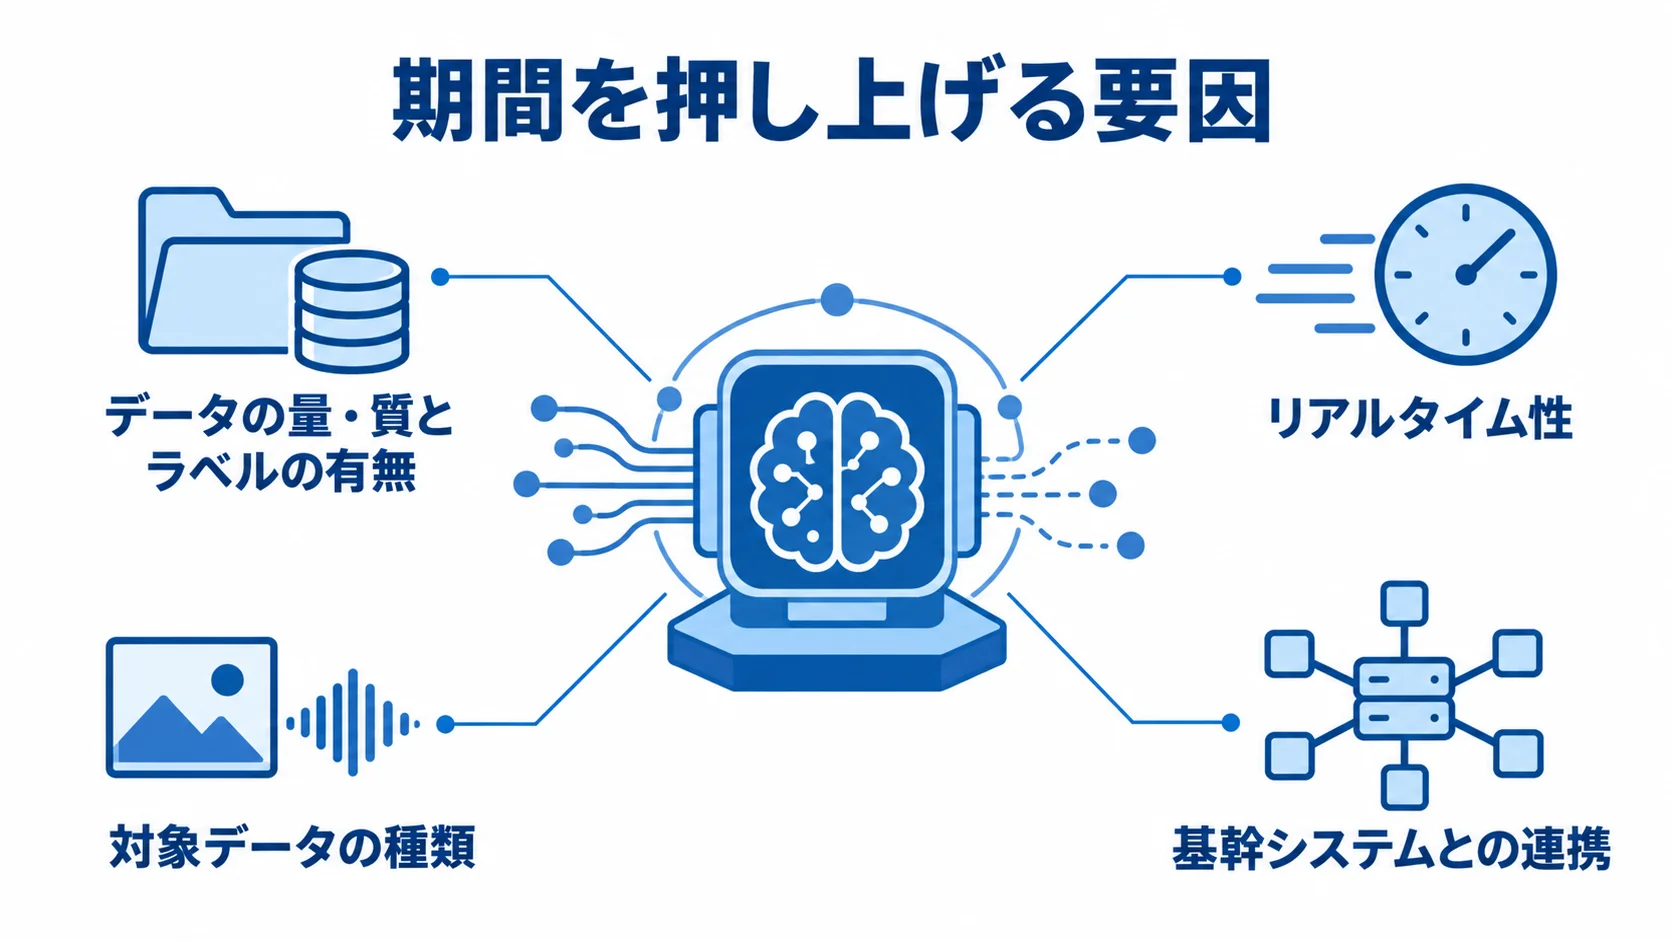
同じAI異常検知でも、条件によって期間に数倍の差が生じます。
そのため、見積もりの前に、期間を押し上げる要因を把握しておきます。特に影響するのは、データの量・質・ラベルの有無と、リアルタイム性・対象データの種類です。
データの量・質とラベルの有無
期間を大きく左右するのは、データの状況です。まず、正常データが十分に蓄積されているかを確認します。
- 量:正常データが蓄積済みなら、収集期間を短縮できます。
- 質:データのばらつきや欠損の程度が、前処理の手間を左右します。
- ラベル:異常事例が乏しいと、評価用データの準備が難しくなります。
数ヶ月から数年分の正常データが業務システムやセンサーにあれば、早期にモデル開発へ移れます。
ノイズや欠損、表記ゆれ、撮影・計測条件のばらつきが大きい場合は、前処理の作り込みが長引きます。
新たにデータを取る場合は、季節変動や稼働パターンの多様性を捉えるため、一定期間の観測が必要です。
正常データだけでも構築はできますが、精度評価には実際の異常事例がある程度必要です。
異常はまれなため、過去の記録が乏しいと評価用データの収集に時間がかかります。そこで、疑似異常を作る工夫が必要な場合もあります。
データの量・質・ラベルの条件が整っているほど、開発期間は短くなります。
リアルタイム性と対象データの種類
検知のタイミングと対象データによって、システムの設計や開発期間は変わります。たとえば、製造ラインの即時停止や決済の不正ブロックでは、リアルタイム検知が求められます。こうした用途では、推論の速さを前提にした設計が必要です。
- バッチ処理:日次・週次の分析なら、システム開発は比較的シンプルです。
- リアルタイム処理:低遅延や大量データの基盤、検知後の連携が加わります。
- データの種類:画像・音・振動・複数センサーは、専門的な前処理が必要です。
数値の表データやログは比較的扱いやすく、画像検査や音・振動の波形は特徴量抽出に工夫が要ります。
複数センサーの時系列も、前処理やモデル選定に時間がかかり、データの種別によって難易度が変わります。
基幹システムやMES、SIEMとの連携には仕様調整とテストも発生し、納期を押し上げます。そのため、要件定義の段階で、リアルタイム性の要否とデータ種別を明確にしておくと、日程を立てやすくなります。
開発期間を短縮する方法
進め方を工夫すれば、AI異常検知の開発期間は大きく短縮できます。具体的には、ゼロから作る範囲を減らし、不確実性を早い段階で確かめます。
既製の部品や基盤を使う方法と、PoCから段階的に進める方法があります。
既製部品・転移学習・MLOps基盤の活用
既存の資産を土台にすれば、アルゴリズムを一から実装する手間を省けます。
- 既製サービス:異常検知API、マネージドサービス、ライブラリなど。
- 転移学習:事前学習モデルを、自社データで調整する方法。
- MLOps基盤:学習・評価・デプロイ・監視を効率化する仕組み。
たとえば、外観検査向けの学習済みモデルや、時系列異常検知のライブラリが使えます。画像では、転移学習により少ないデータでも短期間で一定の精度に届くケースがあります。
MLOps基盤を整えると、データの版管理、実験記録、自動デプロイが揃います。その結果、精度改善のたびにかかる時間が減り、納期短縮につながります。
一方で、既製サービスが特殊な要件に合わない場合もあります。そのため、フルスクラッチ開発との使い分けが大切です。
PoCからの段階的移行とアジャイル開発
PoCで実現可能性と費用対効果を確認してから、本番へ段階的に移行します。
- PoC:価値が出やすい一つの対象に絞り、実現可能性を見極める。
- パイロット運用:検証結果を踏まえて、対象を広げる段階です。
- 本番展開:優先度の高い部分から順に、リリースを重ねます。
最初から全機能・全対象を作ると、要件が膨らみ、長期化や途中頓挫のリスクが高まります。工程が増えるように見えても、段階的な方法は手戻りと不要な作り込みを減らし、全体の期間短縮につながります。
要件を固めて一度に作るウォーターフォール型より、短いサイクルでモデルとシステムを改善するアジャイル型が適しています。精度の不確実性を扱いやすく、現場のフィードバックを早い段階から継続して開発に反映できます。また、価値の提供開始も前倒しできます。
納期設定と発注時の注意点
AI異常検知の不確実性を前提に日程を組めば、現実的な納期を設定でき、委託時のトラブルも防ぎやすくなります。そのうえで、データ準備に余裕を持たせる設計と、見積もり・契約時の確認事項を押さえておきます。
データ準備を律速と捉えたバッファ設計
納期が遅れる主な原因は、多くの場合、モデルの難しさよりデータ準備にあります。
- 棚卸し:データの量と品質を、初期の段階で一覧にします。
- 先行準備:不足があれば、収集や整備を先に行う。
- 余裕の確保:データ課題や精度調整に備え、全体の15〜20%程度を見込んでおきます。
正常データの不足、学習に耐えない品質、少ない異常事例による評価の難しさが、課題として表れることがあります。そのため、データ準備を律速工程と位置づけ、十分な期間を確保します。
精度は、実際に試すまで分からない面があります。そこで、目標を一点に固定せず、PoCの結果に応じて段階的に調整できる契約や計画にします。こうした進め方は、無理な納期による品質低下を避けるうえで役立ちます。
見積もり・契約時の確認事項
外部委託では、見積もりと契約の段階で成果や範囲を確認しておくと、後のトラブルを防げます。
- 契約段階:PoCと本番開発を分けて契約できるかを確かめる。
- 成果の定義:指標・水準・対象データを合意します。
- 契約形態:試行錯誤や予算の重視点に合わせて選びます。
- 運用支援:再学習や精度維持を、どこまで任せるかを決めます。
精度の見通しが立ちにくいため、PoCで実現可能性を確認し、その後に本番の範囲と費用を決める二段階契約が合理的です。
「異常を検知するシステム」という発注では、成果が曖昧になりがちです。完了条件まで書き込んでおくと、認識のずれを小さくできます。そのうえで、見逃しと誤検知のトレードオフも踏まえ、成果の条件を具体的に取り決めます。
契約形態として、請負契約は成果物の完成を約束し、準委任契約は工数に応じて費用が発生します。試行錯誤を伴うAI開発では、仕様を調整しやすい準委任契約が選ばれることが多くあります。一方で、予算の見通しを重視する場合は、請負を選ぶ判断もあります。
複数社から見積もりを取り、前提条件やスコープの違いを丁寧に比較することをお勧めします。
まとめ
開発期間と納期は、全体像から始め、要因と短縮策、発注時の注意点へと順に見てきました。
AI異常検知は、PoCに1〜2ヶ月、本番構築に3〜6ヶ月、企画から稼働まで半年から1年程度が目安です。
期間は、データの量と質、ラベルの有無、リアルタイム性で大きく変わります。中でも、収集・前処理・アノテーションは進みが遅れやすいため、余裕を持てるかが納期を左右します。
既製部品やMLOps基盤の活用、PoCから段階的に対象を広げるアジャイルな進め方は、期間短縮に有効です。
異常検知は、いま起きている異常を捉える技術です。将来の故障時期を予測する故障予知とは、目的が異なります。
まず自社データを洗い出し、小さく検証してから対象を広げる計画を立てます。そのうえで、経験のある開発パートナーに早めに相談し、二段階の進め方も含めて期間をすり合わせましょう。
▼全体ガイドの記事
・AI異常検知の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。