
AI異常検知の運用費は、推論方式、データ量、精度維持の体制で、月額数万円から数百万円まで変わります。
AI異常検知は、不正取引や外観不良、設備センサー、ログや通信に潜む攻撃を自動で検知する用途で広がっています。導入時は初期費用に加えて運用費も見込む必要があります。
▼全体ガイドの記事
・AI異常検知の完全ガイド
AIシステム開発の費用の考え方や見積もりの注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
▼見積依頼前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
AI異常検知の運用コストの全体像
AIシステムは初期開発が終わった後も、保守や運用の費用が継続して発生します。異常検知では、通常のバグ修正やサーバー保守に加えて、精度を維持するためのモデルの再学習やチューニングも必要になります。
一般的な年間費用は初期開発費の15〜25%で、内容によっては20〜30%が目安です。たとえば初期開発に1,000万円をかけた場合は、年間150万〜300万円程度を見込むのが現実的です。
発注側は、正常パターンの変化に追随する費用も含めて、システム保守とモデル保守の両方を予算に入れておく必要があります。
初期開発費に対する運用費の目安
年間運用費は、初期開発費の15〜30%程度が一般的な目安です。運用をどこまで作り込むかによって、この比率は変わります。
費用を左右する運用条件は、処理方式、求める監視水準、人員体制で、それぞれ比率に影響します。
- 定期分析:バッチ処理で構成すると、比率は低めになります。
- 常時監視:24時間の監視と高い精度の維持を求めると、比率は高めになります。
- 担当者の工数:精度確認や誤検知の分析、再学習の指示を担う人員をどう確保するかで、総費用が変わります。
常時稼働するインフラや、精度を改善し続ける人的コストは、ミッションクリティカルな用途でかさみます。人員を抑えたい場合は、MLOpsの自動化への初期投資が、長期的な削減につながります。
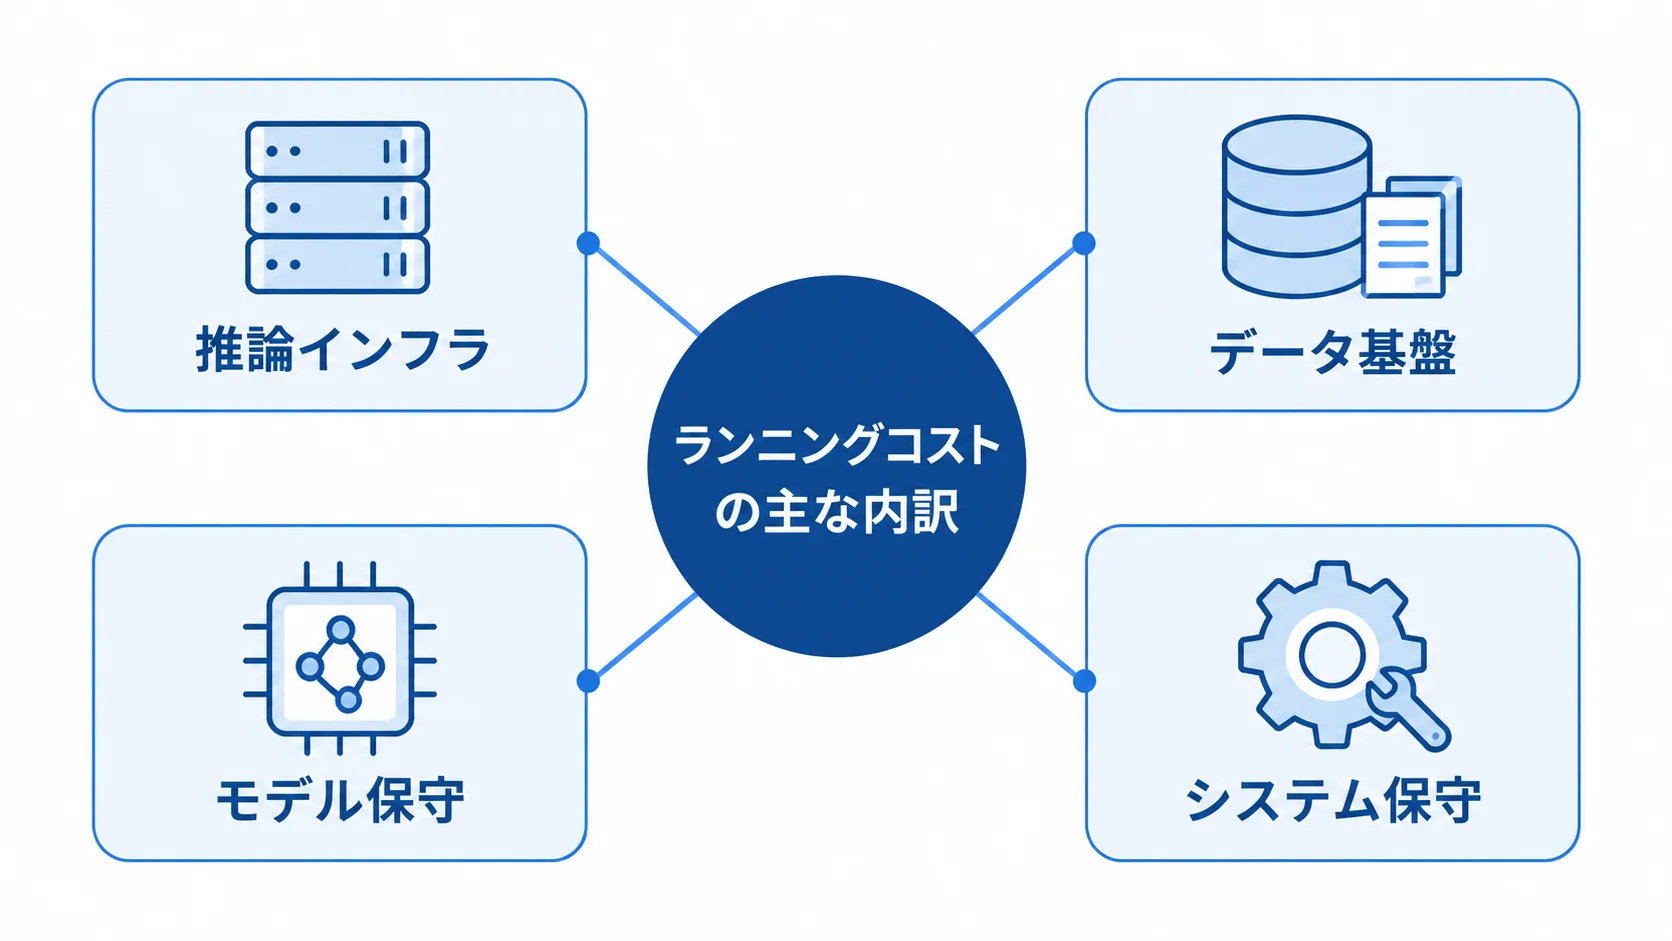
ランニングコストの主な内訳
ランニングコストは、推論インフラ、データ基盤、モデル保守、システム保守の大きく四つに分かれます。
- 推論インフラ:処理をサーバーやGPU、エッジ機器で行い、クラウドでは従量課金が発生します。
- データ基盤:監視データの継続的な収集と保存、ストリーミング処理の維持。
- モデル保守:ドリフト対応や再学習、精度監視、閾値調整にかかる人件費と計算資源。
- システム保守:通知やダッシュボード、障害対応、更新、連携部分の維持。
上の四つを合算したものが、月次・年次のランニングコストになります。
インフラ・推論にかかる費用
ランニングコストのうち、構成によって金額が大きく変わるのがインフラ・推論の費用です。実行場所や頻度、データ量に応じて、月額数万円から数百万円まで幅があります。費用は大きく、推論を実行する場所の費用と、データを蓄積・転送・処理する費用の二つに分かれます。
推論インフラ(クラウド・エッジ)の費用
推論インフラは、推論を実行する場所によって費用の性格が異なります。クラウドは、必要なときに計算資源を使う従量課金が基本で、データ量や推論回数によって費用が増減します。
- クラウド:大量の画像や時系列データをリアルタイムで処理するときは、GPUが必要になる場合があります。
- エッジ:現地に置くデバイスの初期費用がかかりますが、通信費や従量課金を抑えられる場合があります。
クラウドでは、トラフィックが急増すると費用が跳ね上がります。そこで、予算アラートや上限設定を先に決めておけば、想定外の費用増を防げます。
製造ラインのカメラやセンサーの近くに置くエッジは、通信費や従量課金を抑え、長期的に運用費を圧縮できる場合があります。
方式を比べるときは、リアルタイム性、データ量、拠点数、通信環境を踏まえ、総保有コストで検討します。
データ蓄積・転送・ストリーミング処理の費用
異常検知では、監視データを継続して取り込みます。保存期間や通信量、リアルタイム処理の有無によって、データ基盤の費用は変わります。
- ストレージ:高頻度センサーのデータや高解像度の画像を長期保存すると、費用が積み上がります。
- データ転送:エッジからクラウドへ、あるいは拠点間で送る通信費は、データ量に応じて増えます。
- ストリーミング:リアルタイムで検知する場合は、連続するデータを処理する基盤の維持費がかかります。
保存期間は再学習に必要な長さに絞り、その後は圧縮・要約・アーカイブします。こうした保持方針によって、費用を抑えられます。
加えて、検知の頻度やデータの粒度も業務上必要な水準に絞ります。細かいデータをすべて処理せず、検知に必要なデータだけを扱う設計にすると、費用の適正化につながります。
モデル保守:再学習とドリフト対応
異常検知のモデル保守は、通常のシステム運用とは性格が異なります。モデルは「正常とは何か」を学習するため、変化に追随できないと精度は静かに劣化します。精度劣化を招くドリフトへの対応と、定期的な再学習・精度モニタリングが、モデル保守の中心です。
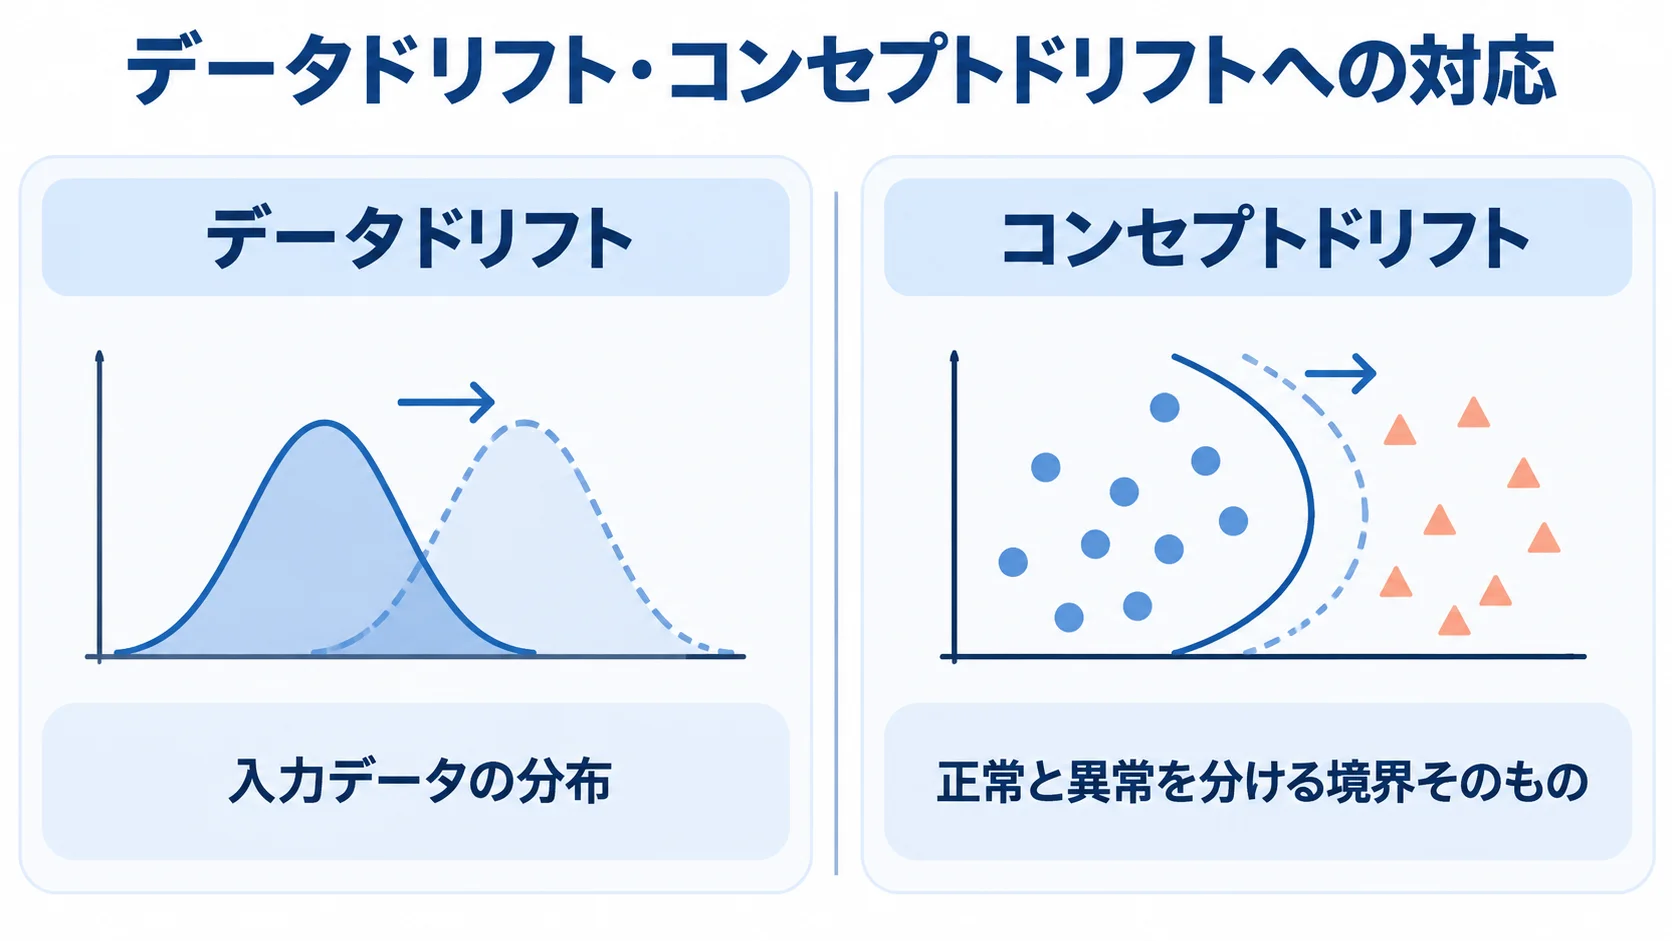
データドリフト・コンセプトドリフトへの対応
異常検知で精度劣化を招く代表例が、データドリフトとコンセプトドリフトです。両者は、変化する対象が異なります。
- データドリフト:入力データの分布が、時間とともに変化する状態です。
- コンセプトドリフト:正常と異常を分ける境界そのものが変わる状態です。
たとえば原材料ロットや製品仕様、季節による稼働パターンが変わると、正常データが学習時と異なる場合があります。そのため、以前は正常だったデータを異常と判定し、誤検知が増える恐れがあります。
業務ルールの変更や不正手口の巧妙化も、正常と異常の境界を変えることがあります。
まず、入力分布や検知結果を監視し、変化の兆候を早い段階でつかみます。次に、変化を検知したら新しい正常データを取り込み、モデルを更新します。
ドリフトの監視と対応は継続費用の中心になります。これを怠ると、システムが「使えない」と判断されて、投資が無駄になることもあります。
定期的な再学習と精度モニタリング
再学習は、新しいデータでモデルを学び直し、最新の正常パターンをモデルに反映する作業です。頻度は、対象環境の変化の速さに合わせて決めます。
- 変化の速い環境:月次や週次で再学習することがあります。
- 比較的安定した環境:四半期ごとに設定することがあります。
- 再学習の工程:データ準備、学習、精度再評価、本番反映を行います。
再学習を行うたびに、計算資源と担当者の工数がかかります。一方、精度モニタリングでは、現場から正しい検知・見逃し・誤検知のフィードバックを集めて、精度の推移を追います。
精度が基準を下回ったときにアラートを出し、再学習を促す仕組みがあれば、劣化を放置せずに済みます。
再学習やモニタリングを毎回人手で行うと負荷が高まります。そこで、MLOpsで工程をパイプライン化・自動化すれば、運用費を持続可能な水準に保てます。
運用チューニングと誤検知対応のコスト
誤検知への対応も、異常検知の運用で見落とされがちな費用です。正常なのに異常と通知する誤検知が多いと、現場の信頼が薄れ、システムが形骸化します。費用がかかる場面は、閾値の調整と誤検知への対応、そしてMLOpsとアラート運用です。
閾値調整と誤検知(false positive)への対応
異常とみなす閾値は、検知精度と現場の負荷を左右します。調整では、発注側と開発会社で、見逃しと誤検知のどちらを重視するかを決めます。
- 厳しい閾値:見逃しは減りますが、誤検知と確認作業が増えます。
- 緩い閾値:誤検知は減りますが、重要な異常を見逃すリスクが高まります。
見逃しと誤検知は、運用中も継続して調整する必要があります。この作業も費用の一部で、誤検知の原因を分析し、特徴量や閾値、モデルを見直す地道な調整が実用性を支えます。
一方で、重大な不良品の流出や不正の看過など、見逃しが致命的になる用途では、誤検知をある程度許容して見逃しを減らす設計が選ばれることもあります。
どちらのリスクを重視するかは現場と合意し、その方針を定期的に見直す運用プロセスが必要です。
MLOps体制とアラート運用
再学習や精度監視、閾値調整を手作業で続けると非効率で、担当者への依存も高まります。そこで役立つのがMLOpsで、機械学習モデルを運用し続けるための考え方です。
この仕組みでは、モデルの学習・評価・デプロイ・監視・再学習を、ソフトウェア開発のCI/CDのように自動化・仕組み化します。
- 監視と評価:データ分布と精度の自動確認。
- 再学習:基準を下回ったときに実行される仕組み。
- モデル管理:モデルのバージョンを管理。
MLOpsには初期投資が必要ですが、運用が長くなるほど投資対効果が高まり、人的コストを抑えながら精度を維持できます。
アラートについては、通知先と手段、優先度を定めたうえで、対応フローを設計します。重大度に応じて通知先や対応レベルを分けると、現場の負担を抑えつつ、重要な異常に対処できます。
運用コストを最適化するポイント
設計と運用に工夫を加えれば、AI異常検知の費用を適正な水準に近づけられます。機能をむやみに増やさず、費用対効果を見ながら、対象や体制にメリハリをつけます。
対象を絞るスモールスタートと、保守契約・内製・外注の判断が、主な打ち手になります。
スモールスタートとスコープ管理
運用費を抑える基本は、対象を絞ったスモールスタートです。製品ラインや拠点、データソースを広げると、監視対象が増え、インフラ費や再学習の手間も膨らみます。
- 対象を絞る:最も効果が見込める一つの対象から始めます。
- 段階的に広げる:成果と運用ノウハウをもとに、費用対効果を確かめます。
- 範囲を見直す:定期的に運用を振り返り、効果の薄い監視は縮小・停止します。
運用を続けると、検知価値が低い対象や、誤検知が多く役立たない領域が見つかることもあります。こうした見直しを続けると、無駄な費用を避けられます。
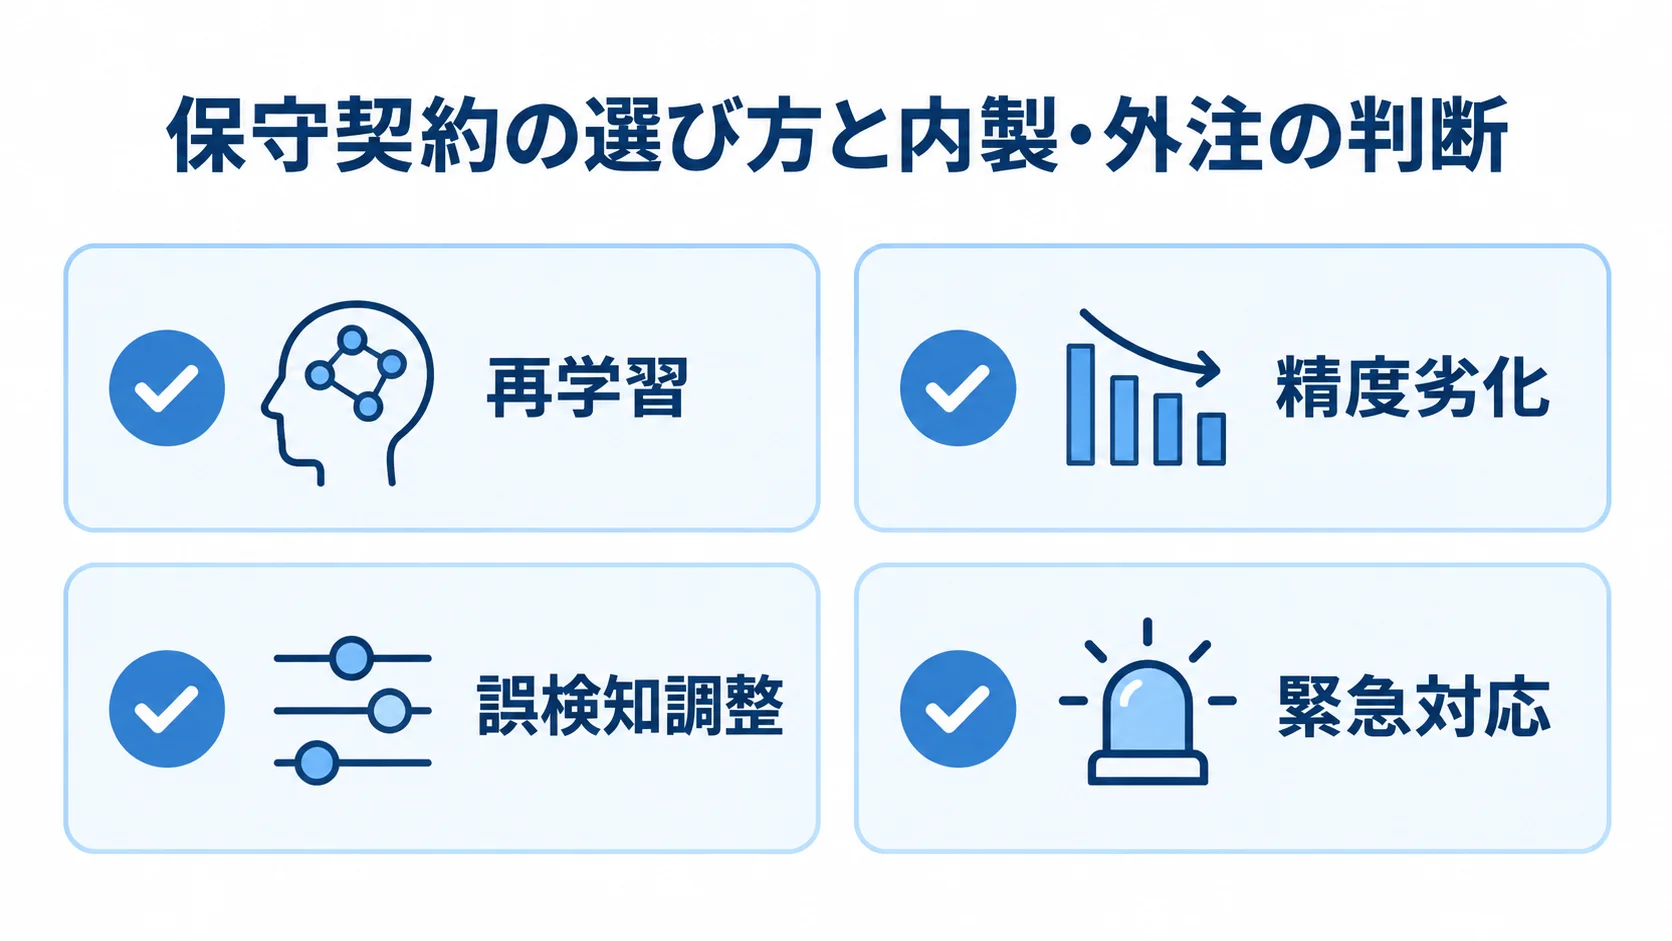
保守契約の選び方と内製・外注の判断
運用体制の選択も費用を左右し、外部委託には月額固定契約や作業量に応じた従量契約などがあります。保守契約では、契約の段階で各項目の範囲を確かめておきます。
- 再学習:実施頻度と契約範囲を確認する。
- 精度劣化:劣化時の対応範囲。
- 誤検知調整:チューニングの回数。
- 緊急対応:対応のスピード。
契約にモデルの再学習が含まれていないと、追加料金になることがあります。そのため、作業内容を発注側と開発会社で明確にしておくと、契約範囲の認識ずれを防げます。
自社で内製する方法も選択肢に入ります。長期の運用や頻繁な調整が続く場合は、データ分析やMLOpsの人材を育てることで、総費用を抑えられることがあります。ただし、人材の確保と育成には、別の費用とリスクがかかります。
たとえば、高度なモデル改善は外部に任せ、日常の監視やアラート対応は社内で担う分担があります。費用と品質のバランスを取りやすい方法のひとつで、自社の体制や頻度に応じて組み合わせます。
まとめ
AI異常検知の運用費は、年間で初期開発費の15〜30%程度が目安です。
推論インフラ、再学習とドリフト対応、誤検知への対応、コストの最適化という順に、費用の中身を見てきました。
なかでも再学習やドリフト対応は、精度を維持するための継続費用の中心です。モニタリングを怠ると、正常パターンの変化に追随できず、精度が劣化します。
MLOpsは初期投資を要しますが、長期的には人的コストを抑えながら精度を保つ助けになります。対象を絞ることや、効果の薄い監視を見直すことも有効です。
保守契約の範囲を確かめ、内製と外注を使い分けることも、費用の適正化につながります。判断の際は、初期費用だけでなく、運用を含めた総保有コストで考えます。
ここで扱った異常検知は、いま起きているデータの異常を捉える技術です。将来の故障時期を予測する故障予知とは、運用の勘所も違います。
導入時は、経験のある開発パートナーと運用体制まで擦り合わせておくことをお勧めします。
▼全体ガイドの記事
・AI異常検知の完全ガイド
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。