
AI異常検知のPoCは、対象と成功基準を決め、データを準備し、モデルを評価して、本番移行の可否を判断する順に進みます。
不正取引、外観検査、設備センサー、ログやネットワークの異常など、正常な状態から外れたデータを自動で検知する仕組みとして、多くの企業が導入を検討しています。
▼全体ガイドの記事
・AI異常検知の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI異常検知におけるPoCの目的と位置づけ
PoCはProof of Conceptの略で、本格開発の前に、技術が狙った効果を出せるかを小規模に確かめる取り組みです。AI異常検知は、精度が実データによって変わります。正常データに比べて異常データが極端に少ないこともあるため、限られた異常の事例でどこまで検知できるかは、事前に見通しにくいものです。
PoCをせずに本番開発へ進むと、費用を投じた後で、自社データでは十分な精度が出ない事態になりかねません。そこで、PoCによって、技術的な実現可能性に加えて、投資に見合う効果や社内関係者の納得も小さなコストで確かめておきます。期間と費用の目安は、小規模な場合で期間1〜2ヶ月、費用50万〜200万円程度です。
PoCで検証すべきこと
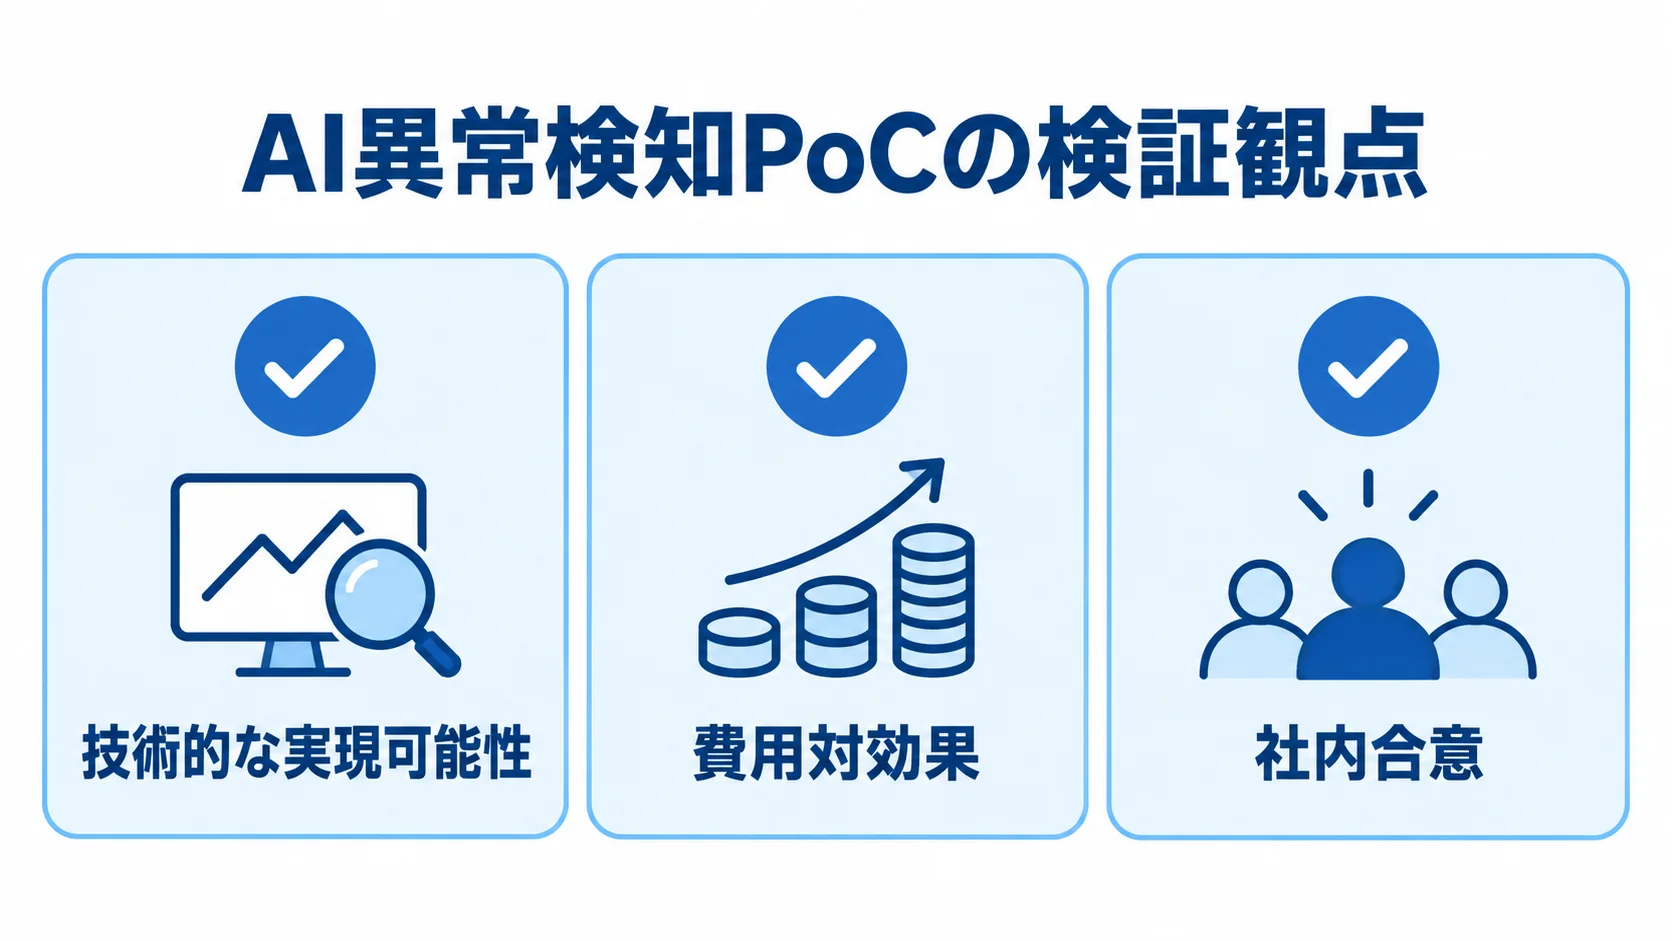
PoCで見るのは、技術、費用対効果、社内合意の三つの観点です。
- 技術性:自社データで狙った異常を実用に足る精度で検知できるか
- 費用対効果:見込む効果が投資に見合うか
- 社内合意:現場や経営層が導入価値を認めるか
技術面では、正常データから異常を切り分けられるかを確かめ、目視検査や閾値監視と比べて優れるかを数値で評価します。
効果は、不良品流出や検査工数の削減、不正被害の防止などを試算します。
技術的に検知できても、効果が投資額に届かなければ、本番導入の意味は薄れます。さらに、結果を関係者に示すことで、現場、情報システム部門、経営層の意思決定を後押しできます。
現場担当者が検知結果を使えると感じるかは、本番導入後の定着を左右します。そこで、この三つの観点を明確な検証項目として設計しておくことが、成果への第一歩です。
PoCの期間と費用の目安
期間と費用は、検証対象の広さやデータの準備状況で変わります。
- 小規模な場合:期間は1〜2ヶ月、費用は50万〜200万円程度が相場感
- 検証範囲:対象を一つに絞り目的を明確にすると、期間と費用を抑えやすい
- 主な工数:データ準備・整備、モデル構築・評価、結果分析・報告
- データ状況:正常データと異常事例がそろえば1ヶ月程度、収集から始めると期間が延びる
依頼前に、使うデータと成功の定義を取り決めておくと、無駄の少ないPoCにつながります。
PoC・プロトタイプ・モックアップの違いと進め方
PoC、プロトタイプ、モックアップは、検証する対象と目的がそれぞれ異なります。
違いと使い分けを押さえ、PoCの進め方を確認しておくと、開発会社との認識ずれを防げます。
三者の違いと使い分け
今確かめたいのが、精度、業務適合性、画面の使いやすさのどれかによって、選ぶ手法が変わります。
- モックアップ:画面や操作の見た目を、関係者と確かめる
- プロトタイプ:一部機能の動作や使い勝手を試す
- PoC:狙った精度が出るかを定量的に検証する
モックアップでは検知ロジックを動かさず、アラート画面や担当者の操作を含む業務フローを、関係者と合意しておきます。
プロトタイプでは、限られたデータで検知を実際に動かし、システムの流れを確かめます。
精度は最大の不確実要素となるため、PoCでは特に重視されます。
実務では、モックアップで業務フローと画面を固め、PoCで精度を検証し、プロトタイプで動作を確かめる流れもあります。
PoCの進め方のステップ
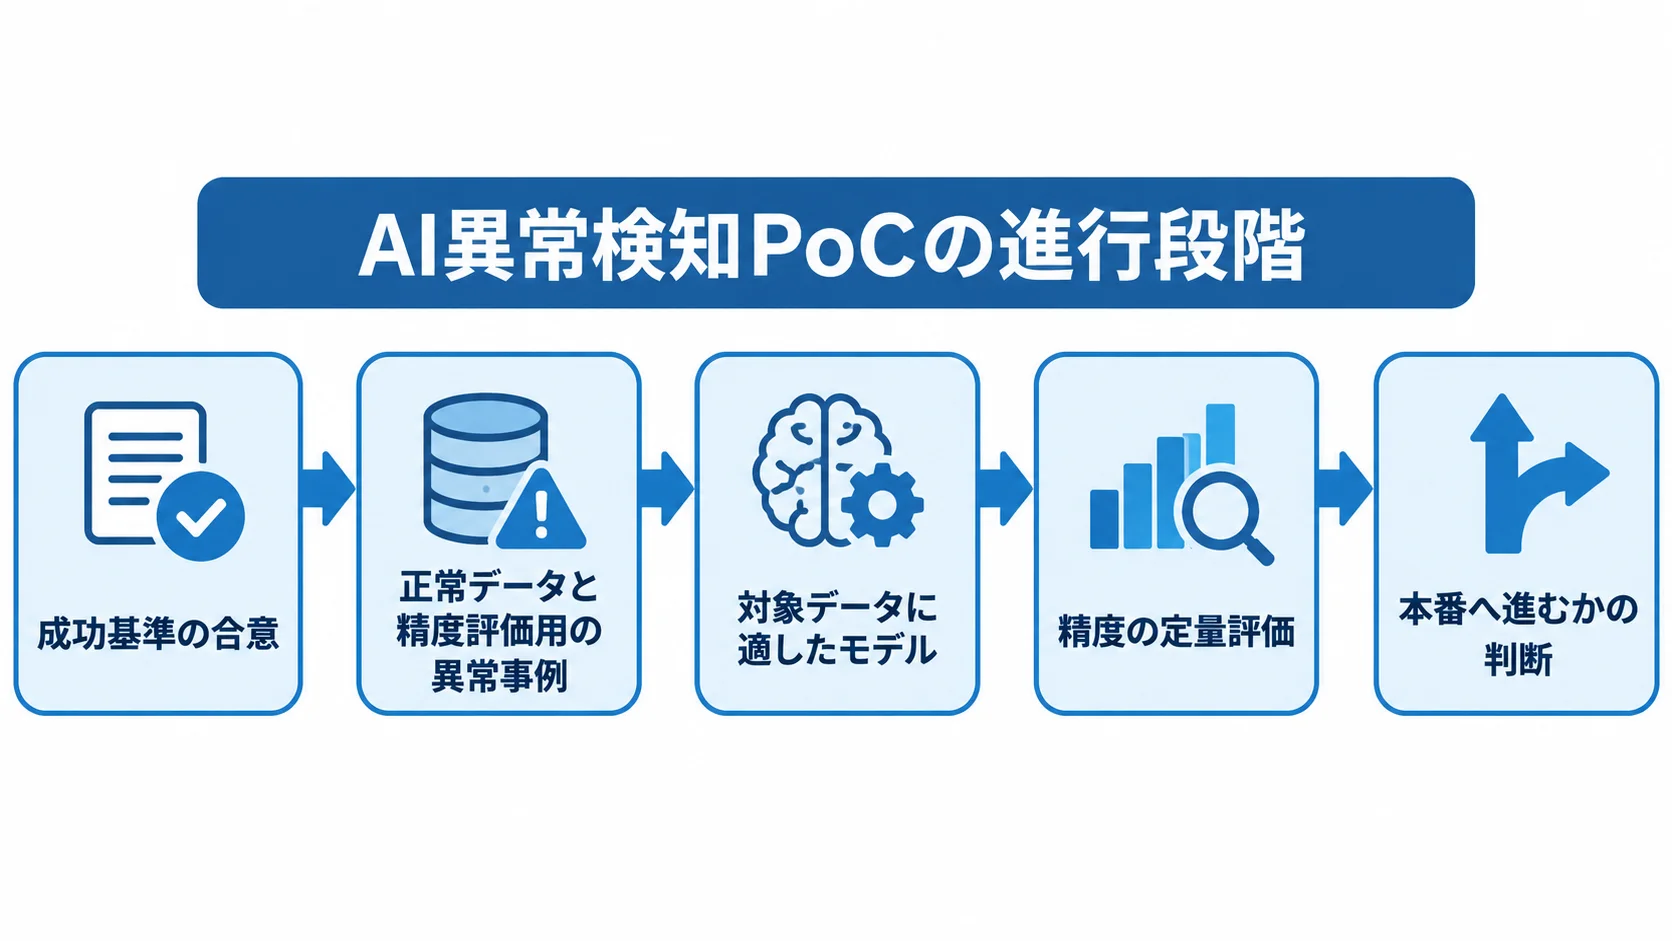
AI異常検知のPoCは、成功基準を合意するところから、結果を見て本番へ進むかを判断するまで、順に進めます。
各段階で必要な作業をそろえておくと、定量と定性の両面から検証できます。
- 対象の異常と検知精度を決め、成功基準を関係者と合意する
- 正常データと精度評価用の異常事例を集め、使える形に整える
- 複数の手法を試し、対象データに適したモデルを構築する
- 評価用データでモデルを検証し、精度を定量的に測る
- 成功基準の達成状況を分析し、本番へ進むか判断する
モデルの候補には、統計的な外れ値検出、Isolation Forest、One-Class SVMがあります。加えて、画像や時系列のデータでは、オートエンコーダなどの深層学習手法も選択肢に入ります。
現場担当者にも結果を見てもらい、実務で使える水準かを定性的に評価します。定量と定性の両面で確かめておくと、本番導入後のミスマッチを防げます。
評価指標の設計と本番移行の判断基準
PoCでは、精度の測り方が特に重要になります。異常検知は不均衡データを扱うため、正解率(Accuracy)だけでは精度を適切に測れず、見るべき指標を選ばないと、精度の良し悪しを読み違えかねません。
見逃しと誤検知のトレードオフを踏まえ、Go/No-Go(本番移行の可否)の基準も設計します。
不均衡データに適した評価指標
異常検知では、正常データが圧倒的に多く、異常データが極端に少ない不均衡データを扱います。そのため、この状況では正解率(Accuracy)だけで検知性能を適切に測ることは難しくなります。
異常が全体の1%なら、すべてを正常と判定しても正解率は99%です。そこで評価では、誤検知や見逃しの状況を表す指標を使います。
- 適合率(Precision):異常判定のうち実際に異常だった割合
- 再現率(Recall):実際の異常を正しく検知できた割合
- F1スコア:適合率と再現率のバランス
- PR-AUC:適合率と再現率のトレードオフを曲線下面積で評価
適合率が低いと誤検知が増え、再現率が低いと異常の見逃しが増えます。また、PR-AUCは不均衡データに最も適するとされ、モデルの総合性能を測ります。
PoCでは、使う指標と成功に必要な水準を先に定めておくと、結果を客観的に判断できます。
見逃し・誤検知のトレードオフとGo/No-Go基準
検知を敏感にすると見逃しは減りますが、正常なものを異常と判定する誤検知が増えます。
反対に、検知を鈍くすると誤検知は減りますが、本来の異常を見逃す可能性が高まります。
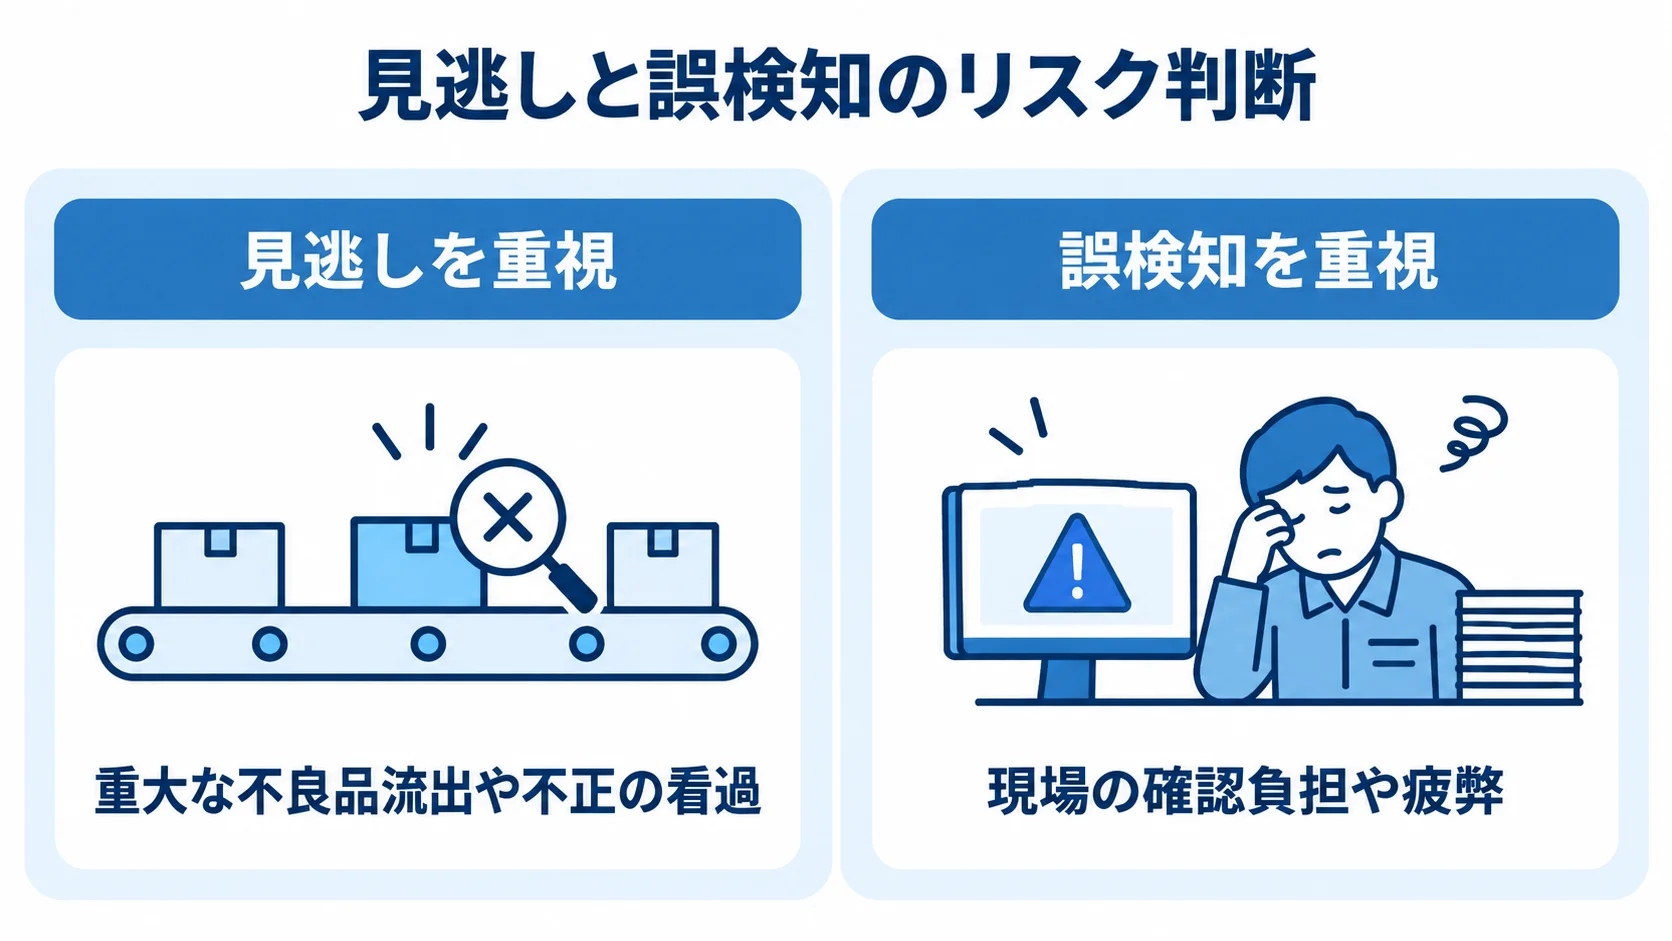
このトレードオフは異常検知につきもので、見逃しと誤検知を同時にゼロにはできません。そこで、業務で重く見るリスクを先に定めておきます。
- 見逃しを重視:重大な不良品流出や不正の看過を避ける
- 誤検知を重視:現場の確認負担や疲弊を抑える
見逃しを重視する場合は、誤検知をある程度許容して見逃しを最小限にする設計にします。一方で、誤検知を重視する場合は、見逃しを一定程度許容してでも誤検知を抑える設計にします。
リスクの重みづけを現場と合意したうえで、目標の水準をGo/No-Go(本番移行の可否)の基準にします。さらに、応答速度などの非機能要件も、業務に耐えるかを確かめます。
基準を先に決めておくと、印象ではなく客観的な事実でPoCの結果を評価できます。
PoC死を避けるコツ
多くのAIプロジェクトが、PoC死(PoC倒れ)に陥ります。PoCが中途半端に終わることもあれば、成功しても本番導入に至らないこともあります。
回避するには、対象を絞り、期待値を管理し、データを準備しておくことが欠かせません。
対象を一つに絞るスモールスタート
PoC死を防ぐには、検証範囲を絞り、成果を段階的に広げていくことが大切です。
- 広げすぎを避ける:初期要件の拡大が典型的な原因です。複数の製品ライン、異常、拠点を一度に検証すると、準備や試行が遅れて予算と予定を超えかねません。
- 対象を一つに絞る:検知したい異常のうち、効果が明確でデータがそろう対象を選ぶ
- 段階的に広げる:限られた予算と期間で成果を示し、第二、第三の対象へ成功を重ねて組織に根付かせる
小さく始めても、目指す先の大きさは変わりません。一点突破で価値を実証する進め方が、結果としてPoC死を遠ざけます。
期待値管理とデータ準備
PoCを止めないために、期待値とデータの状態は開始前に確かめておきます。
- 期待値をすり合わせる:高すぎる期待はPoC死を招くため、完璧な検知を前提にせず、見逃しと誤検知や精度改善の段階を共有する
- データを洗い出す:正常データと評価用の異常事例について、量と品質を把握する
- 不足分を準備する:データが足りなければ、早めに集めて整える。着手後に不足が分かることもある
十分なデータがなければ、正当な検証はできません。そのため、現状の把握をPoC設計の最初のステップにします。
PoCから本番への移行とスモールスタート設計
PoCの結果が良くても、いきなり全社へ展開するのはリスクがあります。そこで、パイロット運用を挟み、段階的な移行と拡張を設計します。
パイロット運用を挟む段階的移行
PoCと本番展開の間には、パイロット運用を挟む方法があります。PoCは限定的なデータでの技術検証です。そのため、実業務で継続して使ったときの様子は、別に確かめる必要があります。
パイロットでは、特定の部署やラインに限定して、検知システムを日常業務に組み込みます。
- データ:リアルタイムに流れ込むデータへの対応
- 現場運用:使い勝手とアラートへの対応フロー
- 継続性:時間経過に伴う精度の変化
想定外のデータによる誤検知や、アラート過多で現場が対応しきれない問題も、この段階で見つかります。そこで、現場からのフィードバックをもとに、モデル、閾値、業務フローを調整してから本番展開します。
実用の水準まで整えてから進めば、大規模導入後の手戻りや現場の混乱を防ぎ、導入の成功確率を高められます。
本番展開と拡張計画
本番展開では、対象の拡大と継続運用を合わせて計画します。
- 対象を広げる:全対象へ一度に拡大せず、横展開しやすい対象から精度と運用フローを確かめる
- 運用体制を整える:再学習頻度、精度監視、誤検知調整、インフラ増強を計画する
- 精度を維持する:MLOps基盤と運用ルールを整備し、継続的に価値を出す仕組みを作る
- 効果を記録する:PoCでの成果を本番後も測り、経営層へ報告して、追加投資や横展開の判断を円滑にする
パイロットで実用性を確かめたうえで段階を踏めば、AI異常検知を組織に根付かせられます。
まとめ
AI異常検知のPoCでは、目的と位置づけ、試作手法の違いと進め方、評価指標、PoC死の防ぎ方、本番移行の考え方を解説しました。AI異常検知は実データで精度が変わるため、PoCで技術性、費用対効果、社内合意を確かめます。
小規模なPoCは期間1〜2ヶ月、費用50万〜200万円程度が目安です。そのうえで、対象を絞って成功基準を決め、不均衡データ向けの指標と現場のリスク判断をもとに、本番可否を見極めます。
成功したあとは、パイロットを経て段階的に展開し、大規模導入後の混乱を避けます。なお、ここで扱った異常検知は現在のデータの異常を捉える技術で、将来の故障時期を予測する故障予知とは目的が異なります。
導入時は、まず小さなPoCから始め、経験のある開発パートナーと成功基準や進め方をすり合わせます。
▼全体ガイドの記事
・AI異常検知の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。