
AIアシスタント開発の期間は、1ヶ月から12ヶ月以上までの幅があります。参照するナレッジの範囲、社内システムとの連携数、求める回答精度で、その位置が決まります。
問い合わせ対応や社内ヘルプデスク、営業支援、資料作成を担うAIアシスタントの導入が広がっています。
▼全体ガイドの記事
・AIアシスタント開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AIアシスタント開発の開発期間の全体像
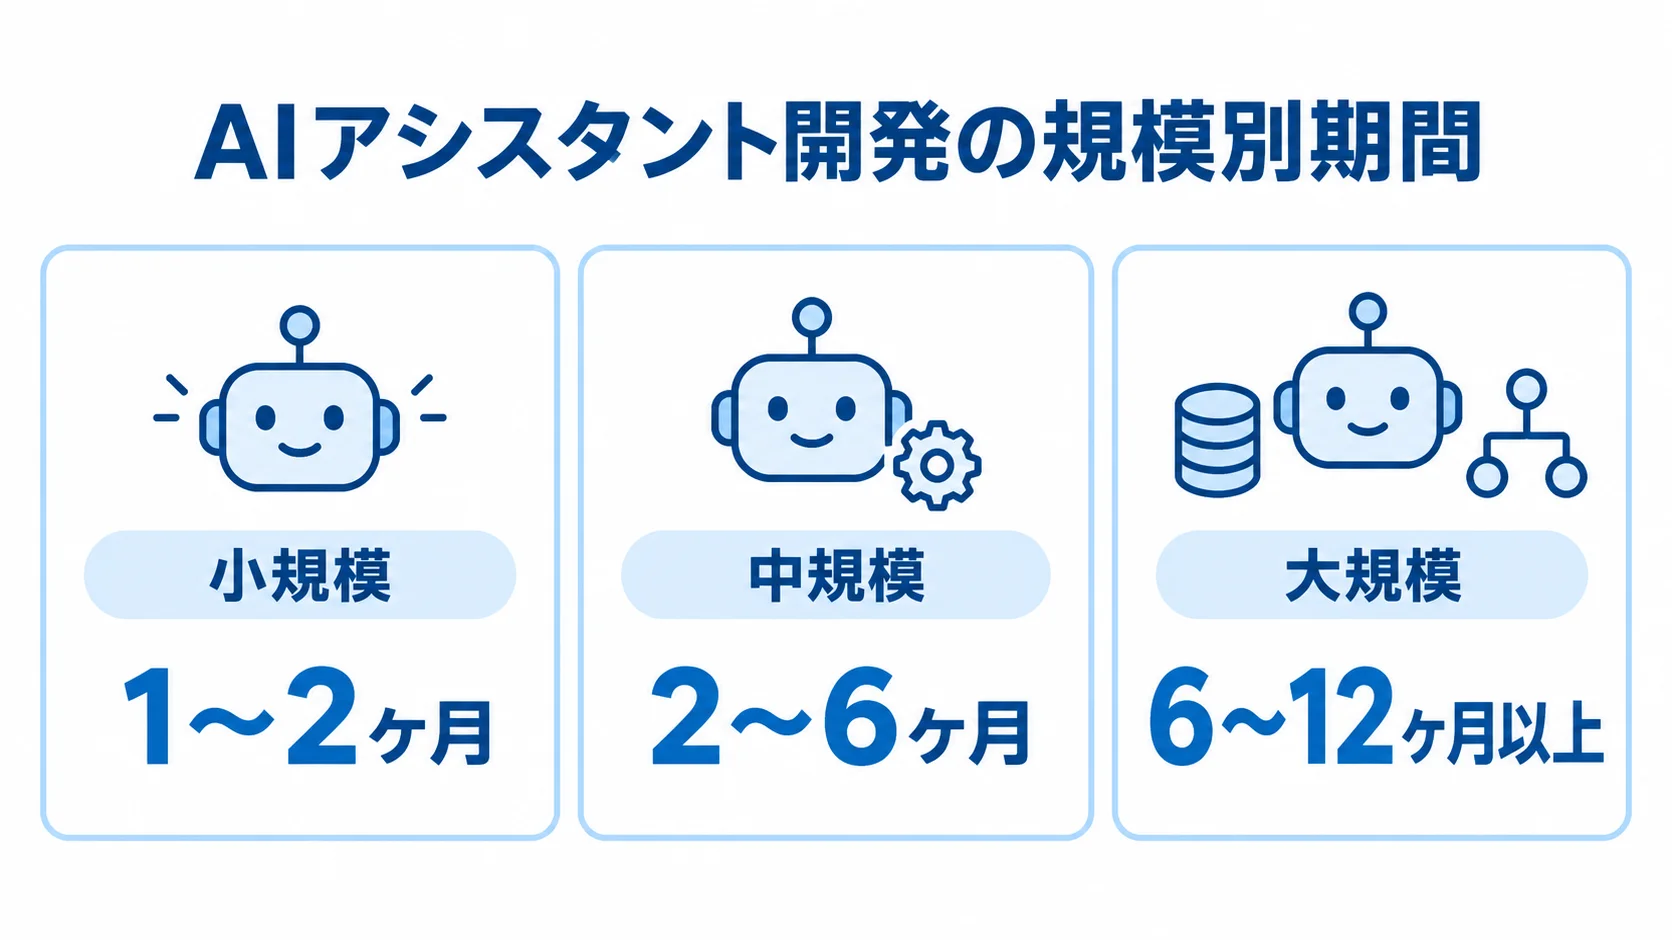
全体の目安は1ヶ月から12ヶ月程度です。たとえば、社内FAQに答えるだけのシンプルな構成なら1〜2ヶ月、基幹システムと連携して業務処理を行う構成なら半年以上を見込みます。期間の差は、参照ナレッジの範囲、社内システムとの連携数、そして単一の対話エンジンで足りるか複数エージェントが要るかから生まれます。
従来のWeb開発は、画面数や機能数で工数を積み上げやすい一方で、AIアシスタントではデータ整備と精度検証が期間を決めます。
規模別の開発期間の目安
規模別の期間は、参照する情報と連携処理の複雑さで決まり、大きく3つの範囲に分かれます。
- 小規模:単一FAQなどを扱う対話アシスタントで、1〜2ヶ月(約3〜8週間)
- 中規模:社内DBやSaaSと連携する構成で、2〜6ヶ月
- 大規模:計画・検索・実行を分担する専門エージェントと基幹システムの統合で、6〜12ヶ月以上
Microsoftの調査では、データ基盤やセキュリティを整えた成功企業は平均6ヶ月未満で導入しています。一方で、準備が不足した企業は9ヶ月以上かかる傾向があると報告されています。
同じ規模でも、データ整備と社内体制の準備状況によって納期は倍近く変わり得ます。さらに、意思決定やナレッジ整理の進み方も期間に影響します。
構成要素が期間を左右する理由
対話・生成エンジン、RAG、Function Callingの3つは、増える作業の中身がそれぞれ違うため、期間への効き方も異なります。
- 対話・生成エンジン:独自の応答を作り込むほど、プロンプト設計が増える
- RAG(検索拡張生成):対象文書の量と品質が、検索準備の工数を左右する
- Function Calling/ツール連携:連携先が増えるほど、設計とテストが増える
既存のLLM(GPT系やClaude系など)をAPI経由で使えば、対話エンジンの開発を短くできます。一方で、社内マニュアルやFAQ、規程類をベクトル化するRAGは、文書の量と品質によって工数が変わります。
Function Callingは、社内システムの操作や外部APIからの情報取得に使います。3要素の作り込み範囲によって、質問応答にとどめるか、業務処理まで自動化するかが決まります。
開発期間は、内部の構成要素を分けて見積もると精度が上がります。見積もりの段階で3要素それぞれの実装範囲を書き出しておくと、後からスケジュールがずれるのを防げます。
工程別のスケジュールと期間配分
標準的な工程は、要件定義とPoCから始まり、設計と実装を経てテストを行い、運用開始へ進みます。合計の目安は、シングルエージェント構成で1〜3ヶ月、マルチエージェント構成で3〜12ヶ月です。工程ごとの期間配分は構成によって異なるため、構成ごとに各工程の目安を示します。
要件定義・PoC・設計フェーズ
上流工程では、発注側と開発会社が、対象業務と任せる範囲、問い合わせや処理の種類を決めます。あわせて、参照するナレッジと連携するシステムを洗い出します。
- 要件定義:シングル構成で2〜4週間、マルチ構成で4〜8週間
- PoC(概念実証):要件定義後に2〜4週間
- 設計:シングル構成で2〜4週間、マルチ構成で4〜12週間
LLMやRAGは自社データで動かさないと精度を予測しにくいため、本格的な設計や実装の前にPoCを行います。限定した業務で実データを使い、必要な精度が出るかを見極めます。
設計では、システム構成とプロンプト、UI、RAGのデータ構造を決めます。マルチ構成では、役割分担と協調フローの設計が加わるため、期間の幅も広がります。
上流工程を丁寧に進めると、後工程の手戻りが減り、全体の納期短縮にもつながります。
実装・テスト・リリースフェーズ
実装から運用開始までの期間は、シングル構成とマルチ構成で異なります。
- 実装:シングル構成で4〜8週間、マルチ構成で8〜24週間
- テスト:シングル構成で2〜4週間、マルチ構成で4〜8週間
- 運用開始:シングル構成で1〜2週間、マルチ構成で2〜4週間
設計が固まると実装に移り、LLMの組み込みやRAGパイプラインの構築、Function Callingによるツール連携を進めます。UIの作り込みも、この工程で行います。
複数エージェントの連携や複雑なワークフローが加わるため、実装は最も長い工程になります。実装と並行して、想定質問への応答精度も確かめます。
テストでは、通常の動作に加えて、例外入力への対処とハルシネーション(誤回答)の検出を行います。機密情報の漏洩防止や権限制御も検証します。
運用開始の時点では、開発会社が本番環境を構築し、現場向けのトレーニングと初期の利用状況の監視を行います。
精度はリリース後も、利用しながら改善します。リリースは完成ではなく、運用改善の出発点と捉えることが定着につながります。
AIアシスタント特有の工程がスケジュールに与える影響
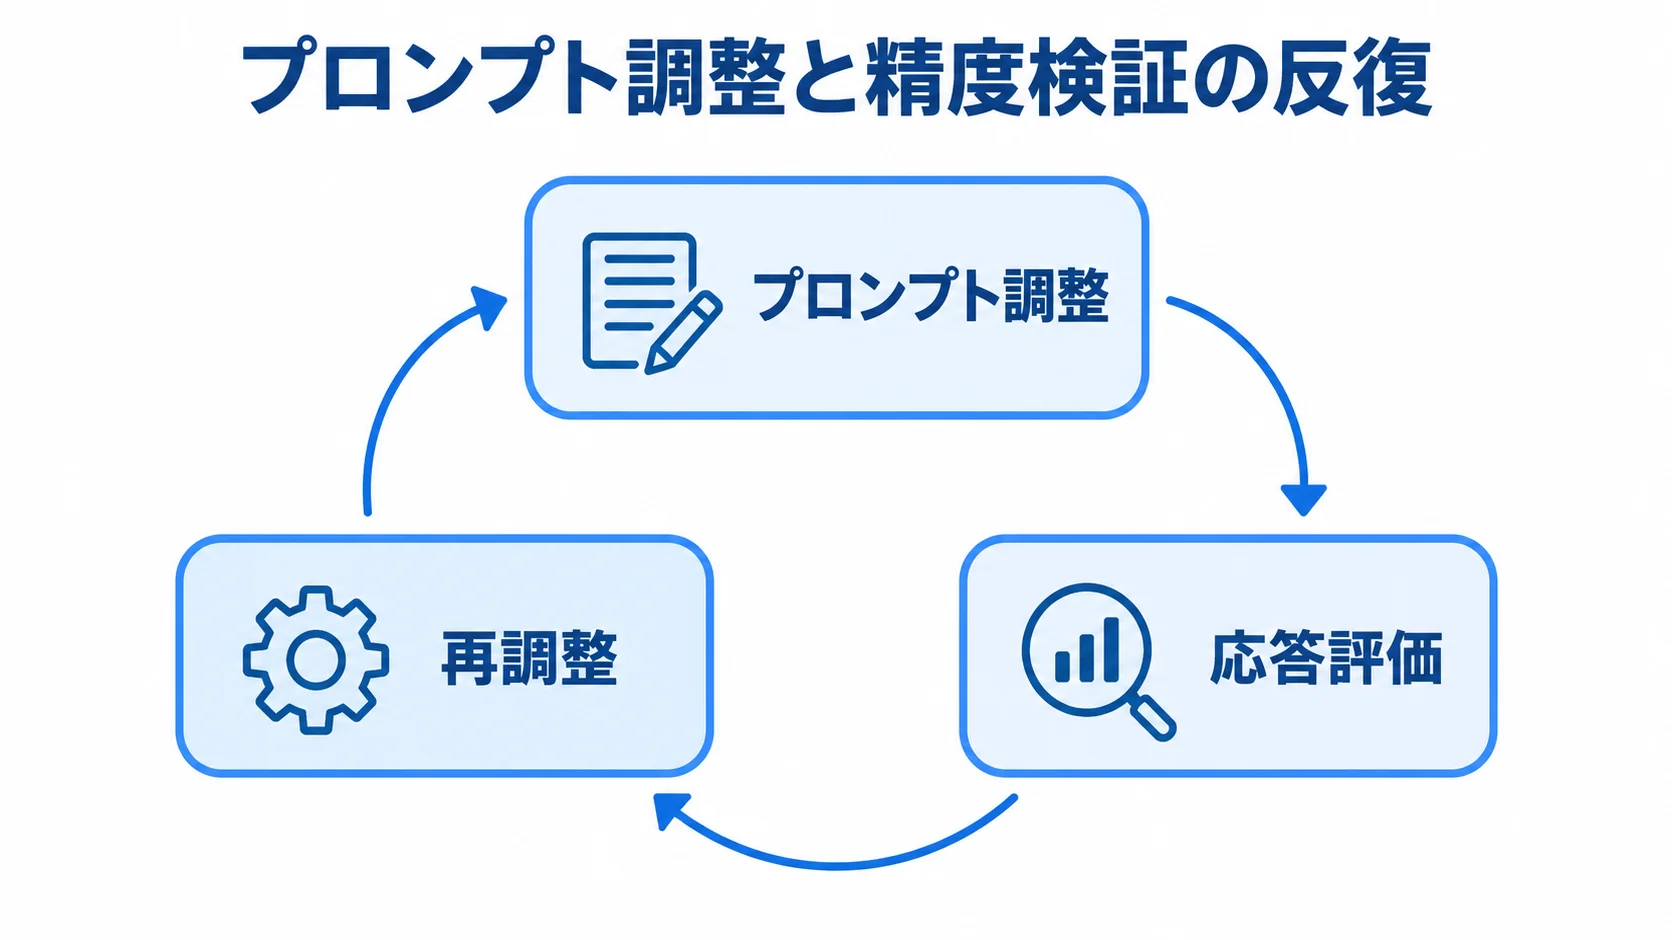
AIアシスタント開発では、データ整備と精度検証の反復が期間に大きく影響します。具体的には、データ整備は文書の量と品質で工数が変わり、精度検証は、LLMが同じ質問でも毎回同じ回答を返すとは限らないため、反復が必要になります。これらは従来のウォーターフォール型開発では、見積もりから漏れやすく、軽視されやすい工程です。この2つを見落とすと、納期遅延につながります。
データ整備(AI-Ready化)とRAG構築
RAG構成では、回答精度が検索対象の文書品質に直結します。そのため、マニュアルやFAQ、規程類を、AIが正しく検索・参照できる状態(AI-Ready)に整える必要があります。
- クレンジング:古い情報や重複した記述を整理する
- チャンク分割:文書の意味構造に沿って検索単位に区切る
- メタデータ付与:検索精度を高める情報を文書に付ける
PDFやスキャン画像、表組みの多いExcelに文書が散在していると、整備工数が膨らみます。また、遅延するプロジェクトの多くは、データ整備の甘さに起因します。
整備しないまま検索すると、古い情報や無関係な文書を参照して誤回答が増え、データを作り直す手戻りが起きます。そこで、データ整備は初期段階から工程に含め、可能であれば発注側で文書を洗い出して整理すると、全体の納期短縮につながります。
プロンプト設計と精度検証のイテレーション
もう1つの特有工程は、プロンプト設計と精度検証の反復(イテレーション)です。LLMは、同じ質問でも毎回同じ回答を返すとは限らない、非決定論的な性質を持っています。
- プロンプト調整:検索結果を正しく解釈させ、誤回答を防ぐ
- 反復の上限設定:目標精度までの回数や期限を事前に決める
- 運用での改善:期限時点の精度で運用を始め、残りを改善する
プロンプトを変えて応答を評価し、再調整を重ねることで、精度を安定させます。とくに医療、金融、法務など95%以上の高精度が求められる領域では、テストと改善に数ヶ月の追加工数がかかることもあります。
目標精度の例は、回答の正確性90%以上です。到達までの反復回数や期限を先に決めておくと、期限の時点の精度で運用を始め、残りの課題は運用しながら改善できます。
必要な反復回数は、事前に確約できるものではありません。そのため、検証を終わりなく続けるより、実用水準で一度リリースし、実データのフィードバックで改善する方法が現実的です。
開発手法による期間の違い
開発手法によって、AIアシスタント開発のスケジュールは変わります。AIの挙動は事前に確定しにくいため、ウォーターフォールとアジャイルのどちらを選ぶかは、納期の見通しやリスクに関わります。
発注側は、それぞれの進め方と適性を踏まえて、仕様変更の扱いや段階的なリリースの可否を判断します。
ウォーターフォール型が不向きな理由
ウォーターフォール型(固定価格の一括請負)は、要件を固めてから設計、実装、テストと順に進める手法です。画面や機能が明確な従来型の開発では有効です。
- 途中の要件変更:調整のたびに追加費用と期間が生じやすい
- 机上での仕様確定:実データで精度が出ず、大幅な作り直しになり得る
- 固定予算で進める場合:業務を絞り、現実的な精度目標と変更管理を事前に決めて文書にする
AIは実際に動かして精度を確かめるため、要件やプロンプトを頻繁に見直すことになります。一括請負では、変更のたびに追加費用と期間が積み上がり、当初の見積もりを超える恐れがあります。
変更を例外として扱う一括請負は、仕様が定まりにくいAIアシスタント開発と、構造的に相性がよくありません。
最初に要件を固めようとして、実データでの検証より前に仕様を決めると、想定した精度が出ず、作り直しになることがあります。
アジャイル型(ラボ型・準委任)による段階的リリース
AIアシスタント開発では、アジャイル型(ラボ型・準委任)が主流かつ安全とされています。月額契約などで始め、現場の反応を得ながら柔軟に軌道修正し、精度を段階的に高めます。
- 小さくリリース:限定業務で最小限のアシスタントを先に提供する
- 短い期間で確認:できる範囲を確かめて方向性を修正する
- 完了条件を設定:精度や業務削減効果の目標を達成基準にする
早い段階で現場に使ってもらいながら改善すると、途中で納期の見通しを確かめ直せます。
作りながら精度を確かめておけば、大きな手戻りが起きる前に気づけるため、全体のリスクを抑えられます。
終了基準が曖昧だと、改善が際限なく続くことがあります。そこで、目標を満たした段階で次のフェーズへ進むという線引きが必要です。
実用最小限の範囲から価値を出し、そこから広げていく計画が、納期とコストの管理につながります。
納期遅延の典型要因と対策
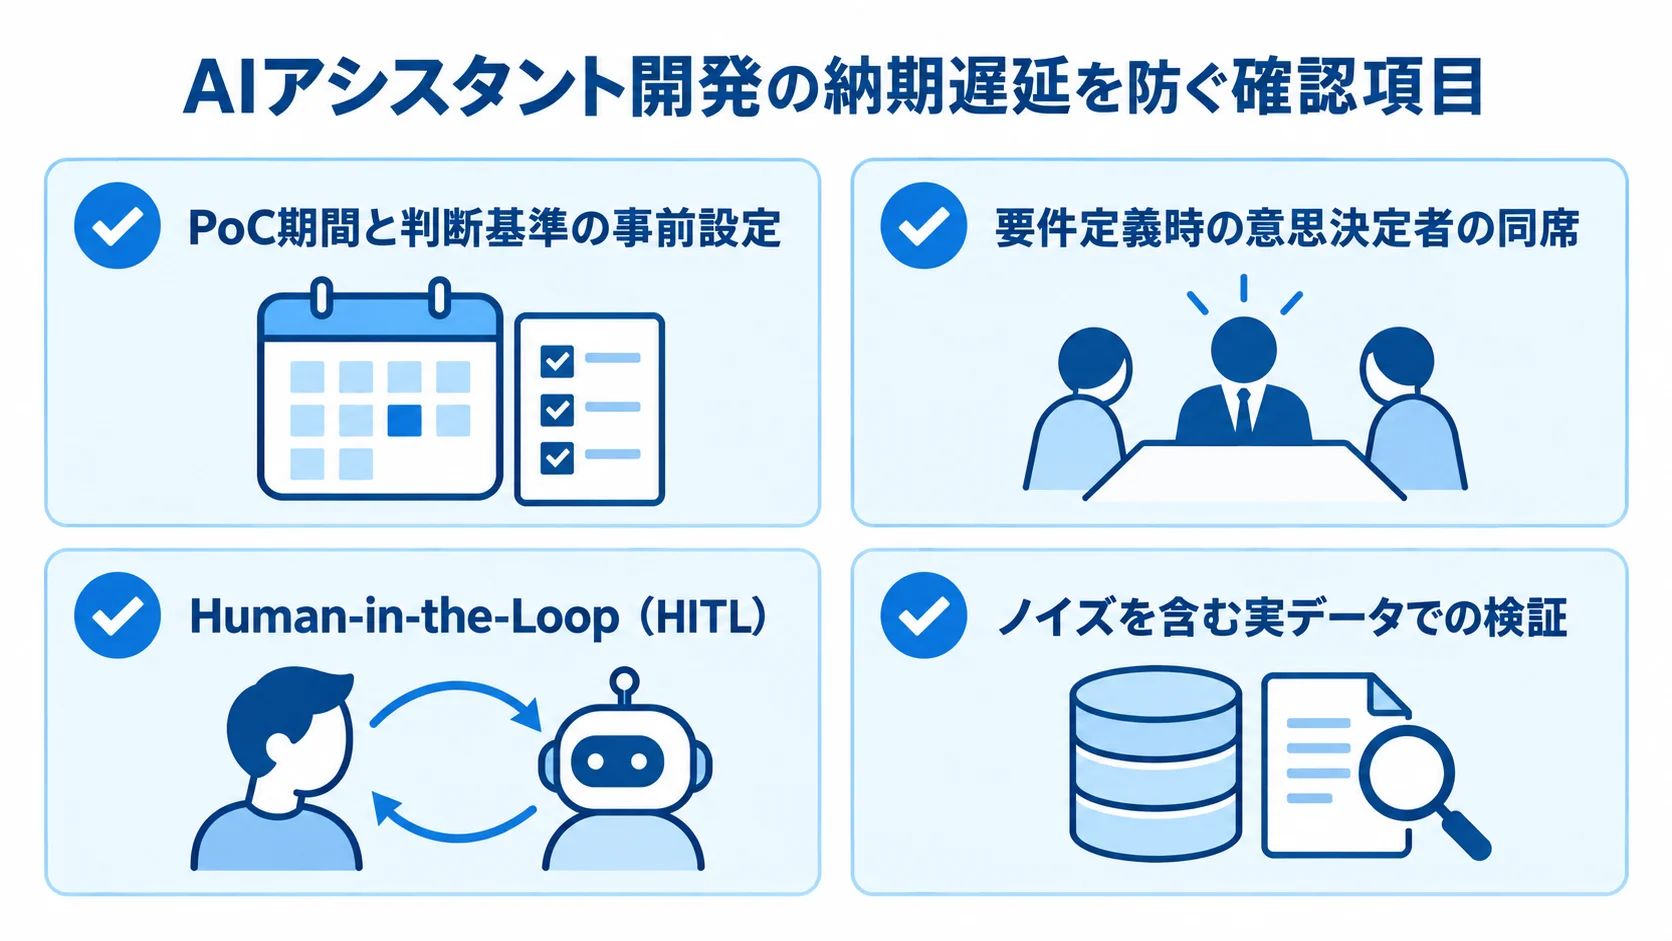
納期遅延には典型的なパターンがあります。技術の難しさより、進め方や意思決定の問題で起きることが多く、事前に知っておけば大半は予防できます。
PoCの長期化と意思決定者の承認待ち
PoC(概念実証)の長期化は、よくある遅延要因です。2〜4週間で区切るはずの検証が、精度向上や別パターンの確認を理由に延び、本番へ移れないことがあります。
- PoCの長期化:期間と回答精度などのGo/No-Go基準を先に決める
- 承認待ち:要件定義時に意思決定者も同席し、範囲や優先順位をその場で決める
判断基準は、「回答精度○%以上」「処理時間○%削減」などの定量条件にします。満たせば本開発へ進み、満たさなければ仕切り直します。
自動化の優先順位や範囲の決定で承認が滞ると、1ヶ月以上遅れることがあります。確認を一つずつ回すより、関係者を集めて重要事項を一度に決めたほうが、時間を短縮できます。
フルオート志向とデータ品質による手戻り
もう1つの遅延要因は、完全自動化(フルオート)を急いで、計画が行き詰まることです。本番データの品質不足も、手戻りを招きます。
- 完全自動化の先行:Human-in-the-Loop(HITL)で人の確認を残す
- 本番データの確認不足:PoCからノイズを含む実データで検証する
最初から人を介さずにAIへ全処理を任せると、想定外の入力や例外に対応できず、例外処理が複雑になって停滞しかねません。そのため、運用実績を積んでから、自動化の範囲を段階的に広げます。
データ品質による手戻りも、遅延要因です。PoCで整ったデータだけを使うと、本番の古い情報や表記揺れで精度が落ちることがあります。
レイアウト崩れなどを含むノイズのある実データも一部使い、データ連携や前処理の課題を早い段階で洗い出します。
人とAIの協働で始めれば、リリースまでの期間を短縮できます。加えて、本番データの課題を先に確かめておくと、後半の手戻りを防ぎ、納期を守る助けになります。
まとめ
ここまで、規模別の期間目安、工程ごとの配分、AI特有の工程、開発手法、納期遅延の要因と対策を見てきました。
期間は小規模で1〜2ヶ月、中規模で2〜6ヶ月、大規模なマルチエージェント構成で6〜12ヶ月以上が目安です。納期はデータ整備と精度検証の反復時間にも左右されます。
AI-Ready化やプロンプト調整を見込まずに計画すると、納期が後ろ倒しになることがあります。
2〜4週間のPoCで実現可能性を確かめ、アジャイル型で段階的にリリースしながら精度を高める進め方が現実的です。
PoCは期限で区切り、Go/No-Goの定量基準を設けます。HITLを前提にし、ノイズを含む実データを早期に検証すると、遅延の多くを予防できます。
導入時は、対象業務を1つに絞り、実データを使った小さな検証から始める方法があります。また、信頼できる開発パートナーと現実的なスケジュールを共有することが、プロジェクト成功への近道です。
▼全体ガイドの記事
・AIアシスタント開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。