
カスタマーサポートへのAI導入は、目的の明確化から始め、小さく試してから本格展開し、運用しながら改善していく5つのステップで進めます。
問い合わせ件数の増加やオペレーター不足などの慢性的な課題を抱える企業は少なくありません。各ステップの要点と、失敗の回避策を説明します。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
AI活用の全体は、次の完全ガイドで体系的に解説しています。
全体像をつかむためのガイドはこちらです。
「作成年度」「対象部署」「文書種別(規定・マニュアル・FAQ・議事録)」をメタデータとして付与し、古い版や無関係な資料を検索から外すフィルタリング設計が必要です。
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
カスタマーサポートでAIが注目される背景
カスタマーサポートへのAI導入が急速に進んでいる背景には、業務構造上の根本的な課題があります。問い合わせチャネルは電話・メール・チャット・SNSへと多様化が進む一方で、対応できる人材の確保と育成には時間とコストがかかります。こうした中で、AIはまず定型的な業務から着実に担い手となりつつあります。
現場が抱える3つの慢性課題
現場では、大きく3つの慢性課題が積み重なっています。第一は「問い合わせ量の増大と属人化」です。製品やサービスが多様化するほど問い合わせの種類も増え、特定のベテランオペレーターに業務が集中しがちです。
第二は「対応品質のばらつき」です。担当者によって回答内容や対応速度に差が生じ、顧客満足度の低下に直結します。第三は「オペレーター採用・育成コストの上昇」です。
新人が独り立ちするまでの研修期間は業種によって異なりますが、多くの企業で数か月単位のトレーニングが必要とされています。こうした課題は、AIの活用によって段階的に緩和できる余地があります。
生成AI・LLMの台頭が変えたサポートの可能性
従来のルールベース型チャットボットは、想定外の表現や複雑な質問に答えきれず、「使いにくい」という印象を与えることが多くありました。しかし、大規模言語モデル(LLM)の実用化により、自然な文章で書かれた問い合わせの意図を正確に読み取り、回答を動的に生成するシステムが現実のものとなりました。
FAQが50件未満の小規模な用途ではシナリオ型でも対応できますが、50件を超える規模になると、AI搭載型でなければ回答到達率が著しく低下することが知られています。生成AIとRAG(検索拡張生成)を組み合わせると、FAQ化されていない社内マニュアルや規定からも直接回答を生成できるようになり、対応できる問い合わせの幅が飛躍的に広がっています。
カスタマーサポートのAI活用 導入の全体ステップ
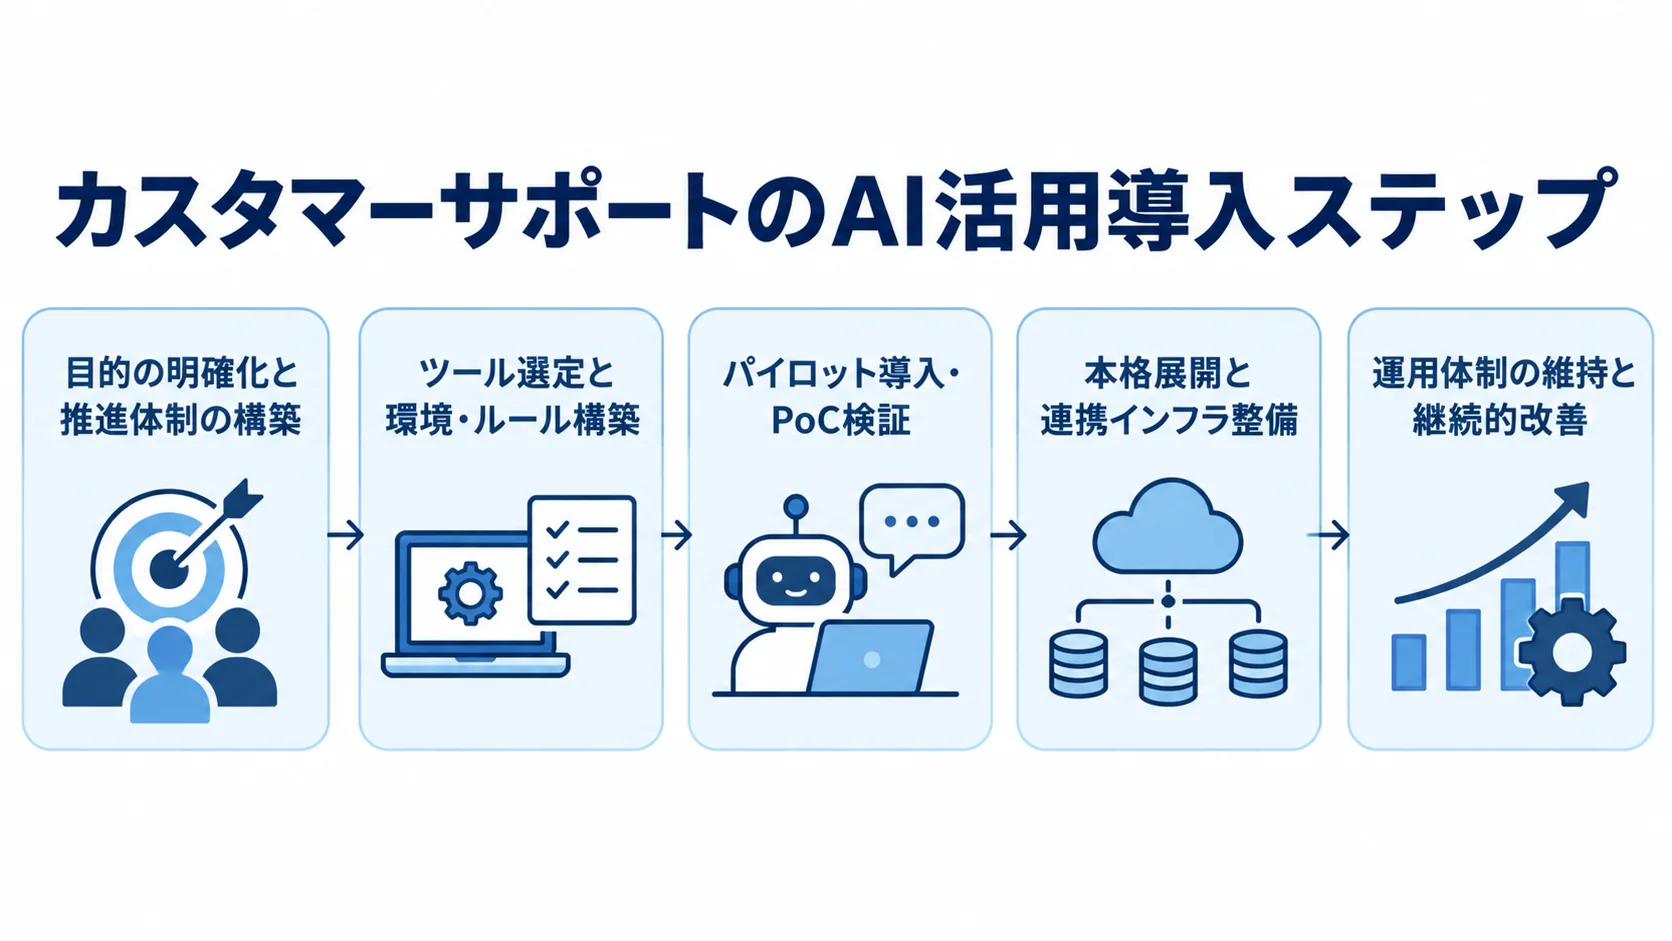
思いつきで始めると、現場に定着せず形骸化するおそれがあります。成功させるには、課題の定量化から始め、段階的な検証と拡張を重ね、継続的な運用体制を確立するまでの5つのステップを順に踏むことが大切です。
5ステップの全体像
カスタマーサポートのAI活用は、目的設定から継続改善まで次の5段階で進めます。各ステップは、前のフェーズの成果を次のフェーズに引き継いで進む連続した取り組みです。
- Step 1: 目的の明確化と推進体制の構築
- Step 2: ツール選定と環境・ルール構築
- Step 3: パイロット導入・PoC検証
- Step 4: 本格展開と連携インフラ整備
- Step 5: 運用体制の維持と継続的改善
各ステップで何をすべきか、どのKPIを設定すべきかを事前に明確にしておくことが、後工程での迷走を防ぐ最大の予防策となります。
導入前の準備度チェック:5つの問い
ステップに入る前に、自社のAI導入準備度を次の5つの問いから確かめておくことをおすすめします。これらを整理しないまま進むと、導入後に現場への定着が進まず、失敗に終わるケースが多く報告されています。
- Q1: チャットボットやAIツールは具体的にどの業務・課題を解決するのか(FAQ数・対象窓口の特定)
- Q2: 参照させるデータ(対話履歴・FAQ・各種規定マニュアル)はAIが読める品質で整備されているか
- Q3: 顧客や社員はどのチャネル(Webサイト・電話・LINE・Slack・Teamsなど)を利用しているか
- Q4: AIの回答精度を継続的にチューニング・更新するための専任運用体制はあるか
- Q5: 成功の定義(KPI:自己解決率・一次対応時間・削減工数など)をどう測定するのか
これらの5つの問いに答えられない項目がある場合は、ツール選定よりも先に、社内の情報整理と体制構築に着手することが優先課題です。
各ステップの具体的な進め方
各ステップで何をどのように進めるかを、実務の観点から詳しく見ていきます。特にStep 1とStep 3は全体の成否を大きく左右するため、十分な時間を取ることが推奨されます。
Step 1 & 2:目的の明確化・ツール選定とルール構築
Step 1では、「AIを使って何かやってみよう」という曖昧な進め方を避けるため、月間の問い合わせ件数や平均対応時間、エスカレーション率などを実データで定量化します。その上で、IT部門・法務・コンプライアンス部門・CS現場リーダーからなる推進チームを作ります。チーム内で役割と権限を明確にすると、後工程での意思決定が速くなります。
Step 2では、入力データがモデルの学習に使われないことを絶対要件として、自社のデータ取扱基準に合ったツールを絞り込みます。選択肢は、手軽に始められるエンタープライズ向けSaaSと、高度なカスタマイズが可能なセキュア構築型(Azure OpenAI Serviceを利用した閉域網環境など)です。どちらを選ぶかは、自社の規模・セキュリティ要件・運用体制に応じて決めます。
ツール選定と並行して、個人情報の入力制限や、ハルシネーションを前提とした人間によるファクトチェック義務などを定めた利用ガイドラインも作ります。
Step 3:パイロット導入・PoC検証の進め方
全社・全顧客への一斉公開は避け、特定の問い合わせカテゴリや一部の限定ユーザーを対象に、スモールスタートで実証実験を行います。たとえば、社内の特定ツールに関するQ&Aや、配送確認など定型的で頻出の問い合わせが対象になります。最初は200件前後のFAQから始め、設定したKPIと照らし合わせながら回答精度を評価するのが一般的です。
現場のオペレーターやパイロットユーザーのフィードバックを取り込み、プロンプトやFAQの内容を調整し続けることが、本番展開後の品質を大きく左右します。特にPoC期間中は、「自己解決率」と「ハルシネーション検知率(人の目による確認)」を重点的にモニタリングします。
Step 4 & 5:本格展開・連携と継続的な改善サイクル
Step 4では、PoCの結果をもとにシステムを本格展開します。重要なのは、AIが対応困難な問い合わせを検知したときに、AIとユーザーのやり取りの履歴(コンテキスト)を保ったまま、有人オペレーターへスムーズにエスカレーションできる「ハイブリッド対応体制」を整備することです。また、既存のCRMシステム(Zendesk等)やコミュニケーションツールとの連携も、この段階で本格的に実装します。
Step 5では、AIを導入して終わりにせず、継続して育てることが最も重要です。AIがうまく回答できなかった「ノーヒットログ(回答不能ログ)」や、ユーザーからの不満アンケートを週次・月次で分析し、新しいFAQの追加、RAG参照ドキュメントの改訂、プロンプトの更新を繰り返します。この改善サイクルが、時間とともに精度が向上する「生きたナレッジ基盤」を生み出す鍵となります。
精度向上と信頼性確保:ハルシネーション対策の実践
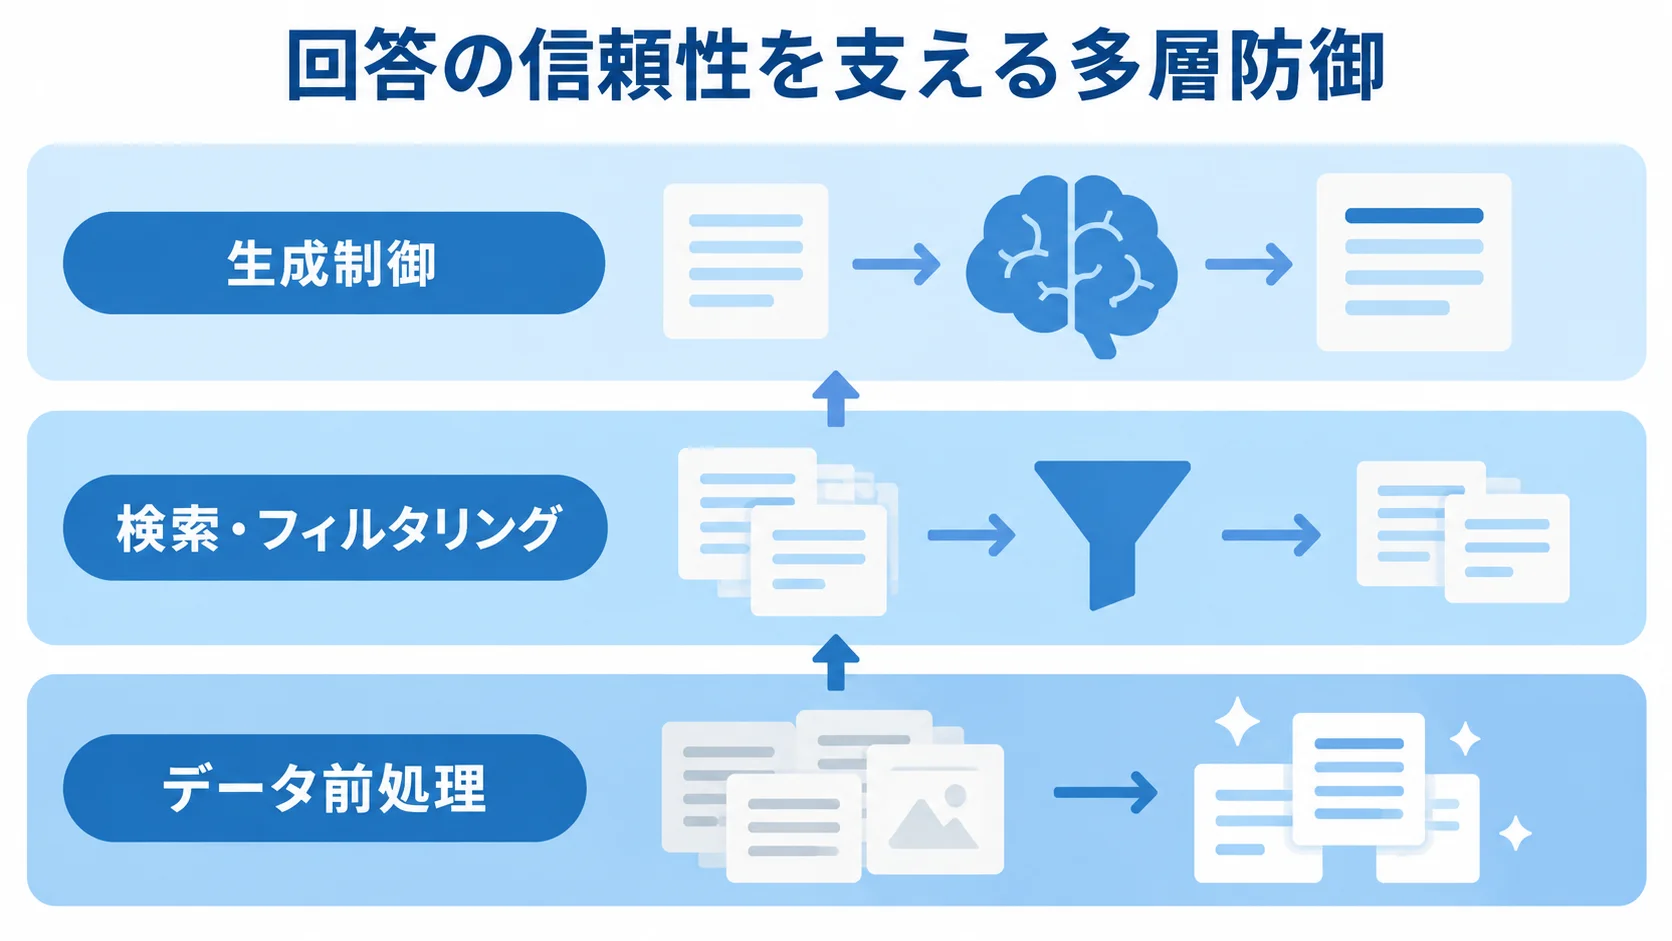
生成AIをカスタマーサポートの実務に適用するうえで、最大の技術的障壁となるのがハルシネーション(もっともらしい誤情報)です。特に金融・保険・行政など、機密性と正確性が強く求められる領域では、誤った回答が深刻なブランド毀損につながりかねません。
現在のベストプラクティスとして、「データ前処理」「検索・フィルタリング」「生成制御」の3フェーズに防壁を設ける「多層防御」が標準的となっています。
RAG精度を決めるデータ前処理の重要性
RAG(検索拡張生成)システムでは、回答精度の大部分がデータ投入前の前処理(下ごしらえ)で決まるとされています。ノイズの多いデータをそのままベクトルデータベースに取り込むと、検索の段階で誤った参考資料がLLMに渡され、精度の低い回答を誘発します。
具体的な前処理として、次の取り組みが挙げられます。
- 意味のまとまり(段落・章)ごとに分割する「セマンティックチャンキング」と、前後のコンテキストが途切れないように重複部分を設ける「オーバーラップ設計」
- 作成年度・対象部署・文書種別のメタデータで検索対象を絞り込む
- スキャンされたPDFや複雑な表組みのExcelをAIが読める形式に変換するAI-OCRやマルチモーダルLLMの活用
プロンプト設計とUI/UXによる多層防御
プロンプトエンジニアリングによるAIの挙動制御も、ハルシネーション対策の中核です。プロンプトに「確信が持てない場合は『分かりません』と答える」という指示を明示的に含めると、推測による誤回答を強く抑えられます。さらに、「回答の際には根拠となった参照ソース(ドキュメント名・URLなど)を必ず併記する」と指示すると、出典不明の情報が回答に混ざりにくくなります。
UI/UX面では、AIが回答を生成した際に、その根拠となった社内マニュアルや公式発表URLへの直接リンクを表示します。あわせて、チャット画面に「AIは誤った情報を出力する可能性があります。重要な意思決定の前には必ず原典をご確認ください」という免責事項を常時表示します。これにより、ハルシネーションを技術的に100%防ぐことが難しい現状でも、ユーザーが自ら検証できる環境を設計で補えます。
ツール・システム選定で押さえるべき評価ポイント
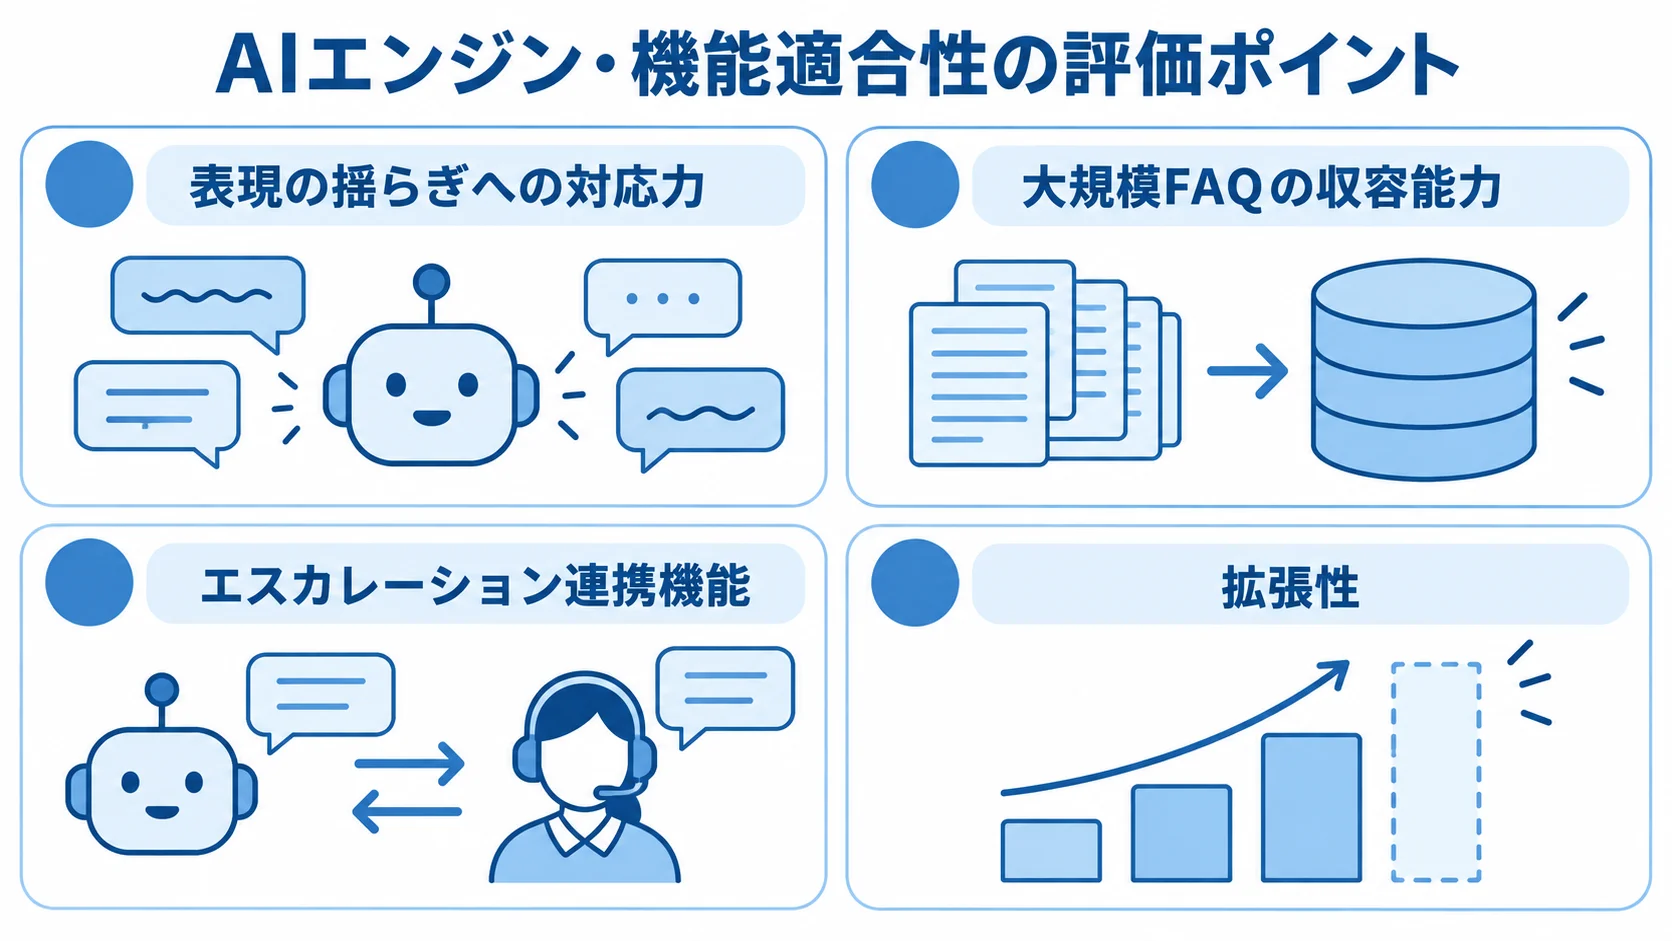
市場には多種多様なAIチャットボットや問い合わせ管理ツールがあります。価格(初期費用・月額費用)だけを基準に選ぶと、AIエンジンの性能が足りず実用に耐えられないという失敗を招きやすくなります。そのため、AIエンジンの機能、ベンダーの信頼性、そしてセキュリティとコストの観点から、総合的に評価することが大切です。
AIエンジン・機能適合性の確認項目
まず確認すべきは、AIエンジン自体の性能です。特に日本語のカスタマーサポートに適用する場合、「表現の揺らぎへの対応力」が最も重要な評価の基準となります。「パワポ」「パワーポイント」「PowerPoint」を同一の言葉として認識できるかどうかは、日本語の理解力をはかる指標として判断しやすい基準です。
また、自社のデータ規模(FAQやマニュアルの量)に耐えられる、大規模FAQの収容能力も確認します。AIが回答困難な案件を、有人オペレーターへスムーズに引き継ぐエスカレーション連携機能も欠かせません。さらに、将来RAGや自律型AIエージェントへ拡張できる設計かどうかという拡張性も、重要なチェックポイントです。
ベンダーの信頼性・セキュリティ・コスト評価
次に、開発会社・ベンダー自体の信頼性を評価します。自社が抱えるカスタマーサポートの課題と似た業種・規模での成功実績があるかを確かめます。事業の安定性(財務状況・事業年数)も確かめます。プロジェクト推進の透明性(定期報告・代替案の提示など)は担保されているかを見ます。
コスト面では、初期費用と月額費用を明文化してもらうことはもちろん、FAQ学習チューニングのたびに追加費用が発生しないかを確認します。さらに、導入によってどの程度の時間・工数が削減されるかを、ROIシミュレーションで詳細に提示してもらえるかも、重要な判断材料となります。初期費用が安くても、運用維持コストが高騰するケースは珍しくありません。
よくある失敗パターンと回避策
カスタマーサポートへのAI導入は多くの企業が取り組んでいますが、思うような成果が出ず、活用が止まってしまう事例も少なくありません。代表的な失敗パターンと回避策を押さえておけば、同じ轍を踏まずに済みます。
失敗1:データ整備の後回し
最も多い失敗は、「ツールを先に契約し、データ整備を後回しにする」ことです。AIチャットボットや生成AIシステムは、参照させるデータの品質によって回答精度が大きく左右されます。ファイル名が整理されておらず、古いバージョンと最新版が混在し、ExcelやPDFの複雑な表も未整理のままです。
そうした状態でシステムを動かしても、実用に耐える回答は返ってきません。回避策は、ツール選定と並行して、データを洗い出し、品質を見直すことです。
既存のFAQリストや手順書・マニュアルを精査し、情報の鮮度・正確性・構造を整えることが先決です。これは時間のかかる地道な作業ですが、ここへの投資が後の精度を決定づけます。
失敗2:導入後の運用体制の不在
「システムを稼働させれば自動的に改善され続ける」という誤解から、専任の運用担当者を置かずに放置してしまうケースも多く見受けられます。AIシステムは、製品・サービスの変更や新しい問い合わせの傾向に応じて、FAQの追加、プロンプトの更新、ノーヒットログの分析などを継続して行わなければ、精度が陳腐化します。
回避策は、導入プロジェクトの初期段階で、誰が週次・月次でログを分析し、FAQを更新するかを決めておくことです。専任担当者の工数を確保しにくい場合は、開発ベンダーと運用保守の範囲を契約に明記し、外部と連携した持続可能な運用体制を設計する方法も有効です。
失敗3:適用範囲の広げすぎ
初期の意気込みから「全問い合わせをAIに対応させる」という目標を掲げ、いきなり広いスコープで展開してしまうパターンです。適用範囲が広いほどデータ整備の負荷も高まり、精度不足のまま本番公開してしまうリスクが上がります。顧客から「AIが使えない」「正しい答えが返ってこない」と評価されると、ブランドイメージへのダメージにもなりかねません。
回避策は、スモールスタートを徹底することです。まずは月間件数が多く、内容が定型化しやすい問い合わせカテゴリを1〜2つに絞り込みます。そのうえで、PoC期間に精度を高め、段階的に対象範囲を広げていくアプローチが、長期的に見て最も早く大きな成果を生みます。
まとめ:カスタマーサポートのAI活用を成功させるための要点
カスタマーサポートへのAI導入は、「5ステップのロードマップ」「ハルシネーションへの多層防御」「スモールスタートと継続改善」の3つで進めることが成功への近道です。ヤマト運輸・アスクル・明治安田生命・LIFULLなど、すでに多くの企業が、一次対応の自動化、オペレーターの工数削減、ナレッジ活用の高度化で成果を上げています。
重要なのは、AIを手段として位置づけ、「顧客と従業員が必要な情報に素早くたどり着ける環境」を実現することです。そのために、データ整備への先行投資、専任運用体制の確保、PoC期間での丁寧な検証という3点を、必ず計画に組み込んでください。
関連知識は、次の全体ガイドで補えます。
まとめに関連する内容は、次の記事で詳しく解説しています。
- ・カスタマーサポートのAI活用に強い開発会社・ベンダー6選|選び方も解説
- ・カスタマーサポートのAI活用事例|チケット対応・ナレッジ・自己解決支援を変える実例
- ・カスタマーサポートのAIによる業務効率化・自動化|成果を出す進め方
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。