
AI故障検知の開発は、データ収集、モデル検証、設備連携の順に進め、全体で6ヶ月〜1年を見込みます。対象の規模と連携範囲によって、期間は変わります。
AI故障検知は、設備の状態に応じて対処する状態基準保全(CBM)・予知保全を実現する技術で、時間基準保全(TBM)や事後保全とは異なります。製造現場では、モーターやポンプ、コンプレッサー、軸受などの生産設備が突然止まると、ライン停止や納期遅延、多額の機会損失につながります。このため、AI故障検知でダウンタイムの削減と保全コストの最適化を同時に狙えます。
▼全体ガイドの記事
・AI故障検知の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI故障検知システムの開発期間の全体像
AI故障検知の開発期間は、全体で6ヶ月〜1年程度が目安です。ただし、期間を左右するのは、設備の台数や種類、センサー数、処理構成、既存システムとの連携範囲です。そのため、対象範囲を先に決めないと、期間の目安を当てはめられません。
標準的な工程では、PoC(概念実証)に2〜3ヶ月、本開発に3〜6ヶ月を見込みます。さらに、現場導入と誤報を抑える微調整に2〜3ヶ月を要します。
単一設備や単一ラインから始めるなら、数ヶ月で最初の成果を出せます。一方で、複数拠点の多数設備と基幹システムを連携する場合は、1年を超えることもあります。
期間の多くを占めるのは、システムの実装だけでなく、設備データを蓄積して要求水準までモデル精度を上げる時間です。
この違いを見ずに、従来の業務システムと同じ感覚で納期を決めると、精度検証の段階で計画が崩れやすくなります。
規模別の開発期間の目安
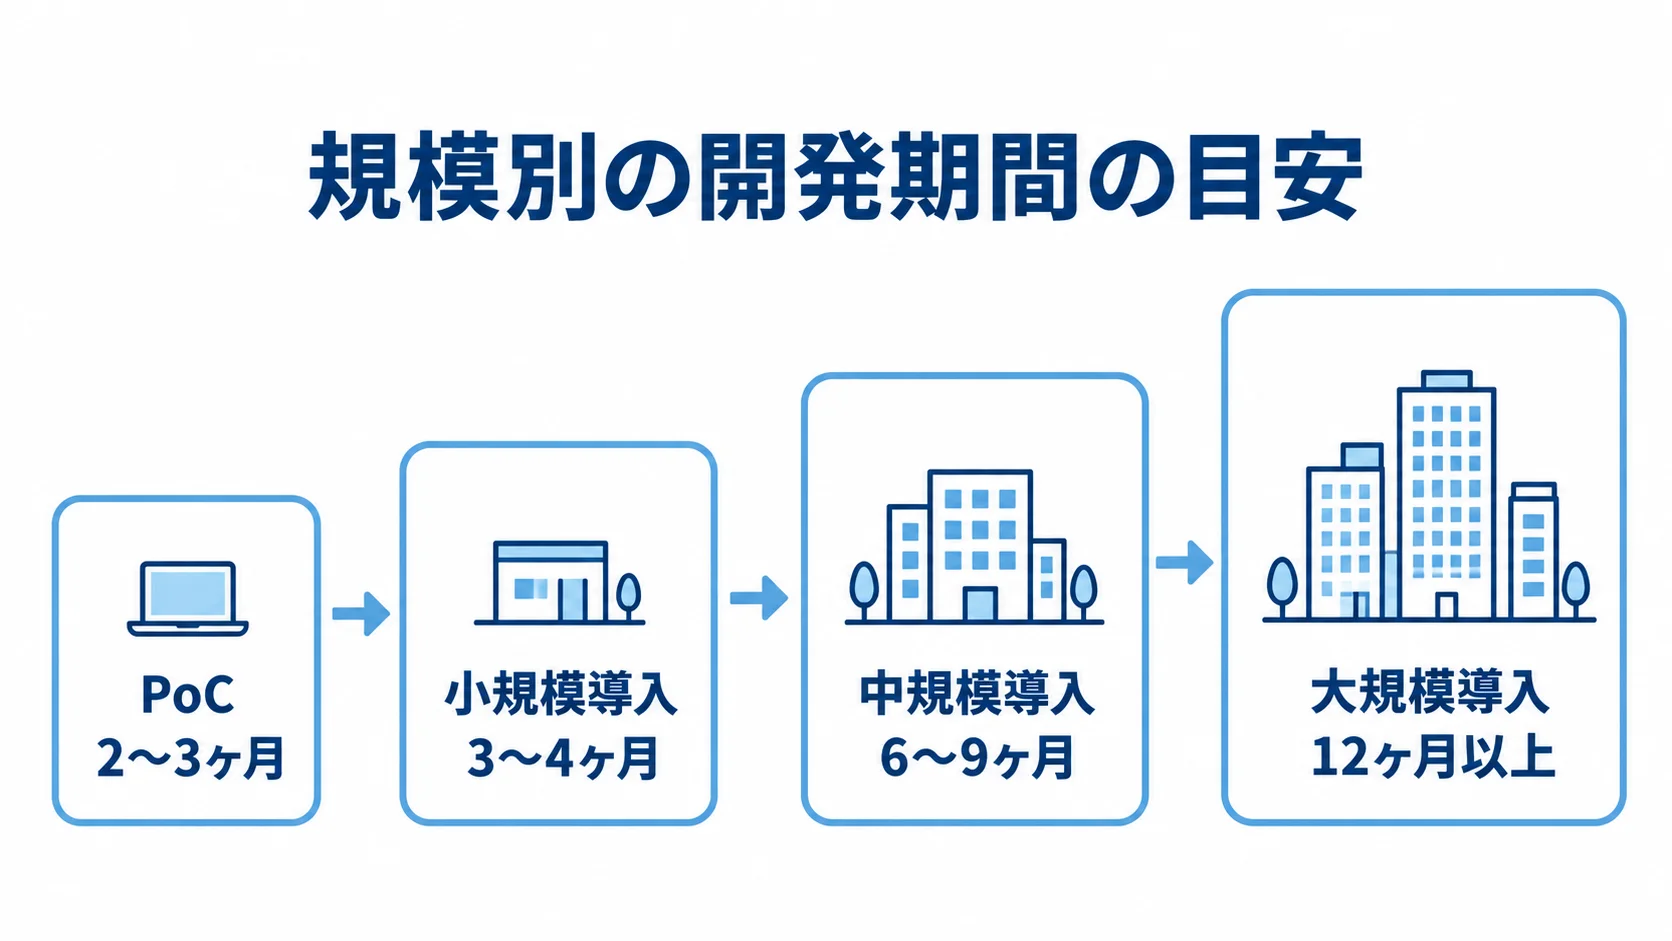
PoCから大規模導入まで、導入の規模が広がるほど必要な期間は長くなります。目安は次の四段階です。
- PoC:一般に2〜3ヶ月
- 小規模導入:3〜4ヶ月
- 中規模導入:6〜9ヶ月
- 大規模導入:12ヶ月以上
PoCでは、1〜数台に振動・温度センサーを付けるか、制御装置から電流・回転数を取得します。そのうえで、正常運転時の状態を学習し、予兆を捉えられるかを検証します。
センサーやデータ収集の仕組みが整っていれば、PoC期間を短縮できます。反対に、機器の選定や設置から始める場合は、ハードウェアの手配で期間が延びます。
小規模導入は、重要度の高い1ラインや数台に絞ります。予兆を検知したら保全担当者に知らせる、レコメンド型の構築が目安です。
中規模では、工場内の複数ラインと設備を対象にします。劣化傾向のダッシュボードやMES・保全管理システムとの連携も含むため、開発やテストが増えます。
大規模では、全社や複数拠点の設備特性とデータ形式を統合します。要件定義とデータ基盤の整備だけで、数ヶ月かかることもあります。
対象範囲ごとの期間を見比べれば、目指す導入段階を絞り込めます。目標とする導入段階を最初に明確にすることが、現実的な計画の出発点です。
一般的なシステム開発との開発期間の違い
業務システムとAI故障検知では、開発期間を左右する要素が異なります。
- 業務システム:仕様が固まれば、期間を見通しやすい
- AI故障検知:データと現場検証の結果で工程が変わる
一般的な業務システムは、入力に対して決められた処理を行います。要件が定まれば、ウォーターフォール型で比較的直線的に進められます。
一方、AI故障検知では、設備が壊れるまでに集まるデータの量や、現場のノイズの中で予兆を安定して捉えられるかが、試すまで分かりません。この不確実性を含みます。
同じ要件でも、対象が回転機械か電気系かで検知精度は変わります。さらに、故障が緩やかな劣化か突発的かによっても、試行錯誤の量が異なります。
モデルの結果は保全記録と照合し、しきい値や特徴量を見直して再学習します。そのため、この反復と再評価を前提に計画を組みます。
故障の発生頻度は低く、正解となる異常データが揃うまで検証に時間がかかります。そのうえ、精度向上と誤報抑制の期間も加わるため、同規模の一般システムより長くなりやすい傾向があります。
要件定義からリリースまでの工程別スケジュール
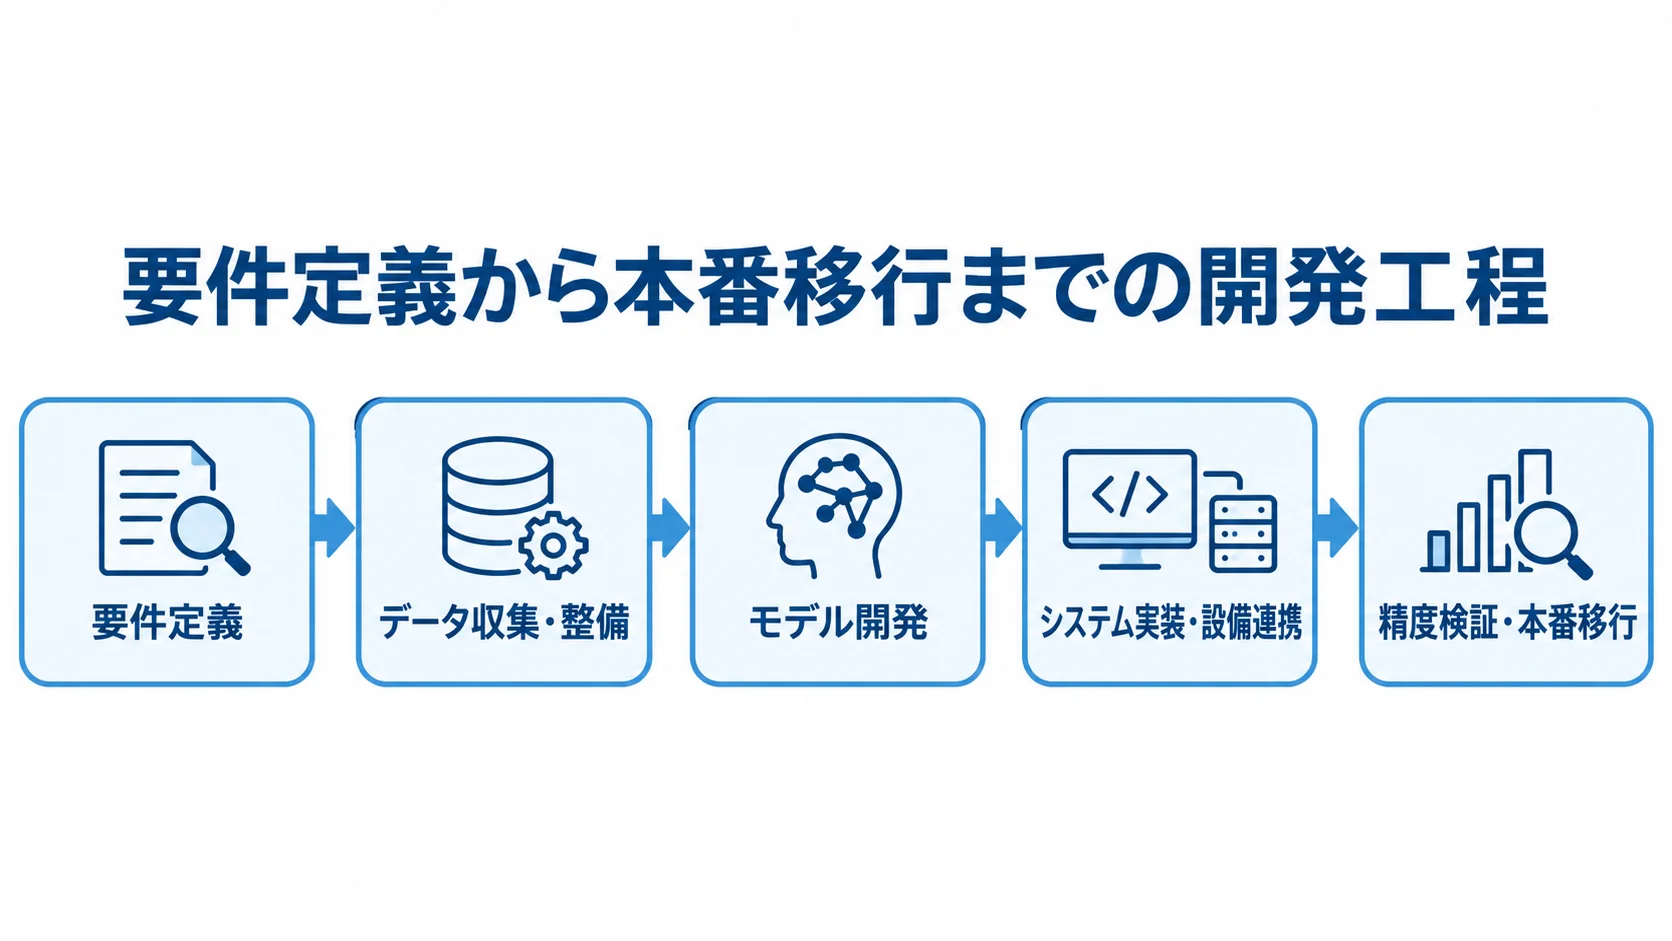
工程は、要件定義から始まります。その後は、データ収集・整備とモデル開発を進めます。続いて、システム実装・設備連携を行います。最後は、精度検証・本番移行で終わります。
中規模の全体期間を6〜9ヶ月とすると、データ収集・整備とモデル開発・検証が6割以上を占めます。従来型の開発と比べると、工数の多くがデータとモデルの側に移ります。
進捗は、画面の完成数よりも、予兆を捉える速さと正確さ、誤報の減少で測るのが適しています。各工程に必要な期間を、それぞれ見積もっておくことが大切です。
フェーズごとの見込み期間は、次の二つの節で示します。
要件定義・センサーデータ収集整備フェーズ
発注側と開発会社は最初に、対象設備と検知したい故障モード、必要な検知時期を決めます。成功基準には、誤報の許容件数も含めます。
- 要件定義:通常2〜4週間
- データ収集・整備:中規模で1.5〜3ヶ月
過去の停止トラブルと被害の大きさをもとに設備を選び、軸受摩耗やモーターの絶縁劣化、潤滑不良といった故障の仕組みを、保全担当者と整理します。
保全計画に合わせて検知時期を決めます。また、誤報が月に何件までなら現場で許容できるかを、数値で定めておきます。
データ収集では、集める周期と期間の設計が要になります。振動や温度、電流に加えて、音響や回転数も対象に含めます。既存の制御盤やPLCから取れるデータは利用し、不足分にはセンサーを設置します。
実用的な精度を出すには、季節や負荷条件の変動を含む正常運転データが要ります。そのため、収集・整備は開発スケジュールを最も左右するフェーズになります。
設備の稼働状況によっては、収集に数ヶ月以上かかることもあります。データがすぐ集まるとは限らないため、収集に十分な期間を確保できるかが、プロジェクトの成否を分けます。
予兆検知モデル開発・実装・精度検証フェーズ
データが整ったあとは、モデル開発、システム実装、現場での精度検証を順に進めます。
- モデル開発・調整:中規模で1.5〜2.5ヶ月
- 精度検証:本番前に1〜2ヶ月を確保
故障データは十分に集まりにくいため、実務では正常運転時のデータで学ぶ教師なし学習が定石になります。
正常な状態から外れたものを異常と捉えます。その手法には、オートエンコーダやマハラノビス距離、One-Class SVMなどがあります。
振動波形では、周波数分析(FFT)で成分を取り出します。一方、温度や電流では移動平均や変化率を特徴量にするなど、設備の物理特性に合う手法を選びます。
精度が要求水準に届かなければ、特徴量の追加やデータ期間の見直しに戻ることになります。そのため、開発・調整の期間には幅を持たせておきます。
モデル開発と並行して、劣化傾向のダッシュボードや、しきい値超過時のアラート、保全担当者への通知を実装します。また、設備・PLCやMESとの連携も進めます。
過去の故障データがあれば、予兆をどれだけ前に捉えられたかを検証します。さらに、実運用データで一定期間のシャドー運用を行い、誤報と見逃しのバランスを確認します。
現場の温度変化や他設備の振動は、誤報の原因になります。検証を省いて急いでリリースすると、アラートが「オオカミ少年」化するおそれがあります。
そうなると現場の信頼を失い、結局は使われなくなります。
故障検知特有でスケジュールに影響する工程
一般的なAIシステムと比べると、故障検知には異常データが集まりにくいことと、物理的なセンサーや設備を扱う難しさがあります。どちらも工程や期間に影響します。
文書分類や需要予測では、大量の正解データを前提にできます。一方で、故障は予防したい対象で発生頻度が低く、異常サンプルが極端に少ないため、同じ前提は置けません。
現場にセンサーを設置し、安定してデータを集める必要があります。そのため、ソフトウェアの開発だけでは完結しません。
特に期間が読みにくいのは、次の二つの論点です。
異常データ不足とセンサー設置・エッジ/クラウド構成
異常データの不足への対応と、処理構成の選び方が、期間に影響します。
- データ不足への対応:過去記録や同型設備のデータを活用
- クラウド構成:既存センサーやPLCのデータを集約
- エッジ構成:設備近くでリアルタイムに処理
学習したい故障状態のデータは、設備が壊れない限り集まりません。このため、AI故障検知の精度づくりが難しくなります。
具体的には、正常データだけで学ぶ方法のほか、過去のトラブル記録や同型設備の別号機のデータも使えます。
故障を模した試験で負荷をかけ、意図的に劣化状態を作る方法もあります。その場合は、試験の計画と実施に期間が追加で必要になります。
既存センサーやPLCのデータをクラウドに集約する構成は、立ち上げが比較的早く進みます。一方で、高速サンプリングが必要な振動波形を設備側で判定する場合は、エッジ構成が必要です。
エッジ構成では、デバイスの選定と調達に加えて、設置や配線、通信の確立が必要になります。特に、部材の調達期間によっては、全体の計画を遅らせる要因になります。
センサーの種類や設置箇所を誤ると、狙った予兆が信号に現れず、設置のやり直しが発生します。そのため、初期検証で適切な種類と位置を確かめておくことが、後工程を安定させます。
既存設備・MES/SCADA連携と現場運用への組み込み
AI故障検知は、予兆を保全計画や部品交換につなげて初めて価値を生みます。連携にかかる期間は、既存システムの新しさと、インターフェースの整備状況に左右されます。
- 新しい設備:標準通信対応なら取得まで数週間
- 古い設備:連携設計・開発・テストに1〜2ヶ月の場合も
連携先には、設備を制御・監視するSCADAやPLCがあります。このほか、生産管理のMESや、保全管理のCMMS(設備保全管理システム)もあります。
標準通信プロトコルのOPC UAなどに対応した比較的新しい設備では、データ取得の準備が早く整います。一方で、古い設備は取り出し口がなく、センサーや変換ゲートウェイが必要な場合があります。
アラートを誰が確認し、どの基準で点検や部品発注を決めるかを、運用設計で定めます。夜間や休日の対応も含めて、保全部門と運用フローをすり合わせます。
運用設計を後回しにすると、完成したシステムが使われないおそれがあります。そのため、初期の段階から保全担当者や設備管理者を巻き込み、連携仕様と運用ルールを確かめておきます。
納期遅延の典型要因と対策
AI故障検知は、当初の予定を超えやすい傾向がはっきりしています。
遅れの主な原因は、集めたデータが想定どおりでないことと、誤報を現場が納得する水準まで抑えるための試行錯誤です。実装そのものの遅れよりも、予知保全特有のこの二点が影響します。
この二点を事前に計画へ織り込めば、スケジュールの精度を高められます。特に、精度と発注側の準備が鍵になります。
誤報多発・精度未達による手戻り
現場で誤報が多発すると、精度調整の手戻りが起きます。検証環境で精度が高くても、工場で同じ結果になるとは限りません。
- 周辺環境:隣接設備の振動、季節による温度変化
- 運転条件:電気ノイズ、品目切り替えによる状態変化
こうした誤報は、本番に近い環境で初めて表に出ることが多く、想定より調整が長引く典型的な例です。
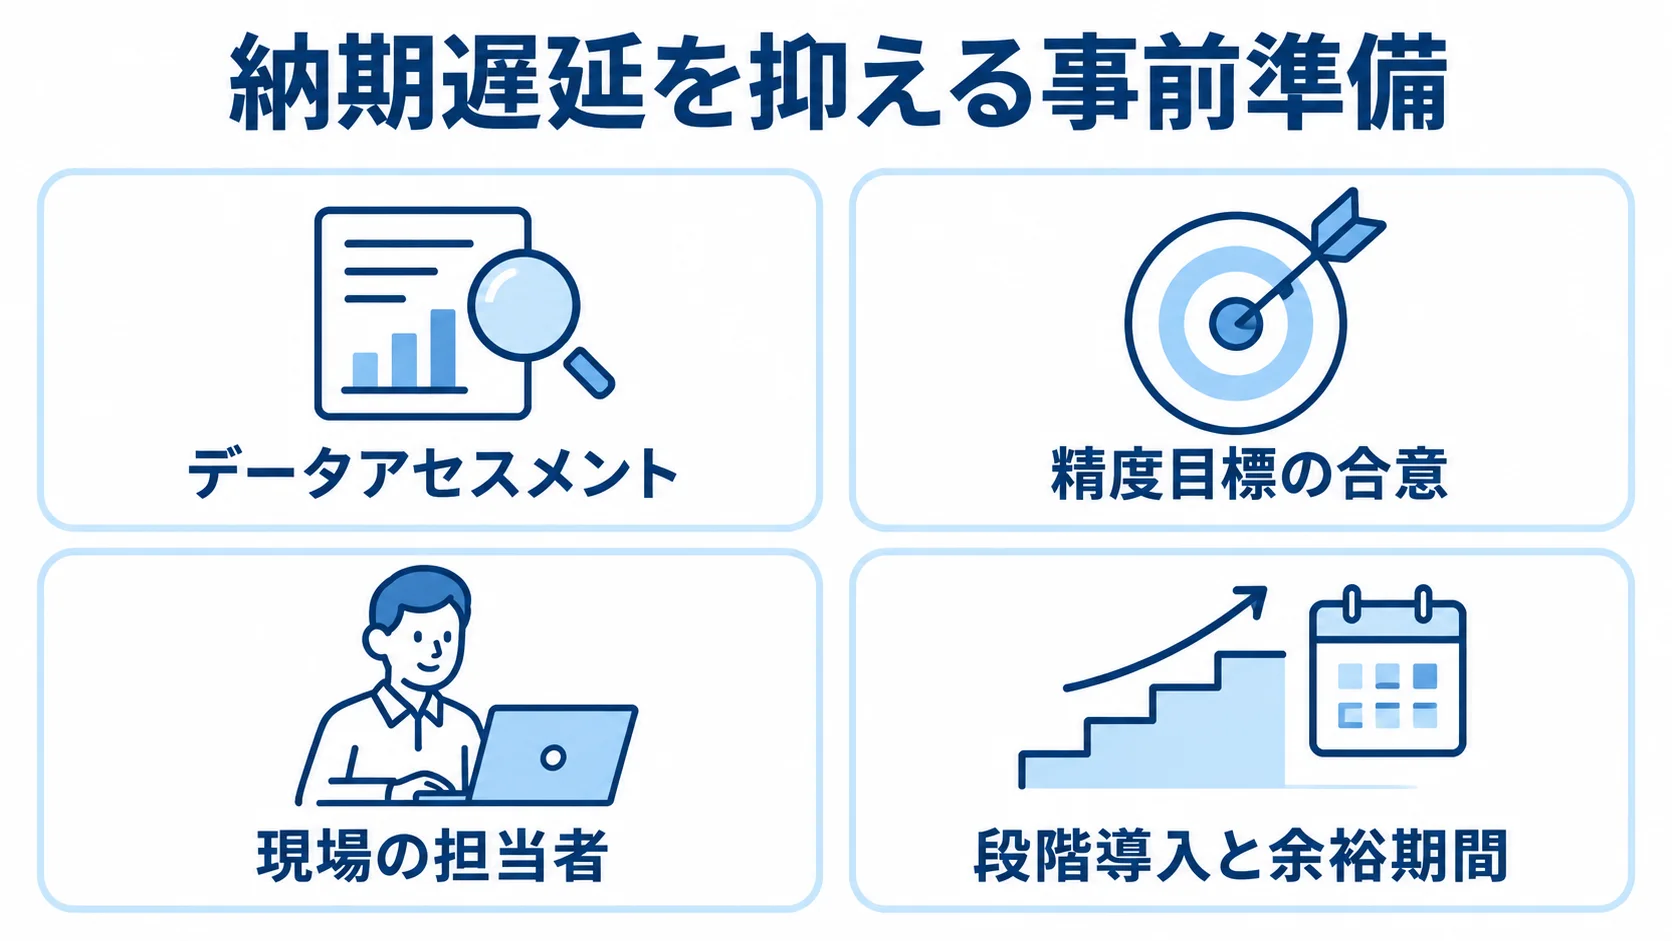
契約・計画の前段階で1〜2週間のデータアセスメントを行い、データの有無と品質を調べます。
故障事例が残っているか、狙う予兆が信号に現れるかを確かめ、その結果をもとに日程を組みます。
精度が目標に届かない場合の方針も、最初に合意しておきます。すべての故障を100%捉えようとすると、調整が終わらなくなるためです。
被害の大きい設備から適用し、見逃し回避と誤報削減のどちらを優先するかを決めます。また、しきい値を運用中に調整する計画を組めば、精度追求による遅延を防げます。
現実的なスケジュールを引くための発注側の準備
納期は、開発会社の力量だけでなく、発注側の準備と体制にも左右されます。保全の知識がなければ、精度と実用性を高めにくいためです。
- 担当者:データ窓口と現場のキーパーソンを決める
- 進め方:PoCから段階的に広げ、工場全体から始めない
- 余裕期間:全体の15〜20%程度を確保する
過去の故障や、異音・振動が出る状態、季節ごとの負荷は、データだけでは読み取れません。そのため、こうした現場の暗黙知を開発チームに伝える担当者が必要になります。
稼働データや故障・保全履歴の提供窓口、現場を説明できる人を、初期の段階で決めておきます。担当者の有無は、モデル精度と検証速度に影響します。
最初から工場全体を対象にせず、重要度の高い1台で始めるのが得策です。予兆と効果を確かめてから本番への投資を判断すれば、大きな手戻りを抑えられます。
余裕期間は、特にデータ蓄積、センサー設置、精度検証に配分します。発注側の準備が整えば、予定に沿って進みやすくなります。
パートナー選定では、技術力に加えて、現場を巻き込んだ進め方や段階導入を提案できるかも評価します。
まとめ
ここまで、設備・機器のAI故障検知の開発期間と納期を整理してきました。規模ごとの目安と工程ごとの配分に加えて、遅延の要因と対策まで扱っています。
AI故障検知の期間は、全体で6ヶ月〜1年が目安です。内訳としては、PoCに2〜3ヶ月、本開発に3〜6ヶ月、現場導入と微調整に2〜3ヶ月を見込みます。
データ収集・整備とモデル開発・検証が、全体の6割以上を占めます。一般的な業務システムより期間が延びる要因は、異常データの不足と、現場の誤報対策です。
計画では、データ蓄積とセンサー設置、現実的な精度目標を中心に置きます。加えて、エッジ・クラウド構成や、MES・SCADAを含む既存設備との連携、現場運用も期間を左右します。
遅延を防ぐには、契約前のデータアセスメントを行い、段階的に導入するのが有効です。保全のキーパーソンを確保し、全体の15〜20%程度の余裕期間を設けておくと、計画が現実的になります。
▼全体ガイドの記事
・AI故障検知の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。