
在庫管理へのAI導入は、課題の整理とKPIの設定から始めて、AI活用領域の選定とデータ整備、PoC(概念実証)、本格導入、運用定着の順に段階を踏んで進めます。
属人化した発注判断や、膨大なSKU数に対する手作業での在庫チェックは、担当者の負担を増やすだけでなく、予測精度のばらつきも招いてきました。
在庫管理のAI活用の全体像は、次の完全ガイドで体系的に解説しています。
・在庫管理のAI活用 完全ガイド|進め方・事例・効率化まで体系的に解説をご覧ください。
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
在庫管理でAI活用が注目される背景
グローバルサプライチェーンが複雑になるなか、需要の変動にどれだけ速く対応できるかが、企業の競争力を左右するようになっています。
従来の在庫管理システムは、「現時点の実在庫数を正確に記録する」リアクティブな管理にとどまっていました。そのため、急激な需給変動や予期せぬ物流トラブルに、先回りして対応するのは困難でした。
そこで、AIを使うと静的な管理モデルから転換できます。
転換先は、「未来の需要を確率的に予測し、能動的な最適化アクションを自動実行する」プロアクティブな意思決定モデルです。
従来の在庫管理が抱える構造的課題
多くの企業が在庫管理で直面する課題には、次のようなものがあります。
- 予測精度:欠品と過剰在庫が並存する状態
- 発注とデータ:属人化とシステム間の不整合
まず、過去の販売実績から予測すると、天候・イベント・競合動向といった外部要因を反映できません。
次に挙げられるのが、発注業務の属人化です。担当者の経験と勘に頼った発注は、人員交代や繁忙期に精度が落ちやすく、業務が属人化するほど引き継ぎコストも高くなります。
最後に、在庫データの分散と不整合があります。基幹システム・倉庫管理システム・販売管理システムのデータが連携されておらず、在庫をリアルタイムで把握しにくくなっています。
AIがもたらす在庫管理の変革とビジネス価値
AI需要予測がもたらす価値は、発注業務の省力化を超えて広がります。たとえば、高精度な需要予測があれば、財務リスクの低減にも貢献します。
- 調達計画:為替変動を織り込んだ計画づくり
- 人員配置:シフト管理との連動
需要予測のデータを、シフト管理による人員配置の見直しに生かす組織も増えています。
アルバイト・パートスタッフの無駄な残業や人員の過不足を防ぎ、業務効率化と人件費の最適化を同時に達成できます。
欠品リスクが下がれば顧客満足度の向上に直結し、過剰在庫を減らせば運転資本の改善とキャッシュフローの強化につながります。
近年は、AIエンジニアやデータサイエンティストがいない組織でも使えるノーコードAIツールが増えています。
データソースを接続するだけで、最短2週間程度で需要予測や在庫最適化の運用を始められ、段階的な実証実験を進めることもできます。
日本の公的支援スキームも追い風です。たとえば、「IT導入補助金」や「ものづくり補助金」を使えば、中小企業でも初期投資の負担を抑えてDX推進に着手できます。
在庫管理へのAI活用 導入の全体ステップ
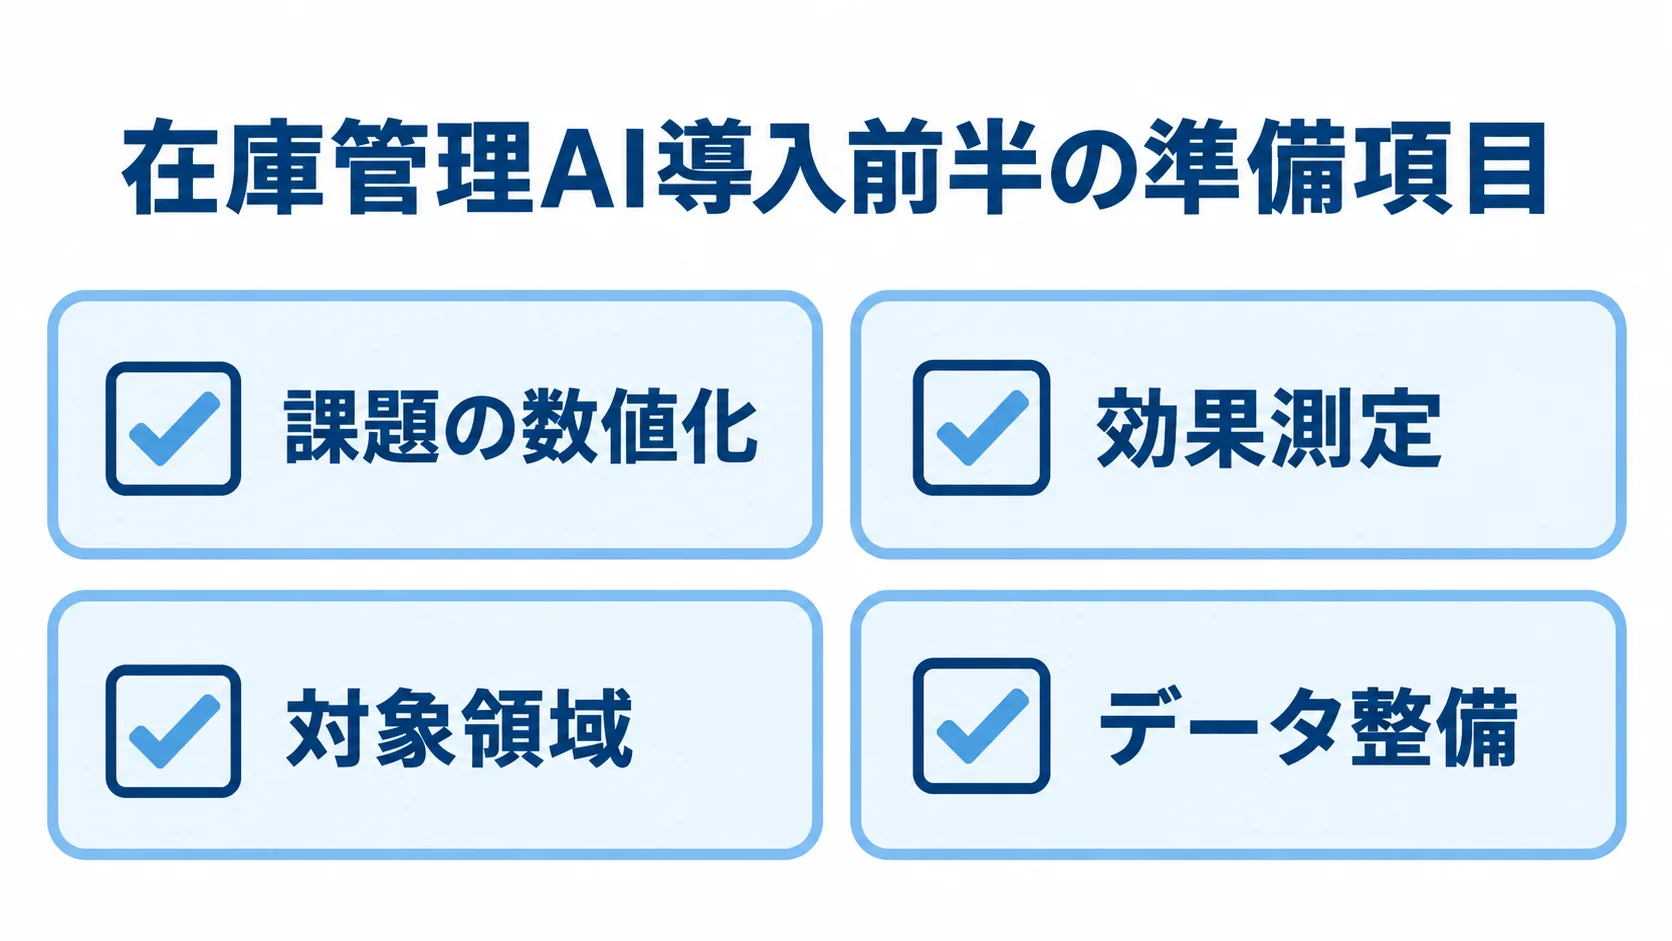
在庫管理へのAI導入は、「課題整理」から「運用定着」まで段階を踏んで進めます。
各段階を丁寧に進めると、PoC(概念実証)止まりを防ぎ、現場で使われ続けるシステムに育てられます。
STEP1:課題整理とKPIの数値設定
まず、現状の在庫管理の課題を数値で把握します。
- 課題の数値化:現状を比較できる数字
- 効果測定:PoCの成果を評価するための指標
たとえば、「欠品による機会損失額はいくらか」「在庫回転率は業界平均と比べてどうか」という問いに、数字で答えられるようにします。あわせて、「発注業務に1人あたり何時間かかっているか」をKPIに含めておけば、AI導入後の効果を測れます。
課題整理の段階では、対象とするSKUを絞り込むことと、保有データの欠損状況を確認することを並行して進めます。
在庫回転率(年間売上原価 ÷ 平均在庫金額)は、資金効率と在庫の滞留度を示す基本的な財務指標です。この数値を業界標準と比べると、自社の在庫管理にどれだけ改善の余地があるかを客観的に把握できます。
KPIが明確であれば、PoCの成果を評価できます。経営層に投資対効果(ROI)を説明するときも、その数値が手がかりになります。
STEP2:AI活用領域の選定とデータ整備
課題が見えたら、次にAIを適用する業務領域を選びます。
- 対象領域:需要予測や在庫配置の優先順位
- データ整備:表記揺れ、重複、欠損値の洗い出し
在庫管理でAIを使う主な領域は、需要予測・自動発注と在庫配置の最適化です。ほかにも、棚卸を自動化する領域や、倉庫内のピッキングを支援する領域などがあります。
最初から全領域を対象にすると、データ整備やシステム連携の負荷が大きくなります。そのため、効果が出やすい特定のカテゴリや拠点から始めることをお勧めします。
データ整備は、AI導入プロジェクトで最もつまずきやすい工程です。マスターデータの表記揺れ(「株式会社」と「(株)」など)、重複レコード、欠損値の処理は、予測モデルの精度に直接影響します。
データの正確性や一貫性を確かめ、AIが学習できる形に整える作業は、ベンダーと協力して進めます。網羅性や非バイアス性もあわせて確かめます。
優れたパートナーは、「この項目データは欠損が多く、このままではAIの精度が落ちる」といった、データの限界を率直に伝えてくれます。
PoC(概念実証)の進め方と評価ポイント
AI在庫管理の導入では、本格展開の前にPoC(概念実証)を行い、自社データで予測精度と業務効果を確かめます。PoCの範囲を絞り、評価基準を事前に決めておけば、本番導入に向けた判断をスムーズに進められます。
PoCのスコープ設定とベンダー評価
PoCは、特定のカテゴリや地域デポに絞ってスモールスタートするのが原則です。
- 検証範囲:PoCで扱う商品と拠点の広さ
- ベンダー:本稼働までの支援体制
たとえば、「売上上位20%のABC品目に絞って需要予測モデルを構築し、3か月間の予測精度を現行方式と比べる」といった形で、対象を限定します。
モデルの検証では、まず過去データのうち「2か月前までの売上実績データ」でAIを学習させます。そのうえで、直近1か月の実績をテスト用の未知データとして流し込む「バックテスト手法」が一般的です。この手法を使うと、未知の市場変動に対する予測の頑健さ(ロバスト性)を、本番の前に評価できます。
ベンダーを評価する際は、デモ環境でしか動かない「PoC止まり」かどうかを見極めます。
具体的には、本番の現場で従業員が使いこなすまで保守・改善に関われるか、PoCから本稼働まで一貫して支援する体制があるかを確かめます。
稼働時間で働く準委任契約と、完成した成果に責任を負う請負契約を、フェーズに応じて使い分けられるかも、ベンダー選定の材料になります。
需要予測アルゴリズムの選定と検証
需要予測では、AIが対象商品の特性に合わせて、異なるアルゴリズムを選んだり組み合わせたりします。季節変動のある商品には、ARIMAモデルやホルト・ウィンターズ法などの時系列分析が適しています。
- 時系列分析:過去の推移から需要を読む手法
- 機械学習:外部要因を組み込んだ予測
天候やイベント、競合動向といった外部要因を取り込むなら、ランダムフォレストやXGBoost・LightGBMといった機械学習モデルが有効です。
数千種類に及ぶロングテール商品では、需要パターンが複雑になります。そのため、LSTMやGRUといったディープラーニングモデルが使われることもあります。
PoC段階では、複数のアルゴリズムを並行して試し、自社商品の特性と保有データ量に最も合うモデルを選ぶことをお勧めします。
アルゴリズムの選択より、学習データの質と量が予測精度に与える影響が大きいケースが多くあります。そのため、データ整備への投資対効果も意識しておきたいところです。
本格導入:基幹システムとの統合と自動発注の実装
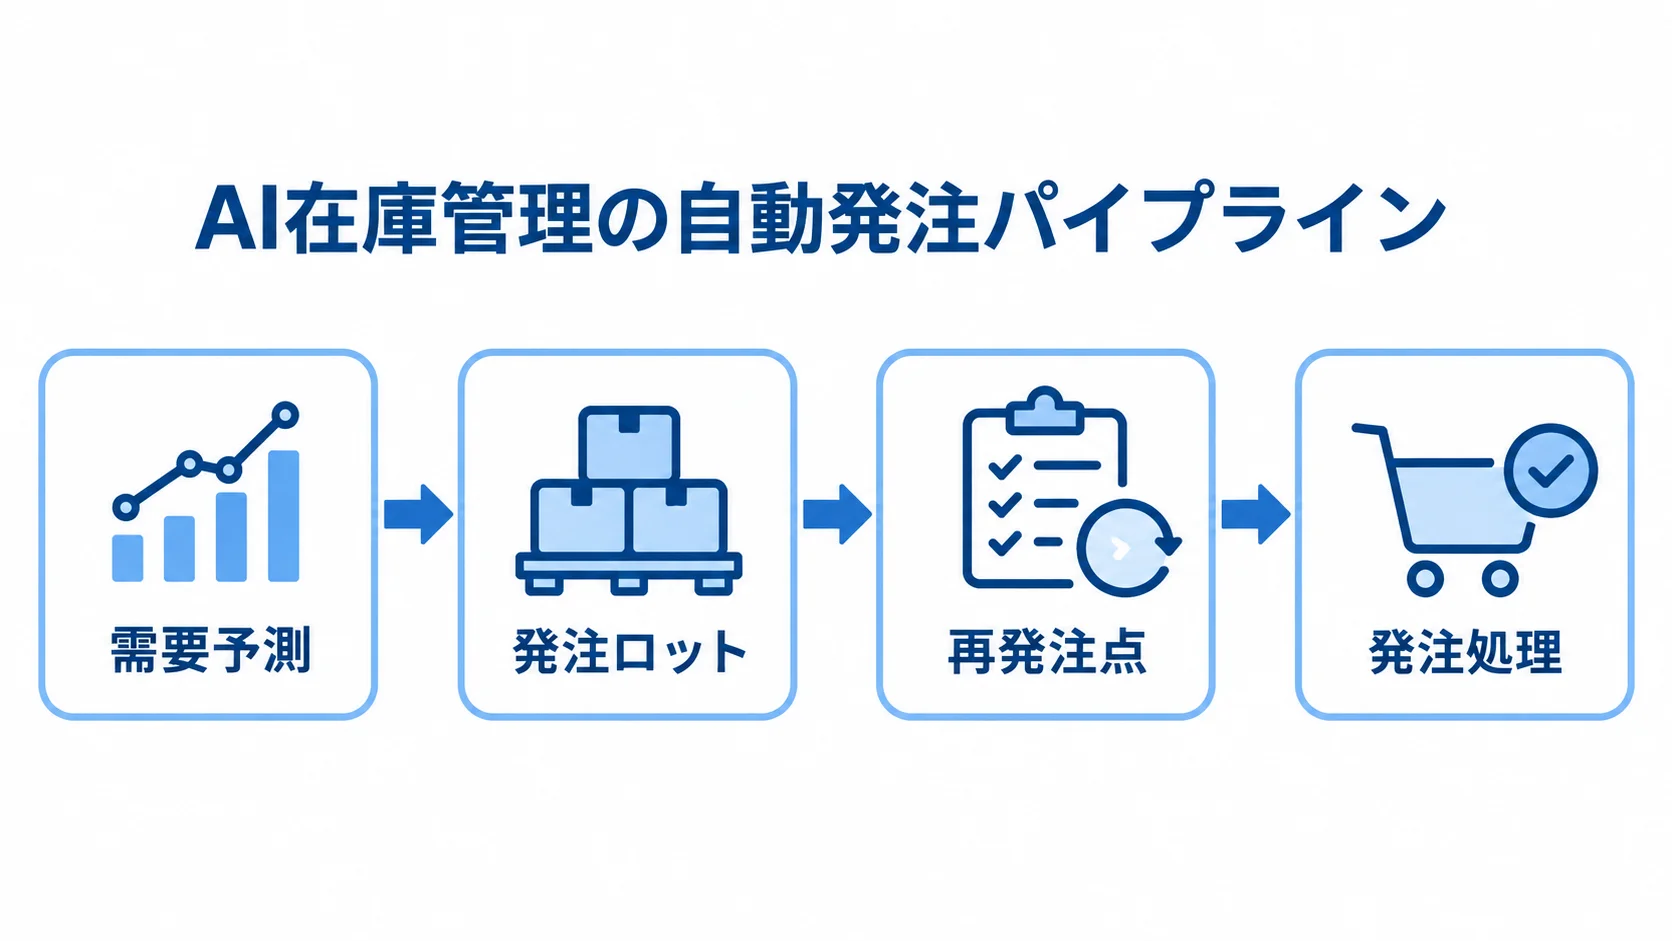
PoCで効果が確認できたら、ERP・WMSとのシステム統合と、自動発注パイプラインの実装に進みます。
稼働形態(オンプレミス・パッケージ・クラウド)の選択は、コストやセキュリティ、既存システムとの統合性から慎重に見極める必要があります。
システム稼働形態の選択基準
オンプレミス型は、独自のセキュリティ要件を持つ企業や、高度なデータ分析基盤が必要な場合に適しています。一方で、初期投資とサーバーの維持コストが大きく、開発期間も長くなりやすい傾向があります。
クラウド型(SaaS)は、初期費用を抑えられ、最新の需要予測アルゴリズムの更新も迅速に反映されます。ただし、機密データを外部ネットワークへ送るため、企業のガバナンス要件と合っているかを確かめる必要があります。
パッケージ型は、標準的な業務プロセスに合いやすいものの、自社固有の複雑な物流ルートや賞味期限管理などへの高度なカスタマイズには制約が出る場合があります。
自動発注・補充パイプラインの実装
AI在庫管理システムの核心は、需要予測から発注処理まで自律的に回る仕組みにあります。
- 発注ロット:需要予測から算出する発注量
- 再発注点:発注を出す基準となる在庫量
予測された需要量は、経済的発注量(EOQ)モデルに基づいて発注ロットを動的に算出する処理へつながります。そして、実在庫が基準を下回ると自動で発注処理へ移る再発注点(ROP)モデルが、自動発注・補充機能の数理的な基盤です。
ERP・WMSとAPIでパイプラインをつなぐと、人手を介さずに在庫と発注が自律的に更新される環境が整います。
ある大手コンビニエンスストアチェーンは、全国数万店舗へAI発注システムを展開しています。これにより、1店舗1日あたりの発注作業時間が大幅に短縮され、さらに食品廃棄の削減と欠品率の適正化も実現しています。
日清製粉ウェルナは、冷凍食品約400品目の需給管理を自動化するシステムを2024年10月に本格稼働させました。需給計画の策定時間は3日から1日へ短縮され、月間約50時間の業務削減効果も出ています。こうした先行事例は、自動発注パイプラインが現場の業務負担を大きく軽減することを示しています。
運用定着とMLOpsによる精度維持
AI在庫管理システムは、稼働後に運用を定着させ、精度を保ち続けなければ、導入効果が徐々に下がってしまいます。
市場トレンドや季節の変化に合わせてモデルを維持・改善するMLOps(機械学習の運用管理)の仕組みは、本番稼働と同時に設計しておく必要があります。
精度ドリフトの監視と再学習の仕組み
市場トレンドや季節変動によって、AIモデルの予測精度は時間の経過とともに低下(精度ドリフト)することがあります。
精度の劣化をリアルタイムで検知し、定期的な再学習(メンテナンス)を自律的に行う体制(MLOps)を整えておくことが、長期的な投資対効果を保つうえで欠かせません。
特定のシーズンや外部要因で需要が急に動いたとき、人間が手動で補正できるインターフェースを設けておくと、システムの実用性が高まります。
人間とAIの協調設計による現場定着
AI在庫管理を現場に定着させるには、人間とAIの協調設計が有効です。AIが数理的な予測と自動補充計画を示し、そこに現場の人間が持つ突発的・局所的な例外状況への対応力を組み合わせます。
- AIの役割:定型業務の予測と補充
- 人間の役割:例外への対応と最終判断
AIに大量の定型業務を任せれば、人間のプランナーや店舗担当者は深夜の発注作業から解放されます。そのぶん、顧客接客や複雑な調達交渉といった高付加価値の業務に時間を割けます。AI活用の先行事例も、この考え方を一貫して示しています。
サントリー食品インターナショナルは、「人間とAIの協働」を前提にしたシステム設計を採用しています。AIが将来の市場変動に対して複数の生産・在庫シナリオを提示します。そのうえで、人間のプランナーが、原材料の調達リードタイムや突発的な物流障害といった外的要因を加味して最終決定します。
人間とAIの協働を前提にした設計思想が、現場への定着とシステムの継続的な改善を支えています。
よくある失敗パターンと回避策
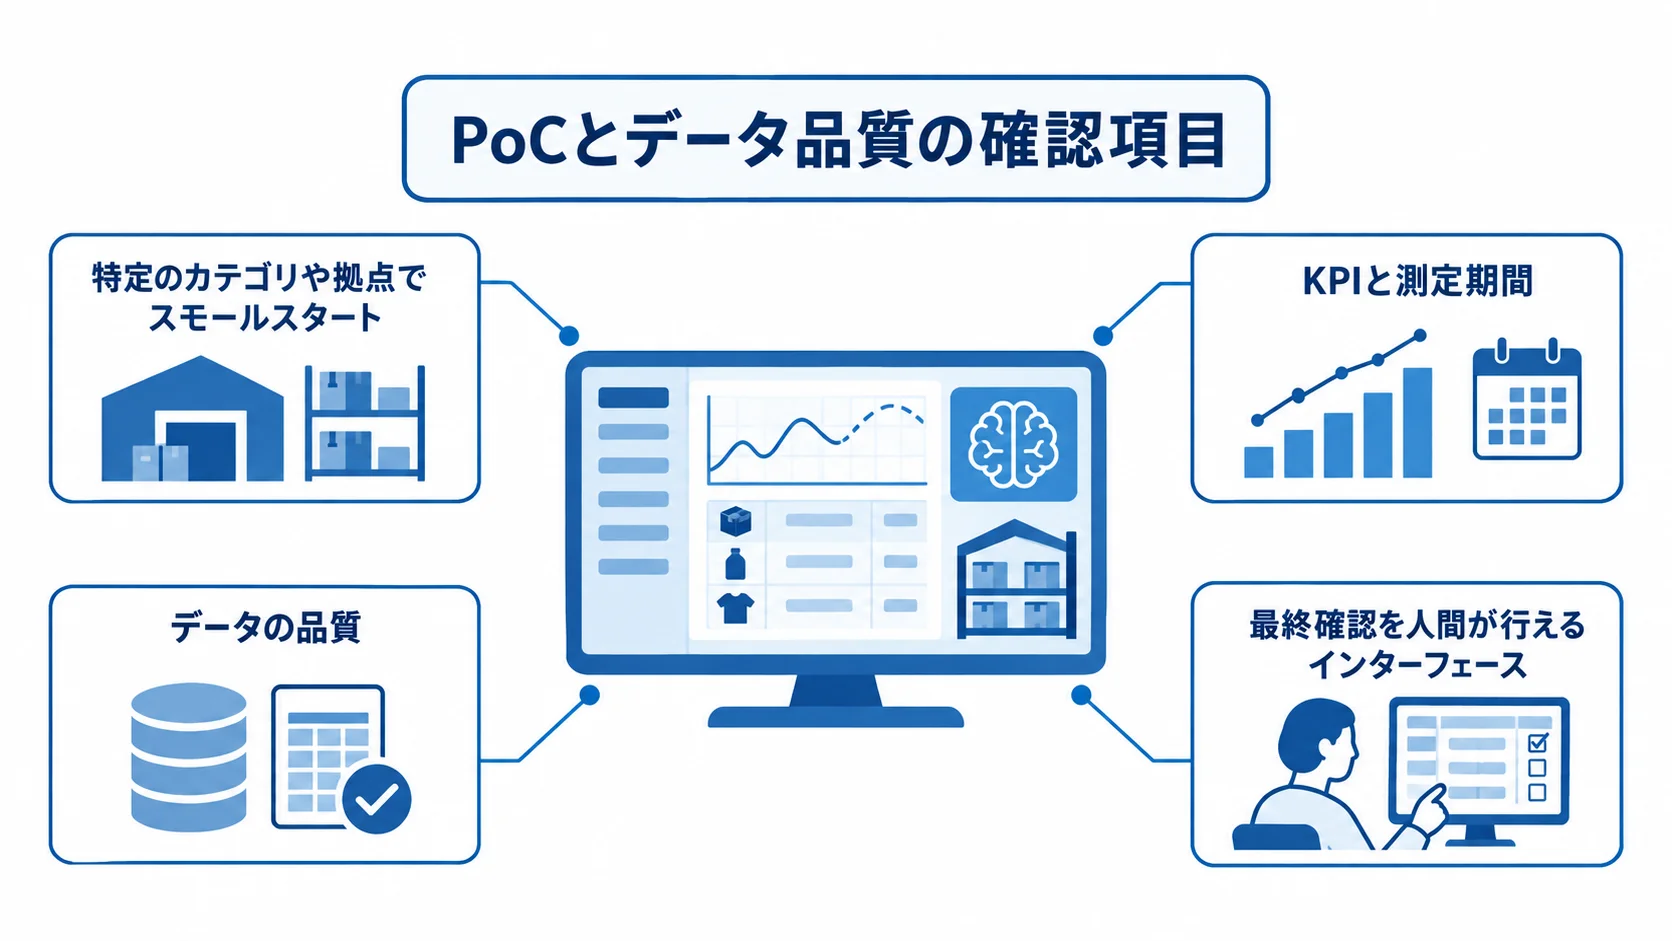
在庫管理へのAI導入には、陥りがちな失敗パターンがいくつかあります。これらを事前に把握し、具体的な回避策を準備しておけば、プロジェクトの成功確率を高められます。
失敗パターン1:PoC止まり
PoC止まりの最大の原因は、スコープが広すぎることか、評価基準が曖昧なことです。
- 検証範囲:対象を広げすぎないこと
- 評価基準:PoCの成果を事前に定めた指標
PoC段階で「全SKU対象」「全拠点同時」といった大きなスコープを組むと、データ整備とシステム連携の負荷が過大になります。その結果、プロジェクトが停滞しやすくなります。
回避策としては、まず効果が出やすい特定のカテゴリや拠点でスモールスタートし、成功事例を積み上げながら、展開範囲を段階的に広げる方法が有効です。また、評価基準となるKPIと測定期間は、事前に関係者で合意しておきます。
失敗パターン2:データ品質の過信と現場の抵抗
「データはある」と考えていても、AIが実際に使える品質のデータが揃っていないケースは少なくありません。
- 入力データ:品質の確認が必要な元データ
- 現場:担当者が抱く運用上の懸念
売上データの欠損、マスターの表記揺れ、特定シーズンへのデータの偏りは、予測精度を大きく下げます。そのため、導入初期にデータを十分に確認し、整備にかかるコストと期間を見積もっておきます。
また、現場の担当者が「AIに発注を任せると、責任はどうなるのか」と不安に感じることも少なくありません。そこで、最終確認を人間が行えるインターフェースを設計し、業務を段階的に移す計画もあわせて準備します。これにより、現場の受け入れを高められます。
ベンダー選びでは、「AIですべての不確実性が解決できる」といった過大な提案を鵜呑みにしないよう気をつけます。
Excelや従来のシステムの仕組みと組み合わせた補完型のモデルを示せるベンダーこそ、実務に定着する在庫最適化を支えるパートナーと言えます。
まとめ:在庫管理のAI活用を成功させるポイント
在庫管理へのAI活用は、需要予測の精度向上、自動発注による業務効率化、在庫最適化による資金効率の改善を通じて、企業の競争力を高める可能性があります。
成功のカギは、段階を踏んだ導入ステップと、データ品質への投資、そして人間とAIの協調設計にあります。
成功のポイントを順に整理すると、まず課題を数値で捉え、KPIと評価期間を事前に決めます。そのうえで、特定の領域からPoCを始め、データ整備を優先して進めます。本稼働まで伴走できるパートナーを選び、MLOpsによって稼働後の精度維持と継続的な改善を図ります。
在庫管理のAI活用は、導入後も市場の変化に合わせてモデルを育て続けるものです。まずは現状の在庫課題を数値で把握し、信頼できるパートナーとともにスモールスタートを切るのがよいでしょう。
あわせて読みたい関連記事は、次のとおりです。
・在庫管理のAI活用に強い開発会社・ベンダー6選|選び方も解説をご覧ください。
・在庫管理のAI活用事例|需要予測・在庫最適化・棚卸を変える実例をご覧ください。
・在庫管理のAIによる業務効率化・自動化|成果を出す進め方をご覧ください。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。