
需要のばらつきが大きい商品は、勘や表計算だけでは欠品損失と過剰在庫の廃棄・保管費を抑えにくいため、AI在庫最適化は規模に応じて段階的に導入します。
開発期間は、PoCの1〜3ヶ月から大規模導入の12ヶ月以上まで、導入規模によって変わります。工程の中心は、システム構築よりもデータ整備と精度検証にあります。
▼全体ガイドの記事
・AI在庫最適化の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI在庫最適化システムの開発期間の全体像
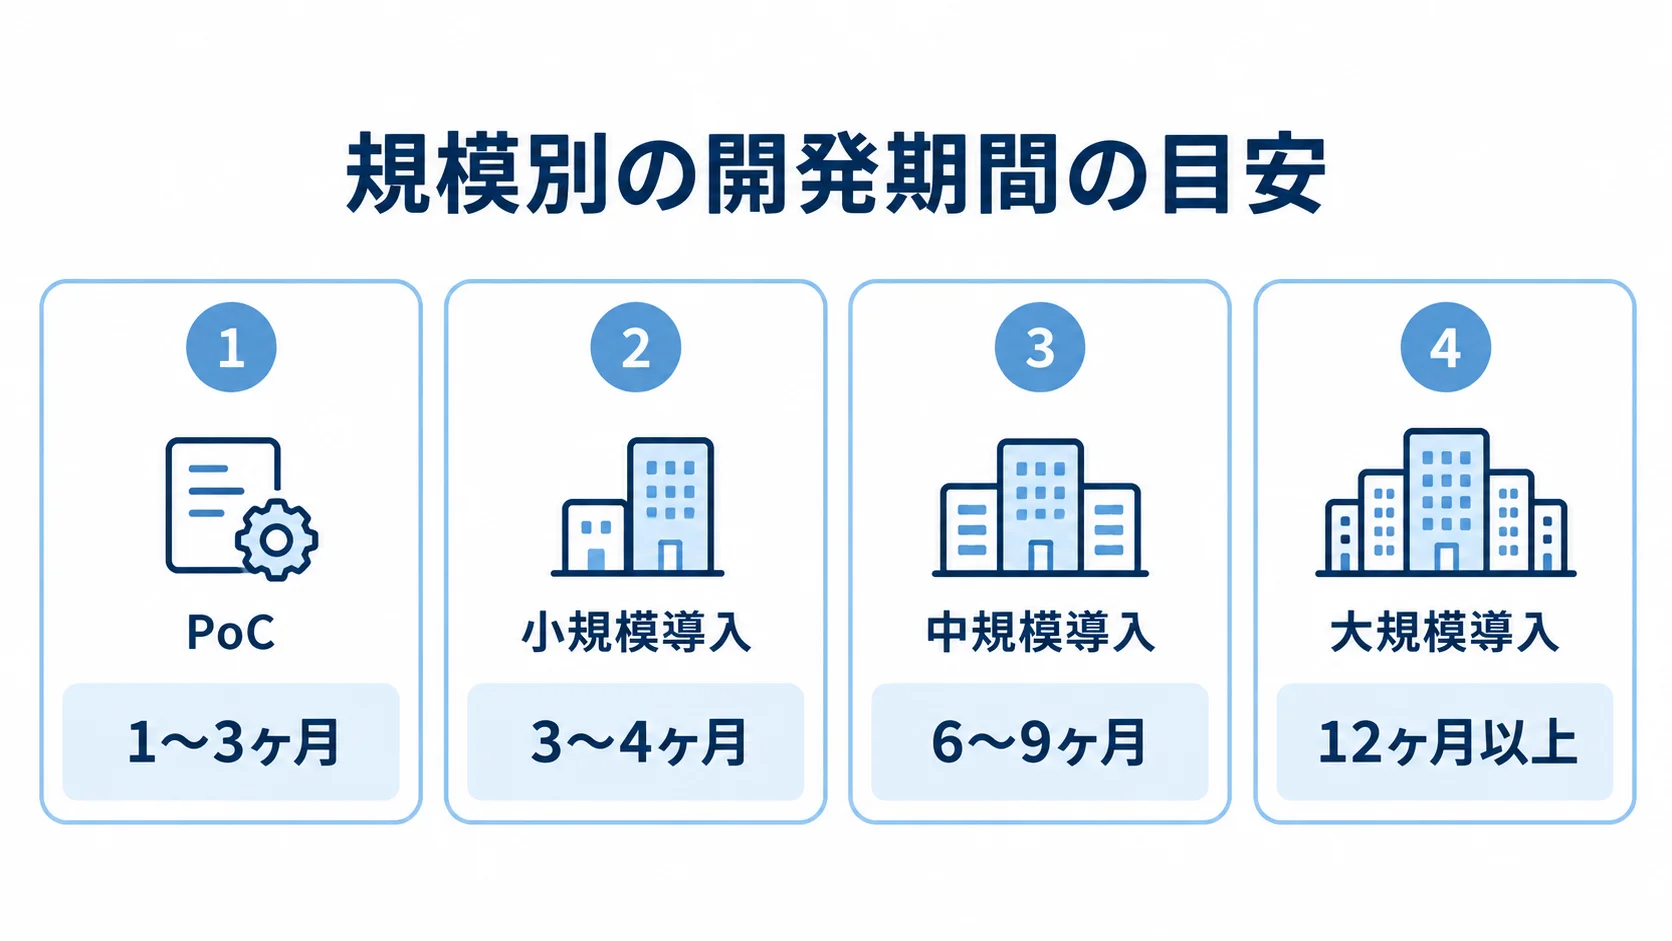
AI在庫最適化システムの開発期間は、対象商品数や拠点数、予測の粒度、既存システムとの連携範囲によって変わります。PoC(概念実証)は1〜3ヶ月が目安です。
本番構築は、規模によって数ヶ月から1年以上かかります。小規模導入は、単一カテゴリまたは単一拠点を対象に、3〜4ヶ月が目安です。
中規模導入は、複数カテゴリ・複数拠点を対象に、自動発注や基幹連携まで含めて6〜9ヶ月です。さらに、大規模導入は全社の在庫を対象にサプライチェーン全体を最適化し、12ヶ月以上を見込みます。
開発では、システム構築以上にデータ整備と需要予測モデルの精度向上に時間を使います。従来の業務システムと同じ感覚で納期を決めると、この構造を見落として、精度検証で計画が崩れやすくなります。
規模別の開発期間の目安
導入規模によって、対象範囲と必要な作業は変わります。そのため、自社がどの段階を目指すのかを最初に明確にしておくと、現実的な日程を組む出発点になります。
- PoC:過去データで需要予測モデルを試作し、精度と投資対効果(ROI)を評価する段階
- 小規模導入:限られた商品カテゴリや店舗・倉庫を対象とする段階
- 中規模以上:複数拠点や全社の在庫を対象に、自動発注や連携まで含める段階
PoCでは、対象商品の過去1〜3年分の販売・在庫データを使います。期間は1〜3ヶ月で、データが整っていれば1ヶ月台で済みますが、抽出や名寄せに手間取ると3ヶ月近くかかることもあります。
小規模導入は3〜4ヶ月が目安で、発注担当者へ需要予測を示すレコメンド型です。
中規模導入は6〜9ヶ月です。複数拠点・カテゴリでの自動発注や安全在庫の動的な見直し、基幹システムやWMSとの連携が加わるため、開発・テスト・連携検証の作業が増えます。
大規模導入は12ヶ月以上が目安です。全社の在庫とサプライチェーン全体を対象にし、調達・生産・物流の制約を扱うため、要件定義とデータ統合だけで数ヶ月かかることもあります。
従来型在庫管理システムとの開発期間の違い
従来型とAI在庫最適化では、開発期間を左右する不確実性の種類が異なります。
- 従来型:入出庫記録、在庫数の表示、発注点アラートなど、定めたルールどおりに動く仕組み
- 要件確定後:従来型はウォーターフォール型で進めやすく、期間の見通しも立てやすい構造
- 反復期間:精度調整が加わるため、機能の実装だけを比べてもAIは長期化しやすい傾向
同じ要件定義でも、需要が安定しているかどうかで、精度調整や試行錯誤の量が変わります。定番品か新商品か、季節変動が大きいかも影響します。
AI在庫最適化では、モデルの評価、特徴量やアルゴリズムの見直し、再学習と再評価を繰り返す、アジャイル的な進め方が主流です。
要件定義からリリースまでの工程別スケジュール
開発は、要件定義・KPI設計から精度検証・本番移行まで、5つの工程に分けられます。中規模の全体6〜9ヶ月のうち、データ収集・整備とモデル開発・検証が全体の6割以上を占めます。
進捗は、画面数よりも予測精度や発注につながるデータの整備状況で測るのが適切です。従来の業務システムでは実装・テストに工数の多くが集まりますが、AI在庫最適化では、その中心がデータとモデルへ移ります。
要件定義・データ収集整備フェーズ
要件定義・KPI設計では、在庫最適化の成功をどの数値で測るかを決めます。通常2〜4週間かかります。
- 経営・現場の目標:欠品率・在庫回転率・過剰在庫による廃棄の目標
- 予測精度:MAE・MAPEなどの指標と目標値を結び付けて設定
- データ整備:収集したデータの欠損・単位・粒度・名寄せ・外れ値の処理
目標が曖昧だと、後工程でモデルの良し悪しを判断できません。
収集対象は販売実績(POS・受注データ)と、在庫推移、発注履歴、商品マスタです。さらに、季節性・天候・キャンペーン・価格改定などの要因も集めます。
データ収集・整備は、AI在庫最適化の開発日程を最も左右するフェーズです。特に、データが複数システムに分散していたり、手作業の在庫調整が混在したりすると、整備に時間がかかります。
中規模では全体の30〜40%、期間にして1.5〜3ヶ月をデータ整備に要することもあります。「データはあるはず」という前提が崩れるリスクに備えて、十分な期間を確保します。
需要予測モデル開発・システム実装・精度検証フェーズ
データ整備のあとは、特徴量を設計し、対象商品の特性に合うモデルを選びます。中規模のモデル開発・調整は、1.5〜2.5ヶ月が目安です。
- 特徴量設計:曜日・月・祝日・ラグ特徴量・移動平均・価格・気温などの説明変数を設計
- モデル選定:LightGBM・XGBoost・Prophet・ARIMAなどを比べて選ぶ
- システム実装:予測表示・自動発注・安全在庫の算出・アラートの実装
精度が要求水準に届かなければ、特徴量の追加やデータ期間の見直しに戻ります。そのため、日程には幅を持たせておきます。実装と並行して、基幹システム・WMS・POSとのデータ連携も進めます。
精度検証では、過去のある時点から予測して実績と比べるバックテストを行います。さらに、実運用データで一定期間の並行稼働(シャドー運用)を行い、提案どおりに発注した場合の在庫推移を確かめます。
検証に1〜2ヶ月を確保しておくと、本番切り替え後のトラブルを大幅に減らせます。
精度検証を省いて急いでリリースすると、現場の信頼を失い、AIの提案が使われなくなるおそれがあります。
在庫最適化特有でスケジュールに影響する工程
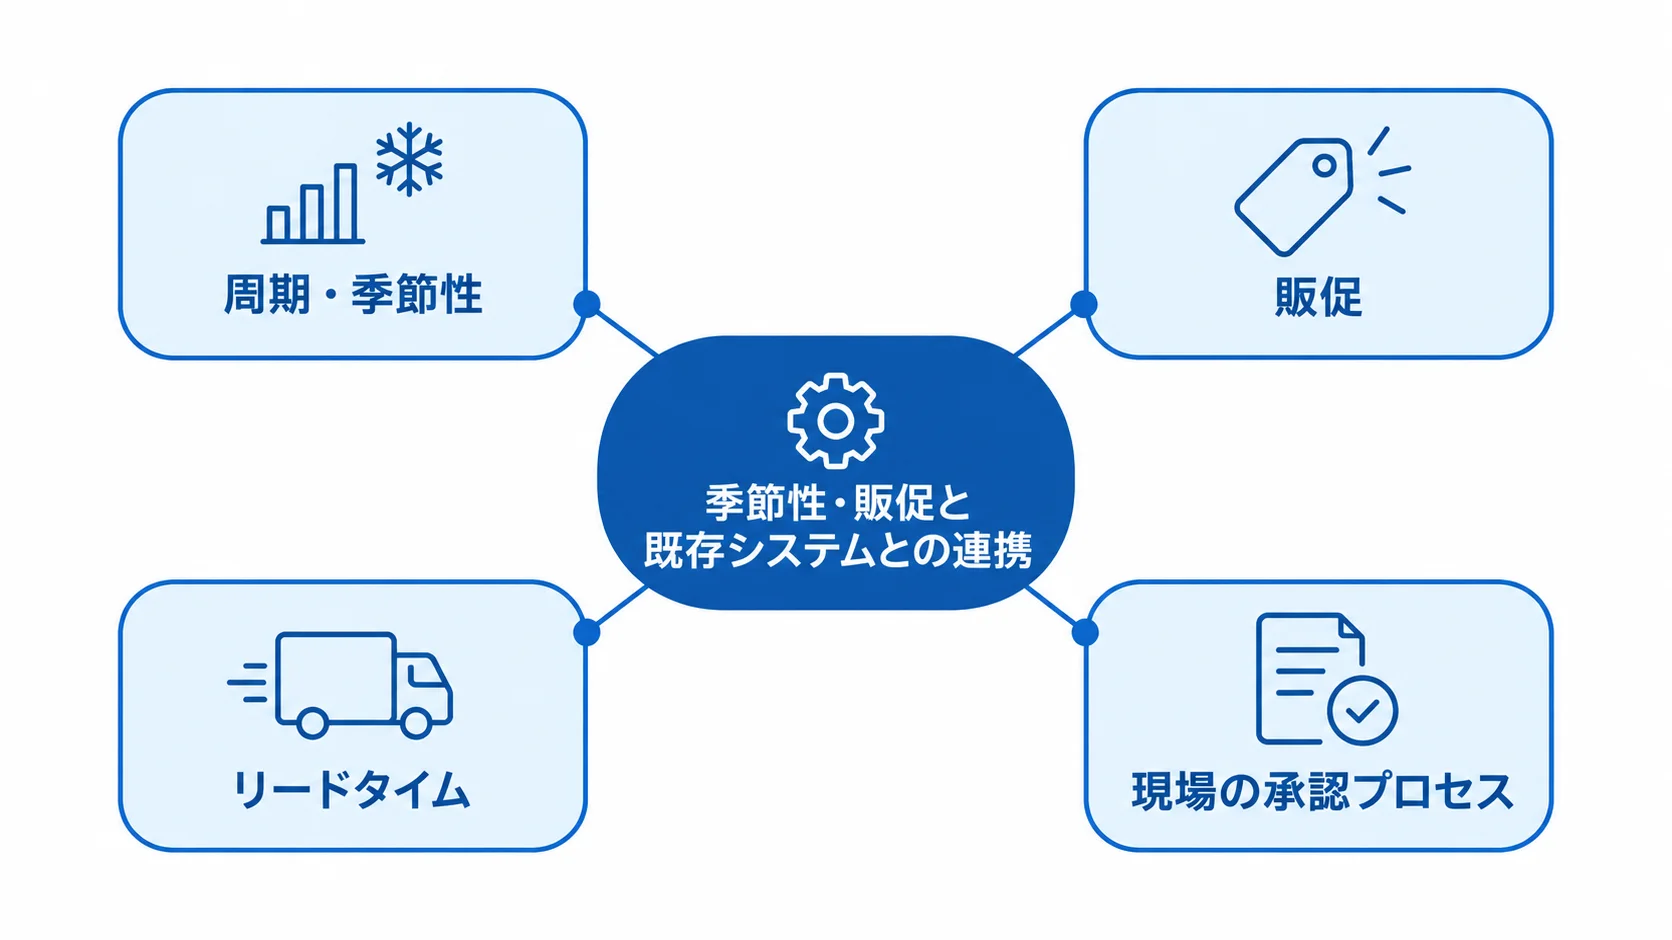
一般的なAIシステムと比べると、在庫最適化では需要の不確実性と実業務への組み込みが日程に影響します。一方で、画像認識や文書分類は正解データが明確で、精度評価の基準がぶれにくく、期間を見積もりやすいタスクです。
期間を読みにくくするのは、特に季節性や販促、既存システムとの連携です。在庫需要は欠品や販促で歪み、本来どれだけ売れたかという正解を定めにくいため、評価の土台から丁寧に整えます。AI在庫最適化では、予測を発注につなげるため、現場の承認プロセスや例外運用とのすり合わせも必要です。
季節性・プロモーション・リードタイム要因の織り込み
需要の予測には、過去の延長に季節性や販促などの要因を重ねて扱う必要があります。要因を細かく扱うほど、精度と期間の調整も増えます。
- 周期・季節性:季節・月末・給料日・連休と、気温や天候を考慮する
- 販促:セールやクーポン、テレビ・SNSでの話題化
- リードタイム:仕入先や時期による納品までの日数の違い
販促効果を学習させるには、いつ、どの商品に、どんな割引を行ったかを整理しておく必要があります。履歴が残っていない場合は、担当者への聞き取りやチラシ・メールの履歴から組み直すため、想定外の期間がかかることがあります。
発注から納品までのリードタイムは、AI在庫最適化で大きく扱う変数です。固定値にするか変動要因として見るかで、モデルの複雑さやテスト工数が変わります。
ばらつきの大きい商材では、不確実性を安全在庫に反映する設計と、その検証の期間も見込みます。
既存基幹システム・WMS・POS連携
AI在庫最適化は、予測結果を実際の発注や在庫補充につなげて初めて価値を生みます。既存システムとの連携期間は、システムの新しさやインターフェースの整備状況に大きく左右されます。
- 連携先:基幹システム(ERP)・倉庫管理システム(WMS)・店舗POS・仕入先との受発注(EDI)
- 接続方式:API対応のクラウド型は数週間、個別対応は1〜2ヶ月かかることがある
- 自動発注:誤発注を防ぐ承認フローや上限ガード、業務との整合確認が必要
レガシーな基幹システムに標準の連携口がない場合は、個別対応が必要になります。たとえば、CSVの夜間バッチやデータベースからの直接抽出では、設計・開発・テストだけで1〜2ヶ月かかることがあります。
連携先の担当者やベンダーの協力も、日程を左右します。そのため、初期から関係者を巻き込み、連携仕様を確認しておくことが、遅延の回避につながります。
納期遅延の典型要因と対策
AI在庫最適化の遅延には傾向があり、プログラムのバグや実装の遅れ以外にも原因があります。主な要因は、想定外のデータ状態と、現場が納得できる精度に届くまでの試行錯誤です。どちらもAI開発に特有の要因です。典型要因を知ってバッファを配置し、リスクに先回りすると、計画の精度を高められます。
データ品質・精度未達による手戻り
遅延を生みやすいのは、データ品質の問題と、予測精度が要求水準に届かないことによる手戻りです。開始時にデータが十分あると思っていても、抽出後に品質上の問題が見つかり、整備に時間を要することがあります。
- 欠品期間:売上がゼロと記録され、本来の需要や機会損失が分からない
- 商品マスタ:コード体系の変更により、過去と現在の商品がつながらない
- 在庫履歴:手作業の調整が混じり、モデルのノイズになる
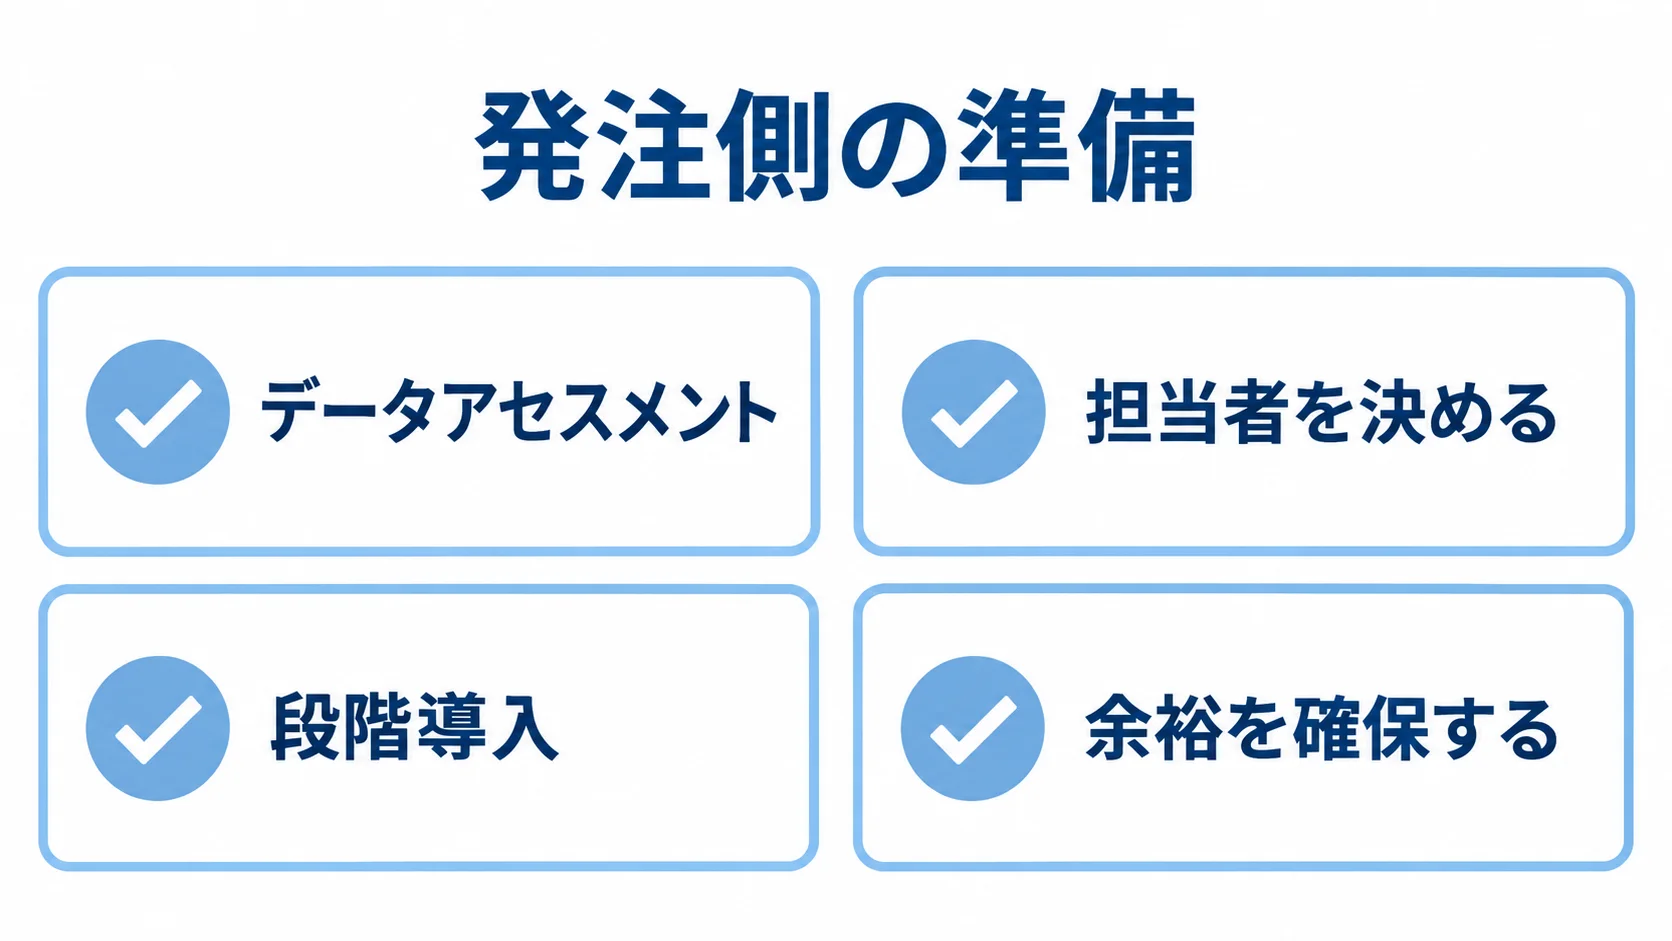
データ品質の問題は、当初の想定より作業を長引かせる典型的な要因です。そこで、契約・計画の前に1〜2週間のデータアセスメントを行い、データの実在性・品質・期間を事前に調べて、日程に反映します。さらに、精度目標に届かなかった場合の対応も、開始時に合意しておきます。
まずは読みやすい定番品から適用し、全商品に高い精度を求めないようにします。また、予測が難しい新商品や特売品は、人が判断する運用も選べます。精度目標を現実的に設計すれば、精度を際限なく追うことによる遅延を防げます。
現実的なスケジュールを引くための発注側の準備
遅延を防ぐには、開発会社の力量に加えて、発注側の準備と体制も欠かせません。現場の知識があってこそ、精度も実用性も高まります。
- 担当者を決める:販売・在庫・発注データの提供窓口と、現場を説明するキーパーソンを初期に置く
- 段階導入にする:PoCで精度とROIを確かめてから、本番投資を判断する
- 余裕を確保する:全体の15〜20%程度をバッファとし、データ整備と精度検証に充てる
「多めに発注する理由」や「特定時期に売上が伸びる理由」など、データだけでは分かりにくい現場の知識があります。担当者がこれを開発チームに伝えることが、精度と検証速度を左右します。
全社展開を最初から目指さず、対象を絞って始めると、大きな手戻りを抑えられます。また、開発パートナーには、発注側を巻き込む方法や段階導入の提案も求めます。
発注側が準備を整えると、AI在庫最適化の開発は予定どおり進みやすくなります。
まとめ
規模別の期間、工程ごとの日程、在庫最適化特有の要因、納期遅延の原因と対策を見てきました。
期間の目安は、PoCで1〜3ヶ月、小規模導入で3〜4ヶ月です。中規模導入は6〜9ヶ月、大規模導入は12ヶ月以上が目安になります。
中規模ではデータ整備とモデル開発・検証が全体の6割以上を占めます。反復期間が加わるため、日程を管理するには、データ品質と現実的な精度目標を最初に決めておくことが欠かせません。
季節性・販促・リードタイムの扱い、基幹システムなどとの連携、自動発注の承認設計が、期間を読みにくくする要素です。
遅延対策は、契約前のデータアセスメントと段階導入です。加えて、現場キーパーソンの配置と、15〜20%程度のバッファを置きます。
自社データの状態を把握し、小さく始めて精度とROIを確かめると、現実的な日程を組みやすくなります。
▼全体ガイドの記事
・AI在庫最適化の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。