
AIサプライチェーン最適化の開発は、要件とデータを整え、予測・最適化を実装し、現場で精度と実行性を確かめる順に進みます。期間は方式と規模で変わり、全体では1か月〜1年以上と幅があります。全体像は、AIサプライチェーン最適化開発の完全ガイドでも確認できます。
▼全体ガイドの記事
・AIサプライチェーン最適化開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AIサプライチェーン最適化の開発期間の全体像
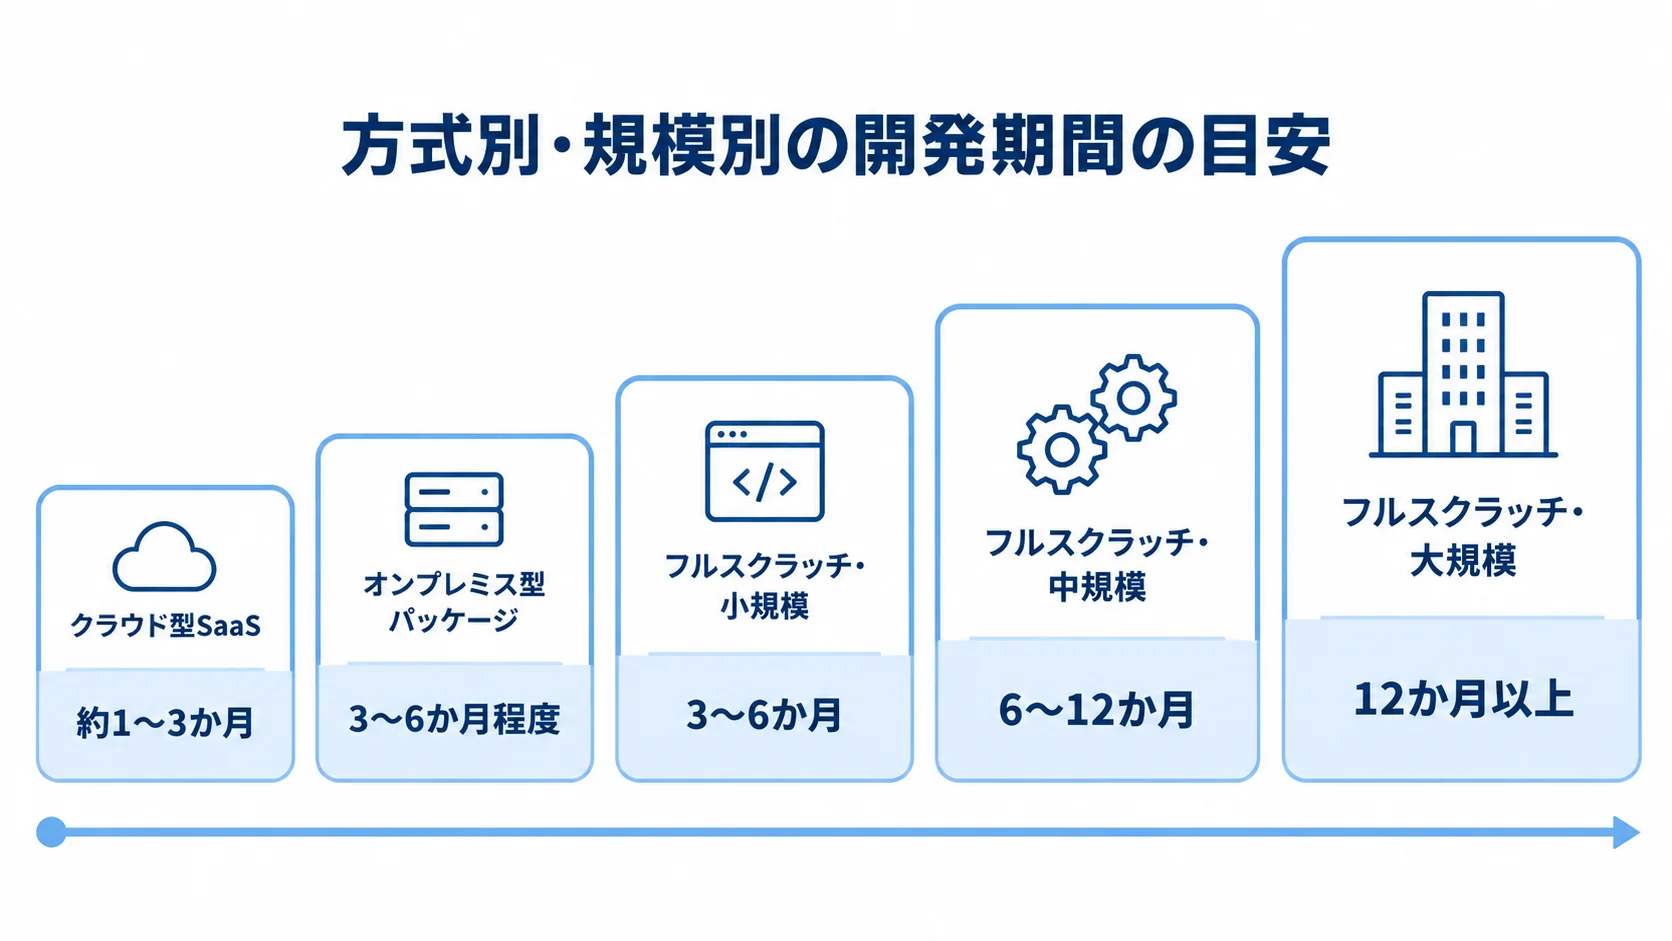
開発期間は、対象業務の範囲、基幹システムとの連携数、開発方式によって変わります。また、既製SaaSの設定と、独自ルールに合わせたモデルや最適化エンジンの開発とでは、必要な工数が大きく異なります。社内に散在するデータを学習用に整える工程も、通常の開発以上に期間を左右します。
そこで、方式と規模別の目安で自社の範囲を把握すると、現実的な日程を描けます。
物流の2024年問題によるドライバー不足や、原材料価格・為替の変動、需要の乱高下を受けて、AI活用が進んでいます。AIサプライチェーン最適化は、販売実績と天候・SNS・イベント情報などを分析し、安全在庫や車両・ルートを最適化する仕組みです。
導入例では、在庫20%削減、欠品による機会損失10〜15%改善、積載率10%向上、動的なルート再計算による平均配送時間15%短縮が報告されています。
方式別・規模別の開発期間の目安
期間は、SaaSの設定で済むか、自社向けに作り込むかで大きく分かれます。自社向けの開発では、規模が大きいほど期間も長くなります。
- クラウド型SaaS:標準業務への設定導入で、約1〜3か月
- オンプレミス型パッケージ:中規模でカスタマイズを加える場合、3〜6か月程度
- フルスクラッチ・小規模:基本的な需要予測を単一拠点に導入する場合、3〜6か月
- フルスクラッチ・中規模:複数拠点とERPやWMSをAPI連携する場合、6〜12か月
- フルスクラッチ・大規模:複数倉庫の在庫・配車を横断して最適化する場合、12か月以上
クラウド型SaaSは、既製の需要予測・在庫最適化サービスを自社データに合わせて設定する構成です。一方、オンプレミス型パッケージは、自社サーバーやプライベートクラウドに導入します。
大手開発会社の例では、配車最適化の初回開発に1億円、納期1年と提示されたケースもあります。対象範囲と方式によって納期は数倍から10倍以上変わるため、まずは自社要件の規模を見極めることが出発点になります。
開発期間を左右する変数
同じ中規模のシステムでも、半年で済む場合と1年近くかかる場合があります。期間が分かれるのは、次の4つの条件が違うからです。
- データの整備状況と保有量:数年分の時系列データがそろっているか、欠損があるか
- 連携先の数と密結合度:接続するシステムごとに、実装とテストが増えていく
- 最適化する業務範囲:需要予測だけを扱うか、在庫・配車・調達まで含むか
- 意思決定者の関与速度:自動発注や配車の判断に、どれだけ時間がかかるか
販売実績が数年分そろっているか、POSや受発注データに欠損・表記揺れがあるかで、整備の工数が変わります。欠損や表記揺れがあれば、クレンジングから始めることになります。
ERP・WMS(倉庫管理システム)・TMS(輸送管理システム)・POSなど、連携先が1つ増えるごとに工数が増えます。基幹システム連携だけで100〜500万円、物流機器連携では500〜1,000万円規模の追加費用がかかり、その分の期間も必要になります。
需要予測に絞るか、在庫・配車・調達まで一気通貫で扱うかで、モデル数と検証工数が変わります。さらに、自動発注や配車の範囲といった重要な判断が滞ると、承認待ちだけで納期が1か月以上ずれ込むことも珍しくありません。
工程別スケジュールと期間配分
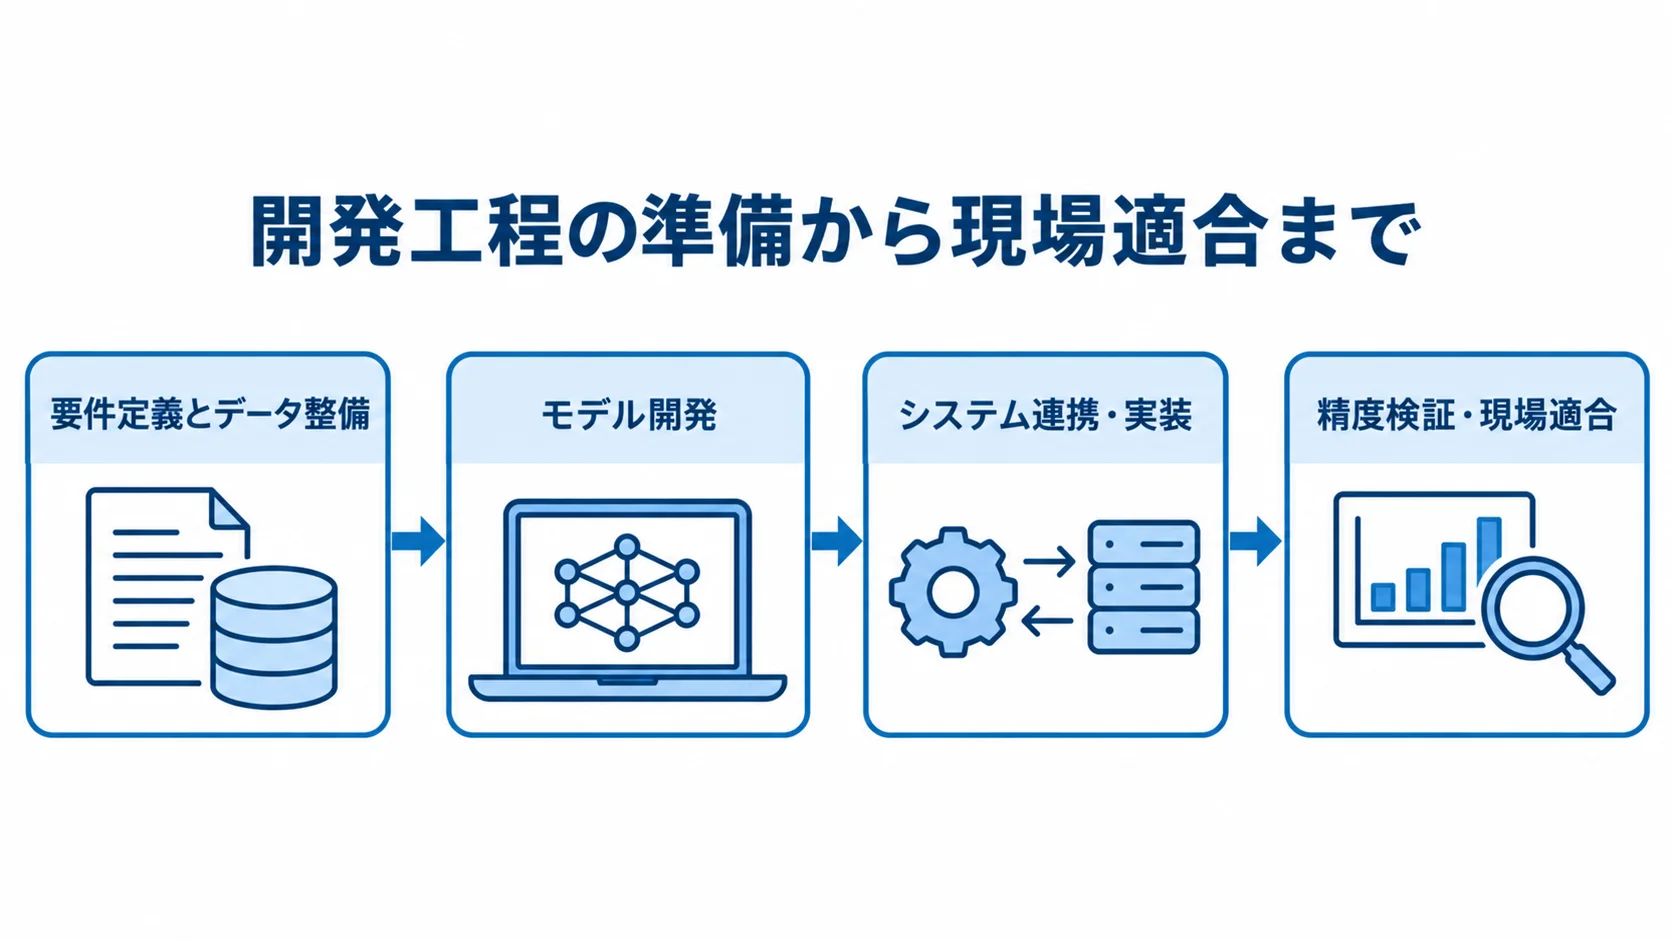
標準的な開発は5工程で進みます。最初に要件定義とデータ整備を行い、次にモデル開発と、システム連携・実装を進めます。最後に精度検証・現場適合で、現場の使い方に合うかを確かめます。
期間配分を知っておくと、開発会社の見積もりや日程が妥当かどうかを判断できます。データ整備と精度検証が、全体の半分以上を占めることもあります。
要件定義・データ整備フェーズ
最適化の目標とデータを先に固めておくと、後続工程での手戻りを防げます。要件定義と並行して、次の4つを早い段階でそろえます。
- 目標指標を設定:対象業務ごとに、成果をはかる評価基準を決める
- 判断範囲を設計:AIに任せる判断と、人が担う判断の線引き
- 学習データを整備:販売や在庫などのデータを、学習に使える品質に整えること
- データ確認を先行:要件定義と並行して、手元の保有データを一覧にする
要件定義は通常2〜4週間です。ただし、目的指標が曖昧なまま進めると、後工程で手戻りにつながります。
まずは対象業務を切り分けたうえで、欠品率・在庫回転率・積載率・配送コストなどを目標指標にします。
データ整備は、全工程の30〜50%を占めるといわれる大きな関門です。販売実績・在庫・受発注・配送実績を集めて欠損値や表記揺れを整えるほか、キャンペーンや災害時の外れ値の扱いも決めます。
ERPやWMSからの抽出も含めると、整備に2〜4か月かかるケースがあります。整備期間を軽く見積もると、後続工程が押し出されます。
モデル開発・連携実装・検証フェーズ
この工程では、予測・最適化モデルを作り、業務システムと接続したうえで、精度と現場での実行性を確かめます。
- モデルを開発:需要予測と、在庫・配車の最適化機能を作り込む
- 業務システムと連携:データを取り込み、予測結果を現場に返す
- 精度と実行性を検証:予測と実績、現場の制約がどれだけ合うか
モデル開発は通常4〜8週間程度です。ProphetやLSTM、Transformerなどの時系列モデルを選んで学習させます。在庫や配車には、数理最適化・組み合わせ最適化のエンジンを構築します。
モデル開発と連携実装は並行して進みます。ERP・WMS・TMS・POSから日次でデータを取り込みます。連携は1件ごとに、インターフェース設計とテストの工数が積み上がり、期間も延びます。
精度検証・現場適合は2〜6週間です。車両台数、庫内レイアウト、取引先ごとの納品ルールに照らして確認します。
また、現場担当者がAIの提案どおりに動けるかも確かめます。この確認を省くと、精度が高くても使えない事態になりやすいため、十分な期間をとる必要があります。
サプライチェーン最適化特有の工程がスケジュールに与える影響
通常の業務システム開発と異なり、予測と最適化を成り立たせる固有の工程が発生します。これらは全体の遅延に直結しやすく、事前の工数確保が欠かせません。
データ整備と基幹システム連携
最初の関門は、需要予測の土台となるデータ整備と、複数の基幹システムとの連携です。両者の範囲が、納期を左右します。
- データを統合:社内の実績と外部の情報を、予測に使える形にそろえる
- 業務システムと接続:発注や配車に、予測結果を反映させる
- 連携範囲を決める:納期を守るため、初期分と後回し分を要件定義の段階で切り分ける
ERPや販売管理システムの実績に加えて、天候・交通情報・カレンダーイベント・SNSトレンドも使います。
データは形式やタイミングが異なり、そのままでは学習に使えません。そのため、統一フォーマットへの変換や欠損補完が必要です。
発注や配車に反映するには、WMS・TMS・EDI(電子データ交換)などとの接続が必要です。連携先が増えるごとに、工数も増えます。
基幹システム連携は100〜500万円、バーコードやハンディターミナルとの連携は50〜500万円が費用感です。自動倉庫など物流機器との連携は500〜1,000万円規模です。連携範囲を広げるほど、スケジュールも長期化します。
需要予測モデルの精度検証と現場適合
需要予測モデルの確認は、精度と現場の両面で行います。
- 予測精度を検証:予測値と実績値を比べ、必要ならモデルを改善する
- 現場適合を確認:AIが算出した発注量や配車計画が、運用上の制約に合うかどうか
過去データで季節性、特売、突発的な需要変動を捉えられるかを評価します。目標に届かなければ、特徴量(学習に使うデータ項目)を追加するか、モデルを切り替えます。
安全在庫が保管能力を超える場合や、ルートが指定の納品時間に合わない場合は、そのままでは使えません。
予測精度と現場での実行可能性の両方を検証します。この工程を軽く見ると稼働後に使われなくなるおそれがあるため、日程にも組み込んでおきます。
開発アプローチによる期間の違い
開発期間は、どのアプローチを選ぶかで大きく変わります。一部の業務で試すか、全社の基幹業務として作るかで、手法も異なります。
SaaS・パッケージ活用による立ち上げ加速
立ち上げの速さ、初期投資、標準機能と自社要件の適合度が、SaaS活用の判断材料です。
- 短期間で導入:既製のサービスを設定して、予測を始める
- 対象を絞って試す:困っている業務から始め、効果を見て範囲を広げ、納期の短縮とリスク低減を図る
- 標準機能を確認:自社固有の業務ルールを、標準機能で満たせるか
需要予測・在庫最適化・配車最適化のSaaSは、1〜3か月程度で立ち上げられます。販売実績を取り込み、商品や拠点を設定します。
予測を動かせるため、専門のデータサイエンティストがいなくても着手できます。費用は、初期費用が0〜数十万円、月額が数万円〜数十万円です。
生成AIで要件整理や実装の一部を自動化し、開発期間全体を30〜70%短縮できるケースもあります。
SaaSでは、複雑な独自ルールに対応しきれない場合があります。そのため、標準機能で要件をどこまで満たせるかを、事前に確認します。
フルスクラッチ開発の期間と意思決定スピードの影響
独自要件に合わせた開発では、規模と連携の複雑さに加え、部門横断の意思決定の速さが納期に影響します。
- 規模に応じた期間:小規模3〜6か月、中規模6〜12か月、大規模12か月以上
- 独自要件を反映:モデルと最適化エンジンをゼロから作り、自社業務に合わせる
- 判断体制を整える:決裁者と関係部門が、運用方針を決める
複数の基幹システムや取引先ごとの納品ルール、運賃計算体系を組み込むため、SaaSより時間がかかります。要件定義には、決裁権を持つ担当者が同席します。予測の自動反映範囲や、例外時の判断者を迅速に決めるためです。
調達・在庫・物流・販売にまたがる合意は時間がかかりやすく、技術作業より意思決定の遅れが納期を押し下げることもあります。そこで、開始前に関係部門の代表者が集まる意思決定の場を設計します。
納期遅延の典型要因と対策
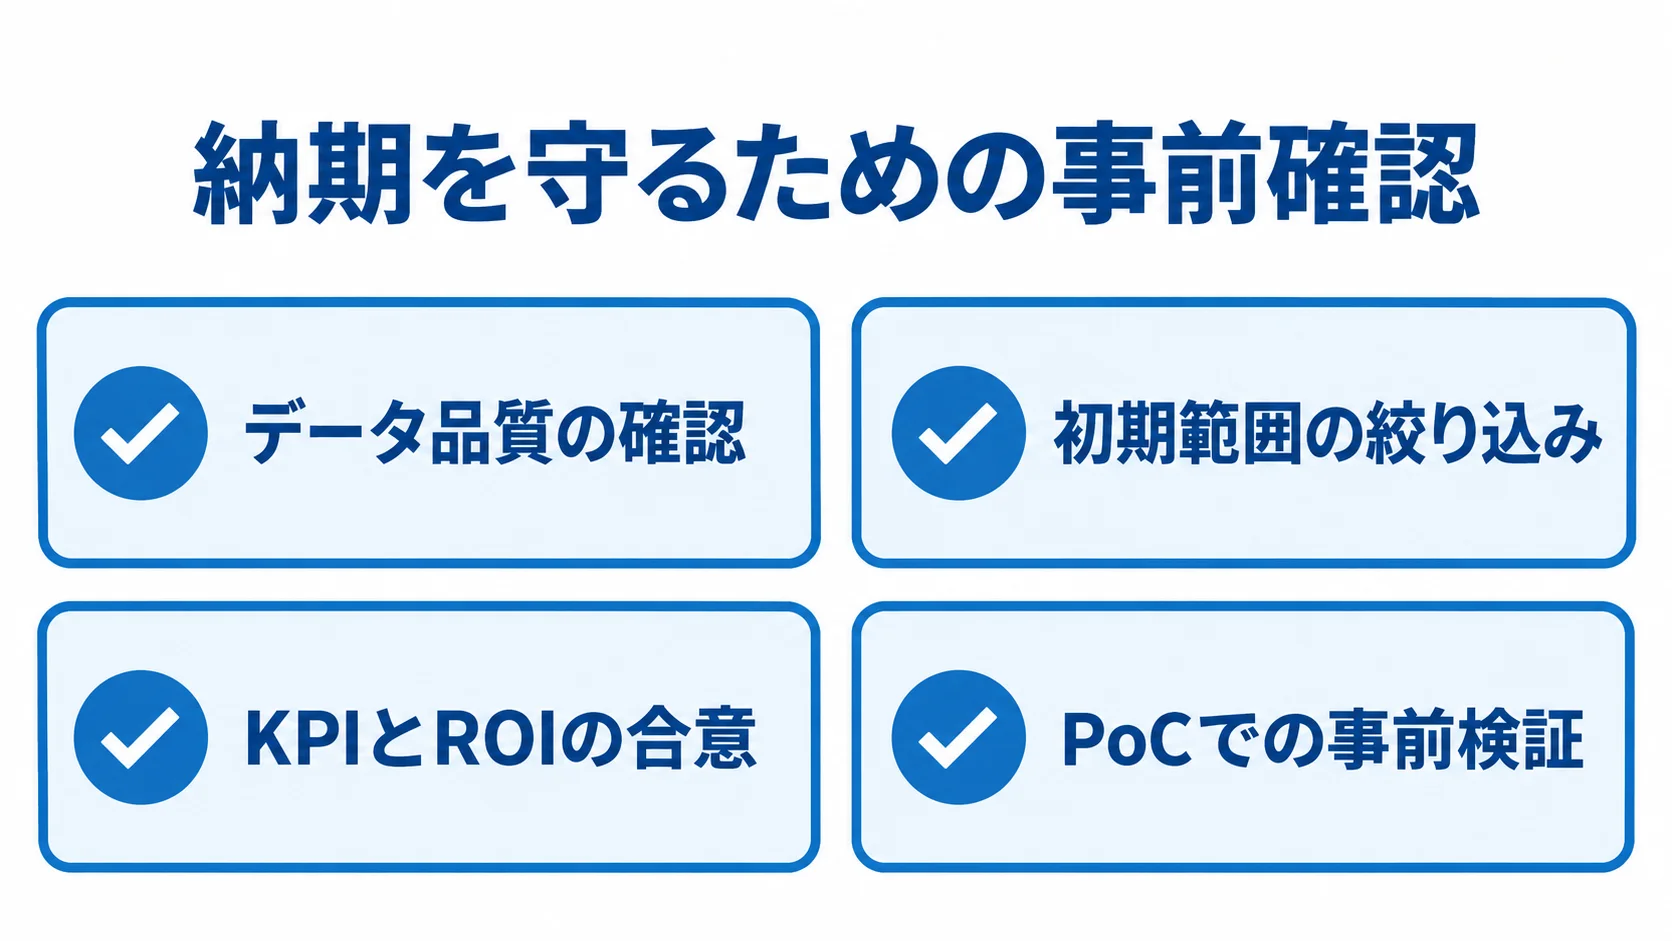
期間や工程を把握していても、典型的な遅延要因を放置すれば計画は崩れます。遅延の主な原因は、データの問題と、精度・効果の基準が曖昧なことです。
データ未整備・連携先の多さによる工数膨張
社内データの未整備は、最も多い遅延要因です。そのため、データ品質と初期リリースの連携範囲を早期に見直します。
- データ品質を確認:実装の前に、対象データを棚卸しする
- 整備工数を見積もる:データ整備を独立したタスクとして切り出す
- 初期範囲を絞る:連携先に優先順位をつけ、初期の対象を選ぶ
販売実績をそのまま学習に使えると見込んで始めても、モデル開発の段階で欠損や表記揺れが見つかることがあります。また、キャンペーンや欠品による異常値が次々に見つかり、想定外のクレンジングでスケジュールが崩れる場合があります。品質の低いデータから品質の低い予測しか出ない状態は、Garbage In, Garbage Outと呼ばれます。
連携先を初期リリースに詰め込みすぎると、各インターフェースの調整とテストが積み上がり、納期が延びます。そこで、需要予測の中核だけを先行させ、配車や調達の連携を次のフェーズに回す範囲の絞り込みが、納期を守るための現実的な打ち手になります。
精度・ROI基準の未設定とPoC省略のリスク
精度・効果の合格基準を先に決め、実データによる検証を経て本開発へ進むと、手戻りを抑えられます。
- KPIとROIを合意:本番稼働に必要な効果の基準を、関係者間で決める
- PoCで事前検証:精度と既存業務との相性を確かめる
- 見積もりを比較:要件概要と保有データを、複数社に示す
基準が曖昧だと、「在庫削減効果を上げたい」「もっと予測を当てたい」といった要望が続き、リリース時期が定まりません。
そのため、欠品率・在庫・配車担当の作業時間について、何%改善するかを決めておきます。なお、本開発前のPoC(概念実証)は3か月程度です。
事前のPoCは、本開発で想定外の精度不足が起きることによる大幅な遅延を防ぎます。小さく検証してから本開発へ進むことは、結果として最短の納期につながります。
まとめ
方式・規模別の期間目安と工程ごとの配分に加え、特有工程の影響、手法による違い、遅延要因と対策を整理しました。
開発期間は、クラウドSaaSで1〜3か月、オンプレ型パッケージで3〜6か月です。フルスクラッチは小規模で3〜6か月、中規模で6〜12か月、大規模で12か月以上です。
工程の目安は、要件定義が2〜4週間、データ整備が全工程の30〜50%、モデル開発が4〜8週間、精度検証・現場適合が2〜6週間です。
データ整備、外部データを含む基幹システム連携、予測精度と現場適合の確認は、スケジュールのクリティカルパスになりやすい工程です。
期間差が大きいため、自社要件に合う開発手法の選定が納期に直結します。
データの事前棚卸しと精度・ROI基準の合意、PoCによる早期検証で、データ未整備や基準未設定による遅延に備えます。
具体的なスケジュールは、複数の開発会社に要件概要と保有データの状況を示して見積もりを取ることから検討できます。
▼全体ガイドの記事
・AIサプライチェーン最適化開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。