
AIサプライチェーン最適化の試作は、モックアップ、PoC、プロトタイプを検証目的に合わせて使い分けます。実データで効果を確かめ、現場で試験運用してから本開発へ進めば、投資リスクを抑えられます。
失敗の回避策や本開発への移行については、関連記事もご覧ください。
▼全体ガイドの記事
・AIサプライチェーン最適化開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AIサプライチェーン最適化開発における試作の位置づけ
試作は目的や検証のレベルによって種類が分かれ、PoC、プロトタイプ、モックアップでは確かめる対象も異なります。
役割を混同すると検証内容がぶれるため、本格開発の前に目的と段階を整理しておくと、無駄のない検証につながります。
AIサプライチェーン最適化では、一般的なシステム開発以上に試作が重要になります。その理由を理解しておけば、試作にかける時間と予算を適切に割り当てられます。
PoC・プロトタイプ・モックアップの3レベルの定義
3つの試作では、見た目、技術の可否、業務での実用性の順に検証が深まっていきます。
- モックアップ:画面や操作の流れを見た目で確かめる段階。
- PoC:自社の課題を技術で解けるかという実現可能性。
- プロトタイプ:業務での使い勝手や連携を試す段階。
モックアップでは、需要予測のロジックは動かしません。その代わりに、需要予測の結果や在庫の推奨値を示すダッシュボードと配車計画の画面を、関係者間で早めにすり合わせます。
PoC(概念実証)は、この技術で自社の課題を解けるかという実現可能性を検証する段階で、試作のなかでも特に重要です。
たとえば、過去データの一部で需要予測モデルを動かし、既存手法より高い精度や、在庫削減・欠品改善の効果を確かめます。
プロトタイプは、PoCで可能性を確認した後に作ります。
限定した範囲で本番に近い環境を使い、現場での使い勝手や既存システムとの連携を検証します。
サプライチェーン最適化でPoCが特に重要な理由
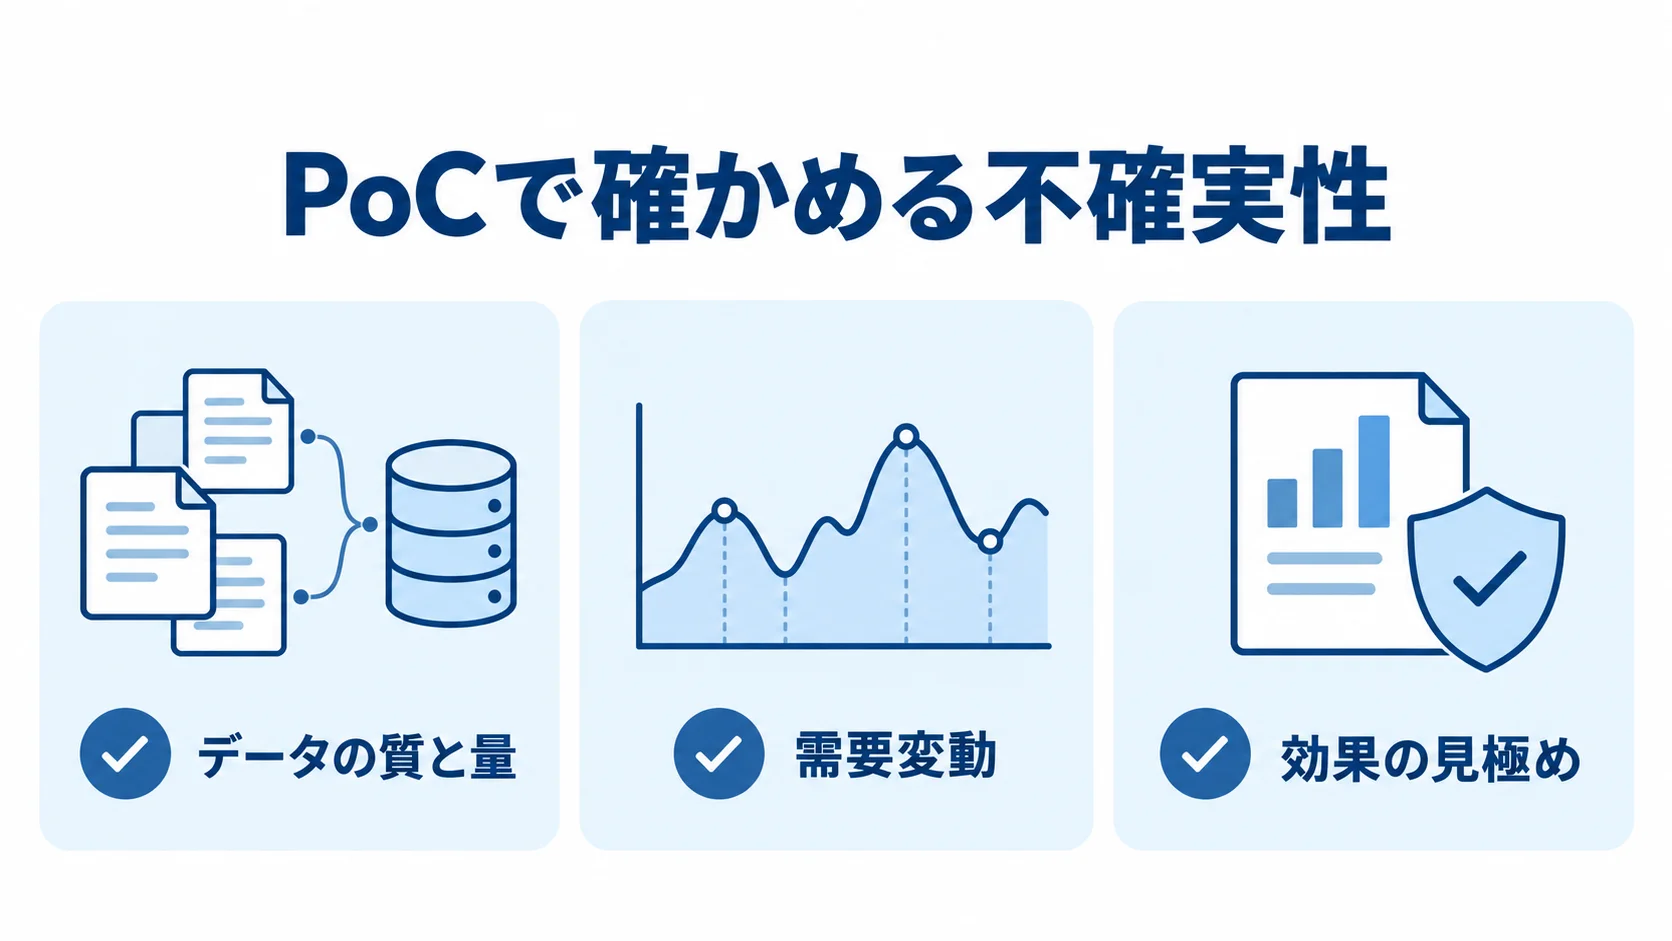
システムの価値は、予測がどれだけ当たるかという不確実な要素に左右されます。AIの精度は実データを使うまで確実には読めないため、PoCで自社での効果を確かめます。
- データの質と量:欠損や表記揺れによる精度への影響。
- 需要変動:需要のパターンによって変わる予測結果。
- 効果の見極め:実データの一部を使った効果の検証。
一般的な業務システムは、仕様どおりに作れば動きます。
一方で、AIの精度はデータの質と量、需要変動に左右されます。
データが整っていれば高い精度が出ます。しかし、欠損や表記揺れが多いと、高度なアルゴリズムでも十分な精度が得られない場合があります。
数千万円の本開発に先立ち、数百万円規模のPoCで実データの一部を試せば、効果を見極められます。精度が出ない場合は、本開発の前に方針を見直せます。
不確実な点を抱えたまま本開発に進むのは、大きな賭けになります。そのためPoCは、大規模開発の失敗リスクを抑えるスモールスタートとして欠かせない工程です。
PoCで検証すべき項目とGo/No-Go判断基準
PoCを成功させるには、何を検証するか、どの基準を満たせば本開発へ進むかを最初に決めておくことが大切です。目的が曖昧なままだと、試作品が動いても判断にはつながりません。
需要予測精度・最適化効果の検証方法
予測精度は、学習に使う期間と実績値を照らし合わせ、既存手法からの改善幅も見て評価します。
- 予測精度:過去データで学習したモデルを、その後の実績値と比べる方法。
- 在庫・欠品:従来の在庫水準や欠品率を基準にした効果の試算。
- 配送コスト:予測や計画を過去実績に当てはめて見る方法。
学習データは過去のある時点までに限り、それ以降の実績値を答え合わせに使います。精度の数値だけでなく、担当者の勘や従来の計算方法とも比べます。
AIが算出した発注量や配車計画を過去の実績に当てはめ、計画どおりに動いていた場合に在庫や配送コストがどう変わるかをシミュレーションします。
一般的な効果目標である在庫20%削減や、欠品による機会損失10〜15%改善を、自社データで再現できるかも確かめます。
特売やイベント、季節変動など、需要が大きく動く場面での精度も評価します。こうした難しいケースを含めておくと、本番投入後の実力を見誤りにくくなります。
Go/No-Go判断基準の具体例
Go/No-Goの基準は、PoCを始める前に関係者の間で合意しておきます。後から決めると、精度への期待が先に立って判断が先延ばしになるおそれがあります。
- 予測精度:既存手法を明確に上回ること。
- 欠品・在庫:欠品率を目標まで下げ、在庫を一定割合減らせる見込み。
- 作業時間:配車担当者などの作業を短縮できること。
そのため、定量的なKPI(重要業績評価指標)を事前に設定しておきます。目安の例には、既存手法より予測精度を10%以上向上させる基準があります。
作業時間を30%削減する水準を置く例や、労働時間を3%以上削減できるかを判断ラインとする例もあります。
効果を人件費、在庫コスト、機会損失などの金額に換算し、導入と運用のコストに見合うかを試算します。ROI(投資対効果)が合うと判断できてからGoを決めれば、数値に基づいて判断できます。
PoC・プロトタイプの費用・期間と進め方
PoCやプロトタイプにかける費用と期間は、多くの担当者が悩む点です。かけすぎれば本開発に近づいてしまい、少なすぎれば検証が不足します。
費用・期間の相場
費用と期間は、検証の範囲によって変わります。全面導入を見据えたPoCと、業務を絞ったMVPは分けて考えます。
- 全面導入への検証:3か月〜、100〜500万円程度。
- 業務を絞るMVP:2〜3か月、100〜300万円程度。
全面導入を見据えた検証では、実データの一部で需要予測モデルを構築し、精度と効果を評価します。MVP(実用最小限の製品)は、最も困っている業務を1つに絞って進める方法です。たとえば、主力商品の需要予測だけ、または特定拠点の在庫最適化だけを対象にできます。
対象を絞れば、費用と期間を抑えながら、実務で使えるレベルの検証ができます。PoCの予算は本開発と切り離して組みます。数百万円のPoCで自社では精度が出ないと分かれば、数千万円規模の本開発での失敗を防げたと判断できます。
PoCは、本開発に進むかを判断するための投資です。その費用は、本開発で大きな失敗をしないための出費と捉えられます。
スモールスタート・MVPの手順
まず業務を一つ選び、データの検証と現場での運用を経てから、本開発に進むかを判断します。
- 課題が大きく、効果を測りやすい業務を一つ選びます。
- 業務の過去データを集め、品質を確認してモデルを構築します。
- 過去データで精度を検証し、現場で3〜6か月ほど試験運用します。
- KPIとROIの基準で本開発への移行を判断し、Goなら対象範囲を広げます。
候補としては、欠品や過剰在庫が頻発する主力商品群や、配車が属人化した特定ルートなど、解決後の効果が見えやすい領域が挙げられます。
既製ツールやクラウドサービスを使えば、短期間で予測を動かし始められます。試験運用では、使い勝手と追加機能を確かめます。現場で継続して動かすと、机上の精度検証だけでは分からない実用上の課題が見つかります。
一つの業務で効果を確かめてから範囲を広げれば、投資リスクを抑えながら成果を積み上げられます。
よくある失敗パターンと回避策
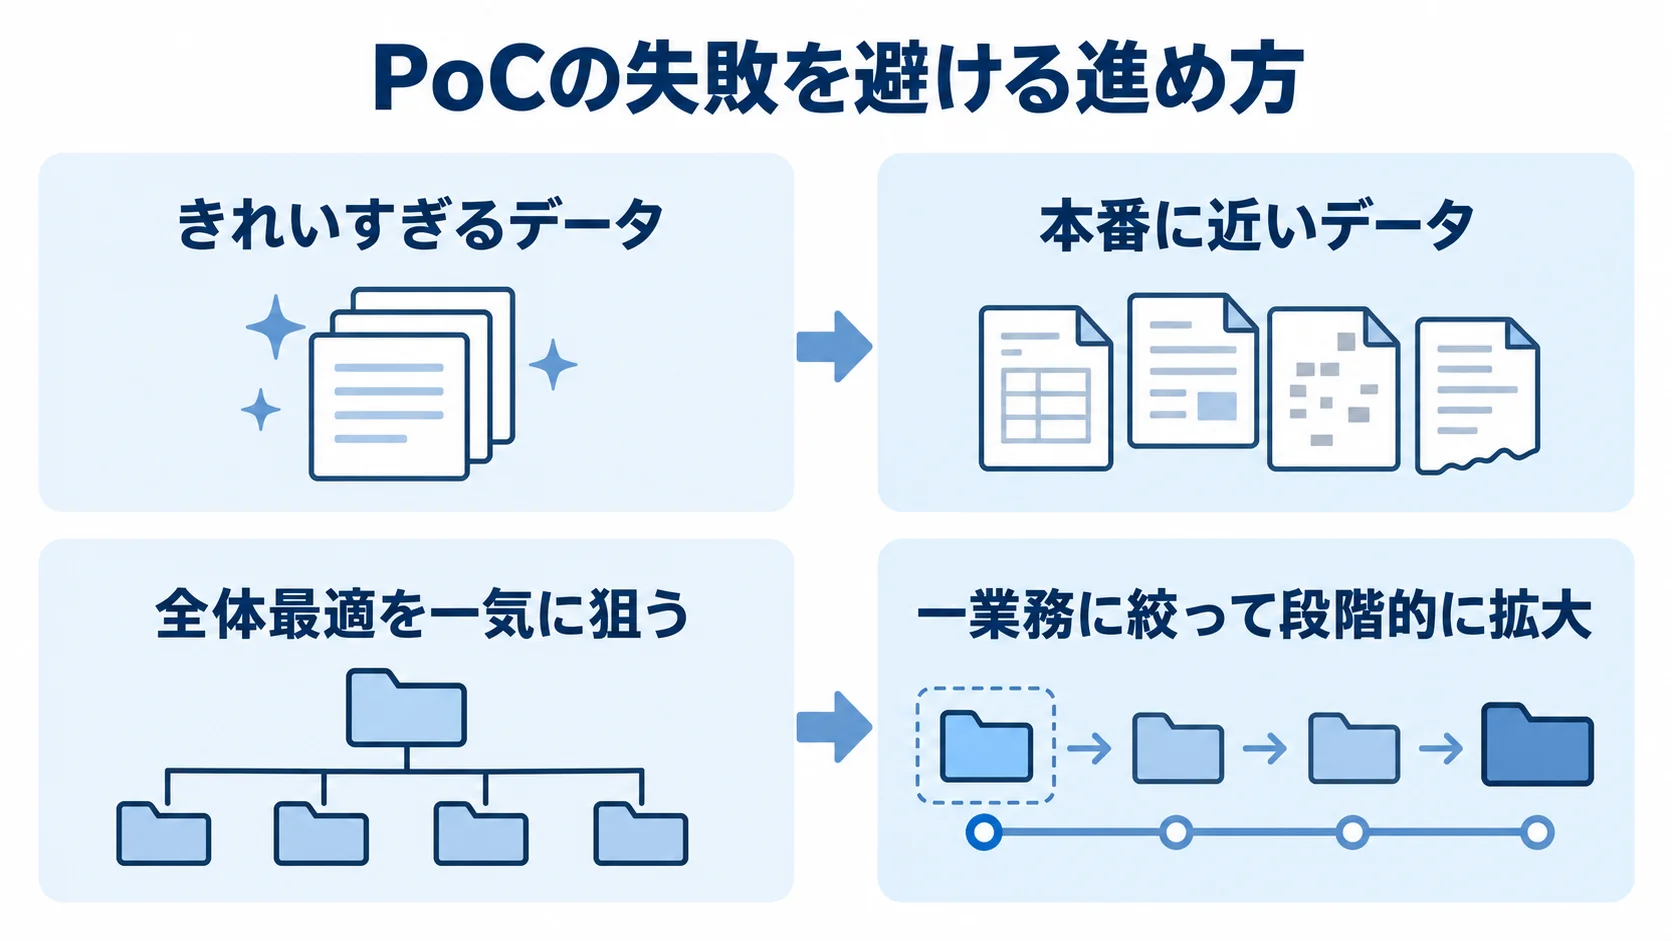
PoCやプロトタイプは、適切に進めれば強力な手段になります。一方で、進め方を誤ると、PoCでは良い結果が出ても本番で使えない場合があります。AIサプライチェーン最適化のPoCで陥りやすい失敗は2つあり、きれいなデータだけで検証することと、全体最適を一気に狙うことです。
綺麗すぎるデータで検証し本番で破綻する失敗
特に多いのは、PoCで高い精度が出ても、本番の生データでは精度が落ちる失敗です。
- 本番に近いデータ:実データを使った検証。
- 前処理の範囲:本番で自動化できる処理に限ること。
- クレンジングの継続:必要な作業の程度を記録し、本番でも続ける仕組みの計画。
PoCの成功を狙って欠損や異常値を取り除けば、理想的なデータで良い結果が出ます。しかし、本番で日々流れてくる汚れたデータでの実力は、この結果には反映されません。
本番では、入力ミスや欠品による異常値、システム間の不整合が混じります。きれいなデータの精度を前提にしてしまうと、稼働後に予測が当たらない事態になりかねません。
全体最適を一気に狙うことによる失敗
需要予測・在庫・配車・調達を一度に最適化しようとすると、PoCが膨らんで結論を得にくくなります。
- 対象を一業務に絞る:最も困っている業務から始めること。
- 隣接業務へ広げる:効果を確かめてから段階的に進めること。
サプライチェーンは工程がつながっているため、すべてを一度につなぐと検証の要素が増えます。ボトルネックや効果の要因が分からなくなり、期間と費用が膨らむおそれがあります。
まず需要予測の精度を確かめ、その予測をもとに在庫を最適化します。次の段階では、在庫を前提にした配車最適化へ進みます。
各段階で効果を確かめれば、判断材料をそろえたうえで全体最適へ近づけます。小さな成功を積み重ねる進め方は、結果として、早く確実に成果へつながります。
PoCから本開発への移行のポイント
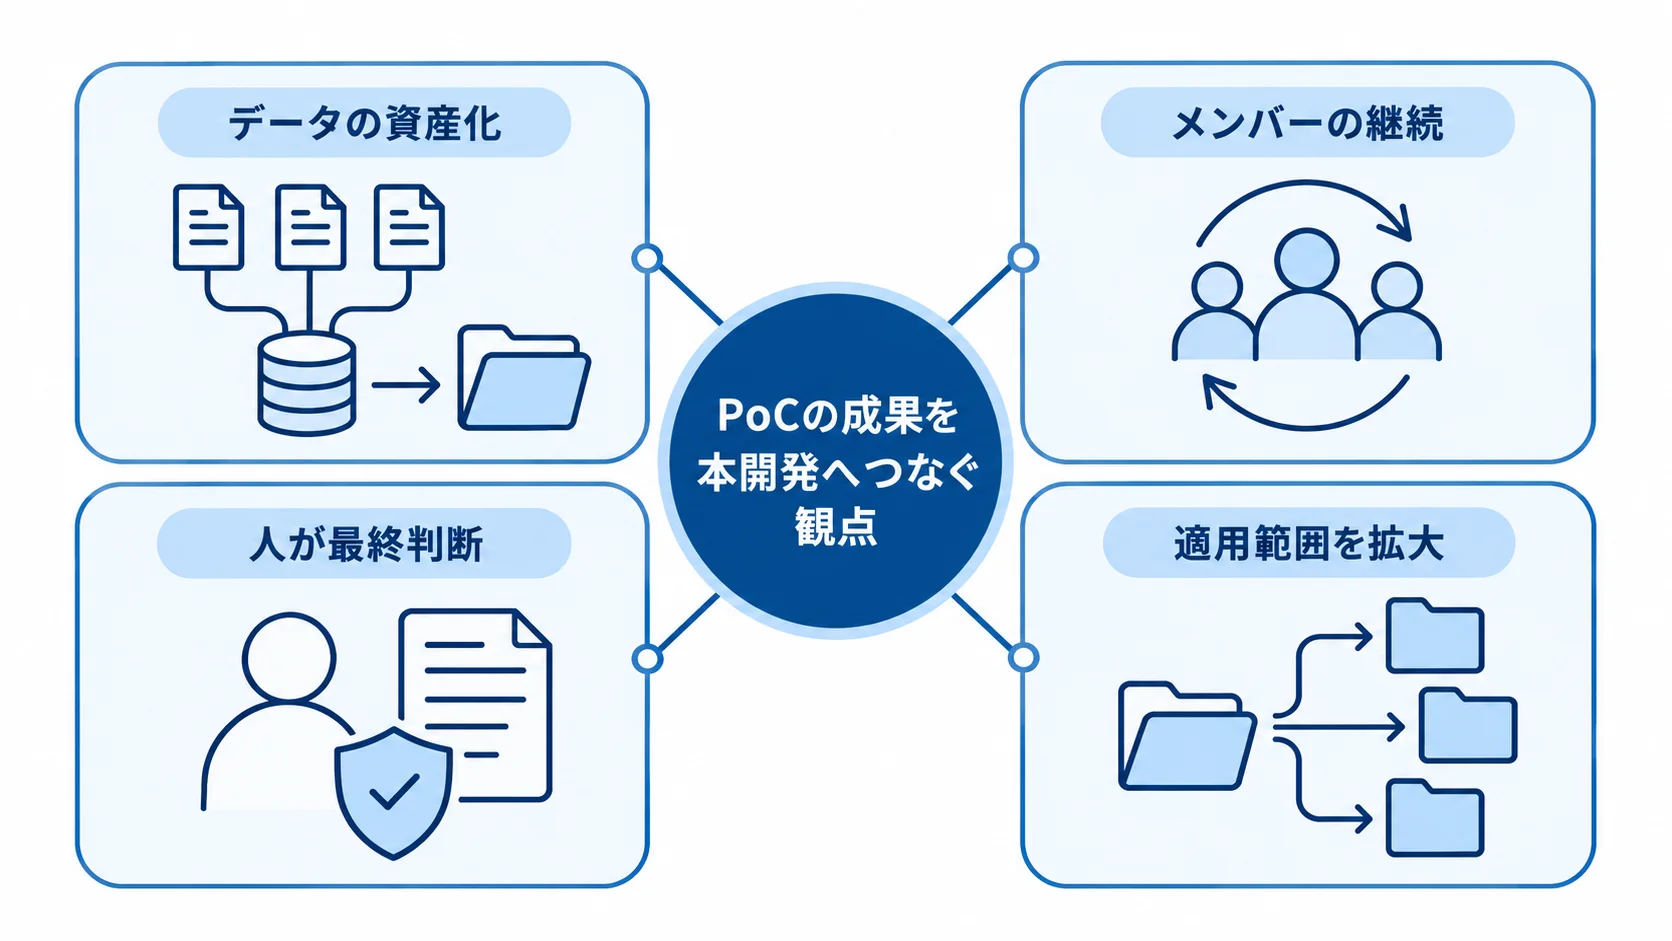
PoCで良い結果が出ても、本開発へ進めるとは限りません。両者の間には「PoCの壁」と呼ばれる断絶があるため、成果をつなぐ備えが必要です。
データ整備とチーム継続によるノウハウ蓄積
発注側と開発会社は、PoCで得たデータや運用の知見を、本開発へ確実に引き継ぎます。
- データの資産化:整備したデータとクレンジングの仕組みを、本開発でも使うこと。
- メンバーの継続:PoCの担当者を本開発にも関わらせる体制。
PoCを通じて、精度に効いたデータや必要なクレンジング、現場の運用制約が分かります。担当チームが変わると知見が失われ、試行錯誤をやり直すことがあります。
AIサプライチェーン最適化では、自社データの特徴が精度を左右します。そのため、データとチームを継続させることが、本開発を円滑に始める前提になります。
現場適合と段階的な適用範囲の拡大
現場の運用に合わせ、担当者の確認から始めて、自動化と適用範囲を段階的に広げます。
- 人が最終判断:AIの提案を確認・修正して、業務に反映すること。
- 適用範囲を拡大:成果が出た領域から、隣接業務へ広げること。
技術的に可能であっても、現場に組み込むには、担当者がAIの提案を受け止めて業務に反映する運用の設計が必要です。
精度への信頼が高まるにつれて、自動化を広げていきます。これにより、現場の抵抗を抑えながら、人とAIの役割を調整できます。
成功した業務から商品群や拠点へ広げ、在庫から配車・調達へ横展開します。段階的に本番化すれば、リスクを抑えながら効果を全社に広げられます。
PoCを段階的な拡大の起点と位置づけることで、投資を成果につなげられます。
まとめ
試作は、モックアップ、PoC、プロトタイプの3段階で、予測精度や業務への適合性を段階的に確かめます。なかでも、実データで効果を検証するPoCが、本開発のリスクを抑えます。
PoCの重要性、検証項目とGo/No-Go、費用相場、スモールスタート、失敗回避、本開発への移行を、順に見てきました。
全面導入へのPoCは3か月〜・100〜500万円程度、業務を絞ったMVPは2〜3か月・100〜300万円程度が目安です。
現場で3〜6か月ほど試験運用し、既存手法を上回る精度や作業時間の削減、ROIを基準に移行を判断します。
本番に近いデータで検証し、最初は一つの業務に絞ります。そのうえで、PoCで得たデータと知見を引き継ぎ、現場への適合を確かめながら段階的に範囲を広げます。
小さく効果を確かめてから本格投資に進めば、AIサプライチェーン最適化の成功に近づきます。
PoCを検討する際は、自社データの状況と検証したい業務を、複数の開発会社に示して相談するとよいでしょう。
▼全体ガイドの記事
・AIサプライチェーン最適化開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。