
AI異常検知の開発は、対象データと目的を定めたうえで、「要件定義・企画」「設計・開発」「テスト・リリース」の三つのフェーズで進みます。
各フェーズの成果を次の工程へ確実に渡すことが、後からの手戻りを防ぐ鍵になります。
▼全体ガイドの記事
・AI異常検知の完全ガイド
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI異常検知の全体像
AI異常検知は、サイバー攻撃対策など、幅広い分野で急速に普及しており、グローバルの異常検知市場は2025年時点で年率20%超の成長を続けています。
導入を検討する際は、仕組みと分類を理解しておくことが大切です。手法を誤って選ぶと、誤検知が多発したり、本来検知すべき異常を見逃したりするおそれがあります。まず全体像をつかんでおくと、要件定義や設計の段階で判断に迷いにくくなります。
AI異常検知の種類と特徴
AI異常検知は、学習データの種類と検出の方法によって、大きく三つのカテゴリに分かれます。
- 教師なし学習型:正常データだけで学習し、そこから外れた挙動を異常として捉える方式
- 教師あり学習型:正常と異常の両方にラベルを付けたデータを使う分類モデル
- 半教師あり学習型:大量の正常データと少量の異常データを組み合わせた学習
教師あり学習は精度が高い一方で、異常サンプルの収集と人手によるアノテーションに相応のコストがかかります。半教師あり学習はその中間に位置し、実際のプロジェクトでもっとも採用されやすい形態です。異常サンプルを集めにくい製造業の設備予知保全やネットワーク侵入検知では、教師なし学習が広く使われています。
代表的なアルゴリズムは、Isolation Forest・オートエンコーダ・LOF(Local Outlier Factor)です。Isolation Forestは、ランダムな木構造で外れ値を高速に孤立させる手法で、数百万件規模のログデータに対してもリアルタイム処理が可能です。
オートエンコーダは、入力データを低次元に圧縮して復元する際の「再構成誤差」を異常スコアとして活用するため、センサー波形や画像の微細な変化を捉えるのに優れています。
従来の異常検知との違い
従来のルールベース型の異常検知は、専門家が定めた閾値や条件式で異常を判定します。例えば「温度センサーが80℃を超えたらアラート」という単純な閾値設定が典型例です。この手法は解釈しやすく実装も容易ですが、現場の複雑な変動パターンや複数センサーの相関関係を捉えきれず、誤検知や見落としが多くなるという根本的な限界があります。
AI異常検知は、この課題を解決するものです。多数のセンサーが生成する多次元データを同時に分析し、単一の閾値では検出できない複合的な異常パターンを高精度で識別します。さらに、AIモデルは継続的に学習するため、運用を重ねるほど精度とシステムの価値が増していく点も、従来手法との大きな違いです。
トヨタ自動車が導入した事例では、AIによる異常検知で不良品検出率が従来比で大幅に向上し、ライン停止時間の削減にもつながりました。キューピー株式会社では、食品製造工程にAI画像解析を導入し、異物混入・規格外品の検出率を飛躍的に改善した事例が報告されています。こうした実績から、AI異常検知は単なる技術的な進化にとどまらず、企業の競争力を左右する重要な投資です。
AI異常検知開発の進め方
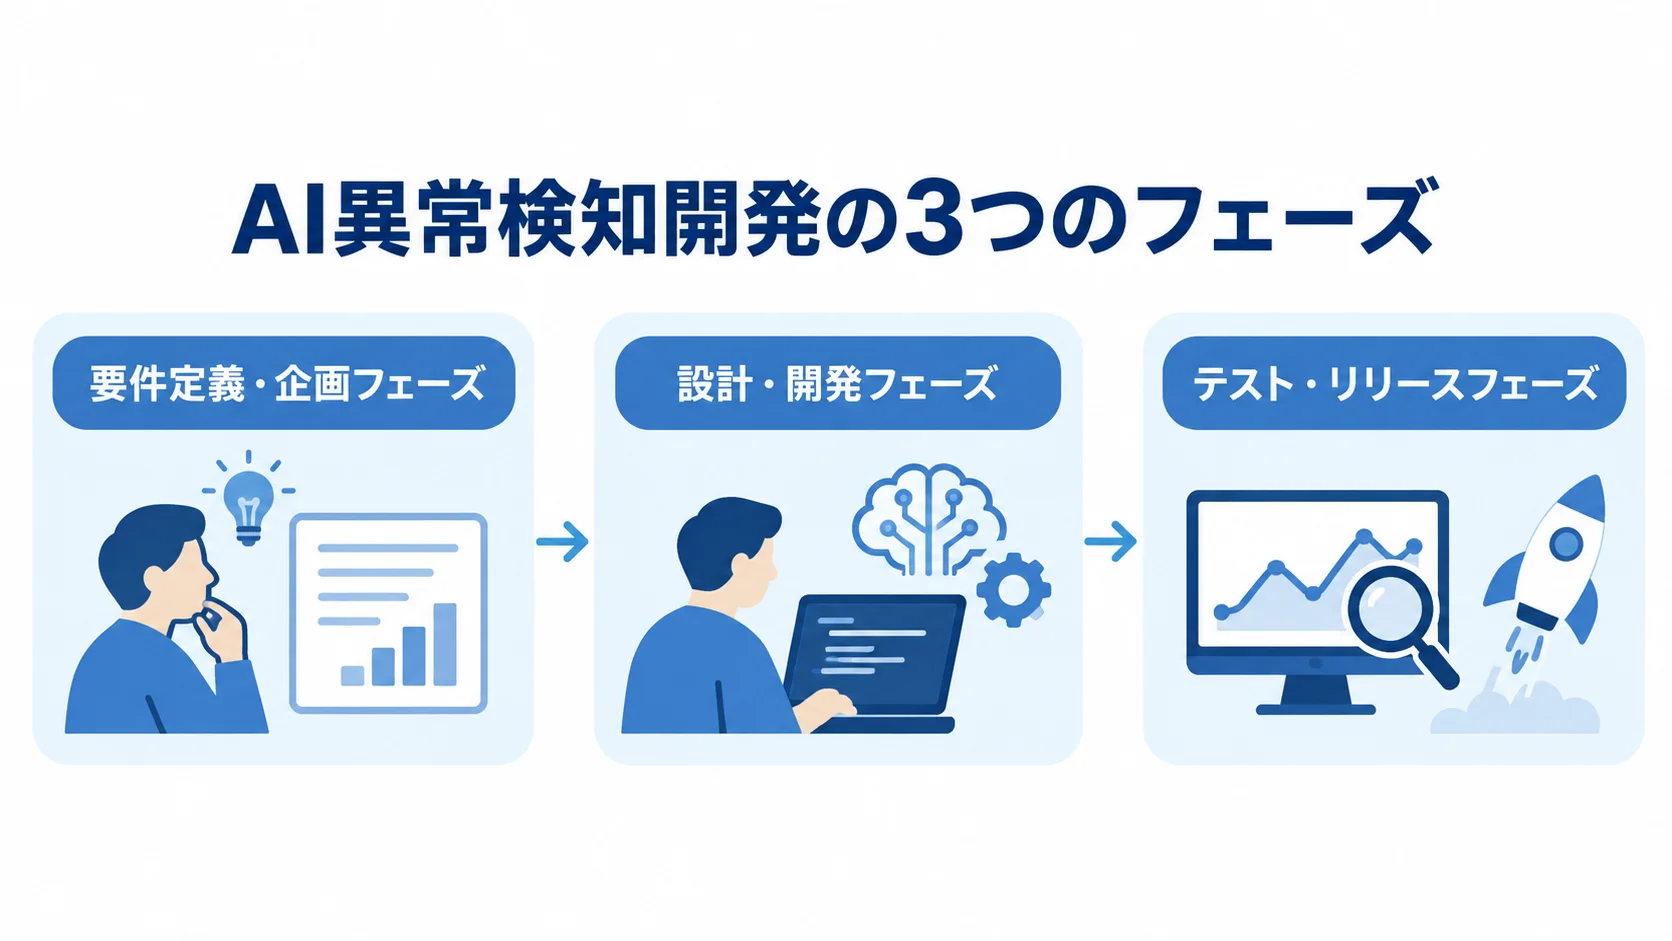
AI異常検知の開発は、大きく「要件定義・企画フェーズ」「設計・開発フェーズ」「テスト・リリースフェーズ」の三段階に分かれます。各フェーズで適切な成果を出せないと、後工程で手戻りが起き、コストと時間が大きく膨らみます。そのため、順を追って丁寧に進めることが成功の鍵になります。
要件定義・企画フェーズ
要件定義フェーズでは、「何を検知したいのか」「検知結果をどう業務に活かすのか」を徹底的に明確にします。異常の定義が曖昧なまま進めると、完成したシステムが現場で使われずに終わるという失敗に直結します。まず解決すべき課題を、「プレス機の主軸振動データから破損の前兆を1時間前に検知したい」「決済ログから不正送金パターンを0.1秒以内に検出したい」といった水準まで具体化します。
次に、センサーデータ・カメラ映像・サーバーログ・業務システムのトランザクションログなど、対象となるデータソースを洗い出し、蓄積量・フォーマット・品質を確認します。一般的に、AIモデルの学習には最低でも数千件から数万件の正常サンプルが必要とされ、データが不足している場合は、データ収集インフラの整備から着手する必要があります。
この段階で、PoC(概念実証)を小規模に実施することも検討に値します。PoC費用は40万〜100万円程度が相場で、本格開発の前に技術的な実現性を確かめることで、失敗リスクを大幅に下げられます。さらに、関係部署を巻き込み、KPI(例:誤検知率5%以下・見落とし率1%以下)を設定してから次のフェーズに進むことが重要です。
設計・開発フェーズ
設計・開発フェーズは、前処理からモデル学習・評価・組み込みまでを含む、もっとも工数の大きい段階です。最初に取り組むのは前処理で、欠損値・外れ値・ノイズを除去し、スケーリングや特徴量エンジニアリングを施して、学習に適した形に整えます。実際のプロジェクトでは、前処理に全体工数の40〜60%が費やされるといわれ、質の高いデータの準備がモデルの性能を左右します。
前処理のあとは、検知対象のデータ特性に応じた複数の候補を試し、次の作業を順に進めます。
- 候補アルゴリズム:Isolation Forest・オートエンコーダ・LSTM(長短期記憶ネットワーク)・One-Class SVMなどを試験的に実装
- 評価と採用:AUC・F1スコア・再現率・適合率で比べ、もっとも適切なアルゴリズムを採用
- 連携先の設計:精度が要件を満たしたあと、既存の業務システムやIoTプラットフォームへの組み込み
NECやNTTなどの大手ベンダーは独自のAIフレームワークを持ちます。一方で、オープンソースのPython・scikit-learn・PyTorchを使えば、コストを抑えることも可能です。
組み込みの構成は、リアルタイム処理が求められる場合はエッジコンピューティング構成、大量のバッチ処理が中心ならクラウドサーバー構成が適しています。開発費用は規模によって異なり、AIモデル開発だけで80万〜250万円×人月、システム開発部分で60万〜200万円×人月程度が目安とされています。
テスト・リリースフェーズ
テスト・リリースフェーズでは、開発したシステムを実際の業務環境に近い条件で検証し、品質を担保してから本番リリースに臨みます。テストは、単体テスト・統合テスト・受け入れテスト(UAT)の三段階で進むのが一般的です。単体テストではデータパイプラインやAPIの動作を、統合テストでは既存システムとの連携やアラート通知の流れを確かめます。
受け入れテストでは、現場の担当者が実際に操作し、要件定義で設定したKPIを満たしているかを検証します。ここで大切なのが「誤検知率と見落とし率のバランス」です。誤検知が多すぎると現場が警告に慣れてしまい(アラートの疲弊)、本物の異常を見落とす危険性が高まります。
また、検知感度を上げすぎると正常な状態を異常と誤判定するケースが増えるため、現場の運用に合う閾値の調整が必要です。本番後の初期運用(通常1〜3か月)は、実データでモデルを微調整するキャリブレーション期間で、開発会社との密な連携が推奨されます。誰がアラートを受け取り、どう初動対応するかを事前に決めておくことが、導入を業務改善に結びつけるうえで不可欠です。
費用相場とコストの内訳
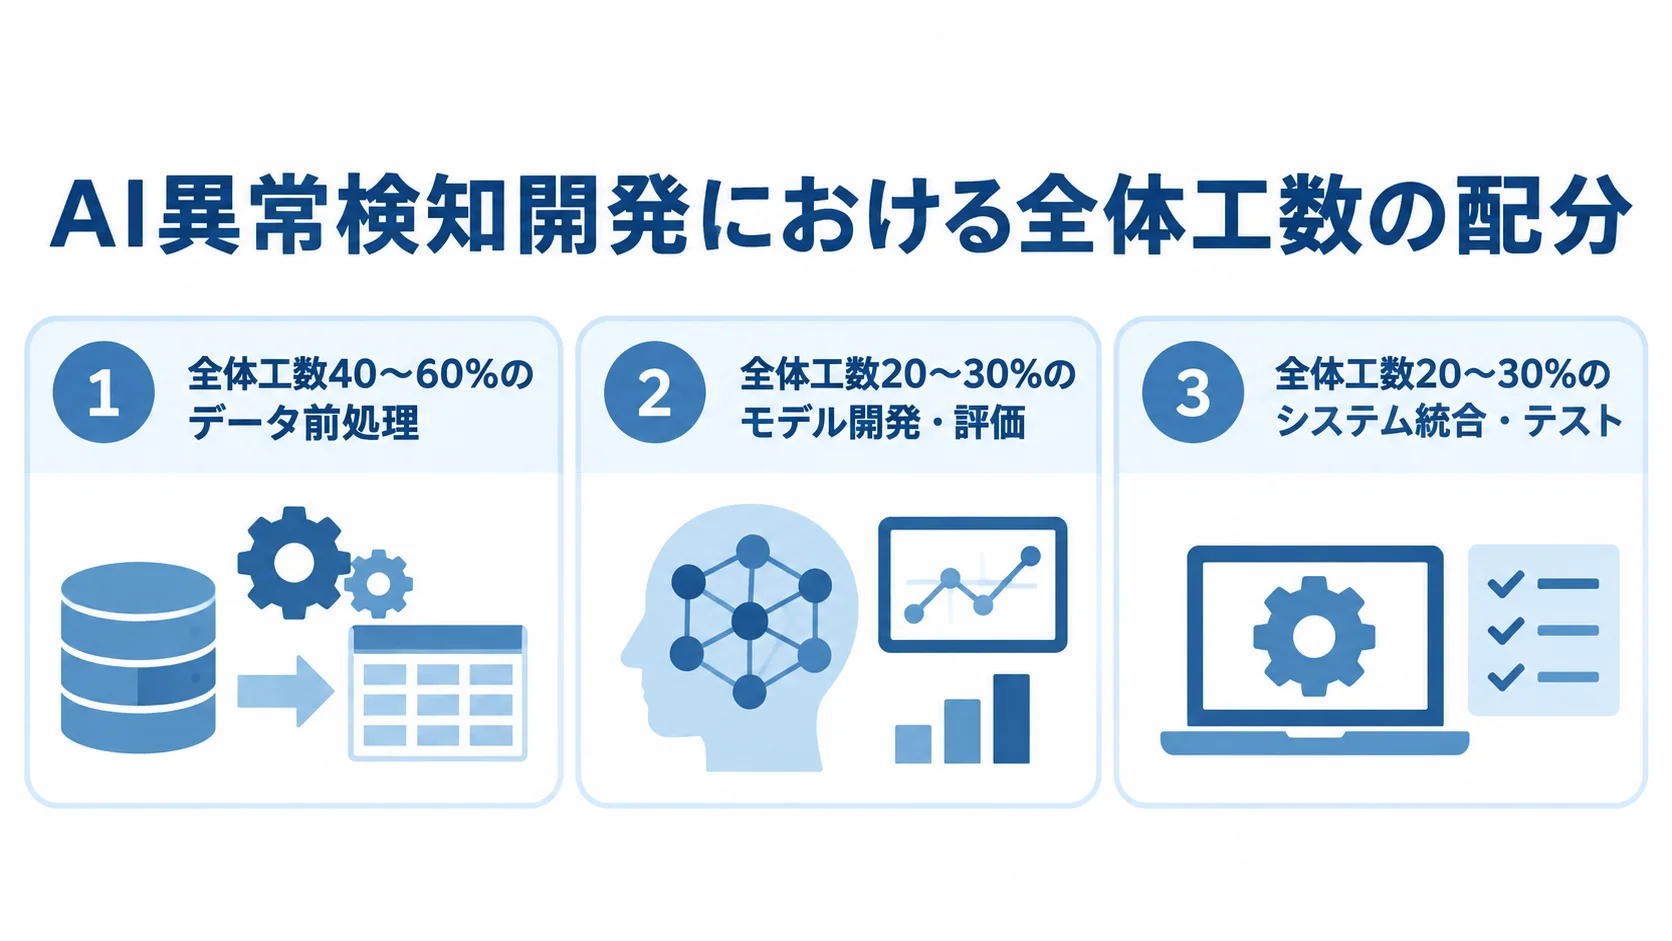
AI異常検知システムの開発費用は、要件の複雑さ・データ量・リアルタイム性の要求・導入環境などによって大きな幅があります。「画像分類の単純な異常検知なら300万円程度」から「大規模工場向けのフルスクラッチ開発では1,000万〜2,000万円以上」まで、プロジェクトの内容によって数倍の差が生まれます。
クラウドサービスを活用したパッケージ型であれば、初期費用数十万円・月額数万円から始められるケースもあります。そのため、自社の要件に合った調達方法を選ぶことが、コストの最適化につながります。
人件費と工数
AI開発費用の60〜70%を占めるのは、もっとも大きな要素である人件費です。人件費は、どの職種をどれだけ投入するかで決まり、単価は職種ごとに違います。
- データサイエンティスト:月額80〜150万円
- MLエンジニア(機械学習エンジニア):月額70〜120万円
- バックエンドエンジニア:月額60〜100万円
- プロジェクトマネージャー:月額80〜130万円
このほか、コンサルティングフェーズで40万〜200万円、PoC実施で40万〜100万円、プロトタイプ作成で100万〜数百万円の費用が生じます。AIモデル開発には80万〜250万円×人月、システム開発・インフラ構築には60万〜200万円×人月がかかり、これらが積み上がっていきます。
シンプルなセンサーデータの統計的異常検知なら、全体で300万〜500万円程度のコンパクトなプロジェクトで完結することもあります。
一方、画像認識を組み合わせた外観検査AIや、複数拠点対応のリアルタイム監視システムになると、1,000万〜3,000万円規模の開発費用を見込む必要があります。工数の配分は、データ前処理に全体の40〜60%、モデル開発・評価に20〜30%、システム統合・テストに20〜30%というのが一般的で、データ品質が低い場合は、データ整備の工数がさらに増えます。
初期費用以外のランニングコスト
AI異常検知は、導入した後も継続的なランニングコストが発生します。代表的な項目は、クラウドサーバーやGPUの利用料金・モデルのメンテナンス・再学習費用・アラートチューニング費用・保守サポート費用です。クラウド利用料は、小規模システムで月額数万円、大規模システムでは数十万〜数百万円規模に達することがあります。
モデルのメンテナンスと再学習には、月額50万〜200万円程度が目安です。AIモデルは運用を続けるなかで、データの傾向が変わって精度が徐々に下がる「モデルドリフト」が起きます。例えば、製造ラインの稼働条件が季節変動する工場では、半年〜1年周期で再学習が必要になるケースが多く報告されています。
このため、初期開発費用と同等以上のランニングコストが3〜5年で積み上がることを前提に、総保有コスト(TCO)の視点で予算を立てることが重要です。コストを抑える方法としては、まずパッケージ型・SaaS型のAI異常検知サービスを検討することが有効です。初期投資を最小限にとどめながら短期間で効果を検証できるため、リスクを抑えてスモールスタートで始められます。
見積もりを取る際のポイント
AI異常検知の開発会社から適切な見積もりを得るには、発注側が事前に情報を整えることと、見積もりの中身を評価する視点を持つことが欠かせません。準備が不足したまま相談すると、概算の見積もりしか出てこず、開発を始めてから追加費用が発生するリスクが高まります。
要件明確化と仕様書の準備
見積もり精度を高めるために、発注側が事前に整理しておくべき情報は四つあります。第一は「検知対象と異常の定義」で、「何のデータから、どのような状態を、どのくらいの感度で検知したいか」を言語化しておきます。可能であれば、異常事例のサンプルデータや過去のインシデントレポートも用意しておくと、開発会社との認識のずれを防げます。
第二は「利用可能なデータの仕様」で、データの種類(センサー数値・画像・テキストログ)や、蓄積期間・サンプル件数・フォーマット・収集頻度を一覧にしておきます。一覧があれば、開発会社は工数を正確に見積もれるようになります。第三は「検知精度の要件(KPI)」で、再現率・適合率・レイテンシ(リアルタイム性)の目標値を定量的に示します。
第四は「既存システムとの連携要件」で、ERPや生産管理システム・監視ダッシュボードとの連携方法、APIの形式、デプロイ環境(オンプレミスかクラウドか)を明確にします。これらを仕様書にまとめてから相談すると、開発会社から精度の高い見積もりを引き出せるうえ、発注後のトラブル防止にもつながります。
複数社比較と発注先の選び方
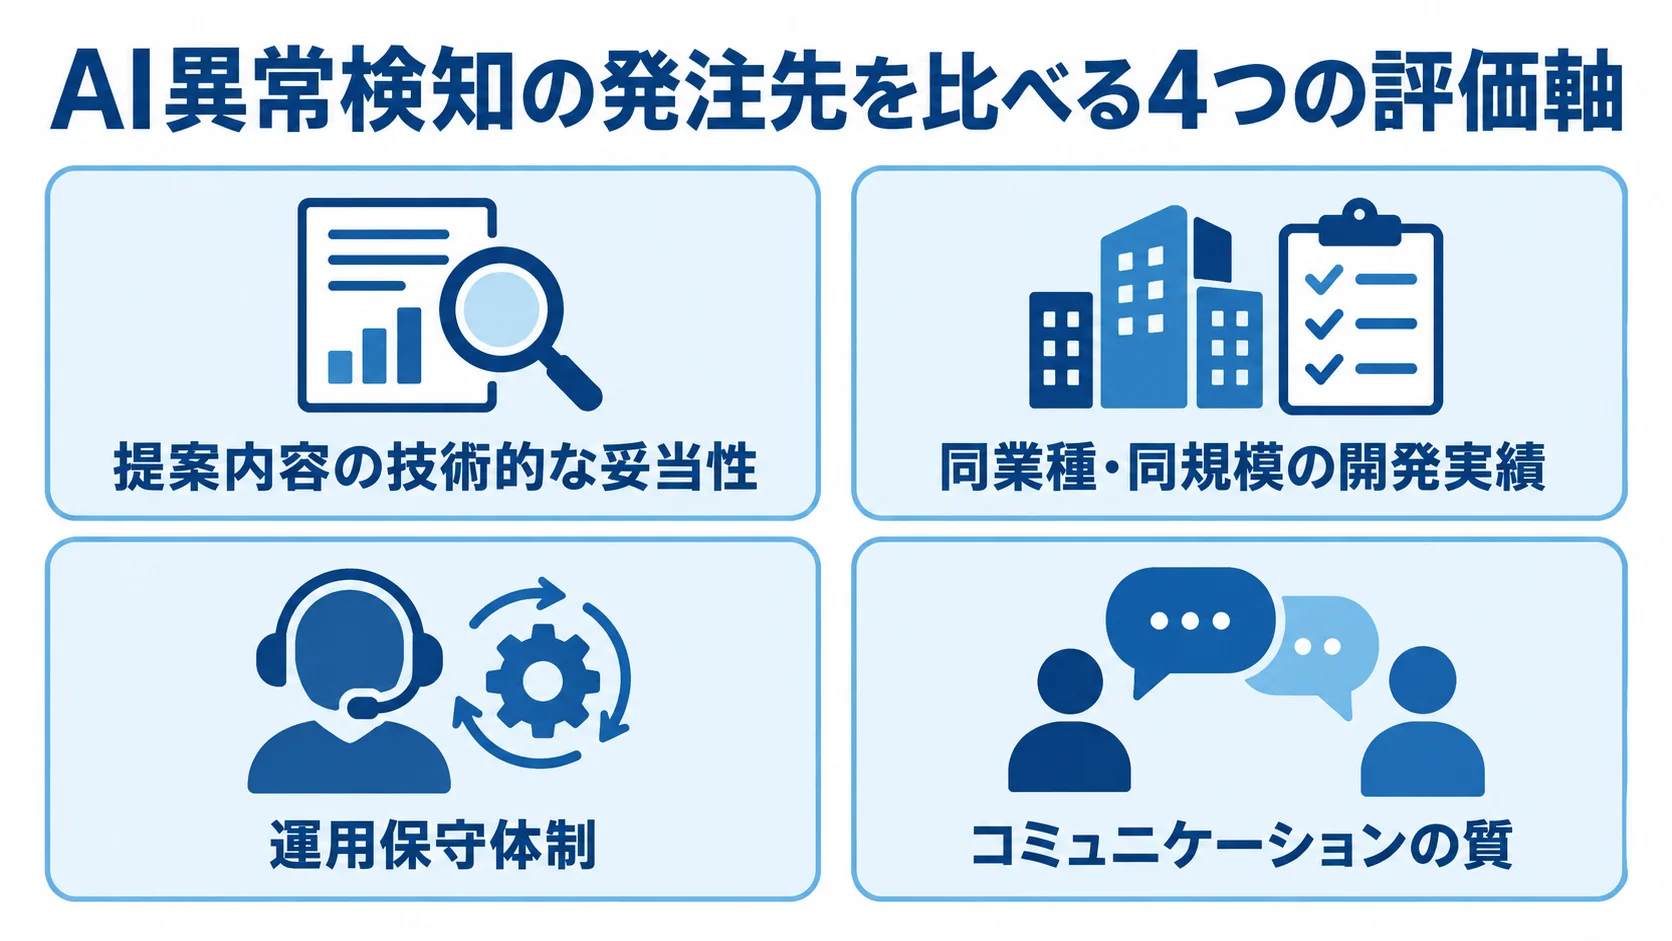
AI異常検知の開発会社は、少なくとも3社から見積もりを取り、比較するのが基本です。金額だけでなく、次の四つの軸で評価することが求められます。
- 提案内容の技術的な妥当性:提案されたアルゴリズムが自社のデータ特性に合うか、評価指標の設定を確かめる
- 同業種・同規模の開発実績:製造業・金融業・インフラ業など、自社に近い業種の導入事例があるか
- 運用保守体制:導入後の保守を、どこまで担ってもらえるか
- コミュニケーションの質:金額とあわせて比べる、担当者との意思疎通のしやすさ
データサイエンティストの実務経験年数や保有資格(AWS Machine Learning Specialty・Google Professional ML Engineerなど)も判断材料になります。業種によってデータの性質や「異常」の定義が異なるため、業種知識のある会社のほうが、プロジェクトをスムーズに進められます。
また、フルスクラッチ開発・ハイブリッド開発(既存パッケージのカスタマイズ)・SaaS活用など、複数の開発手法に対応できる会社を選ぶと、予算や開発期間に応じた最適な手法を提案してもらえます。運用保守については、「導入後のモデル再学習の時期」「アラートチューニングのサポート範囲」「SLAの水準」を事前に確かめ、契約書に明記してもらうことをお勧めします。
注意すべきリスクと対策
一つ目は「データ不足・データ品質の問題」です。AIモデルの学習には一定量以上の高品質なデータが必要ですが、現場では「センサーが3か月前にしか設置されていない」「ログが欠損だらけ」といったケースが少なくありません。対策としては、要件定義の段階でデータの実態を正直に開発会社へ開示し、データ収集インフラの整備にかかるコストと期間をスコープに含めることが必要です。
二つ目は「スコープクリープ(要件の際限ない追加)」で、開発中に要望が増えると、費用と期間が当初見積もりを大きく超えることがあります。これを防ぐには、開発前に機能要件を文書化し、変更管理プロセスを設けることが有効です。三つ目は「精度目標の未達」で、異常検知AIは100%完璧な検知が保証されず、誤検知率と見落とし率はトレードオフの関係にあります。
過大な期待を持って導入すると、運用後に「使えない」という評価に直結するため、PoC段階で達成可能な精度目標を現実的に設定することが大切です。四つ目は「ベンダーロックイン」で、特定の会社や製品に依存しすぎると、乗り換えや内製化が困難になります。ベンダーロックインを避けるには、データやモデルの所有権を契約で明確にし、オープンソース技術を活用した開発を基本として検討してください。
まとめ
ここまで、AI異常検知の全体像から開発の進め方、費用相場、見積もりのポイントを見てきました。AI異常検知は、教師なし学習・教師あり学習・半教師あり学習の三つに大別され、Isolation Forest・オートエンコーダ・LSTMなどの中から、自社のデータ特性に合う手法を選ぶことが開発成功の第一歩です。
開発は「要件定義・企画」「設計・開発」「テスト・リリース」の三段階で進み、各フェーズで適切なドキュメントとKPIを整備することが、後工程の手戻りを防ぎます。費用相場は、小規模システムで300万〜500万円、大規模システムで1,000万〜3,000万円以上です。
初期費用に加えてランニングコスト(月額50万〜200万円程度)まで含めた総保有コスト(TCO)の視点で、予算を組むことが大切です。見積もりを取る際は、検知対象の定義・データ仕様・精度要件・既存システムとの連携要件をまとめた仕様書を用意し、3社以上から比較見積もりを取ることをお勧めします。
発注先は、技術力・業種実績・運用保守体制の三軸で評価し、ベンダーロックインを避けるための契約条件も必ず確認してください。AI異常検知の導入を成功させるには、技術面の理解と同時に、「業務オペレーション設計」「KPI設定」「継続的な改善サイクル」の三つを初期から見据えることが欠かせません。
ぜひ本記事を参考に、自社のAI異常検知開発を着実に前進させてください。
▼全体ガイドの記事
・AI異常検知の完全ガイド
開発を相談する前に、以下のホワイトペーパーもご覧ください。
AIシステム開発の完全ガイドブック
【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。