
AI需要予測の開発は、課題と要件を整理する企画、PoCを含む設計・開発、テスト後の段階的な本番運用の順に進みます。各段階で何を決めるかを押さえておくと、現場への定着と精度維持につながります。
▼全体ガイドの記事
・AI需要予測の完全ガイド
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI需要予測の全体像
AI需要予測は、機械学習や深層学習で将来の商品・サービスの需要量を予測する仕組みです。販売実績に加えて、天候・経済指標・SNSのトレンド・競合情報も同時に分析できます。特に、複雑な外部要因を扱える点が、従来の統計手法との違いです。
サッポロビールは、導入後の継続学習によって予測精度を当初比で20%向上させました。
また、衣料品メーカーでは、精度が70%から90%に改善した事例もあります。
開発を成功させるには、まず仕組みと必要な要件を理解することが第一歩です。
AI需要予測の種類と特徴
需要の時間的な動き、外部要因、商品数のどれを重視するかで、適した予測手法は異なります。
- 時系列予測:販売実績の時間的な動きから将来値を推定します。
- 多変量回帰:複数の説明変数を使った需要予測。
- 機械学習アンサンブル:複数モデルを組み合わせ、精度向上を目指します。
時系列予測は、季節性・トレンド・周期性を学習します。代表例はARIMAやLSTMで、販売データが豊富な製品に向いています。
多変量回帰は、気温・曜日・販促状況などを組み合わせて使います。
外部要因の影響が大きい小売業や食品業界で活用されています。
アンサンブルの例には、勾配ブースティング(XGBoost・LightGBM)やランダムフォレストがあります。
大量の商品SKUを扱う製造業や流通業で効果を発揮します。
どの手法にも得意・不得意があるため、業種、データ量、予測対象を踏まえて適切なモデルを選ぶことが重要です。
従来手法との違いと導入メリット
従来はExcelの移動平均や単純な季節調整が主流でした。手作業で集計・加工し、経験則と照らし合わせていたため、属人化や複雑な変動要因への対応が課題になっていました。
手作業の予測からAIに移ると、分析のやり方、担当者の仕事、在庫と発注の作業が変わります。
- 分析の自動化:大量データのパターンを学び、人手による分析の限界を補います。
- 担当者の業務転換:予測作業から離れ、販売戦略や仕入先との交渉に集中できます。
- 在庫・発注の改善:在庫を適切に保てるようになり、発注作業の時間短縮にもつながります。
リアルタイムデータで在庫水準を調整し、過剰在庫を平均20〜30%削減した事例が多数報告されています。
イトーヨーカ堂では、AI発注システムの導入後、対象8,000品目の発注作業時間を約3割削減しました。この削減が、現場の生産性向上にもつながっています。
AI需要予測の進め方
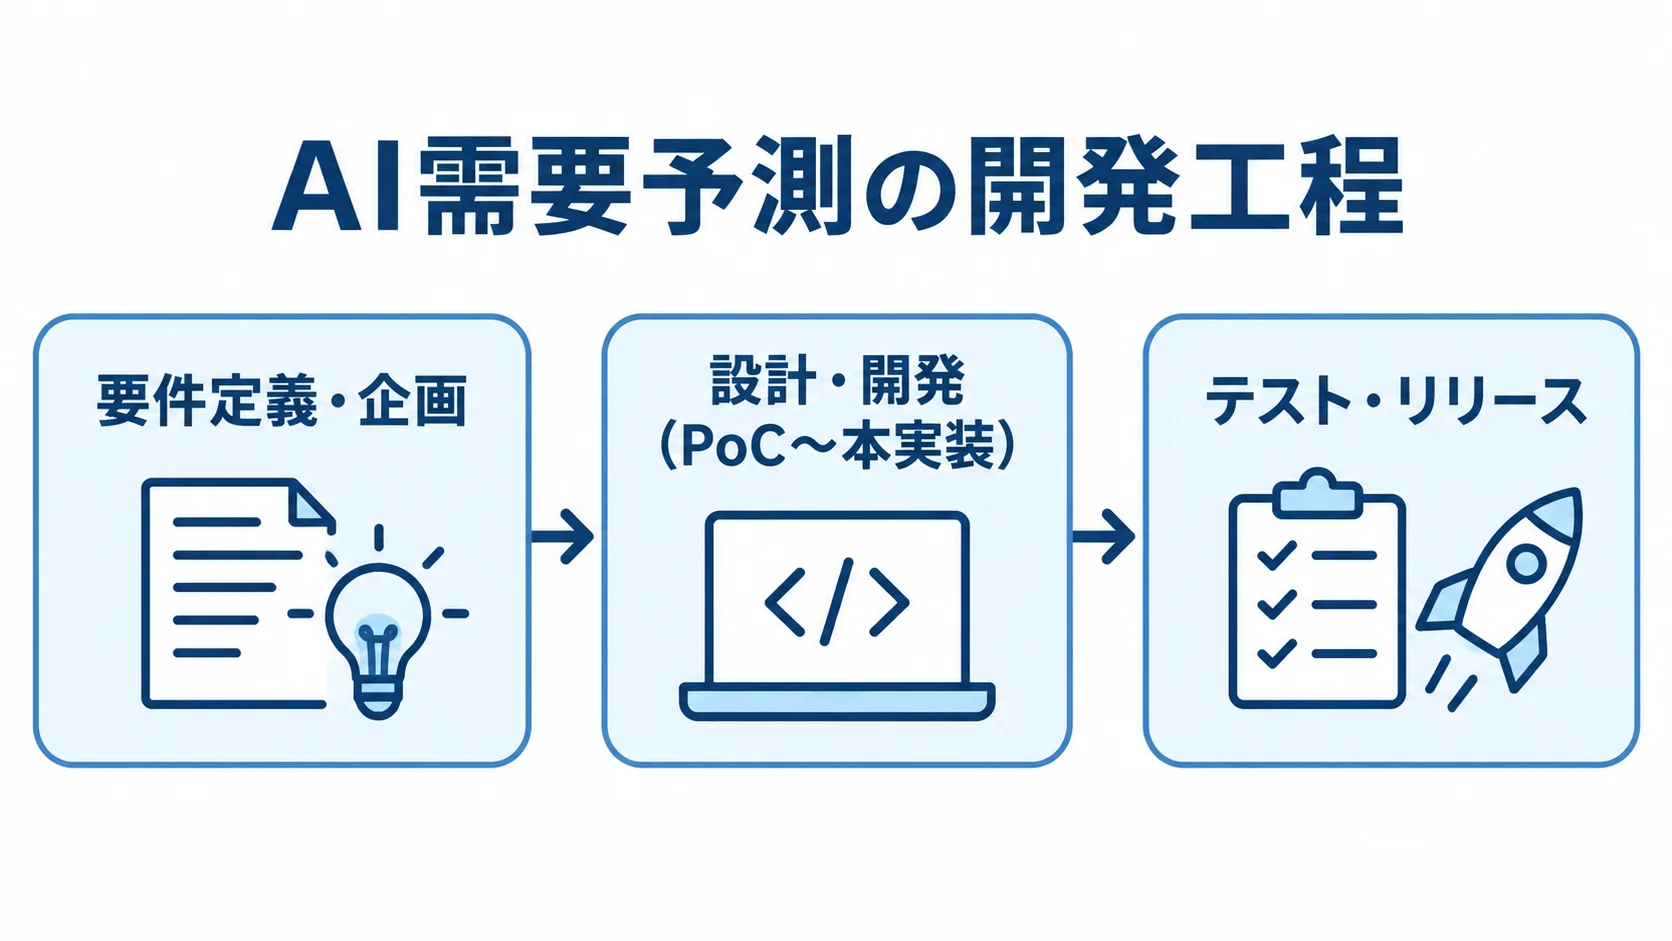
AI需要予測は、システム開発だけでなく、業務改革(BPR)としても進めます。
高精度なモデルを作っても、現場に定着しない可能性があります。そのため、誰がいつ予測値を使い、どの判断に活かすかを決めることが、定着の鍵になります。
企画から本番運用までは、次の3段階に分けて捉えると整理しやすくなります。
- 要件定義・企画
- 設計・開発(PoC〜本実装)
- テスト・リリース
要件定義・企画フェーズ
企画では、AI需要予測を導入する理由を掘り下げ、解決する課題を決めます。課題を数値で捉えられるよう、次の3つの観点で整理しておきます。
- 業務課題:過剰在庫・欠品の損失、発注工数、新商品の立ち上げ精度を把握します。
- データ状況:保管先、期間、粒度、取得できるかどうかを洗い出します。
- 利用方法:連携先システムと、画面・帳票の要件を固めます。
損失金額や工数を数値にしておくと、後の投資対効果を評価する基準がはっきりします。
AI需要予測には、最低でも2年分の時系列データが必要とされます。季節性のある商品では、さらに2シーズン以上のデータを確保することが求められます。データが足りない場合は、外部データの購入や収集体制の整備も企画に含めます。
発注システムやERPへの連携も検討します。
現場担当者が確認する画面や帳票も、この段階で大枠を固めます。
経営層・業務担当者・IT部門が同じゴールを共有しておくことが、この段階の前提です。
設計・開発フェーズ(PoC〜本実装)
要件が決まったら、まずPoC(概念実証)で、モデルが課題を解決できるかを低コストで検証します。作業は次の順で進めます。
- データのクレンジングと前処理
- 複数モデルの試作とバックテスト
- 目標精度の確認後、本番環境へ実装
前処理では、欠損値の補完、外れ値の除去、特徴量エンジニアリングを行います。この工程の品質は、モデル精度を大きく左右します。
販促やキャンペーンによる特需は、モデルを歪める原因になります。対処には、異常値として扱う方法と、フラグ変数にする方法があります。
時系列モデルや機械学習モデルなど複数のモデルを試作し、過去データを使うバックテストで精度を比較します。
精度指標には、MAE(平均絶対誤差)やMAPE(平均絶対パーセント誤差)が一般的です。
適切な精度水準は業種や商品カテゴリによって異なるため、目標達成の見込みを確かめてから本実装へ進みます。
本番では、採用したモデルをインフラに組み込みます。さらに、データ取得から予測、出力までのパイプラインを自動化します。また、発注システムやERPと連携するAPIも開発します。
スクラム開発など短い反復で進めれば、現場の意見を開発に早く反映できます。早い段階でフィードバックを受けられるため、仕様変更に伴うリスクも抑えられます。
テスト・リリースフェーズ
精度と現場の受け入れ状況は、まず小さな範囲で確かめます。確認できた範囲から、対象を広げていきます。
- 限定導入:一部カテゴリや店舗・拠点でパイロット運用します。
- 精度確認:予測値と実績の乖離を調べ、原因を分析します。
- 継続改善:信頼を得た後の対象拡大と、モデルの再学習。
パイロット中は、予測値を参考値として扱い、現場担当者が最終判断を行います。
精度を継続して測り、乖離の大きい商品群を特定します。現場の実感と合わない場合は、ローカルなイベントや競合店の出店などを、モデルが捉えられていない可能性があります。そのため、見落とされた要因を追加の特徴量として組み込めるかを検討します。
市場環境は常に変わるため、モデルは一度つくって終わりではありません。本番展開後は、定期的な再学習(リトレーニング)を仕組みにしておきます。
新しいデータを継続して学習させ、モデルの鮮度を保つことが精度維持の前提です。
2025年6月末に全国500店舗で稼働させたファミリーマートのAI発注システムも、継続学習と運用改善を見据えて設計されています。
費用相場とコストの内訳
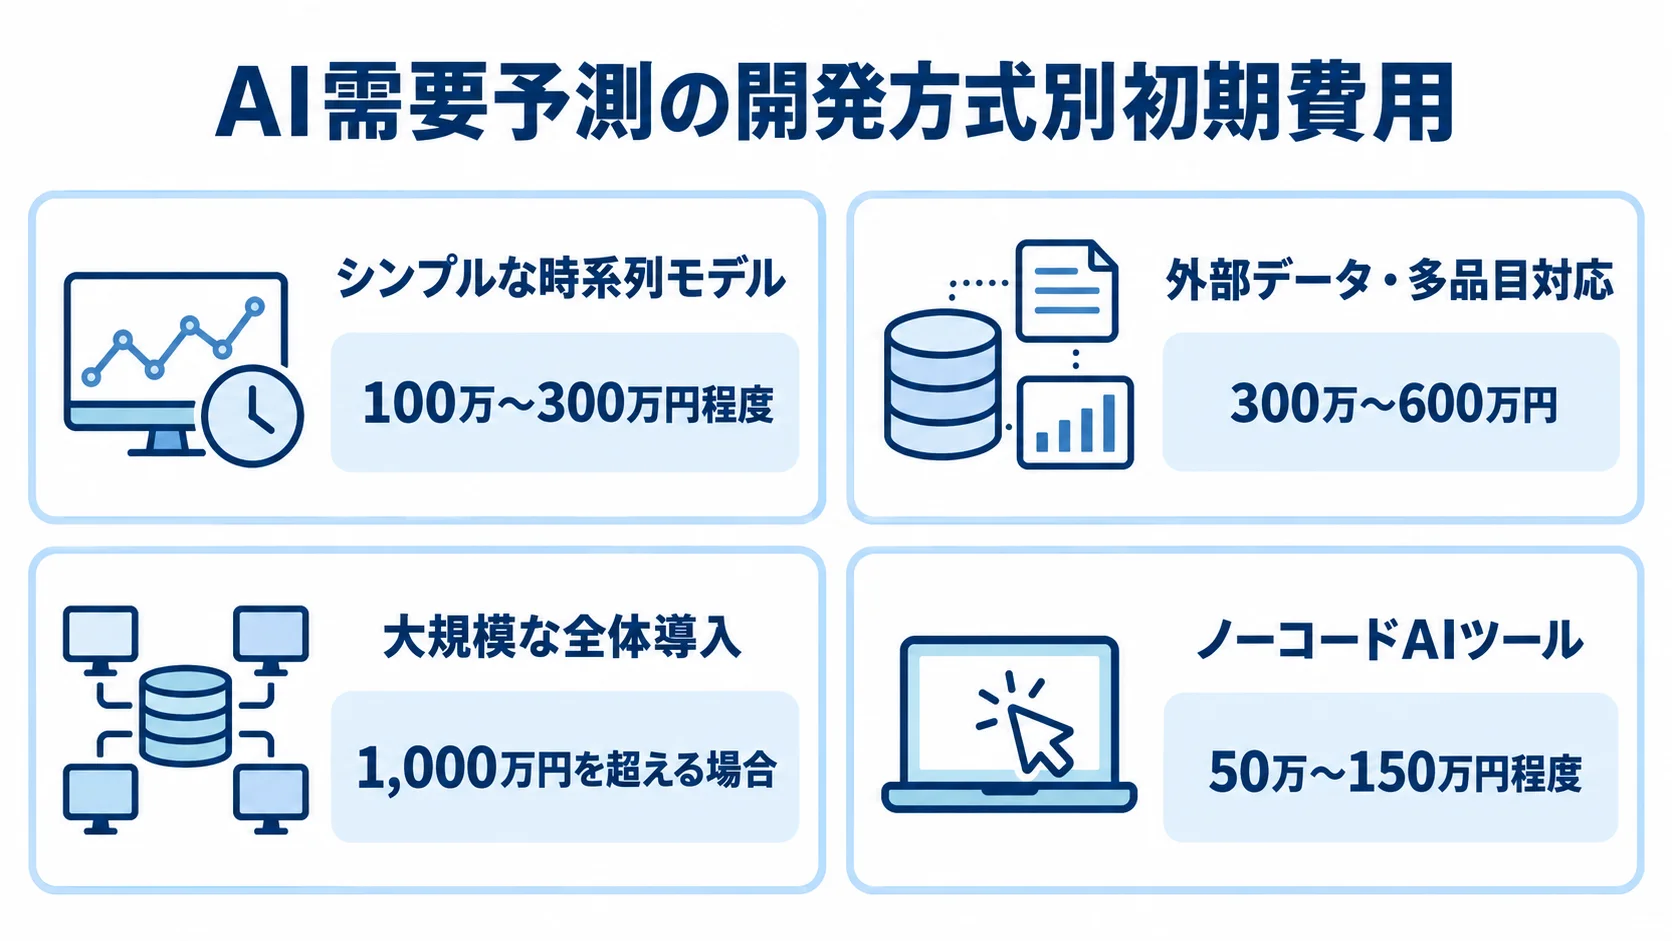
開発費用は、要件の規模・複雑さ・アーキテクチャによって変わります。
予算は、初期費用だけでなく運用中の費用も含めた総額で検討します。
人件費と工数
開発費用の大部分は人件費で、見積もりの基礎になるのは工数です。工数には、データエンジニアや機械学習エンジニア、バックエンドエンジニアに加えて、プロジェクトマネージャーの分も含まれます。
費用の幅はモデルの複雑さや連携範囲で大きく変わるため、代表的な区分ごとの相場を挙げておきます。
- シンプルな時系列モデル:100万〜300万円程度から着手できます。
- 外部データ・多品目対応:300万〜600万円が相場です。
- 大規模な全体導入:1,000万円を超える場合があります。
- ノーコードAIツール:クラウド型なら初期費用50万〜150万円程度の例があります。
外部の気象・経済指標・SNSトレンドなどを取り込み、多品目・多拠点に対応する場合は、上の「外部データ・多品目対応」(300万〜600万円)の区分が当てはまります。
サプライチェーン全体への組み込みや複雑な連携を含む大規模案件では、費用がさらに大きくなります。
データ準備・前処理は、工数全体の30〜40%を占めるケースが多い工程です。形式変換や特徴量設計の品質は、精度に直結します。前処理を軽く見て費用を削ると、後で手戻りが起きるおそれがあります。
ノーコード型は、初期費用を抑えられる一方で、柔軟なカスタマイズや深いシステム連携には限界があります。
初期費用以外のランニングコスト
稼働後は、初期費用とは別に毎月・毎年の支出が続きます。どの項目で費用がかかるかを先に洗い出しておくと、予算の精度が高まります。
- クラウド基盤:AWSやGCPなどの利用料がかかります。
- モデル保守:再学習、精度監視、パラメータ調整の工数が必要です。
- 外部データ:気象APIや経済統計のライセンス費用がかかる場合があります。
- 担当者教育:現場が予測結果を正しく使うための研修を行います。
クラウド基盤の利用料は、月額数万〜数十万円規模です。モデル保守の契約費用も、月額数万〜数十万円を確保しておくのが一般的です。市場が急に変わったときや新商品を追加するときは、モデルの見直しが必要になります。
ライセンス費用は、年間で数万〜数十万円かかるケースがあります。
現場担当者向けの研修費用も、運用予算に含めておきます。
月額費用の合計は数万〜数十万円が目安です。
年間計画では、ランニングコストを初期費用の15〜25%程度と見積もることが推奨されます。
見積もりを取る際のポイント
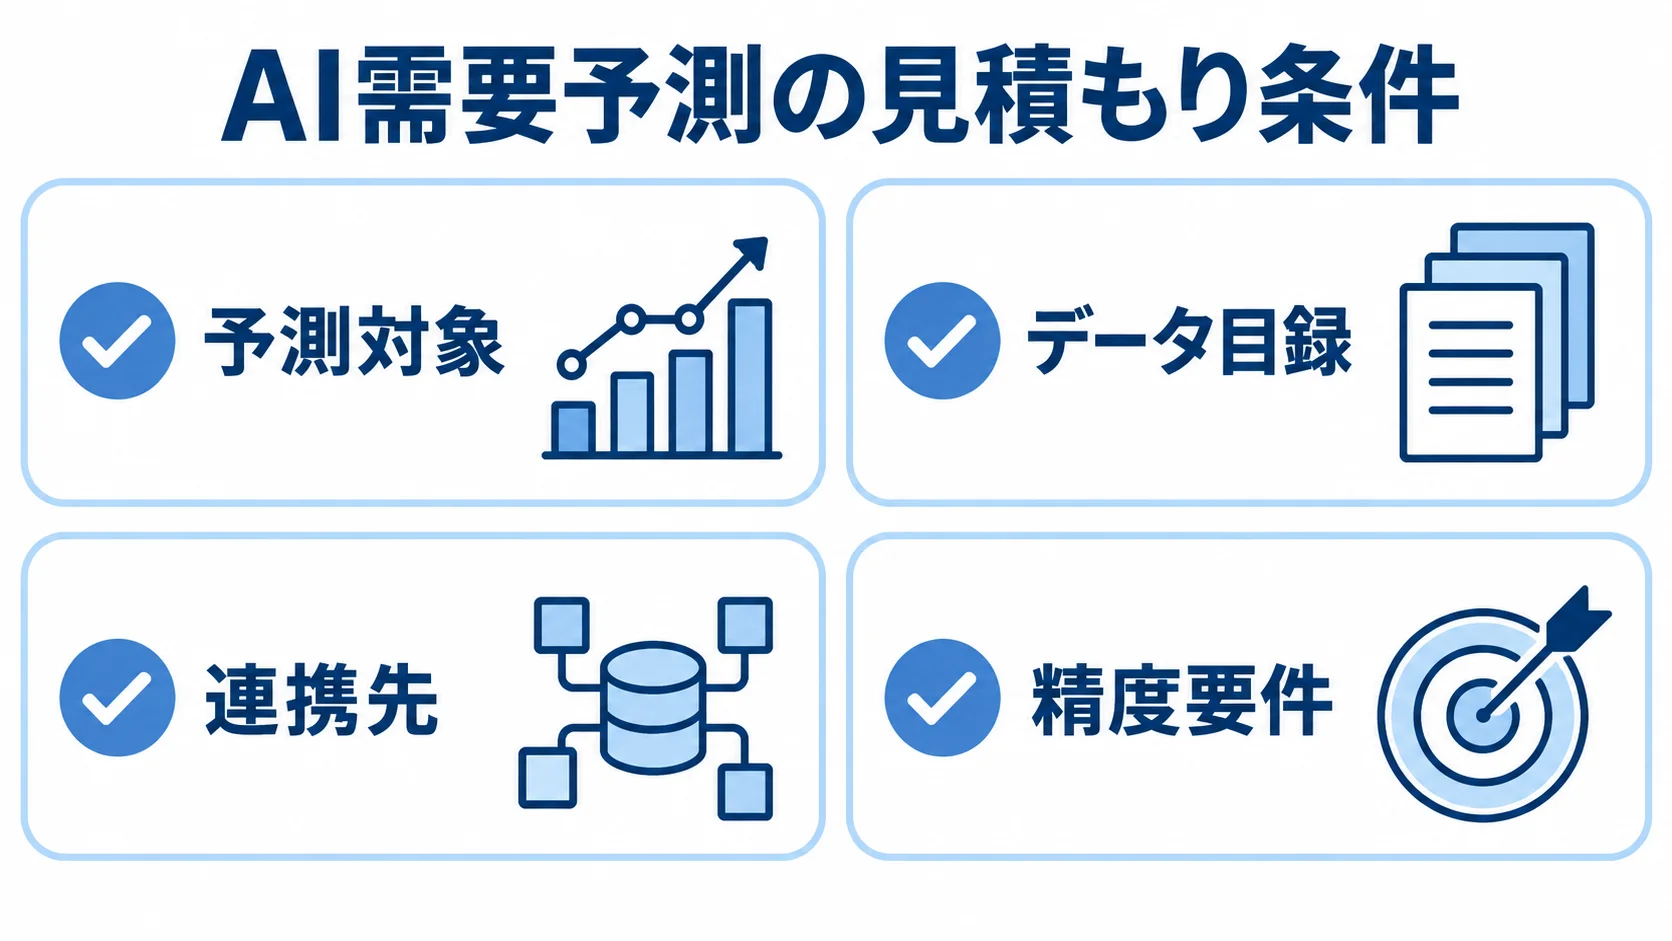
外部ベンダーへの依頼では、見積もりの取り方と発注先の選び方が成否を左右します。要件が曖昧なまま進めると、仕様変更や追加費用、遅延につながりやすいため、事前の準備が欠かせません。
要件明確化と仕様書の準備
予測の粒度、利用データ、既存システムとの接続条件を具体的に決めておくと、各社の見積もりを比較しやすくなります。
- 予測対象:「何を」「どの粒度で」「何期間先まで」予測するかを決めます。
- データ目録:データの種類、形式、期間、量を一覧にします。
- 連携先:API連携に必要なシステム資料を準備します。
- 精度要件:達成水準と検収基準を具体化します。
たとえば「SKU単位で週次の販売数量を4週先まで予測する」と指定すれば、モデル設計と工数を算出できます。
データ目録には、社内データの保管場所や取得できる期間・粒度も書き出します。こうしておくと、前処理工数の見積もり精度が上がります。
発注システム・ERP・在庫管理システムとのAPI連携が必要な場合は、仕様書やAPIドキュメントを準備しておきます。そうすると、連携コストの見積もり精度が上がります。
「MAPE(平均絶対パーセント誤差)15%以内」のような目標を示しておかないと、完成の定義が不明確になり、検収トラブルの原因になります。
ここまでの情報を整理してRFP(提案依頼書)にまとめ、ベンダーに提示します。そうすると、複数社から比較可能な見積もりを得られます。
複数社比較と発注先の選び方
技術力・実績・管理体制を、価格と合わせて評価します。同じ要件で比較すると、提案の違いが見えてきます。
- 業界実績:同業種・同規模での導入経験の有無。
- PoCの提案:本実装前に精度リスクを検証する計画を見ます。
- 説明可能性:予測値の根拠を現場に説明する方法。
- 運用支援:保守や障害対応の担当・窓口を確認します。
3〜5社に同じRFPを送り、提案内容を比較する方法が推奨されます。
経験のある会社は、データ特性や業務との適合、よくある落とし穴を把握しています。
PoCを省いて本実装に進む提案は、精度リスクの管理が不十分な可能性があります。PoCを初期フェーズに置くのかどうかも、確かめておきます。
予測根拠が現場に伝わらないと、「AIの通りに発注して在庫が増えた」という不信につながります。
リリース後のモデル調整や障害対応については、担当者、対応時間、連絡窓口を事前に確かめておきます。
長期的なパートナーとして協力できるかも含め、技術面と支援体制を総合的に見て、発注先を選びます。
注意すべきリスクと対策
見積もりの段階で、ベンダーと起こりやすい問題を共有し、それぞれの予防策を話し合っておきます。
- データ不足・品質:発注前に共同でデータアセスメントを行います。
- PoCの長期化:期間・評価基準・精度目標を契約に記します。
- 現場定着:現場担当者を開発に巻き込み、研修を含めます。
- モデル陳腐化:再学習と評価の仕組みを設計します。
必要な期間のデータがない、形式が不統一、欠損が多いと、整備工数が膨らみ予算超過につながることがあります。
条件を変えれば精度が上がるという期待から検証が終わらず、本番に移せない状態を「PoC沼」と呼びます。これを防ぐには、合否判定の基準を前もって決めておくことが対策になります。
現場が使わなければ、精度が高くても投資対効果は得られません。そのため、開発段階から現場のキーパーソンを巻き込み、使いやすい画面の設計や操作研修も開発の範囲に含めます。
市場や顧客行動の変化は、モデル精度を劣化させる要因になります。対策を提案書に明記してもらうと、透明性と信頼性が格段に高まります。
まとめ
AI需要予測は、課題とデータを整理し、PoCで確かめてから本番運用へ進めることが大切です。
導入後も、現場への定着と継続的な改善が欠かせません。
シンプルなモデルは100万〜300万円程度から着手できます。複雑な要件では600万〜1,000万円以上となる場合があります。
年間の予算には、初期費用の15〜25%程度をランニングコストとして含めます。
RFPを使って、複数社の技術力・実績・保守体制を比較します。
データ品質、PoCの期間、現場定着への対策を発注前に決めておくと、プロジェクトのリスクを抑えられます。
自社の課題とデータ状況を整理し、パートナーと改善を続けることで、予測精度と業務価値を高められます。
▼全体ガイドの記事
・AI需要予測の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。