
生成AIシステム開発の期間は、規模によって1か月から12か月以上まで幅があります。その長さは、ユースケースの範囲、既存システムとの連携数、求める出力品質で変わります。
生成AIは品質を試すまで工数を見積もりにくいため、工程の配分やデータ整備の期間も確認しておく必要があります。
▼全体ガイドの記事
・生成AIシステム開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
生成AIシステム開発の開発期間の全体像
ChatGPTの登場以降、GPT・Claude・GeminiといったLLM(大規模言語モデル)を業務に組み込む生成AIシステムの開発が広がっています。たとえば、社内文書からの回答や議事録・契約書の要約を実現できます。ほかにも、次のような用途があります。
- メールや提案書の作成
- コードの生成
- 画像・デザイン素材の生成
RAG(検索拡張生成)やAIチャットボットは実装パターンの一例です。また、どの型でも、LLM選定やプロンプトエンジニアリングに加えて、ファインチューニングやガードレール(ハルシネーション対策)が共通の論点になります。
全体では1か月〜12か月以上の幅があり、どこに当たるかは、ユースケースの範囲、既存システムとの連携数、求める出力品質と精度によって大きく変わります。文章生成や要約を既製SaaSやノーコードツールで始める構成なら、数週間で立ち上げられます。一方で、複数のAIが連携し、基幹システムとも統合する大規模構成では、1年近くかかることもあります。
要件が固まっても、生成AIの工数は機械的に見積もれるとは限りません。実データを使うまで期待する品質が出るかは分からず、その不確実性が期間の幅を広げます。そのため、まず規模別の目安を見て、自社の構成がどの範囲に当たるかを把握することが、現実的な計画の第一歩になります。
開発期間の見積もりが難しい理由
生成AIの開発期間は、設計で確定する作る工数に加えて、品質達成までの調整工数も含めて見積もる必要があります。
- 品質の依存先:完了の判断は、コードの完成ではなくLLMの出力品質に基づき、入力データやプロンプト、業務の性質に左右されます。
- 品質の不確実性:一般の開発は仕様どおりに実装すれば完了ですが、生成AIは出力が揺らぐため、期待する精度を安定して出せるかは試すまで分かりません。
- 反復調整:文章生成や要約、コード生成は、何度も手を入れて仕上げる必要があります。作る工数に加えて、品質に届くまでの調整工数も見込みます。
この特性を見ないまま納期を先に固定すると、品質が出ないまま手戻りが重なり、大幅な遅延につながることがあります。
規模別の開発期間の目安
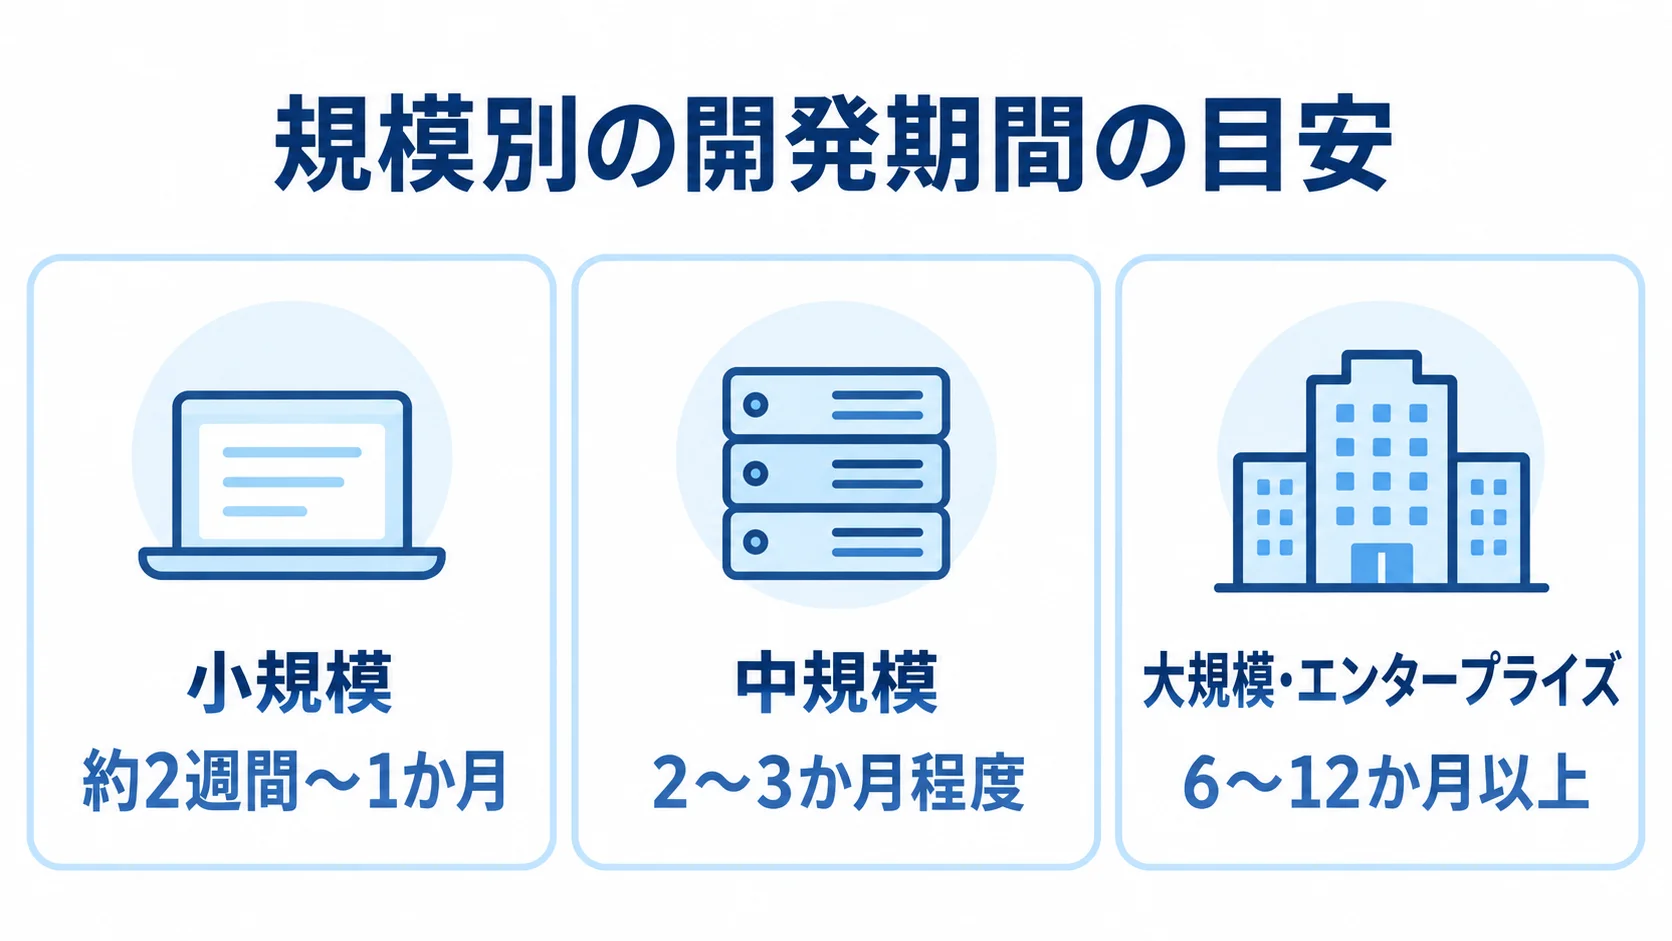
期間の目安は、構成の規模によって異なります。想定する連携先とAIの数をもとに、近い規模を確認しておくと計画の出発点になります。
- 小規模:単一の用途を既製SaaSやDifyなどで作る構成で、期間は約2週間〜1か月です。
- 中規模:単一のAIが社内DBやAPI、CRM・会計ソフトと連携する構成で、2〜3か月程度です。
- 大規模・エンタープライズ:複数のAIや基幹システムとの連携、厳格なセキュリティ要件を含む構成で、6〜12か月以上です。
小規模でも、簡易なFAQ応答や定型文生成のプロトタイプであれば、ノーコードツールで数時間から数日で作れることもあります。
中規模は、AIが業務タスクを実行する標準的な構成です。連携先が増えるほど、データ受け渡しの仕様調整と連携テストに時間がかかります。
大規模では、計画・リサーチ・実装・レビューをそれぞれ担う複数AIのマルチエージェント構成や、SAPなどの基幹システムとの統合が含まれます。
Microsoftの調査では、データ基盤やセキュリティを事前に整えた成功企業は、平均6か月未満で導入を完了しています。これに対し、準備が不足した企業は9か月以上かかる傾向があるとされています。
この差の多くは技術的な難しさではなく、事前準備の充実度によって生まれるとされています。そのため、計画の段階で準備の状況を確かめることが大切です。
要件定義からリリースまでの工程別スケジュールと期間配分
標準的な工程は5つあり、要件定義と設計から始まります。その後は、実装、テスト・品質保証、運用開始・パイロットと進みます。
工程ごとの目安が分かると、開発会社の見積もりや日程が妥当かを判断しやすくなります。シングル構成とマルチ構成の目安を、工程ごとに並べて示します。
シングル構成は1つのAIで完結し、マルチ構成は複数のAIが協調して動きます。どちらの構成でも、ユースケースの見極めとテストでの出力品質の作り込みが全体を左右します。
要件定義・設計フェーズ(前半)
前半では、解決する業務課題とAIが担う範囲を決めます。後工程の作業を見通せるように設計しておくと、日程の見積もりが立てやすくなります。
- 要件定義:シングル構成は2〜4週間、マルチ構成は4〜8週間。
- 設計:シングル構成は2〜4週間、マルチ構成は4〜12週間。
要件定義では、発注側と開発会社が解決したい業務課題を明確にします。そのうえで、AIと人間の担当範囲を分け、ROI(投資対効果)の目標を定めます。
最初から広い業務を対象にせず、効果が見込める1つの用途に絞る「スモールスタート」が鉄則です。たとえば、文章生成や要約、コード生成を一度に求めると、後工程が膨らみます。
設計では、システム全体の構成を決めたうえで、LLMへの役割や根拠、振る舞いの指示を組み立てます。また、ユーザーが操作する画面(UI)も、この段階で形にします。
どのLLMをどの用途に使うか、参照データをどう用意するか、出力をどう検証するかは、後工程の作業量と日程を左右します。
実装・テスト・パイロット運用フェーズ(後半)
設計が固まったら実装へ進みます。後半では品質を確かめ、対象を限定した試行運用を経て本格展開へ移ります。
- 実装:シングル構成は4〜8週間、マルチ構成は8〜24週間。
- テスト・品質保証:シングル構成は2〜4週間、マルチ構成は4〜8週間。
- 運用開始・パイロット:シングル構成は1〜2週間、マルチ構成は2〜4週間。
実装では、LLMを組み込み、外部APIやツールと連携させ、プロンプトを作ります。コードを書く作業と、出力を確かめて直す調整が並行して進むため、単純なアプリ開発より期間を見通しにくくなります。
テストでは、通常の動作や例外処理、セキュリティを確かめます。加えて、意図しない出力やハルシネーション、不適切な生成が起きていないかも検証します。
評価用の質問セットを使って出力品質を数値で測り、基準に届くまでプロンプトやガードレールを調整します。
パイロットでは、限られた環境と利用者に実際に使ってもらい、現場の意見を集めてから本格展開します。想定外の使われ方を先に見つけておくことが、本稼働後の安定につながります。
LLM選定・プロンプト・ファインチューニング・ガードレールが納期に与える影響
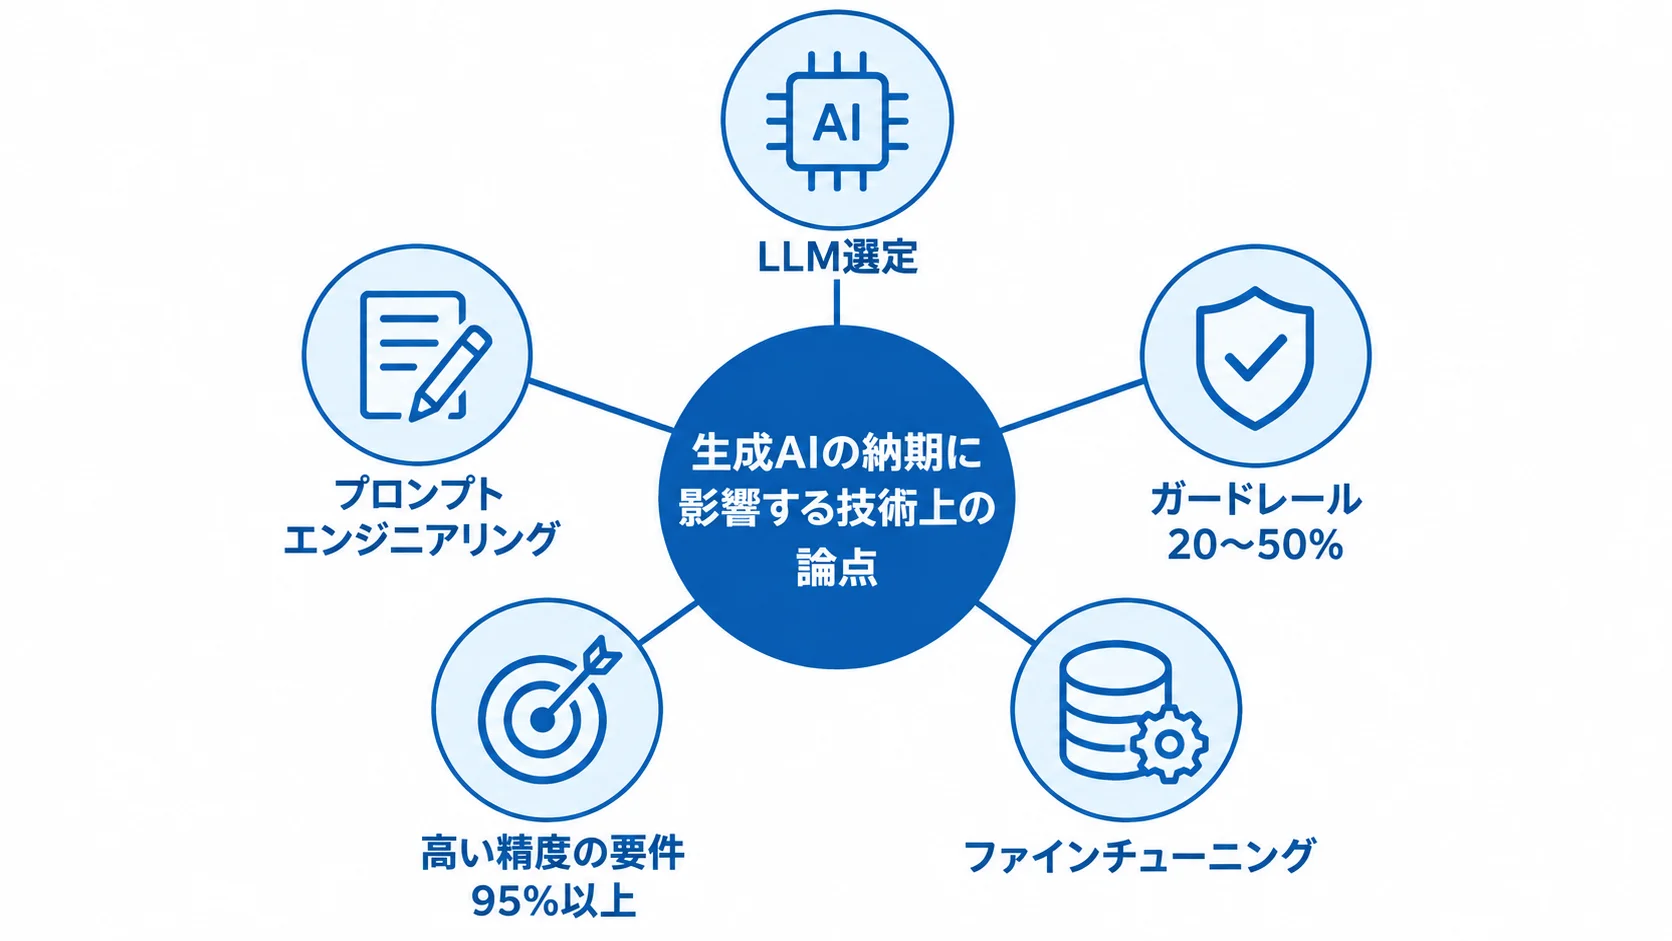
LLMを扱う工程には、反復がつきものです。一般的なアプリ開発は機能の実装をもって完了となりますが、生成AIでは、出力品質が目標に達するまでの反復回数が日程を左右します。期間に直結する技術上の論点は、RAGやチャットボットといった実装パターンを問わず、生成AIシステム開発全般に共通します。
LLM選定とプロンプトエンジニアリングの反復
使うLLMとプロンプトは、品質と期間を左右する上流の設計です。LLMの選び方は、大きく2つの方向に分かれます。
- 商用API:OpenAIのGPT、AnthropicのClaude、GoogleのGeminiなどの外部サービスを使う方式。
- OSSモデルの自社運用:LlamaやQwenなどをオンプレミスやVPC内に置き、自社で運用する方式。
情報漏洩を防ぐためにOSSモデルを選ぶ場合は、GPUインフラの構築やモデルのデプロイに、数週間から数か月が追加で必要になります。どちらの方式でも、プロンプトの反復調整は避けられません。
立場や根拠にする情報、出力方法をLLMに指示するプロンプトは、一度で完成するとは限りません。実データのノイズや想定外の入力に対応するため、実装とテストの期間中、数週間にわたって調整を続けます。この調整は欠かせない工程なので、最初から日程に組み込んでおきましょう。
ファインチューニングとガードレール・ハルシネーション対策の作り込み
求める品質が高いほど、誤りを防ぐための作り込みが必要になり、期間を押し上げます。とくに誤りが許されない分野では、必要な精度を要件定義の段階で見極めておくことが大切です。
- ガードレール:対象範囲によって、開発工数を20〜50%ほど押し上げるとされています。
- 高い精度の要件:金融・医療などで95%以上を求める場合、テストと改善を頻繁に繰り返すため、時間がかかります。
- ファインチューニング:自社固有の専門用語や文体をモデルに追加学習させる場合、データセットの準備とGPU環境の整備が加わります。
ファインチューニングは、用途によって必要かどうかが分かれます。多くの用途では、プロンプトの工夫や外部データを参照するRAGで十分な品質に届き、短期間で仕上がることもあります。
必要な精度を見極め、過剰な作り込みで納期が膨らむのを避けることが、現実的なスケジュール管理につながります。
開発手法による期間の違いと並行開発による短縮
開発手法や工程の並行方法も、開発期間を左右します。素早く価値を確かめたい場合と、本格運用を見据えて作り込む場合とでは、適した進め方が異なります。
ノーコード/API活用による立ち上げ加速とフルスクラッチ
プロトタイプの速さと、独自要件に応えられる範囲を比べて、検証の段階に合う手法を選びます。
- ノーコード:DifyやMicrosoft Copilot Studioを使い、数時間から数日で試作できる。
- フルスクラッチ:LangGraphやCrewAIで独自のロジックを組み、複雑な要件に対応する。
ノーコードはGUI操作が中心で、テンプレートや標準機能の範囲であれば、専門のエンジニアがいなくても着手できます。本番導入までは1〜3か月程度が目安です。
フルスクラッチはコードで独自のロジックやワークフローを組み立てるため、本番導入までに3〜12か月を要します。一方で、複雑な条件分岐や例外処理、複数のAPI連携にも無制限に対応できます。
マルチエージェント開発では、CrewAIを使うとPoCの開発速度をLangGraph比で約40%短縮できるというデータもあります。ツールの選定そのものが、期間に影響します。
まずノーコードやAPI活用で検証用のシステムを立ち上げ、効果と課題をつかむ進め方があります。品質や制御の限界が見えた段階でフルスクラッチへ広げれば、初期の速さと本番品質を両立できます。
並行開発によるクリティカルパスの短縮
スケジュールを縮めるには、工程を並行して進めることが効果的です。たとえば、データ整備の完了を待つ間に、サンプルデータで開発を始められます。
- サンプルを先に用意:きれいなデータ数件やダミーデータを使い、LLMの組み込みとプロンプト設計を進める方法。
- 担当を分ける:入力データの整備と、画面表示・出力形式の実装を別の人が並行して進める方法。
社内データをAI-Readyにするクレンジングは、しばしば最も時間のかかる工程です。その完了を待ってからパイプラインの開発を始めると、作業が一列に並び、期間が伸びてしまいます。パイプラインができた時点で、整備済みの本番データをまとめて投入できれば、数週間から1か月分の工数を短縮できます。
生成AIの品質は、入力データやプロンプトの品質と、出力の見せ方や後処理に分けて扱えます。前者の整備を待たずに後者を進められる点が、並行開発の土台になります。クリティカルパスになりやすいデータ整備の周辺工程を先に動かすことが、無理のない納期短縮につながります。
納期遅延の典型要因と対策
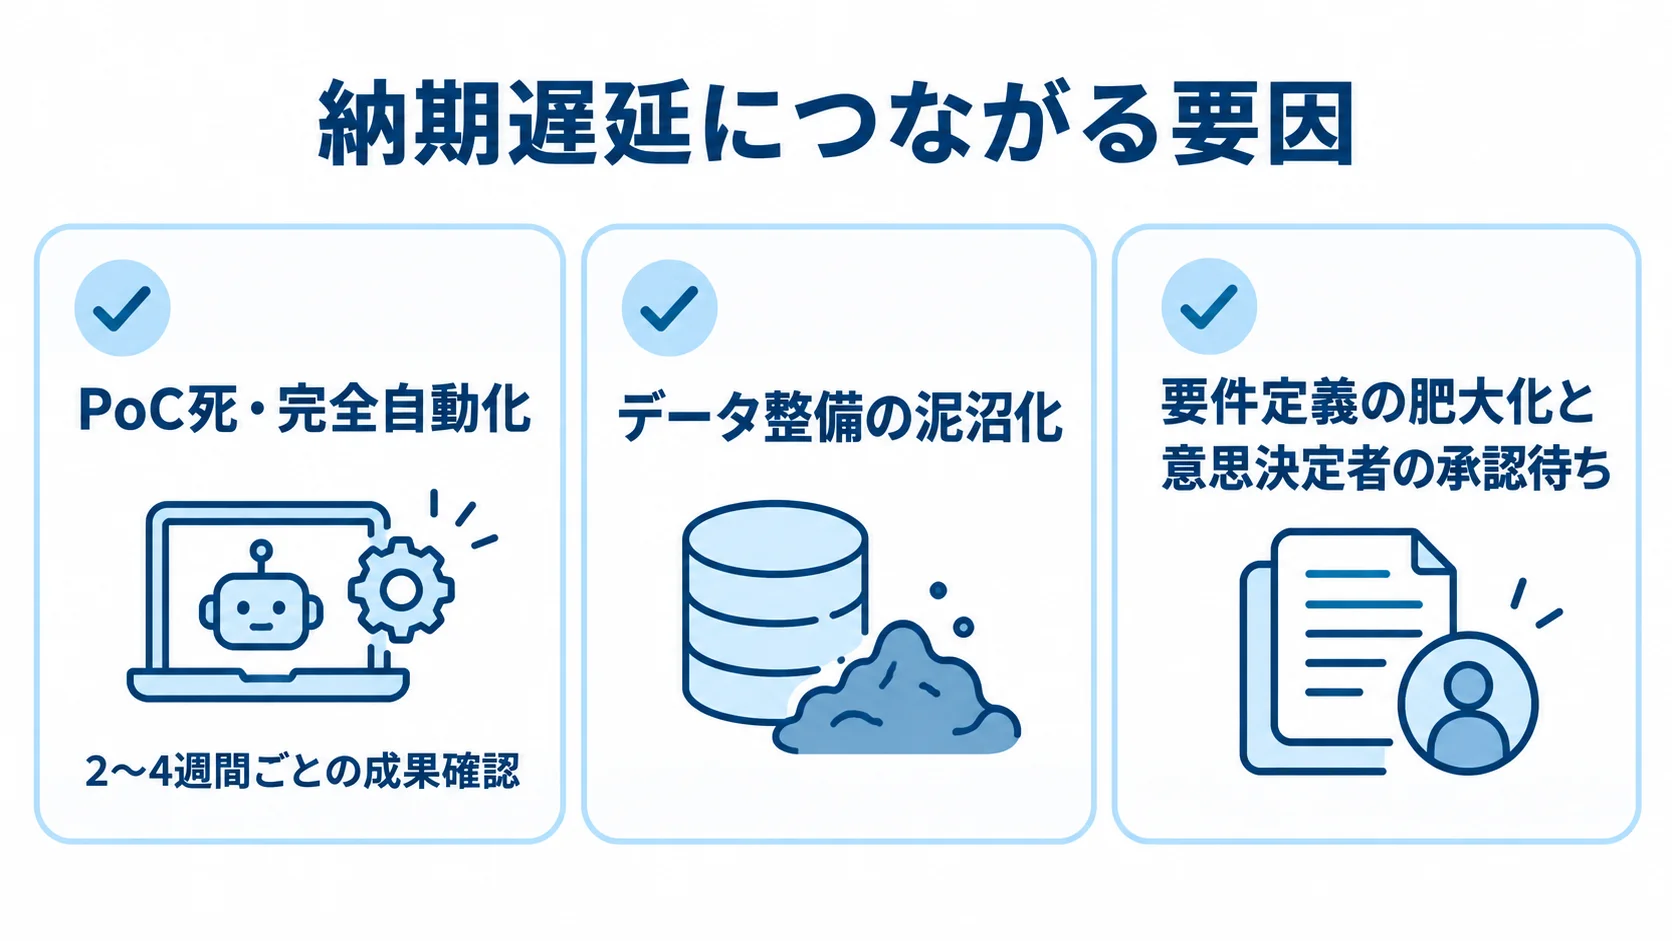
期間や工程を把握していても、生成AI特有の遅延要因を放置すれば計画は崩れます。遅延の原因は、PoCの自己目的化や完全自動化へのこだわり、データ整備の泥沼化、要件定義の肥大化と承認待ちに集約されます。
PoC死・完全自動化へのこだわりとデータ整備の泥沼化
1つ目の要因は、PoC(概念実証)そのものが目的になってしまう「PoC死」と、人の介在なしに動かすフルオートへのこだわりです。どちらも、開発を複雑にする原因になります。
- PoC死・完全自動化:2〜4週間ごとに区切って成果を確かめ、段階的に自動化する。
- データ整備:要件定義の初期にデータを洗い出し、品質を確かめる。
「AIが動いた」だけで満足してしまい、ビジネス価値につながらないケースがあります。また、想定外の入力や失敗をすべて自動で処理しようとすると、例外処理が複雑になり、破綻する場合もあります。
AIが迷いやすい場面では、人間が最終確認するHuman-in-the-Loop(HITL)を前提にします。実績を積んだうえで、自動化する範囲を広げていきます。
2つ目の要因は、データ整備(AI-Ready化)の泥沼化です。既存のマニュアルやデータをそのまま使えると見込んでいても、古い情報や分散したファイル、表記の揺れが見つかることがあります。そのため、整備に必要な期間と予算は、計画の初めから組み込んでおくことが有効です。
要件定義の肥大化と意思決定者の承認待ち
3つ目の典型的な遅延要因は、要件定義の肥大化と意思決定者の承認待ちです。業務の範囲が広がったり、決定が遅れたりすると、検証や確認が滞ります。
- 対象業務を絞る:「絶対にやりたい1個」を決めてから着手する。
- 決定者が参加する:要件定義の段階でスコープと品質基準を固める。
- 小さく検証する:PoCで見通しを立ててから、本開発へ進む。
生成AIは応用範囲が広いため、業務を増やすほど確認すべき出力のパターンも増えていきます。その結果、納期が雪だるま式に膨らみます。
文章やプロンプトの承認に意思決定者が同席できないと、確認待ちが積み重なり、日程が後ろ倒しになることがあります。
PoCを省いて本開発に進むと、当初は短く見えても、本番で品質が出ずに手戻りが起きます。そのため、全体の納期が延びるケースが多くあります。
まとめ
生成AIシステム開発の期間は、規模に応じて目安が変わります。小規模で2週間〜1か月、中規模で2〜3か月、大規模・エンタープライズで6〜12か月以上です。
工程は5つに分けて見ます。要件定義と設計から始まり、実装、テスト、パイロット運用へと進みます。シングル構成とマルチ構成では配分が変わるため、開発会社の見積もりを比べるときの手がかりになります。
完了の基準はコードの完成ではなく、LLMの出力品質が目標に届くことです。LLM選定やプロンプトの反復、ガードレールの調整が日程に影響します。
用途を1つに絞り、Human-in-the-Loopを前提に自動化を段階的に広げるとともに、データ整備の期間を確保しましょう。ノーコードやAPI活用と並行開発を組み合わせると、納期とリスクを管理しやすくなります。納期遅延の典型要因と対策も、あわせて見てきました。
具体的な日程を相談する際は、想定する用途と社内データの状況を書き出し、複数の開発会社から見積もりを取ることから始めます。
▼全体ガイドの記事
・生成AIシステム開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。