
Difyの立ち上げは、ユースケースの明確化、データ整備とRAG設計、Dify本体の構築、検証と本番運用の4段階で進めます。
Difyは、社内チャットボットなどで採用が進むオープンソース基盤です。導入を検討する企業や開発者にとって、PoCから本番構築までの各段階で決めることと、制作・運用のコツを押さえておくことが、立ち上げを進める近道になります。詳しくは下の記事をご覧ください。
▼全体ガイドの記事
・AIエージェント開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Difyとは?生成AIアプリを素早く立ち上げられる開発基盤
Difyは、ノーコード・ローコードで生成AIアプリケーションを構築できるオープンソースのフレームワークです。
ChatGPTやClaudeなど主要なLLMプロバイダーに加え、GeminiやMistralとも連携できます。RAG構成やワークフロー設計を組めるうえ、ユーザー管理やプロンプト構築にも対応しています。
Difyには、トークン利用量の可視化など、商用利用に必要な機能もひと通りそろっています。
活用が特に広がっているのは、社内向けの検索や業務の効率化に関わる場面です。具体的には、以下のようなユースケースがあります。
・社内文書を対象としたナレッジ検索チャットボット
・営業マニュアルや業務手順書を検索できるAIアシスタント
・社内SaaS連携による業務自動化(例:Notion+Slack)
・ドキュメント自動要約やPDF解析の生成系アプリ
Difyは、「自社用の生成AIエージェントを低コスト・短期間で立ち上げたい」という要望に応える有力な選択肢になっています。
ステップ1:ユースケースと活用目的の明確化
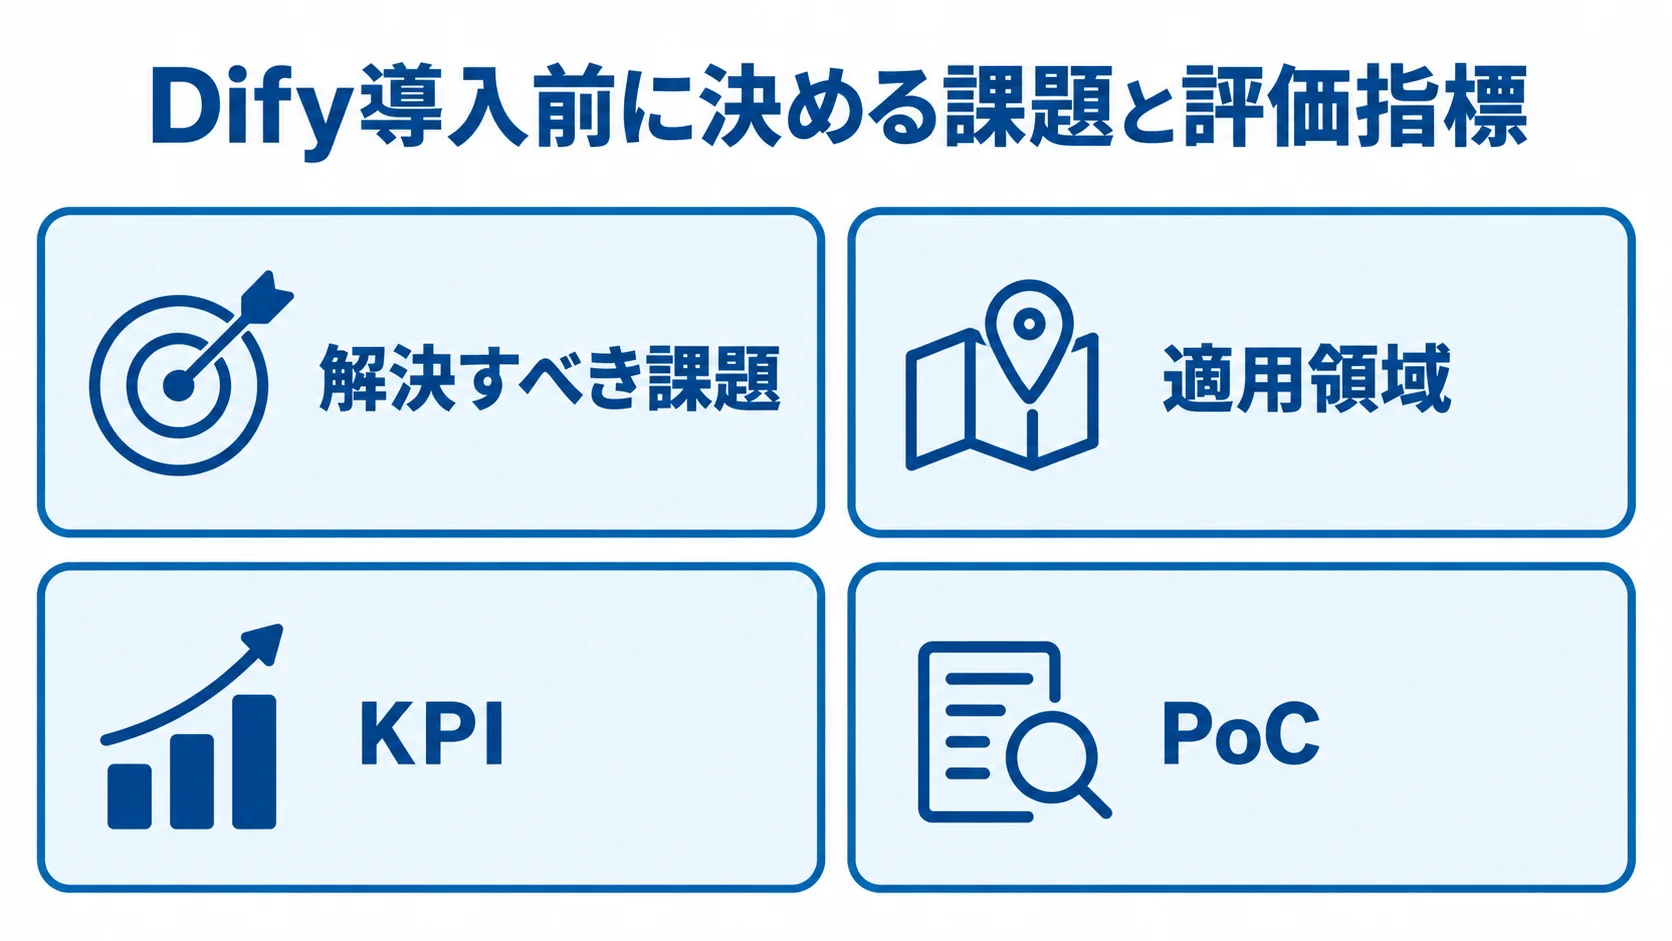
Dify導入の第一歩は、何のためにDifyを使い、どのような成果を出したいのかを明確にすることです。
生成AIでできることは幅広いため、目的が曖昧なまま進めると方向性がぶれやすく、失敗につながるおそれがあります。
解決すべき課題と適用領域の定義
Difyで解決すべき課題は、現場の困りごとを洗い出して決めます。
- 社内の情報や業務の困りごと:Difyで解決するケースが増えています。
- 社内ナレッジの検索:散在していて検索に時間がかかる
・FAQや問い合わせ対応が属人化している
・ドキュメントが多く、要点抽出や要約に工数がかかる
・業務マニュアルを対話形式で活用したい
発注側と開発会社で、AIに任せる作業と、どの業務の流れに組み込むかを具体化します。
KPI・評価指標の設定
生成AIの導入効果は、あらかじめ決めたKPIで測ります。
- 指標:導入の目的に合わせて選びます。
- 応答精度:ユーザー満足度で測る
・検索スピードの改善(平均所要時間)
・業務効率(対応件数や時間削減)
・LLM使用量(コスト管理)
そうすれば、PoCの段階でも数字をもとに効果を検証できます。
ステップ2:必要なデータの整備とRAGの設計
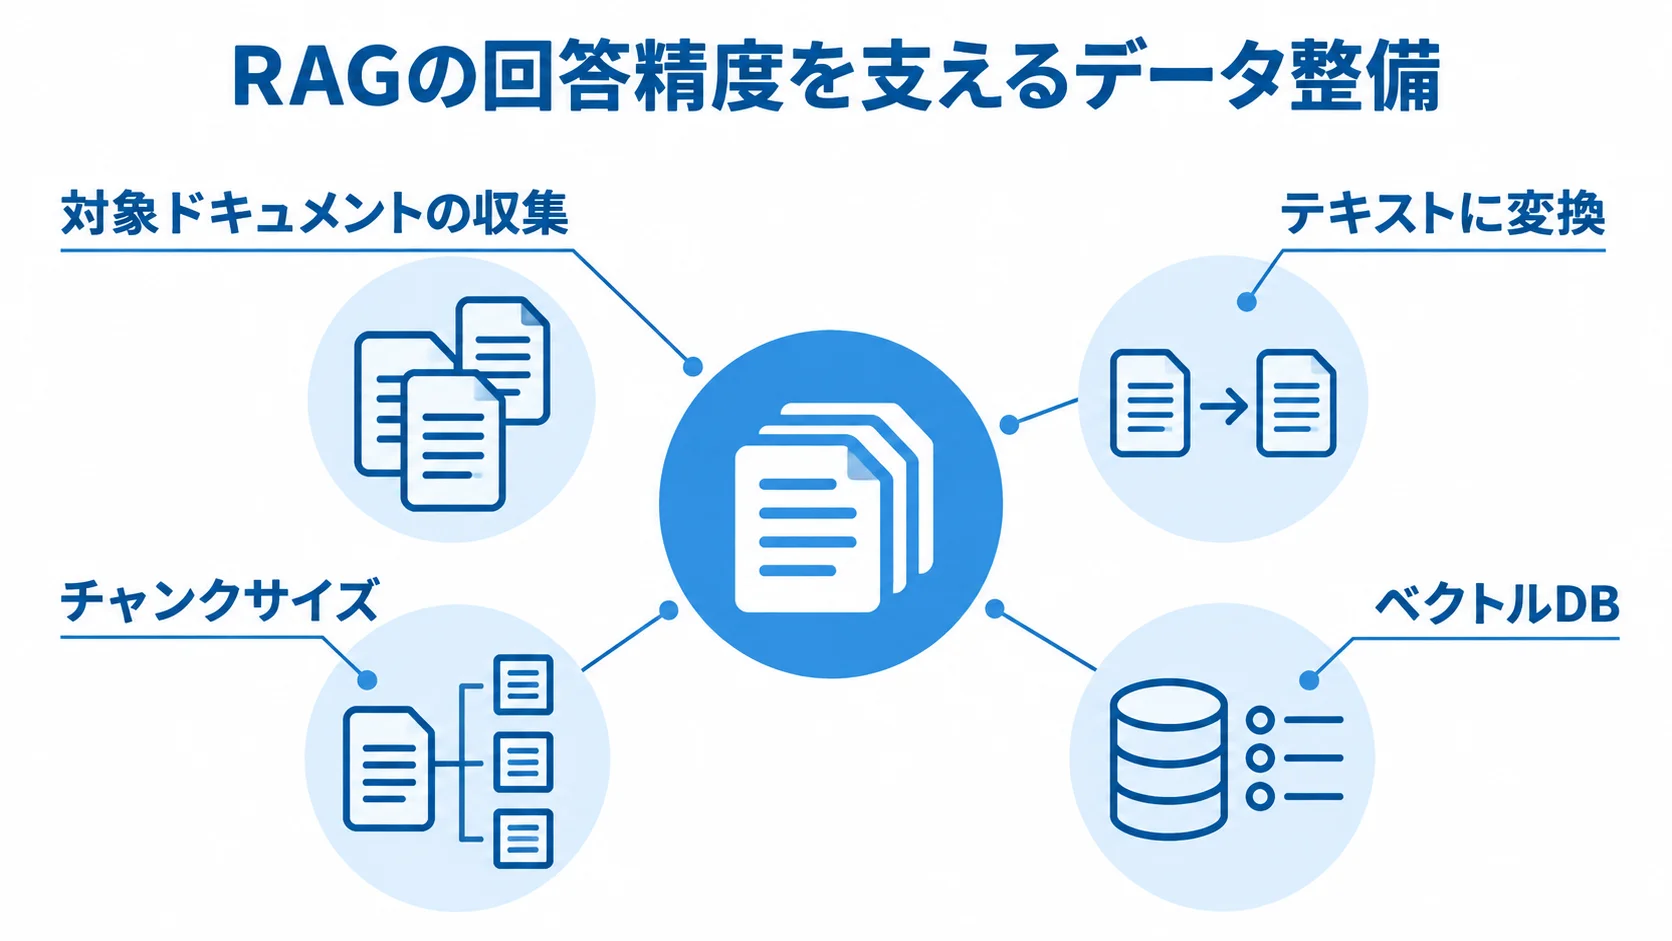
Difyの最大の特徴は、検索拡張生成(RAG)を標準で備えている点です。自社データを検索して要約し、精度の高い応答を生成するには、対象の情報を整え、ベクトルDBに登録しておく必要があります。
対象ドキュメントの収集と前処理
まずは、RAGで使うデータを集めて整えます。形式はWordやPDF、Excelなど多岐にわたります。
MarkdownやHTMLも含まれますが、最終的にはテキストに変換して扱います。
前処理は、検索精度を左右する作業です。
- 取り込み前の整理:データの中身を見直して整える
- 不要なページ:無関係なページやテンプレートの削除
・画像の代替テキスト化(必要に応じて)
・セクションごとのチャンク化とメタ情報の付与
・重複やノイズデータの除去
情報を整えておくと、検索精度と応答品質が上がります。
ベクトルDBの選定とインジェスト設計
Difyは、WeaviateやQdrant、MilvusなどのベクトルDBと連携できます。用途やスケーラビリティに合わせて選び、データをインジェスト(登録)します。
ベクトルDBの選定と登録の設計は、RAGの仕組みを支える部分です。
- 登録の設計:データの分け方と更新の仕組みを決める
- チャンクサイズ:分割単位と重複除去の設計
・検索対象とすべきメタ情報の設計(部署、日付、カテゴリなど)
・定期的な再インデックス処理の仕組みづくり
RAG設計は回答精度に直結するため、特に重要な工程です。
ステップ3:Dify本体の構築とカスタマイズ
データの準備ができたら、Dify本体の構築に入ります。Difyはオープンソースで提供されており、DockerやKubernetesを使ってインフラを自由に組めます。
サーバー環境の構築
サーバー環境の構築では、Difyの配置先と構成を先に決めておきます。
- デプロイ方法:基本はDockerコンテナを立ち上げてDifyをデプロイします。AWSやGCP、Azureのほか、オンプレミス環境でも対応できます。
- 構成設計:WebUI、バックエンド、ベクトルDB、LLM APIなどの構成を決める
・ログ管理、モニタリング(PrometheusやGrafana)の導入
・リバースプロキシやSSL対応(Nginxなど)
社内ネットワークで運用するなら、セキュリティやポリシーに沿った構成にする必要があります。
LLMプロバイダーとの連携設定
LLMとの連携は、Difyの中でも設定が比較的単純な部分です。
- LLMの選択:複数のLLMプロバイダーに対応しており、用途、コスト、精度に応じて柔軟に選べます。
- OpenAI:GPT-4、GPT-3.5
・Anthropic(Claudeシリーズ)
・Mistral、Cohere、Geminiなど
APIキーの登録と使用モデルの指定だけで使い始められるため、立ち上げは進めやすいです。
UI設計とプロンプト構築
UIはDify上で構築でき、非エンジニアでもある程度カスタマイズできます。業務フローに合わせて、チャットUIや入力欄を設計できます。マルチステップのフローやドロップダウンも組み込めます。
プロンプトは、UIの設計と合わせて組み立てる部分です。
- 調整の進め方:回答を見ながら、少しずつ整えていく
- テンプレートと変数:プロンプトの設計と変数の定義
・プロンプトのバージョン管理と精度チューニング
・ユーザー単位の履歴やトークン量可視化の設定
UIとプロンプトの出来が、そのまま現場の満足度に直結します。
ステップ4:検証・リリース・本番運用
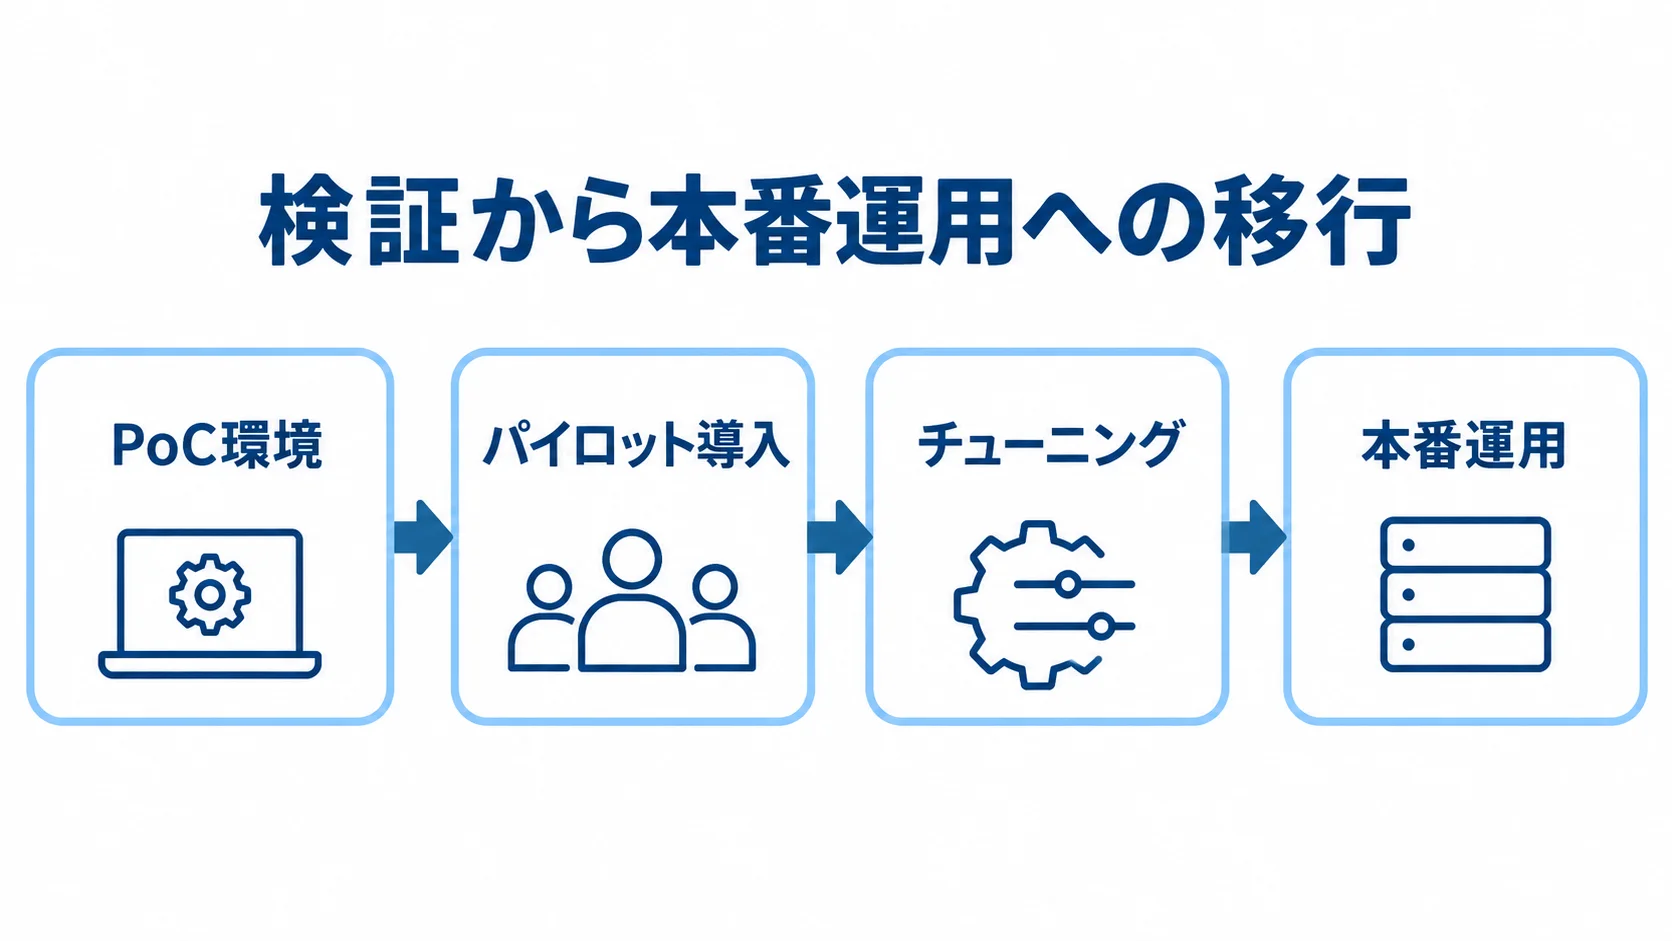
構築が終わったら、PoC環境で検証してから本番導入に進みます。ここからは、ユーザーのフィードバックをもとに改善を重ねることが中心になります。
パイロット導入とチューニング
パイロット導入は、一部の部署など限られた範囲で運用するところから始めます。
- 効果の確認:運用の中で、いくつかの観点から確かめる
- 回答精度:誤回答の頻度も見る
・応答速度やUXの快適さ
・業務における導入効果(時間短縮、負荷軽減など)
得られた結果をもとに、プロンプトやチャンク化を見直し、検索アルゴリズムやインデックス設計も微調整します。
本番運用と管理体制の整備
本番運用では、誰がどこまでを管理するかを決めておく必要があります。
- 移行時の準備:正式に本番環境へ移行する際は、運用ポリシーや監視体制の整備が欠かせない
- 権限管理:管理者によるアプリ権限の設定、ユーザー制御
・LLM使用量や応答ログの定期的なチェック
・データ更新フローと新ファイルの自動インジェスト設計
・セキュリティインシデント対応フローの策定
この運用フェーズが、長期的な成功と社内定着を支えます。
Dify運用を成功させるための制作・改善のコツ
Difyで生成AIアプリを作るなら、技術を導入するだけでなく、継続的な改善とユーザー起点の設計が成功のカギになります。
スモールスタート+拡張型の導入計画
導入は、いきなり全社へ広げるより、段階的に進めるほうが安全です。
- 小さく始める:特定部署や小さなユースケースに限り、成功体験を積み上げると、社内への浸透と拡張がスムーズになる
- 展開の例:FAQチャットからスタートし、次に議事録要約へ展開
・1部門導入後、他部門への展開ロードマップを作成
段階的に広げれば、開発コストや失敗リスクを抑えられます。
LLMコストの見える化と最適化
Difyは外部のLLM APIと連携するため、その利用量がそのままコストに表れます。
- コストの増え方:利用量に応じてコストが増えるため、ログの可視化とプロンプトの最適化で削減が実現できる
- トークン使用量:可視化と不要出力の削減
・簡潔なプロンプト設計とインタラクション回数の最適化
・APIの選定とモデル切り替え(例:GPT-4→GPT-3.5)
これらを続けることで、コストパフォーマンスが大幅に向上します。
現場の声を活かすUI改善サイクル
改善の中心になるのは、現場の利用者からのフィードバックです。
- 画面の改善:Difyは、UIを柔軟に改善できるのが強みです。ユーザーのフィードバックを生かして「使いやすいAI」を育てる姿勢が求められます。
- 問い合わせ分析:分析にもとづくUIの改善
・誤回答のパターンからプロンプトを修正
・運用チームによる改善ログの記録と定例レビュー
PDCAを回し続けることで、AIツールは日常的に使われる存在へと育っていきます。
まとめ
Difyは、自社に合った生成AIアプリを素早く構築し、運用するための有力な基盤です。
PoCから本番構築、継続運用までの流れを押さえ、目的に沿って段階的に立ち上げることが、導入成功の鍵になります。改善サイクルの設計も欠かせません。
・ユースケースとKPIを明確にし、PoC設計から始める
・RAG設計とデータ整備が応答精度を左右する
・インフラ構築、LLM連携、UI設計までを一貫して設計する必要がある
・ユーザー起点の継続改善が、Difyの強みを最大限に活かす
今後も進化を続けるDifyを使えば、生成AIの業務活用に向けた第一歩を段階的に踏み出せます。
関連する内容は、下の記事でもまとめています。
▼全体ガイドの記事
・AIエージェント開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。