
ChatGPTなどの登場を受け、大規模言語モデル(LLM:Large Language Model)の企業活用が現実味を帯びています。
LLMの立ち上げは5つのステップで進みます。目的の明確化に始まり、データ準備、モデル選定と開発、UI設計と業務システムへの統合を経て、検証と運用改善へ進みます。
本テーマに関する全体ガイドは、以下の記事をご覧ください。
▼全体ガイドの記事
・RAG構築・LLM開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
LLMの基本概念とビジネス活用の背景
LLM(大規模言語モデル)は、数十億〜数千億単語を学習した自然言語処理モデルです。対話、要約、分類、翻訳など、テキストを扱う幅広い処理に使えます。
近年は、オープンソースのLLaMAやMistral、商用のGPT-4、Claude 3などが登場し、実用性と精度が急速に高まっています。
企業でのLLM活用例には、次のようなものがあります。社内ナレッジベースからの自動回答生成、議事録の自動要約とタスク抽出、契約書の要点抽出やリスク検出などです。
多言語チャットボットによるカスタマーサポートや、社内のFAQや業務手順書の自然言語検索も、活用例に含まれます。
背景には、自社の業務に合わせたLLMを構築・立ち上げたいというニーズが広がっています。
ステップ1:目的とユースケースの明確化
LLM開発の第一歩は、目的とユースケースの明確化です。どのような課題を解決したいのか、どの業務領域にLLMを組み込むのかを言葉にしておけば、後続の工程がぶれにくくなります。
解決すべき業務課題の整理
LLMが活躍する領域は多岐にわたるため、まずは具体的な課題を一覧にしておきます。
- 問い合わせ対応:負担が大きい
- 属人化の解消:ナレッジを誰でも使えるようにしたい
また、情報検索の精度とスピードが低いといった課題もあります。こうした課題を洗い出し、LLMを活用できる余地を探すところから始めます。
KPI・評価指標の設定
LLM導入が効果を発揮しているかを判断するには、事前にKPIを定めておく必要があります。
- 応答精度:例としてユーザー満足度80%以上
- 時間短縮:例として検索時間を50%削減
KPIには、コスト削減(例:人件費月○万円分の効率化)を指標として含めることもできます。
KPIを決めておけば、PoCや本番運用の後で、何をどう改善するかを判断できます。
ステップ2:データ準備と設計方針の策定
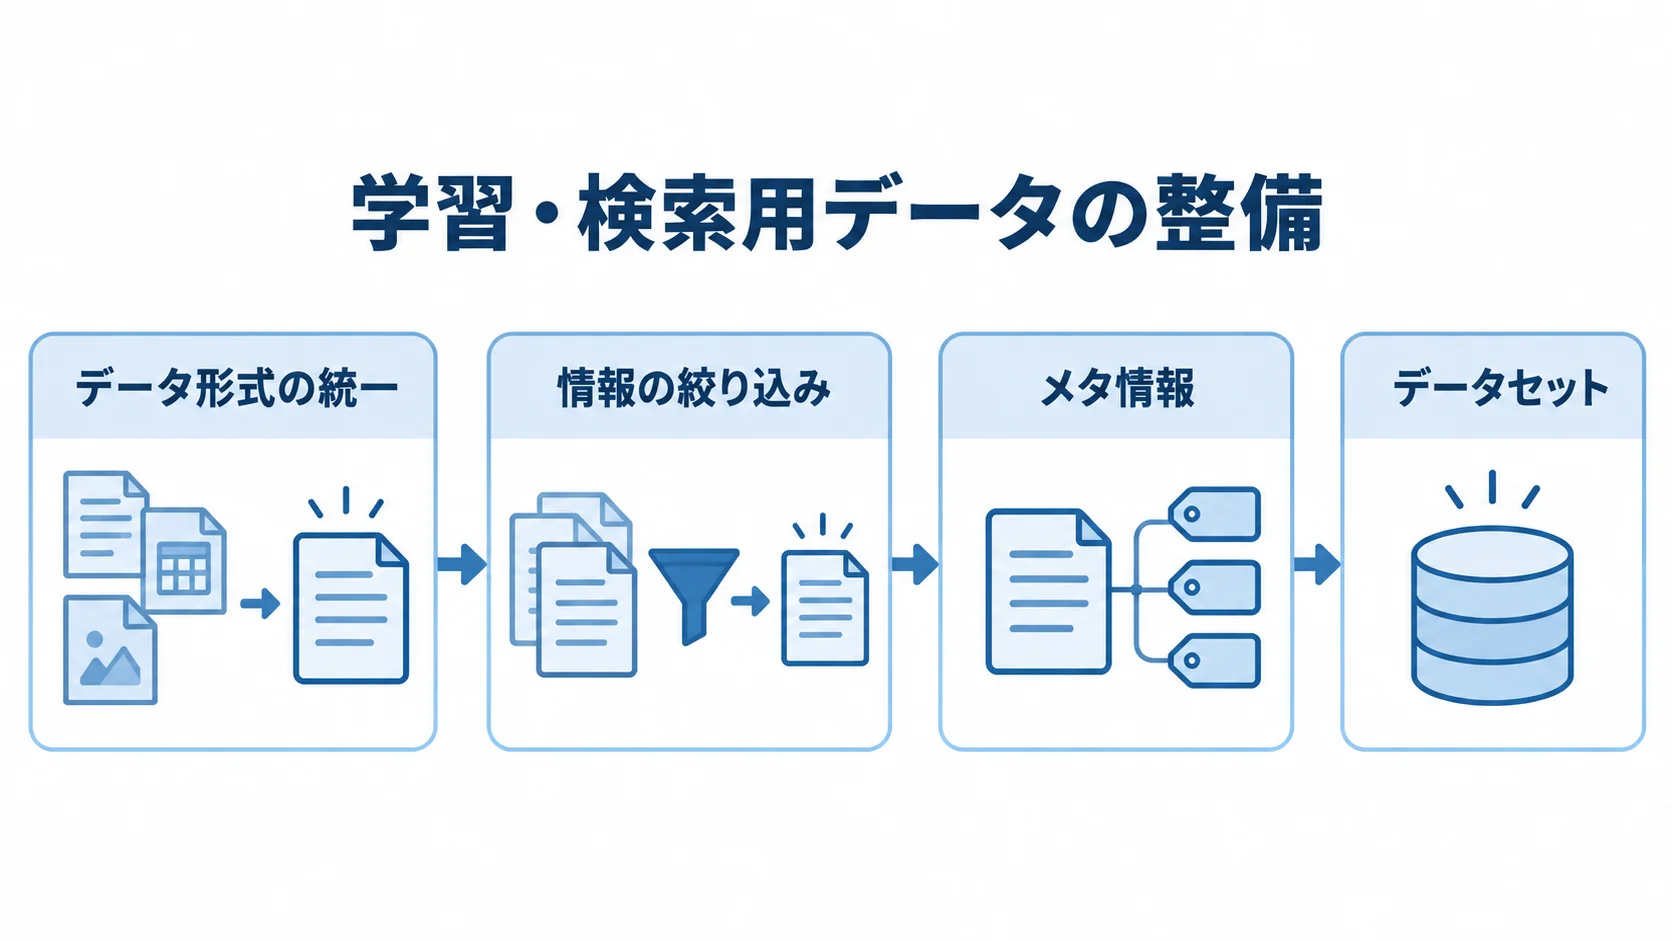
LLMの性能を最大限引き出すには、高品質なデータの準備と構成の設計が欠かせません。特に社内業務に合わせるには、独自データを整えることが重要な段階になります。
学習・検索に使う社内データの整備
企業内には、PDFの手順書、PowerPointの研修資料、Slackの会話ログなど、非構造データがさまざまな形で存在します。学習や検索に使えるよう、次のように整えます。
- データ形式の統一:テキスト、JSONなどの統一フォーマットに変換する
- 情報の絞り込み:不要な情報や機密情報を削除・マスキングする
メタ情報も、セクションやトピックごとに付与します。
データは処理を経て、RAG(Retrieval-Augmented Generation)やファインチューニングで活用できるデータセットになります。
開発方針の選定:RAGとファインチューニング
自社LLMの立ち上げには、大きく2つの方針があります。RAG型構成は、外部のLLM(GPT、Claudeなど)に社内ドキュメントをリアルタイムで検索させ、回答を生成する方式です。一方、ファインチューニング型は、オープンなLLMに自社データで再学習させ、カスタムモデルにする方式です。
両者は、導入の速さや汎用性、精度や運用コストで違いがあります。
- RAG型:導入が比較的早く、汎用性も高い
- ファインチューニング型:高精度で、低コストでの運用が見込める
業務の特性や予算に応じて、適切な構成を選ぶことが大切です。
ステップ3:モデル選定と開発・構築
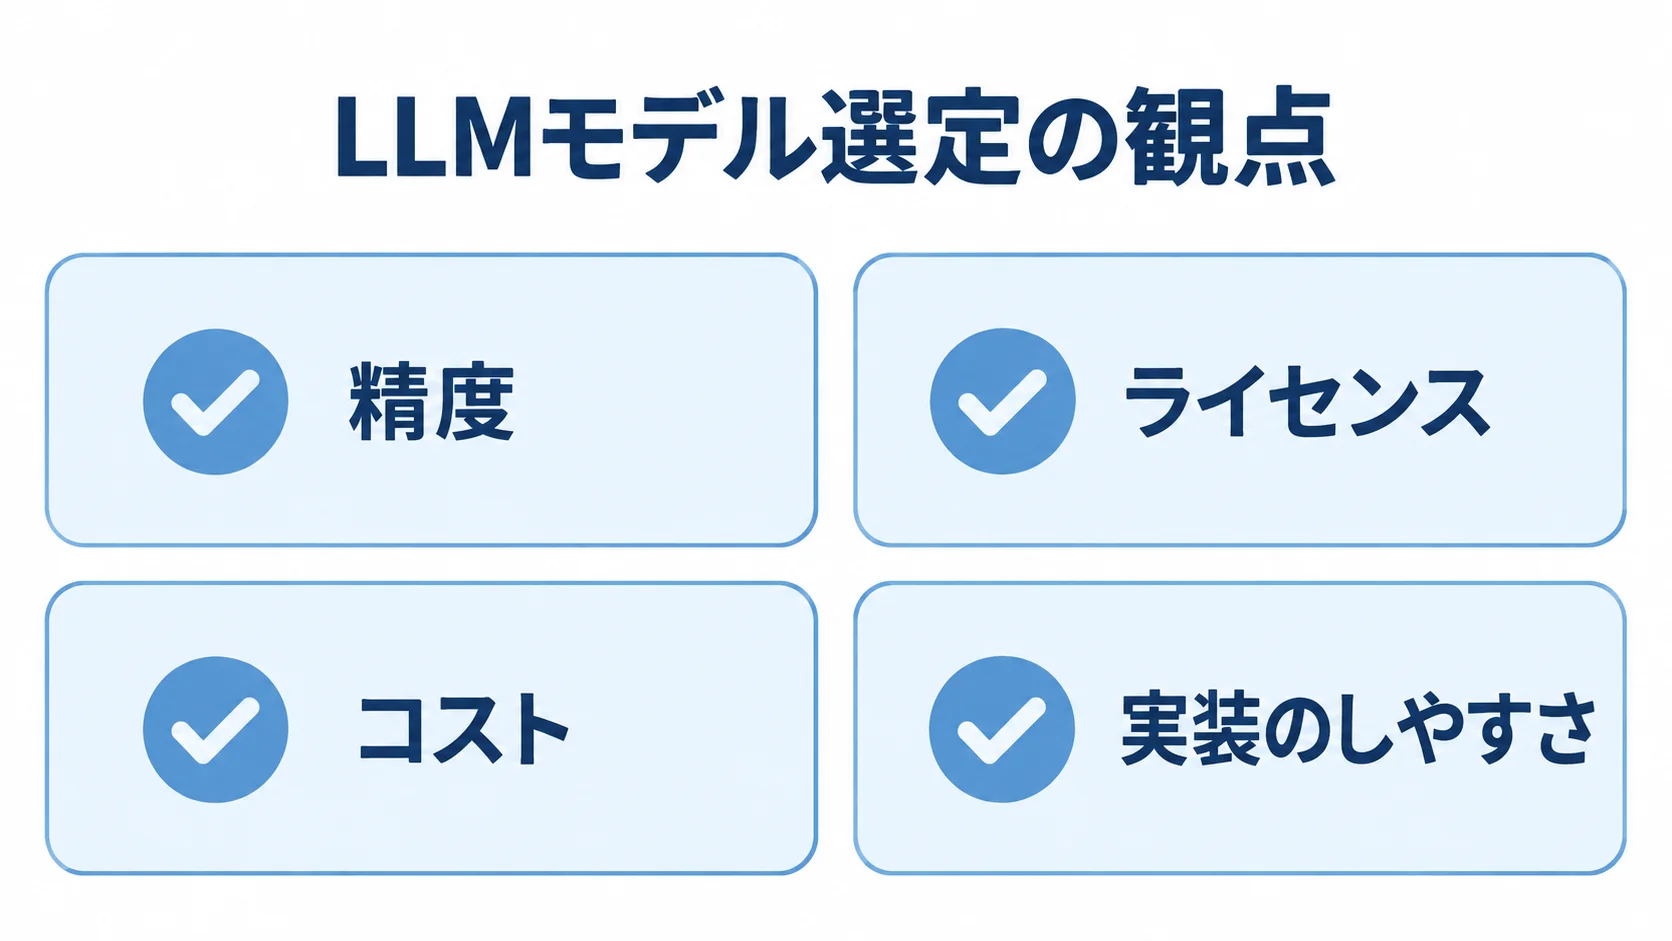
次は、実際に使うLLMモデルを選んで開発を進める段階です。精度、ライセンス、コスト、実装のしやすさを比べながら、どのモデルが合うかを見極めます。
モデル選定のポイント
LLMを選ぶ際は、次の観点で比べます。
- オープンソースか商用か:LLaMA、Mistral、GPT、Claudeなど
- 精度:推論品質、知識の新しさ
また、推論速度とモデルサイズ(オンプレかクラウドか)も比べます。さらに、利用ライセンス(商用利用の可否、配布条件など)も確認します。
小規模な用途であれば、OpenRouter経由の商用LLMを使う方法も選択肢になります。一方で、情報漏洩のリスクを避けたい場合は、オンプレでオープンモデルを動かすことが推奨されます。
開発・実装の進め方
モデルが決まったら、次の工程で開発と構築を進めます。
- プロンプト設計:テンプレート作成も含める
- RAG構成:ベクトルDB(Pinecone、Weaviateなど)と組み合わせる
また、モデルをAPI化し、業務アプリケーションと連携させます。さらに、APIキーやユーザー認証などのセキュリティ設定も行います。
LLM単体で完結することは少ないため、検索、ログ、セッション管理、インフラ管理などと連携させる全体設計が求められます。
ステップ4:UI設計と業務システムへの統合
LLMを現場で快適に使ってもらうには、操作画面や業務の流れを工夫することが欠かせません。業務効率を本当に高めるには、UX設計が要になります。
LLMを使うインターフェースの種類
LLMを使うインターフェースには、次のような種類があります。
- WebチャットUI:SlackやTeams連携、社内ポータル内など
- 業務アプリ内:アシスタント機能
インターフェースとしては、社内検索システムに自然言語で入力できるようにすることや、社内の問い合わせフォームの自動応答と連携させることもあります。
エンドユーザーがどこで、どのように使うのかを踏まえ、利用頻度の高い業務の流れに自然に組み込みます。
業務システムとの連携・運用設計
業務システムとつなぐ際は、次の点を設計します。
- 認証連携:社内LDAPやSSOと連携し、ユーザーのアクセス権を制御
- 社内データ連携:社内DBやファイルサーバーへの検索連携
さらに、操作ログや利用データを蓄積して、改善の循環をつくります。また、エラー検出やフィードバック対応の体制も整えます。
LLMを実験で終わらせず、業務に根付いた「実働AIアシスタント」として活用するには、この設計が欠かせません。
ステップ5:検証・リリース・運用改善
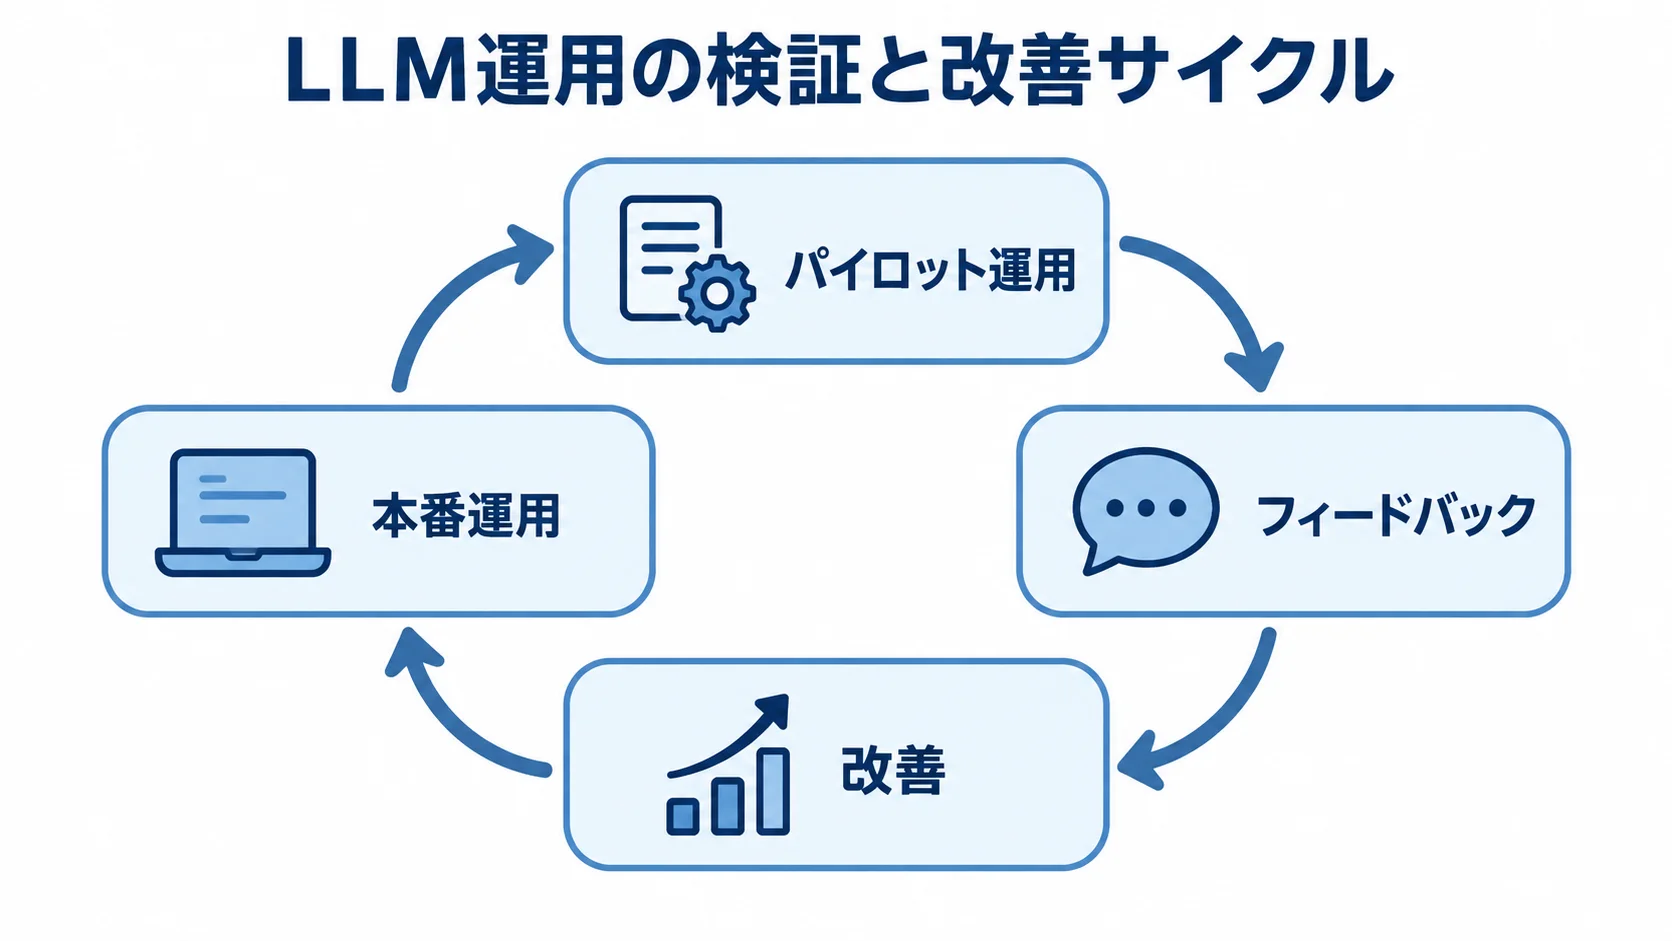
開発が完了したら、実際の業務でパイロット運用を始め、寄せられたフィードバックをもとに改善を重ねていきます。
パイロット検証とユーザー評価
まずは一部の部署や小グループで運用を始め、次の観点で評価します。
- 精度:回答の正確性、使える情報の網羅性
- 使い勝手:UIの見やすさ、動作スピード
影響度も、実際に時間が短縮されたか、業務が効率化されたかで確認します。
利用データやアンケートをもとに、モデル、UI、検索ロジックの改善を続けます。
本番運用と改善サイクルの設計
LLMは、導入後も運用を通じて育てていく必要があります。
- ナレッジ更新:最新情報のインデックス化(定期的に実施)
- FAQ・回答の改善:ユーザーログをもとにしたFAQ強化や回答補正
さらに、モデルのアップデート対応(新しいLLMへの乗せ換えなど)も必要です。また、権限管理や利用ポリシーを見直します。
改善の循環を体制として回せるように設計することが、LLM活用の成否を分けます。
まとめ
LLMの立ち上げには、目的の整理からデータ整備、モデル選定、UI統合、運用体制の構築まで、段階を踏んで進めることが求められます。
目指すべきは、「AI導入」で終わらず、業務成果を生み出すAIを実装することです。
まず、ユースケースとKPIを明確にすることが成功の起点になります。そのうえで、社内データの整備と設計方針(RAGかファインチューニングか)を早めに決めます。
モデルは、ライセンス、精度、実装のしやすさの観点で選びます。また、ユーザー視点のUIと既存システムとの統合が、現場に定着するうえで鍵になります。さらに、継続的な改善とナレッジ更新によって、「育てるAI」を実現します。
生成AI時代の競争力を高める第一歩として、自社に合ったLLMの立ち上げを、着実に進めていきましょう。
ここまでの流れを全体で確認したい場合は、以下の記事が参考になります。
▼全体ガイドの記事
・RAG構築・LLM開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。