
RAGの立ち上げは、目的と業務範囲を決めることから始め、データ整備や検索設計、プロンプト、運用までを一続きで考えながら、段階的に進めます。
RAGは、ChatGPTなどの大規模言語モデル(LLM)に自社文書を参照させ、業務に即した回答を目指す技術です。
本テーマの全体像は、RAG構築・LLM開発の完全ガイドでも確認できます。
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
RAGの概要と業務活用で注目される理由
RAGは、Retrieval(検索)とGeneration(生成)を組み合わせたアーキテクチャです。検索で見つけた社内文書をLLMへ渡し、その内容を踏まえた回答を生成させます。
RAGの基本構造
基本的な処理は、次の順で進みます。
- ユーザーの入力をもとに、ベクトル検索で検索対象の文書を特定する
- 検索結果の複数の文書を、プロンプトとともにLLMへ渡す
- LLMが文書の内容を踏まえ、自然な回答を生成する
この構成によって、LLMだけでは難しい「正確性」と「業務ドメインへの対応」を目指せます。
RAGが必要とされる理由
企業の業務では、自社固有の情報を扱えることや、回答の出典を確認できることが大切です。RAGには次のような利点があります。
- 社内文書:社内マニュアルや契約書などを回答の根拠にできる
- 回答の確かさ:ChatGPT単体よりも、事実に基づいた回答を返しやすい
- 根拠の確認:生成結果の出典を示せるため、業務での信頼性が高い
- 向いている分野:法務、製造、教育、医療などドキュメント中心の業務
RAG開発・構築の全体プロセス
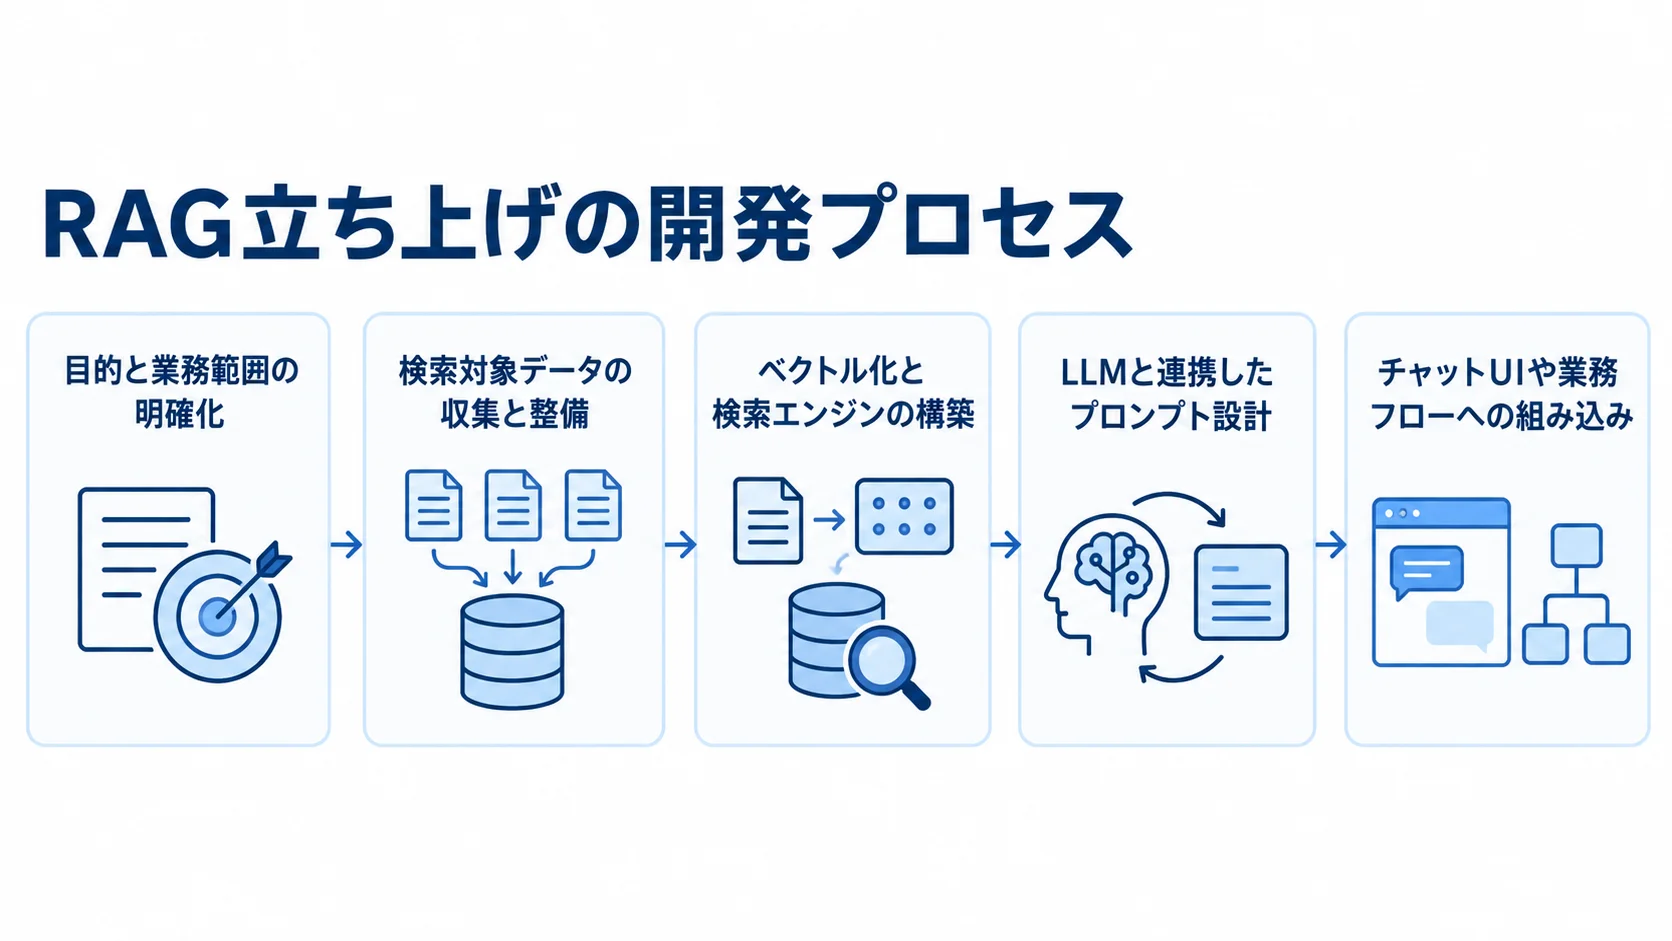
RAGの立ち上げは、目的の明確化からUIや業務フローへの組み込みまで、段階的に進めるのが一般的です。そのため、各段階の結果を確かめながら、次の段階へ進みます。
ステップ1:目的と業務範囲の明確化
最初に、発注側と開発会社で、「なぜRAGを使うのか」「どの業務で使うのか」を決めます。利用例には次のようなものがあります。
- 社内FAQ:問い合わせへの自動応答に使う
- 営業支援:資料作成をサポートする
- 契約書:自動検索と要約を支援する
後で効果を評価しやすくするため、問い合わせ削減率や作業時間短縮などの成果指標も、あらかじめ設定しておくとよいでしょう。
ステップ2:検索対象データの収集と整備
RAGで重要なのは、参照する文書の質です。そこで開発会社は、社内のPDFやWordのファイル、ExcelやNotion、SharePointなどの資料から対象のデータを取り出し、章や段落の単位に分けます。さらに、不要な改行や図表を整え、タイトル、カテゴリ、作成日などのメタデータを付けます。
こうした前処理の精度が、最終的なRAGの品質を左右します。
ステップ3:ベクトル化と検索エンジンの構築
開発会社は、文書の意味を数値で表す「ベクトル化」を行い、検索できる状態にします。埋め込み(Embedding)モデルは、OpenAI, Cohere, Sentence Transformersなどから選び、「日本語対応」「コスト」「検索精度」などを比べて決めます。
ベクトルデータは、QdrantやWeaviateなどのベクトルDBに格納します。この検索基盤の良し悪しが、RAG全体の性能に直結します。
ステップ4:LLMと連携したプロンプト設計
検索結果をLLMへ渡す際の指示文(プロンプト)を、開発会社が設計します。
- 回答の前提:「以下の文書を参照して回答する」など、指示を明確に示す
- 複数結果の扱い:検索結果が複数あるときの形式をそろえる
- 情報の絞り込み:不要な情報を取り除き、回答の精度を高める調整を行う
ChatGPTやClaudeなどのLLMを使うため、API連携も実装します。
ステップ5:チャットUIや業務フローへの組み込み
現場の担当者が日常の業務で使えるよう、インターフェースを用意します。
- UIの形態:Webチャット、Slackボット、Teamsアプリなどで実装する
- 追加機能:ファイルアップロード、履歴管理、ロール別のアクセス制御も追加できる
- 組み込み方:RAGの操作が、既存の業務フローに自然に組み込まれるよう設計する
この使い勝手(ユーザー体験)が、RAGの定着を左右します。
RAG開発を成功させるための制作・設計のコツ
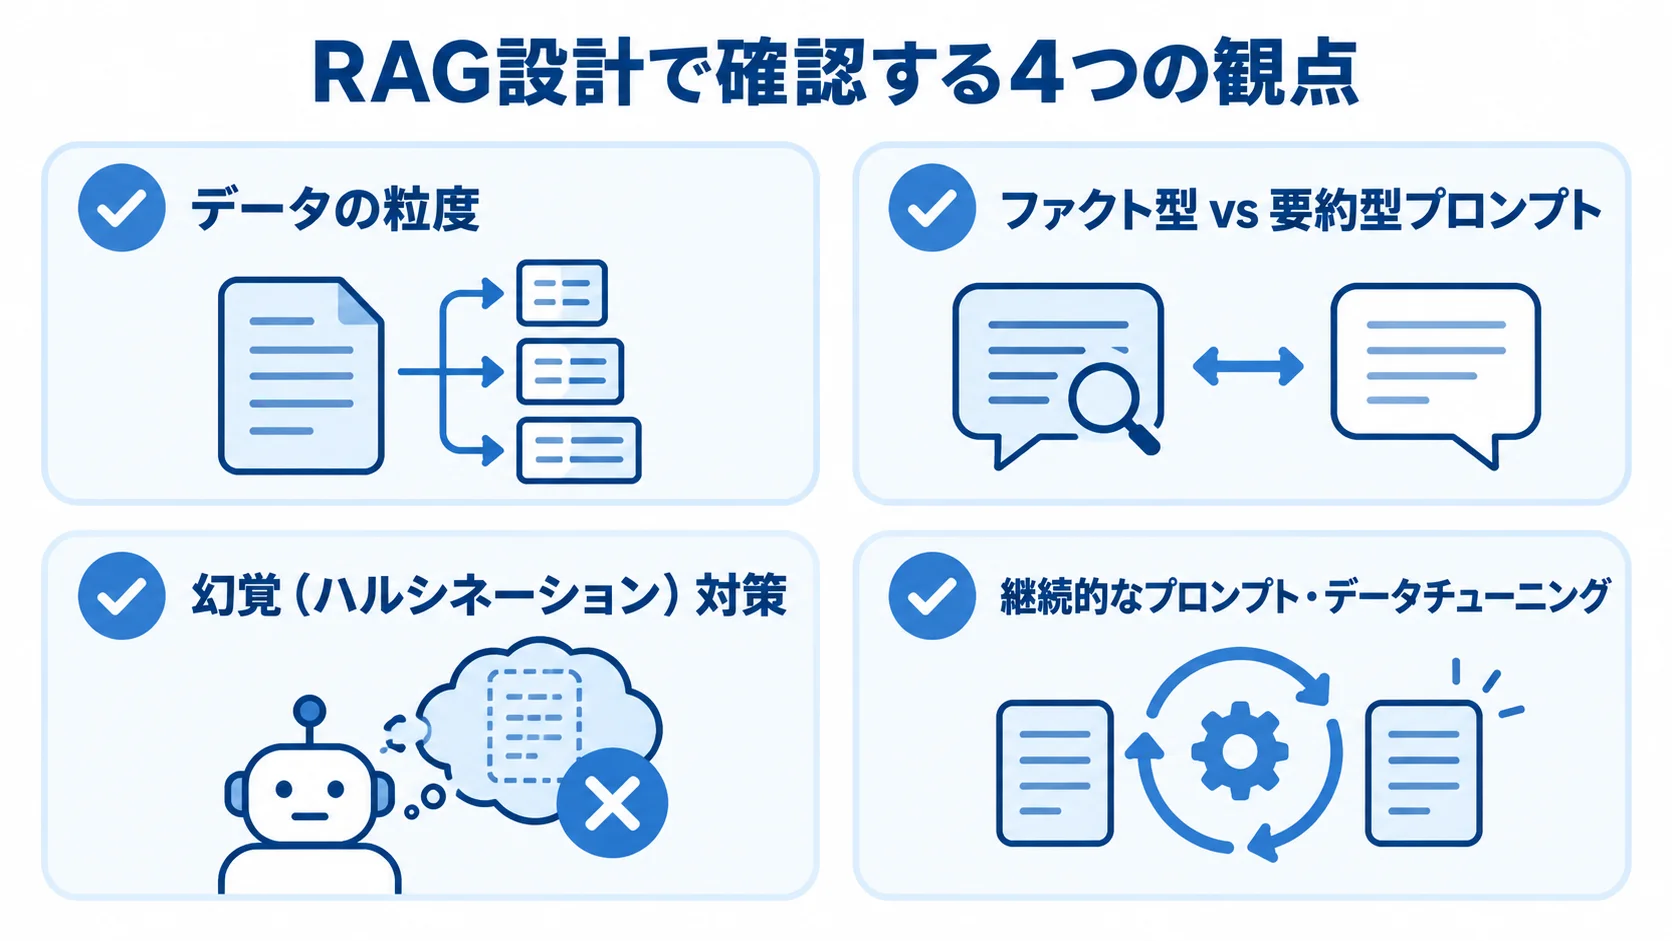
RAGの精度や業務への適用性を高めるには、データとプロンプトを作るだけで終わらせず、回答の根拠と改善方法まで設計することが大切です。
データの粒度の目安
文書を分割するとき、1文単位やページ単位では、うまくいかないケースが多く見られます。そのため、段落から章までの単位で分けるのが適切です。意味が完結する単位で分けておくと、精度の高い検索と回答につながります。
ファクト型 vs 要約型プロンプトの使い分け
「事実をそのまま伝える」プロンプトと、「複数の資料を要約・比較する」プロンプトは、目的によって使い分けが必要です。業務の目的に合わせてプロンプトを柔軟に切り替えることが、成功の鍵になります。
幻覚(ハルシネーション)対策の組み込み
RAGを使っても、誤った情報が生成される可能性はゼロではありません。そこで、根拠となる文書を回答とあわせて明示表示させる設計が有効です。
さらに、出典がない場合は「分かりません」と答える設計も加えられます。信頼性を保つには、こうした設計への配慮が欠かせません。
継続的なプロンプト・データチューニング
ユーザーの利用ログやフィードバックをもとに、プロンプトを改善していきます。また、新しい文書が追加されたときには、定期的な再学習や再登録も必要になります。初期構築の後も、運用の段階で改善を続ける体制づくりが求められます。
RAGを立ち上げる際の注意点と落とし穴
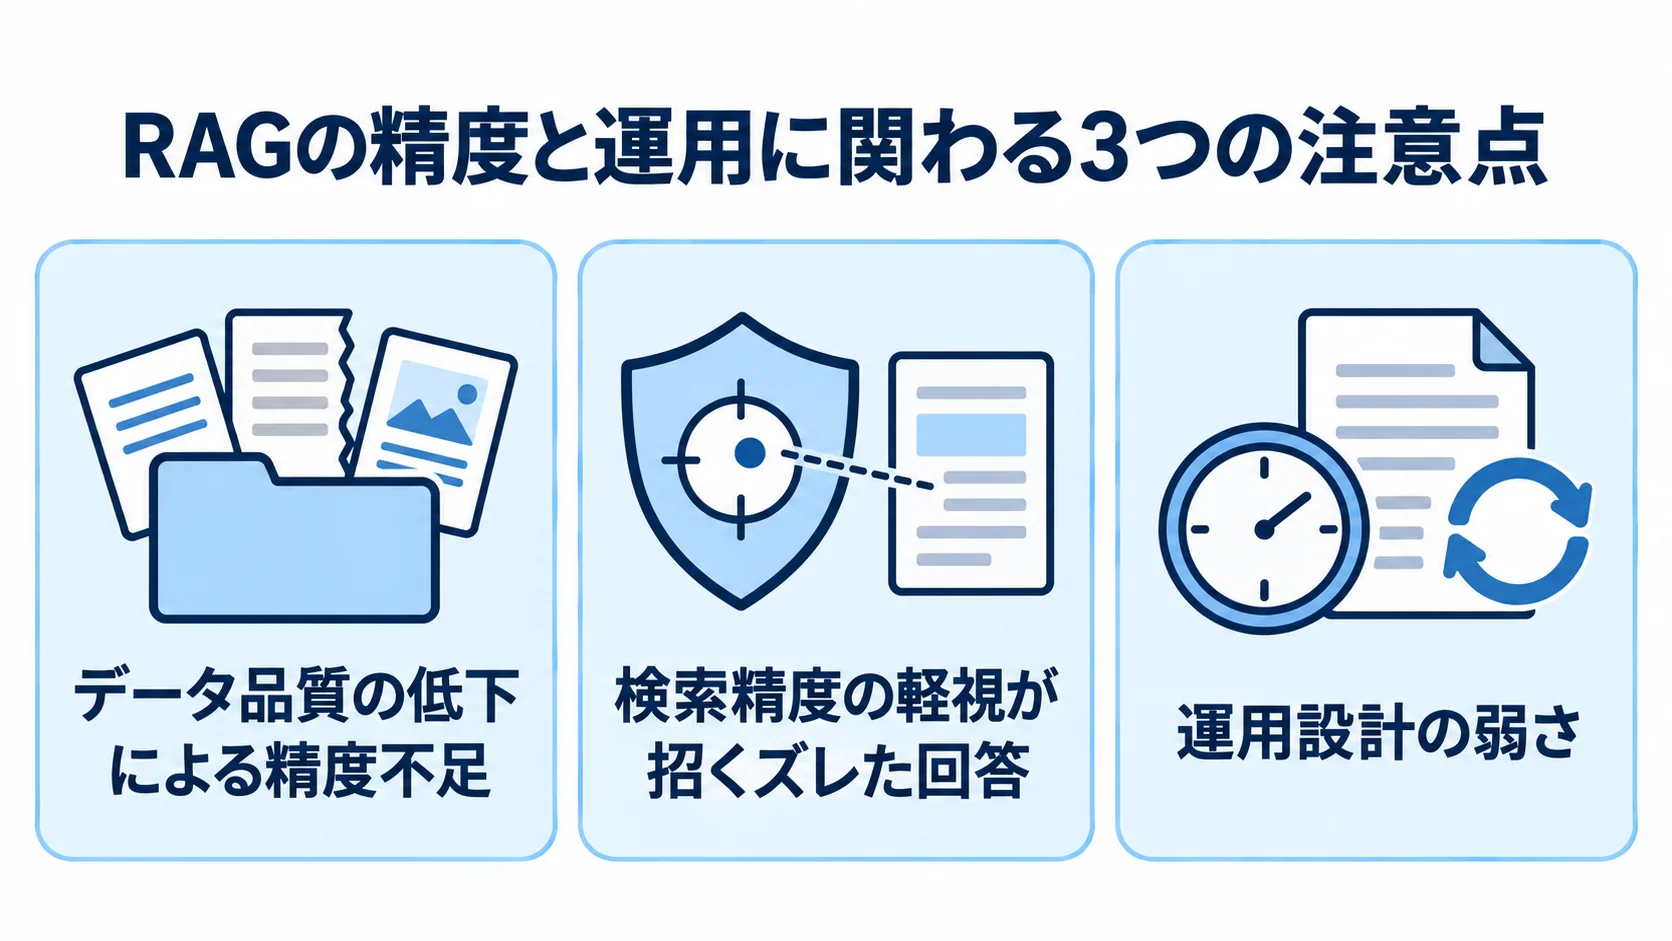
RAG開発では、設計やデータの面に加えて、運用まで含めて押さえておくべき点があります。
データ品質の低下による精度不足
RAGの精度は、元データの品質と文書分割(chunking)の設計が8割を占めます。PDFのノイズや非構造データ、粒度のばらつき、古い文書が混在している状態では、精度が上がりません。そのため、文書のクリーニング、構造化、バージョンの整理は欠かせません。
検索精度の軽視が招くズレた回答
RAGの核心は、検索(Retrieval)にあります。embeddingモデルの選定とchunkサイズ、類似度閾値、メタデータ設計が不適切だと、「答えは文書にあるのに出てこない」「関係のない文書がヒットする」といった問題が起きます。
成果に直結するのは、LLMの性能よりも検索の設計です。
運用設計の弱さが招く、古い情報を返すRAGのリスク
RAGは、構築よりも運用のほうが重要です。文書更新の反映フロー、権限管理、品質チェックを設計しなければ、古い文書や誤った文書を返すおそれが高まります。そこで、「誰が文書を更新するのか」「いつ反映するのか」を明確にしておくことが必要です。
まとめ
RAGは、生成AIを業務で本格的に使うための仕組みで、とくにナレッジ検索や文書ベースの業務で効果を発揮します。立ち上げには、複数の技術と設計力が求められます。
- 検索と生成:両者を組み合わせ、高精度なAI応答を実現する
- データ整備とプロンプト設計:この2つで成否が分かれる
- 進め方:段階的なPoCから展開するのが現実的
- UI設計:業務現場に自然に溶け込むことが、定着の鍵になる
- 体制:設計・構築・運用までを一貫して見据えた体制が必要
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。