
機械学習開発は、課題設定、データ準備、モデル評価、本番導入の順に進み、実用精度を確かめます。期間は規模で変わり、PoCは1〜3ヶ月、本番構築は数ヶ月〜1年以上が目安です。
AI活用ニーズが高まり、需要予測や不良検知などの多くは、機械学習モデルの開発と業務への組み込みに至ります。
▼全体ガイドの記事
・機械学習の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
機械学習開発の開発期間の全体像
機械学習開発の期間は、データの量や質、課題の難易度、目標精度で変わります。さらに、予測結果を業務に組み込む範囲も、期間を左右します。
一般的には、PoC(概念実証)で1〜3ヶ月かけて実用に足る精度を確かめます。本番システムの構築には、規模に応じて数ヶ月〜1年以上かかります。
機械学習開発は、着手前にデータで目標精度へ届くかを確定できない開発です。そのため、全体スケジュールには、精度を作り込む反復期間を必ず含めます。反復は見積もりを難しくする一方で、機械学習開発の本質でもあります。
予測エンジンだけを作るか、基幹システムや業務フローと深く連携するかでも、期間は変わります。
規模別・目的別の開発期間の目安
導入の規模が大きくなるほど、連携する業務や拠点が増え、開発期間も延びます。規模ごとの具体的な期間は、次のとおりです。ここでのPoCは、過去データでモデルを試作し、精度と投資対効果(ROI)の見通しを立てる段階です。
- PoC:1〜3ヶ月が一般的です。
- 小規模導入:限定範囲で予測を担当者に提示し、おおよそ3〜4ヶ月です。
- 中規模導入:複数の業務や拠点を基幹システムなどと連携させ、6〜9ヶ月です。
- 大規模導入:全社基盤を整備し、12ヶ月以上かかります。
データが整っていれば、PoCは1ヶ月台で進む場合があります。一方で、抽出・名寄せ・ラベル付けに手間取ると、3ヶ月近くかかることもあります。
中規模導入では細かな予測やデータ連携が加わり、開発・テスト・連携検証の工数が増えます。さらに、大規模導入では、多様なデータソースの統合だけで数ヶ月かかることもあります。
予測分析系のカスタム開発はおおむね200万〜800万円です。これに対し、大規模なフルスクラッチ基盤は、数千万円規模に達します。
予測値を示すコア部分にとどめると、期間はコンパクトになります。反対に、自動発注や自動制御までつなぐ場合は、連携とテストの工数が積み上がります。
一般的なシステム開発との開発期間の違い
一般的なシステム開発と機械学習開発では、工数の見積もりや進捗の測り方が異なります。
- 一般的な開発:要件を固めてから設計・実装・テストへ進み、成果物と工数はおおむね比例します。
- 工数の見積もり:仕様が決まれば画面数や機能数から逆算でき、日程を比較的読みやすくなります。
- 機械学習の精度:同じ要件でも、データの質と量で結果が変わり、試行錯誤の量は着手前に分かりません。
- 精度到達の差:1週間で届くデータもあれば、特徴量を作り直し、手法変更と再学習を重ねても届かない場合があります。
- 進め方:モデルを評価して特徴量や手法を見直し、再学習と再評価を繰り返すアジャイル型が主流です。
進捗は画面数では測らず、精度の向上や、予測に使えるデータの整備状況で測ります。
機械学習プロジェクトのライフサイクルと工程別スケジュール
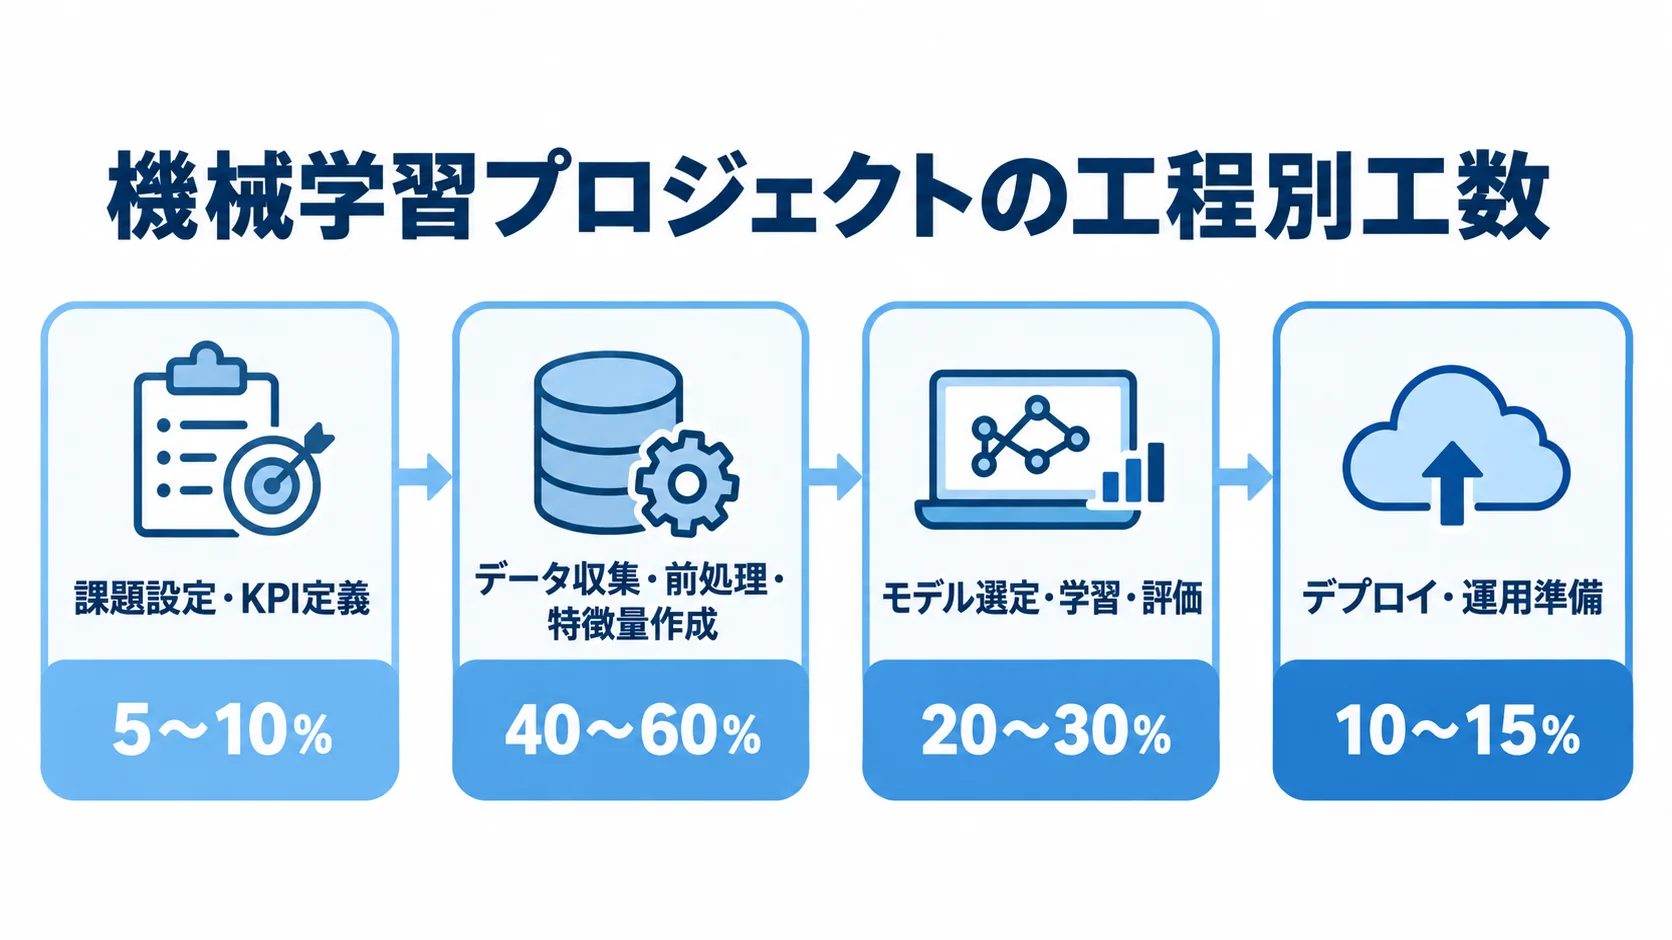
機械学習プロジェクトは、課題設定から運用・再学習(MLOps)までの工程に分かれます。工程ごとの工数配分をつかんでおくと、計画の組み立てに役立ちます。
- 課題設定・KPI定義:全体の5〜10%です。
- データ収集・前処理・特徴量作成:全体の40〜60%です。
- モデル選定・学習・評価:全体の20〜30%です。
- デプロイ・運用準備:全体の10〜15%です。
モデル作成というと、アルゴリズムを選んで学習させることだと考えがちです。しかし実際には、データを集めて整える作業こそ、機械学習開発の中心です。
従来の業務システム開発では、工数の中心が実装とテストにあります。一方で、機械学習では、その中心がデータとモデルへ移ります。
生成AIを開発工程に組み込むAI駆動開発では、コーディングやデータ処理スクリプトの生成を効率化でき、開発期間を30〜70%短縮できるケースもあります。
ただし、短縮できるのは主に実装まわりです。データの質を高め、精度を反復して作り込む作業には人の判断が要るため、その時間は開発会社と発注側で計画に確保しておく必要があります。
ライフサイクルは、データ準備までの前半と、モデル開発以降の後半に分けられます。
課題設定・データ収集・前処理・特徴量エンジニアリングフェーズ
ライフサイクル前半は、機械学習開発の成否の大部分を決める最重要フェーズです。各工程の期間と作業内容を、あらかじめ把握しておくことが大切です。
- 課題設定・KPI定義:1〜3週間で、成功基準をビジネス側と合意します。
- データ収集:2〜6週間。学習用データを集める作業です。
- 前処理・クレンジング:2〜6週間。データを整える作業です。
- 特徴量エンジニアリング:2〜4週間。生データを加工する作業です。
課題設定では、予測・分類の対象と、成功とみなす精度指標や水準をビジネス側と決めます。ここが曖昧なままだと、後工程で精度を上げても改善の目的が定まりません。
データ収集では、社内の基幹システムやログ、外部データなどを集めます。ただし、データの分散や権限、フォーマットの壁があると、想定以上に時間がかかります。
前処理では、欠損値を補完し、外れ値やノイズを除去します。さらに、表記揺れを統一し、重複データも排除します。
特徴量の作り方は精度を左右します。たとえば、日付から曜日・祝日フラグ・月末フラグを作ると、モデル精度が変わります。
教師あり学習では、正解ラベルを人手で付けるアノテーションも加わります。データ量が多いほど、その作業工数は膨らみます。そのため、前半の工程だけで、プロジェクト全体の半分近い期間を要することもあります。
モデル選定・学習・評価・デプロイフェーズ
データが整ったら、モデルを選んで学習させ、評価で目標水準に届くかを確かめたうえで本番環境へ導入します。この段階は、次の3工程に分かれます。
- モデル選定・学習:2〜6週間です。
- 評価:2〜6週間です。
- デプロイ:2〜4週間です。
課題に応じて、分類や回帰には勾配ブースティング(LightGBM、XGBoostなど)やランダムフォレストを使います。一方で、画像や自然言語にはディープラーニングを使います。
データは、訓練用・検証用・テスト用に分けます。訓練データで学習し、検証データで調整したあと、未使用のテストデータで汎化性能を測ります。
汎化性能は、未知のデータへの対応力です。ここを確かめておくことで、訓練データにだけ合った過学習を避けられます。
評価では、Precision(適合率)、Recall(再現率)、F1スコアを確認します。また、回帰ではRMSEやMAEなどを使い、目標水準への到達を検証します。
目標精度に届かなければ、特徴量エンジニアリングやデータ収集へ戻る反復が発生します。この往復があるため、スケジュールは読みにくくなります。
デプロイでは、モデルを本番環境に組み込みます。APIやバッチ処理で業務システムから呼び出せるようにし、監視の仕組みを整えて、運用へ引き渡します。
後半全体は、規模にもよりますが、2〜4ヶ月程度を見込んでおきます。
機械学習特有でスケジュールに影響する工程
機械学習開発の大枠を押さえたうえでも、特有の工程がスケジュールを読みにくくします。
学習手法の選択と、それに伴うデータ整備は、工数を事前に見積もりにくい工程です。精度をどこまで高めるかという調整も、期間に影響します。
この2点は見積もりにくいため、スケジュールにバッファを持たせておく必要があります。また、初期の段階で設計しておくことが、納期を守るうえで効果的です。
学習手法の選択(教師あり・教師なし・強化学習)とアノテーション
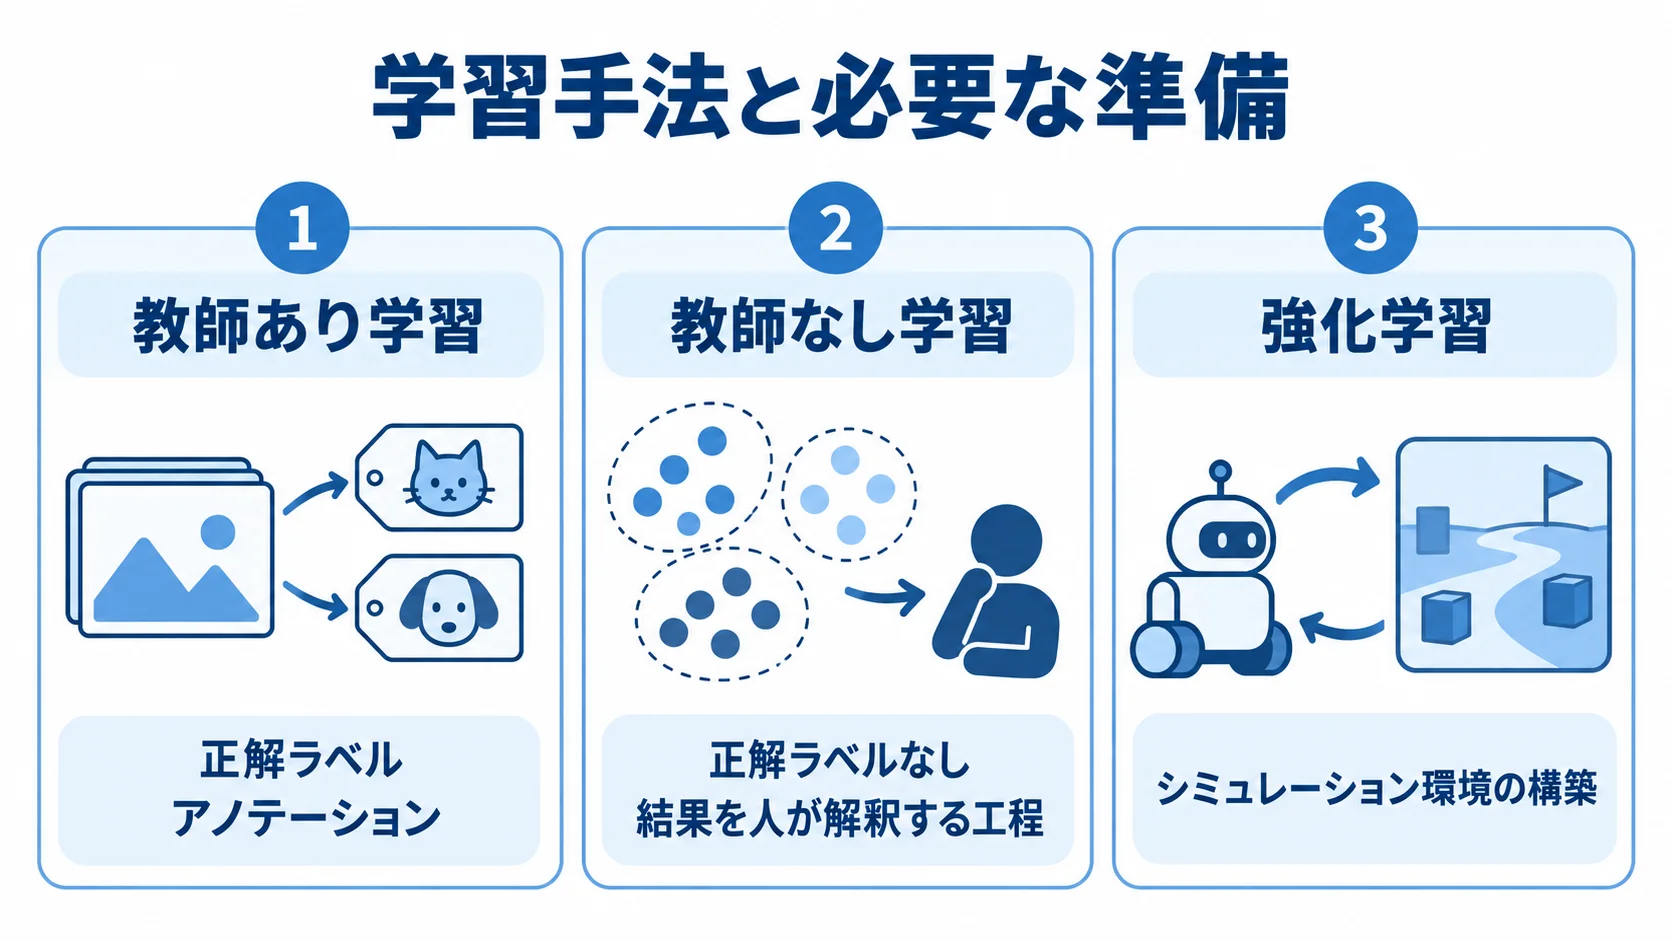
学習手法は、教師あり・教師なし・強化学習に分かれます。手法の選択によって必要な準備とスケジュールが変わるため、それぞれの特徴を比べます。
- 教師あり学習:正解ラベルを使い、予測や分類を行います。
- 教師なし学習:正解ラベルなしで、データの構造を捉える方法です。
- 強化学習:試行錯誤しながら、報酬が最大になる行動を学ぶ方法です。
教師あり学習は、入力と正解のペアを大量に学び、需要予測や不良判定など多くの業務で使われます。
教師あり学習では、正解ラベルを人手で用意するアノテーションが必要です。たとえば、画像に「不良/良品」のラベルを数千枚単位で付ける作業が、スケジュールに影響します。さらに、データ量が多い場合や、専門知識を要する判定では、アノテーションが長期化します。
教師なし学習は、顧客セグメントのクラスタリングや、正常データから外れた挙動を見つける異常検知に使われます。ラベル付けは要りませんが、結果を人が解釈する工程に時間がかかります。
強化学習は、価格最適化やロボット制御などに使われます。シミュレーション環境の構築が必要なため、他の2手法より難易度が高くなりがちです。そこで、自社の課題に合う手法と、必要なデータ準備を見極めることが、期間見積もりの起点になります。
精度と実用性のトレードオフと反復チューニング
精度チューニングの反復は、スケジュールを膨らませやすい工程です。精度100%を目指すと、期間が長引く可能性があります。
精度は一定水準まで比較的速く上がりますが、その先の1%を積み上げるには、多くの工数が必要です。
- 特徴量:作り直して効果を検証します。
- アルゴリズム:別の手法へ変えます。
- パラメータ:ハイパーパラメータの組み合わせを網羅的に試す作業です。
- データ:追加で集めて、学習に使い直します。
医療や金融のように誤りが許されない領域では、95%以上の精度が求められます。その分、反復回数が増え、期間が数ヶ月単位で延びます。
一方で、人間が最終確認するHuman-in-the-Loopを前提にすれば、80〜90%の精度でも効果が出る業務は少なくありません。
着手前に、業務で実用に足る精度ラインを定義します。そのうえで、到達後に作り込みを止める判断も、あらかじめ合意しておきます。
実用ラインの設計を怠ると、精度を追い続けて期間もコストも際限なく膨らみます。精度と実用性の折り合いが、期間管理の核心です。
反復チューニングは、一度のモデル作成で終わりません。その性質は本番リリース後も続き、運用中にデータを蓄積しながら、少しずつ精度を高めていきます。
そのため、初期開発に負荷を集中させない中長期の視点が必要です。最初から完璧を目指すより、実用ラインで公開して育てるほうが、価値を早く生み出せます。
納期遅延の典型要因と発注側の準備
機械学習プロジェクトが当初の予定を超える原因には、明確なパターンがあります。典型要因を把握し、発注側が事前に手を打つことで、納期遅延のリスクを下げられます。
機械学習開発は、発注側も関わって進める必要があります。データを持つのは発注側で、その協力度合いが、スケジュールを直接左右します。
遅延の要因と準備内容を、順に確認しておきます。
データ品質・精度未達による手戻り
データの問題は、納期遅延の最大の要因です。よくある状況を把握して、着手前の検証につなげることが大切です。
- 品質:機械学習に使えると想定したデータに欠損が多い。
- 分散:複数システムに散らばり、名寄せに時間がかかる。
- 蓄積量:過去データが十分に蓄積されていない。
機械学習には「Garbage In, Garbage Out(ゴミを入れればゴミが出る)」という原則があり、データ品質がモデル精度の上限を決めます。
データが汚れていると、高度なアルゴリズムを使っても精度は上がりません。そのため、データ整備へ戻る必要が出てきます。
目標精度に届かないと、特徴量エンジニアリングやデータ収集へ戻る反復が発生し、そのたびに数週間単位で期間が延びます。
手戻りは、機械学習開発では避けにくいものです。そこで、本開発でいきなり作り込まず、着手前に小さくPoCを行ってデータの実力を確かめてから本番に進みます。この段取りが、本開発での大きな手戻りを防ぎ、納期の短縮にもつながります。
現実的なスケジュールを引くための発注側の準備
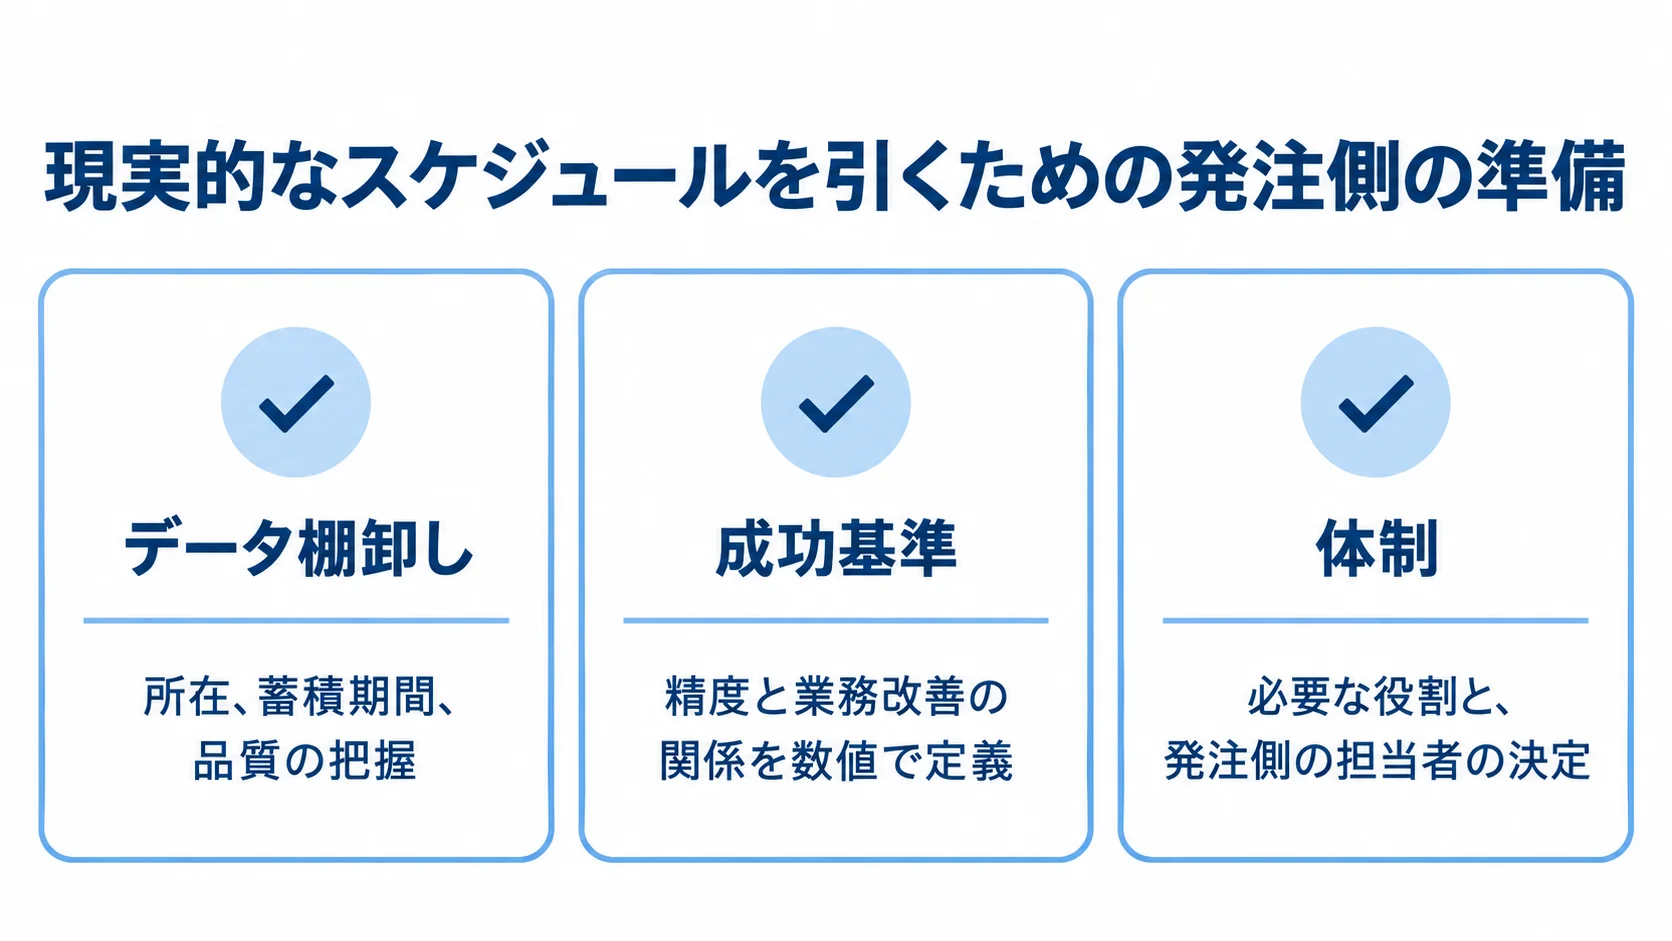
着手前の準備は、データ・成功基準・体制の3点です。この3点をそろえておくと、現実的なスケジュールを立てやすくなります。
- データ棚卸し:所在、蓄積期間、品質の把握
- 成功基準:精度と業務改善の関係を数値で定義
- 体制:必要な役割と、発注側の担当者の決定
データ棚卸しでは、どのシステムに何がどれくらいの期間、どんな品質で蓄積されているかを確認します。この確認により、データ収集・前処理を短縮できます。
可能であれば、ベンダーに渡せるサンプルデータを用意しておきます。そうすれば、初期の見積もり精度も上がります。
次に、成功基準(KPI)をはっきりさせます。達成する精度と期限、改善する業務を決めておきます。明確な基準があれば、終わりのない精度追求を避けて、実用ラインで着地できます。
機械学習開発には、課題を数理的に定式化してモデルを設計するデータサイエンティストのほか、学習・推論のパイプラインを実装し、MLOpsを担う機械学習エンジニアも必要です。
データ基盤を整えるデータエンジニアも関わります。発注側は、業務知識とデータの意味を説明できる担当者を立てておきます。現場の知見とデータ理解は欠かせず、発注側の当事者がいなければ、ベンダーが優秀でも計画どおりに進みません。
この3点をそろえることが、遅延を防ぐための準備になります。
まとめ
機械学習開発の期間は、規模で変わります。PoCは1〜3ヶ月が目安です。導入は規模別に見ると、小規模導入が3〜4ヶ月、中規模導入が6〜9ヶ月、大規模導入が12ヶ月以上です。
データ準備は全体工数の40〜60%を占めます。一般的なシステム開発と異なり、データとモデルの品質が日程を左右します。
課題設定からデプロイまでの工程配分は、前半のデータ準備と後半のモデル開発に分けて整理しました。前半にはデータ収集、前処理、特徴量エンジニアリングが、後半にはモデル選定、学習、評価、デプロイが含まれます。
精度反復の不確実性と、遅延要因や発注側の準備も整理しました。着手前に精度は確定できないため、反復期間と実用ラインを計画に含めておきます。
需要予測や不良検知などは、機械学習開発を経て実現する応用例です。まず自社データを棚卸しし、小さくPoCを行って精度とROIを確かめると、現実的な計画を立てられます。
▼全体ガイドの記事
・機械学習の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。