
機械学習開発では、用途を問わず、既製サービスから順に、フルスクラッチまで段階を追って、自社の課題への適合を確かめます。既製で難しい中核だけを作り込むと、費用対効果につながります。需要予測や不良検知、レコメンドでも、同じ考え方で判断します。
▼全体ガイドの記事
・機械学習の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
機械学習におけるフルスクラッチ開発の全体像
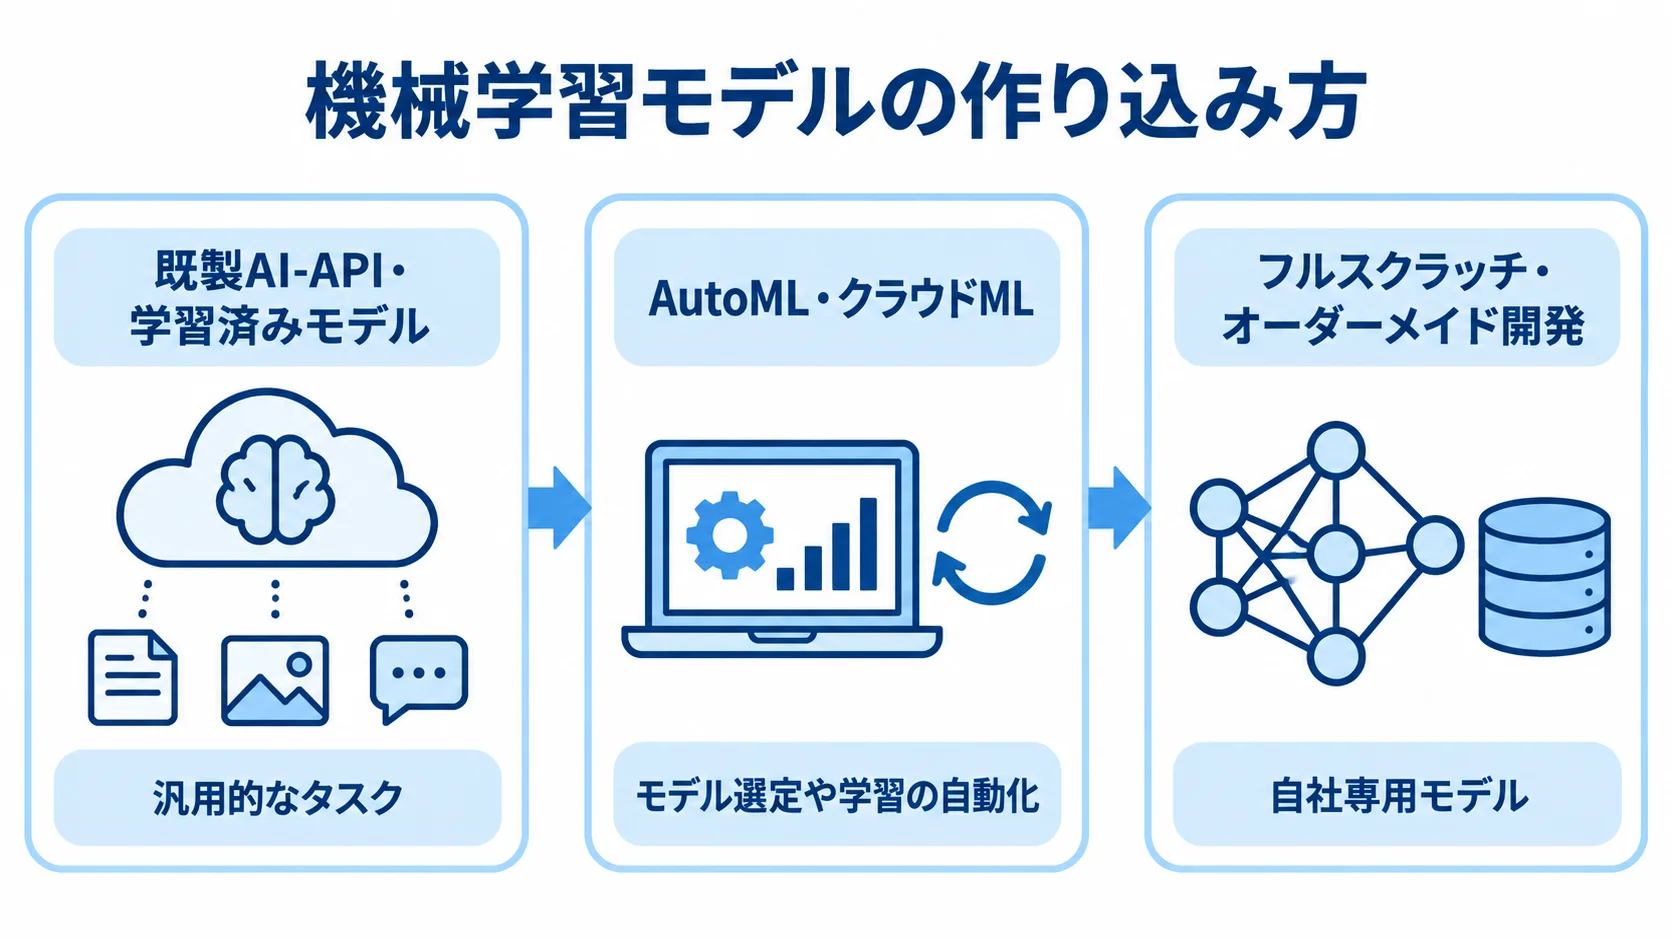
機械学習モデルの用意には、既製品をそのまま使う方法から完全に作り込む方法まで段階があります。方法の優劣より、自社の課題にどれだけ適合するかで選ぶことになります。
画像認識や自然言語処理のような汎用的なタスクであれば、既製のAI-APIや学習済みモデルを使えます。自前で学習させる必要はなく、APIを呼び出すことで一定の精度を得られます。
次の段階は、AutoMLやクラウドMLです。AWS SageMakerのAutopilot、Google Vertex AI、Azure Machine Learningなどを使えば、専門人材が手薄でも、データをアップロードしてモデルを作れます。これらは、モデル選定や学習をある程度自動化します。
最も作り込む段階が、フルスクラッチ・オーダーメイド開発です。PythonやPyTorchなどを使って、自社専用のモデルを実装します。
カスタマイズ性は高い一方で、高度な知識と費用・期間が必要です。そのため、まず軽い方法を試し、既製では満たせない要件がある場合に選びます。
既製サービス・AutoML・クラウドML・フルスクラッチの違い
それぞれの方法を、コスト、スピード、カスタマイズ性の点から比べます。用途と要件に照らして、合う選択肢を判断します。
- 既製サービス:初期費用と学習コストが低く、数日で使い始められます。ただし独自要件には対応できません。
- AutoML・クラウドML:開発速度とコストのバランスを取りやすい反面、内部の制御には限界があります。
- フルスクラッチ:モデルの構造、特徴量、学習方法を要件に合わせて設計できる一方、数ヶ月の期間と専門知識、高額な費用が必要です。
AutoMLなどは前処理やアルゴリズム選定の一部を自動化するため、専門人材が少なくても一定水準のモデルを構築できます。極限の精度や特殊なアルゴリズムが必要な場合には、この方法が向かないことがあります。
要件がシンプルで汎用的なら、既製やAutoMLで十分です。そのうえで、競争力の源泉となる中核だけを作り込めば、費用対効果を保ちやすくなります。
機械学習でフルスクラッチが選ばれる理由
フルスクラッチが選ばれるのは、既製モデルでは要件を満たせない場面です。その理由は、いくつかのパターンに集約されます。
- 独自データ:特殊なデータや業界固有の文脈に合わせ、特徴量やモデルを設計できます。
- 高精度の要求:医療診断の補助や金融の与信判断など、精度差が価値や損失につながります。
- 機密性:オンプレミスや閉域網の中で、機密データを扱う要件に応えられます。
- 密な連携や移行自由度:基幹システムと結合しながら、ベンダーロックインを避けられます。
独自の社内システムやデータベースを業務プロセスに組み込む場合も、柔軟な作り込みが求められます。標準技術で構築すれば、将来のインフラ移行や技術の乗り換えにも備えられます。そうした要件が強い場合に、フルスクラッチが選択肢に入ります。
フルスクラッチで実現できる範囲
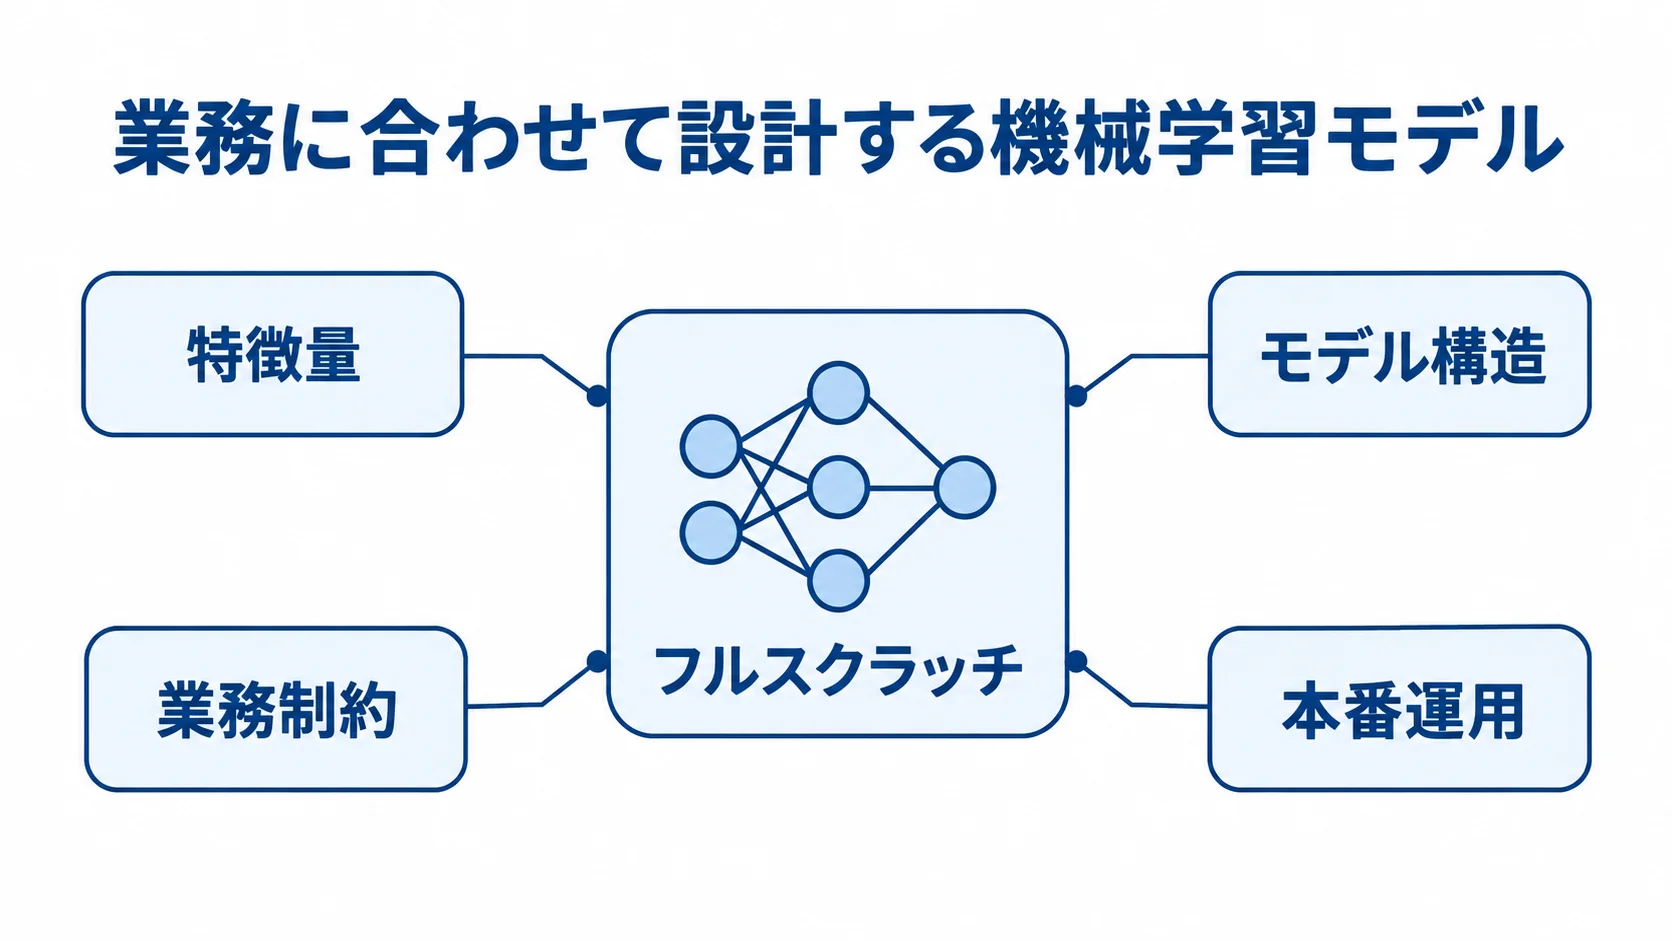
フルスクラッチの価値は、既製品では届かない領域に対応できることにあります。独自要件への適合と、機密データを守る既存システムとの連携が、採用を判断する材料になります。
独自のアルゴリズム・特徴量・制約条件の作り込み
モデル設計を自社の課題に合わせられることが、フルスクラッチの最大の強みです。精度は、アルゴリズム以上に、与える特徴量によって左右されます。
- 特徴量:値の比率や時間帯別の指標など、業務知識に基づく仮説を組み込めます。
- モデル構造:アンサンブルや特殊なニューラルネットワーク、独自の損失関数を実装できます。
- 業務制約:予測値を0以上にする、合計を在庫量以下にするといった条件を、モデルに反映できます。
- 本番運用:エラー時の挙動、例外処理、人間が最終確認する手順(Human-in-the-Loop)を組み込めます。
既製のAutoMLは標準的なアルゴリズムの中からモデルを選ぶため、特殊な構造や制約を実装するには限界があります。一方で、制約をモデルに反映すれば、現実離れした値の予測を防ぎ、業務で使える出力を設計できます。こうした自由度によって業務に完全に適合させられる点が、フルスクラッチの大きな価値です。
機密データの社内保持と既存システムとの密な連携
機密データを外部サービスに送れない場合は、自社環境の中で構築する方法が選択肢になります。規制や社内ポリシー、顧客との契約が、その制約になることがあります。
- データ管理:機密データを外部に出さず、機械学習に活かせます。
- 業務システム連携:独自のシステムやデータベースと深く連携できます。
対象になるのは、顧客の個人情報、取引データ、技術情報などです。これらは、オンプレミス環境やプライベートクラウド、閉域網内に構築できます。金融、医療、製造など、データの機密性が特に高い業界では、フルスクラッチを選ぶ理由になります。
既存の基幹システムとの密な連携も、フルスクラッチが得意とする領域です。標準APIではつながらない社内システムやデータベースにも連携でき、予測結果を業務プロセスへ組み込めます。たとえば、生産管理システムからデータを取り込み、予測結果を発注システムへ自動連携する仕組みを構築できます。
既製サービスは、サービス内で完結する設計が多いため、深い連携には限界があります。データの保護と業務システムの一体化が必要になるほど、作り込む価値が高まります。
フルスクラッチのコスト・期間・人材と過剰投資の罠
フルスクラッチは価値を生む一方で、費用・期間・人材を要します。判断を誤れば過剰投資にもなるため、費用とリスクを見極めたうえで、Buy or Build(買うか作るか)を考えます。
費用・期間・データサイエンス人材の確保
フルスクラッチの費用と期間は、開発規模や要件によって変わります。代表的な目安と、人材面で必要な条件を見ていきます。
- 予測分析系:初期費用200万〜800万円、月額運用費10万〜30万円、期間3〜6ヶ月程度。
- 大規模基盤:初期費用が5,000万円から1億円以上に達することもあります。
- 専門人材:データサイエンティストと機械学習エンジニアが必要です。
独自の高度なアルゴリズムや、複数システムとの深い連携が加わると、費用はさらに上振れします。全社横断のAI基盤や、大規模なGPUクラスタを使う独自の学習基盤の構築も、大規模開発に当たります。
この規模は、高度な専門性や機密性を求められる大企業のケースです。汎用サービスでは満たせない独自要件があってはじめて、正当化されます。
データサイエンティストは、課題を数理的に定式化してモデルを設計します。機械学習エンジニアは、学習と推論のパイプラインを本番に実装し、MLOpsを担います。どちらも欠かせませんが、こうした人材は希少で高額なため、自社で揃えるのは容易ではありません。
外部委託でも、機械学習に精通した開発会社は限られます。そのため、パートナー選びが成否を左右します。開発と運用を担う人材の確保も、あわせて見通しておきます。
過剰なフルスクラッチを避けるBuy or Buildの判断
AutoMLや既製サービスで足りるのに、フルスクラッチに多額を投じてしまう失敗があります。Buy or Buildでは、まず既製やクラウドMLで対応できないかを検討します。
- 解きたい課題を、要素ごとに分けます。
- 各要素を既製APIで扱えるか、AutoMLで十分な精度が出るかを確かめます。
- 学習済みモデルを転用できるかを見て、競争力の源泉となる中核だけを作ります。
すべてを一から作ると、車輪の再発明となり、コストと時間を浪費しがちです。「フルスクラッチのほうが高精度」という思い込みにも注意が必要です。
データの質が同じであれば、AutoMLと丁寧に作ったモデルの精度差はわずかなこともあります。その差に対して、投じる費用が見合わないケースも珍しくありません。精度を左右する最大の要因は、開発手法そのものではなく、データの質です。
まず軽い手法を試し、越えられない壁が明確になってから作り込みます。この段階的な判断は、過剰投資を防ぎ、投資対効果を高めることにつながります。
発注時の契約とベンダー選定
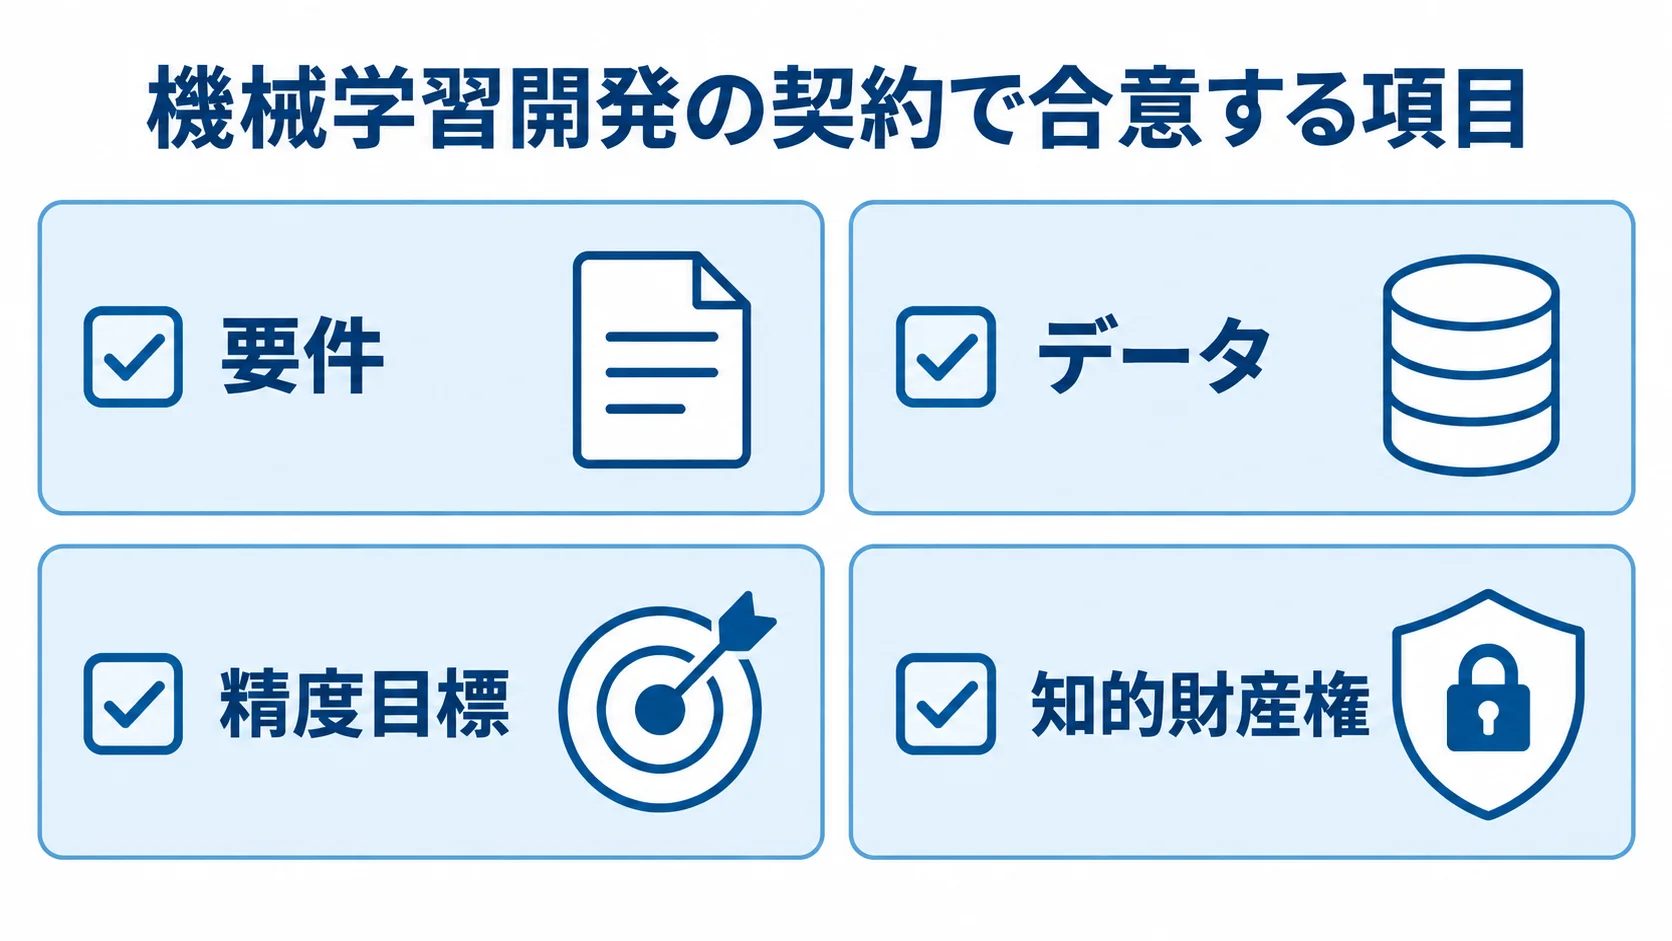
外部に発注する場合は、契約設計とベンダー選定が成否を左右します。機械学習ならではの視点で、要件・データ・精度目標を中心に、段階的なスコープの考え方を見ていきます。
要件・データ・精度目標を取り決める契約設計
精度を契約で保証するのは、容易ではありません。機械学習の精度は提供データの質に左右されるため、ベンダーが精度を一方的に保証するのは現実的ではありません。
そのため一般には、精度そのものではなく、合意した水準を目指して定めた手順で開発と検証を進めるプロセスを契約の対象にします。準委任契約に近い考え方で、発注側もデータ品質の確保に協力します。
- 要件:何を予測・分類し、結果を業務でどう使うかを文書にします。
- データ:学習に使う材料を、誰が、どの品質で、いつまでに用意するかを決めます。
- 精度目標:評価指標と水準、未達時の対応を定めます。
データの準備が遅れるとプロジェクト全体も遅れるため、役割分担を明記しておくことが欠かせません。
モデルやコードの知的財産権、学習データの扱い、成果物をどこまで渡すかも、契約時に定めておきます。曖昧なまま進めると、トラブルの原因になりかねません。
段階的スコープとベンダー選定
まずPoC(概念実証)で、データの実力と実現可能性を確かめてから本開発へ進めば、投資リスクを下げられます。データによる精度の限界が分かれば、本開発への投資を冷静に判断できます。精度の見通しを立ててから進むため、手戻りも減ります。
- 機械学習の実績:専門知識と類似プロジェクトの経験を確かめます。
- データへの姿勢:モデルより先に、データの有無や品質を確かめる姿勢も、実力の指標になります。
- 運用体制:精度の劣化や再学習に対応し、公開後の運用・保守まで支援できるかを確かめます。
システム開発の実績に加えて、データサイエンスや機械学習の専門性と実績があるかを見極めます。複数社から相見積もりを取り、金額だけでなく、技術提案の質や自社課題への理解度も比べます。信頼できる相手と段階的に進めることが、成功への道筋です。
まとめ
既製・AutoML・クラウドMLとの使い分けと、フルスクラッチが選ばれる理由を見てきました。独自設計や機密データとの連携も扱っています。
予測分析系の初期費用は200万〜800万円、大規模基盤では5,000万円から1億円以上に達することもあります。加えて、専門人材を継続して確保することも必要です。
精度は、開発手法よりもデータの質に左右されます。そのため、PoCで確かめれば過剰投資を防ぎやすくなります。契約と信頼できるパートナーの確保も、欠かせない要素です。
需要予測や不良検知などでも、既製とフルスクラッチのどちらが適するかを見極めます。自社の要件に合う方法を選びましょう。
▼全体ガイドの記事
・機械学習の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。