
機械学習の運用費は、開発費、精度維持の度合い、推論の頻度や規模で変わり、年額は初期開発費の15〜30%が目安です。
個別の業務を支える本番運用に共通する費用構造を見ると、正しい見積もりが採算を左右することが分かります。全体像は機械学習の完全ガイドもご覧ください。
▼全体ガイドの記事
・機械学習の完全ガイド
AIシステム開発の費用の考え方や見積もりの注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
▼見積依頼前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
機械学習システムのランニングコストの全体像
運用保守費は、一般に初期開発費の15〜30%が年間相場です。初期開発費が600万円なら、年間90万〜180万円、月額換算で8万〜15万円程度です。
これは目安で、精度を維持する厳密さや推論の頻度・規模によって上振れします。機械学習の費用は、サーバー維持費だけで決まるものではありません。
通常のシステムは、障害対応やセキュリティパッチで品質を保てます。一方、機械学習モデルは時間とともに精度が落ちるため、維持・改善の費用が必要になります。
この違いを理解しないまま「作れば後は安い」と考えると、運用段階で想定外の費用が生じます。たとえば、PoCや初期開発では小さなデータで良い精度が出ても、本番でデータや利用シーンが広がると、費用が膨らむことがあります。
投資判断では、開発費だけでなく毎月・毎年の運用費も試算します。そのうえで、数年分の費用と、運用費を上回る業務改善効果を見込めるかを確認します。運用費用の中身は、区分ごとに分けると具体的に見えてきます。
3つの費用区分と見落とされやすい隠れコスト
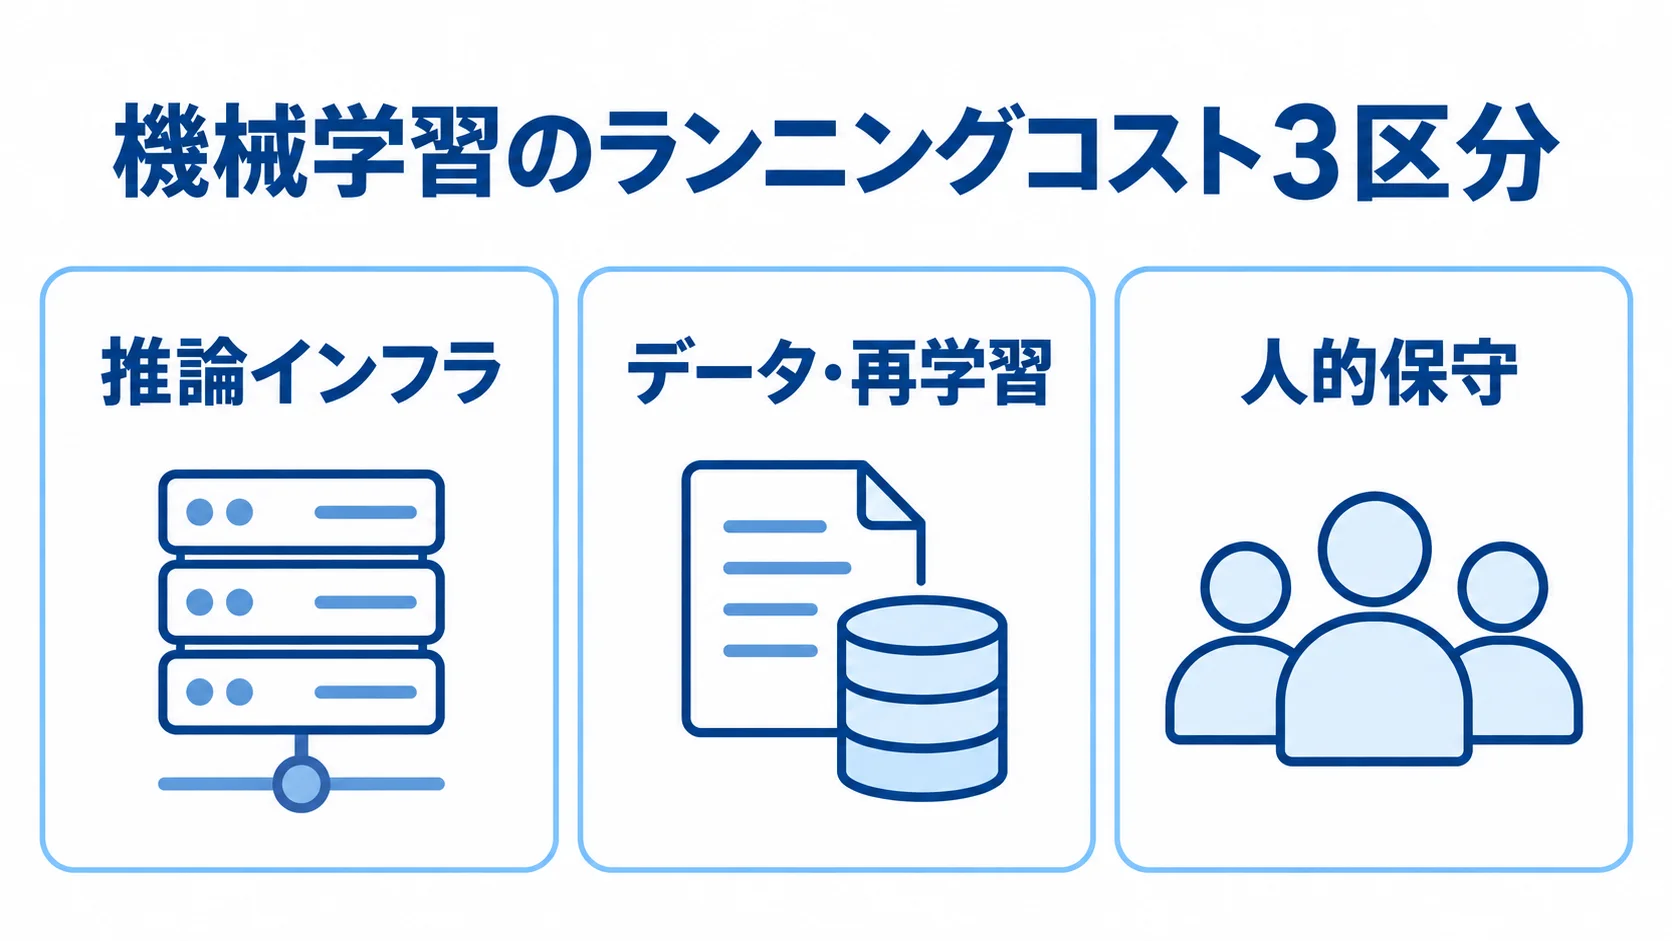
ランニングコストは、次の3区分で見ると全体を把握しやすくなります。
- 推論インフラ:予測を返すサーバーやクラウドの費用。
- データ・再学習:データ整備とモデル再学習にかかる費用。
- 人的保守:モデル監視と精度改善を担う人件費。
推論インフラはトラフィックに応じる変動費で、月額5万〜50万円が目安です。条件によっては、運用費全体の80〜90%を占めることもあります。
データパイプラインの維持は月3万〜10万円、モデル再学習は1回50万〜200万円です。一方、人的保守費用は、最も大きな固定費になりやすい項目です。
見積書には表れにくい隠れコストもあります。GPUサーバーは、利用率が低いままアイドル時間が続くと、その時間にも費用がかかるケースがあります。
精度劣化に気づかず誤予測を続けると、業務側に損失が生じることもあります。そのため、発注側と開発会社は、運用設計の段階で対策を検討しておく必要があります。
一般的なシステムとの費用構造の違い
両者は、保守の作業内容と費用の発生要因が異なります。
- 一般的な業務システム:バグ修正や機能追加など、壊れた箇所を直し、時代に合わせて手を入れる保守が中心です。
- 機械学習システム:学習に使った過去のデータと現実の最新データがずれ、精度が下がります。
- 保守の違い:変化を検知し、精度維持のためモデルを継続して作り直す点です。
一般的なシステムは、放置しても機能自体は劣化しません。一方で機械学習では、嗜好や市場環境、新商品、季節の変化がモデルの前提を変え、予測に影響します。
この構造差が、機械学習の運用費を通常のシステムより読みにくく、高くしがちな根本原因です。見積もりには、精度維持への継続投資を含めます。
モデルの精度を維持するための費用(MLOps)
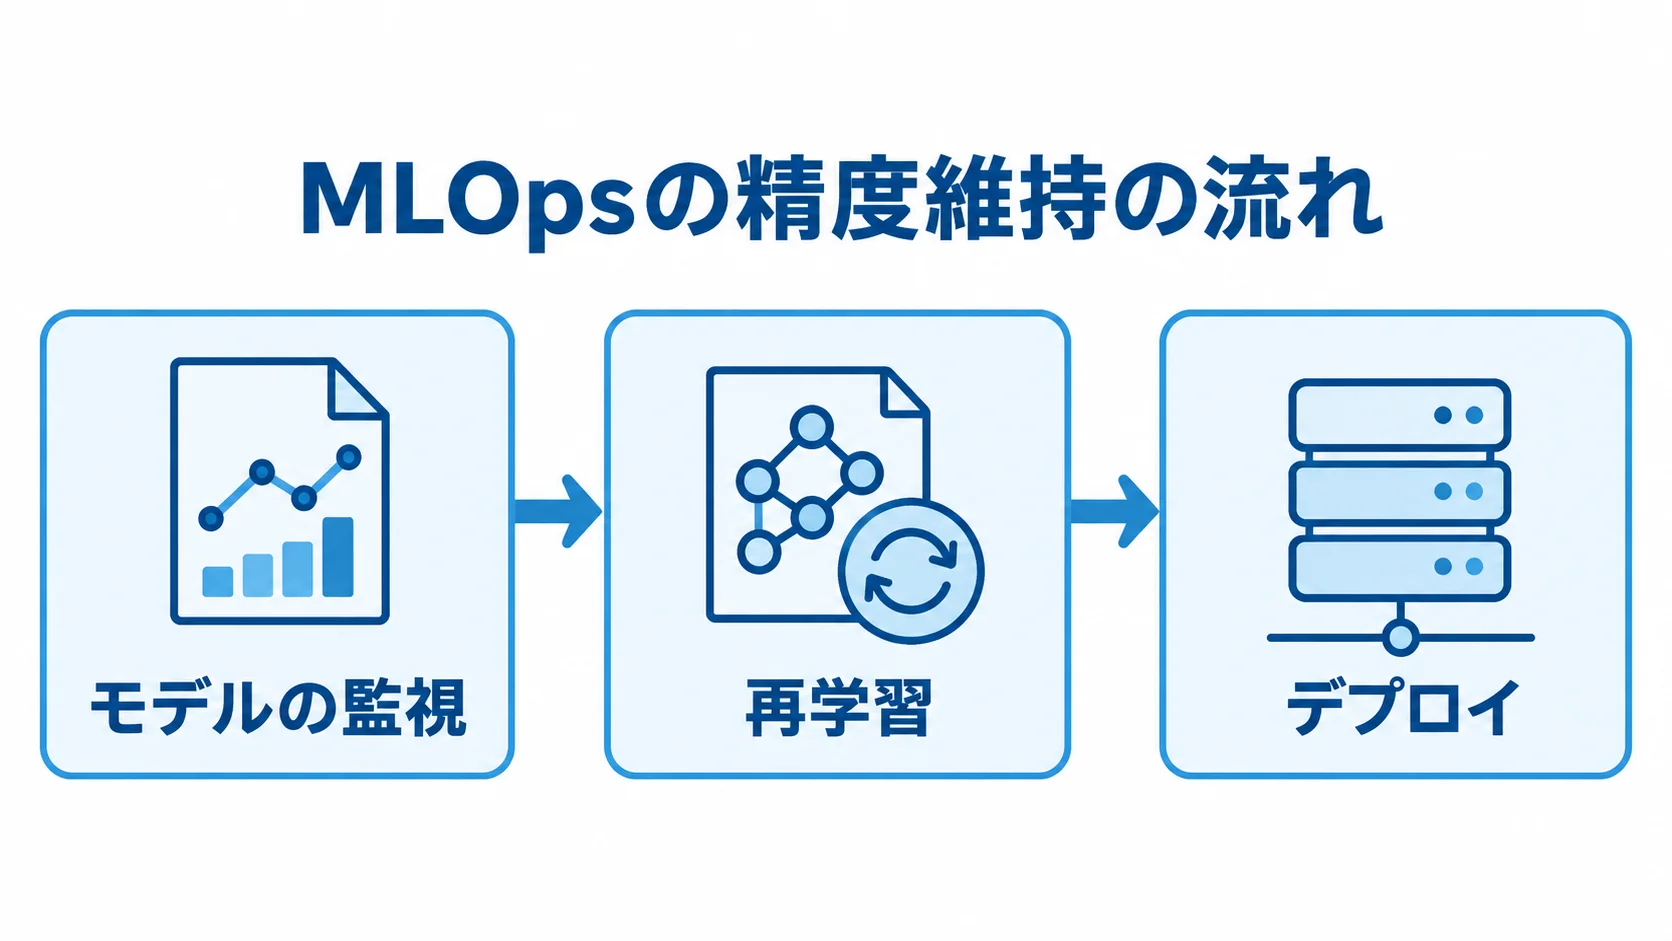
MLOps(Machine Learning Operations)は、機械学習モデルの精度を保ち、改善する仕組みと運用です。ソフトウェア開発のDevOpsを、機械学習に応用したものです。
MLOpsでは、モデルの監視、再学習、デプロイを自動化し、一連の流れとして回せるようにします。これを軽視すると、精度劣化に気づかないまま、誤予測に基づく業務判断が続くおそれがあります。
精度の変化を早く捉え、必要なときに再学習すれば、費用を抑えながら品質を保てます。主な費用は、精度監視と再学習、データパイプラインの維持です。
精度劣化(データドリフト・コンセプトドリフト)の監視と再学習の費用
精度劣化には、データ分布が変わるデータドリフトと、入力と出力の関係が変わるコンセプトドリフトがあります。
- データドリフト:顧客層や商品カテゴリの変化で、入力データの傾向が変わります。
- コンセプトドリフト:市場環境の変化などで、入力と出力の関係のルールが変わる現象。
検知するには、本番の予測結果と実際の結果を照合し、精度指標を継続して監視します。監視と精度分析を担う運用チームの費用は、規模に応じて月額数十万〜数百万円です。
精度が閾値を下回った場合は、新しいデータで再学習します。1回50万〜200万円が目安で、データ準備と計算資源(GPU)の費用を含みます。
年2〜4回の定期再学習が一般的で、精度を維持する厳密さによっては、年間100万〜800万円規模の変動費になります。また、再学習モデルのリグレッションテストと再評価には、1回100万円以上かかることもあります。これらは、機械学習を運用するうえで避けられない構造的な費用です。
データパイプライン維持・チューニング費の目安
継続費用は、データ供給の仕組みとモデルの調整作業に分けて見積もります。
- パイプライン:社内システムやログから学習データを集め、前処理する自動処理です。
- 維持費と停止時の影響:月額3万〜10万円程度で、安定稼働を保ち、停止による精度劣化を防ぎます。
- チューニング作業:特徴量の見直しやハイパーパラメータ調整に、専門人材の稼働費がかかります。
- 見直し頻度:四半期に一度なら、1回あたり数十万円規模の工数です。
- 費用管理:複雑さやデータ量に応じて増えるため、運用設計で自動化と人手の配分を決めます。
シンプルなモデルなら負担は軽微ですが、多数の特徴量や頻繁な更新が必要な業務では、費用が膨らみます。
機械学習特有でコストに影響する要素
同じ機械学習システムでも、構成によってランニングコストは変わります。特に影響するのは、推論インフラの選び方と、運用を担う人的体制です。
この2つは費用の大部分を占めますが、工夫によって大きく削減できる余地もあります。それぞれの影響と、無駄を抑える考え方を整理します。
推論インフラ(GPU・オンライン/バッチ)と処理規模
モデルの計算負荷と応答時間の要件を踏まえて推論方法を選ぶと、費用を見積もりやすくなります。
- 軽量モデル:勾配ブースティングなどは、一般的なCPUサーバーで動作します。
- ディープラーニング:画像認識や自然言語処理では、推論にGPUが必要となり費用が上がります。
GPUサーバーを常時稼働させると、固定費が高くなります。アイドル状態の時間が70〜85%に達し、無駄が生じるケースも報告されています。
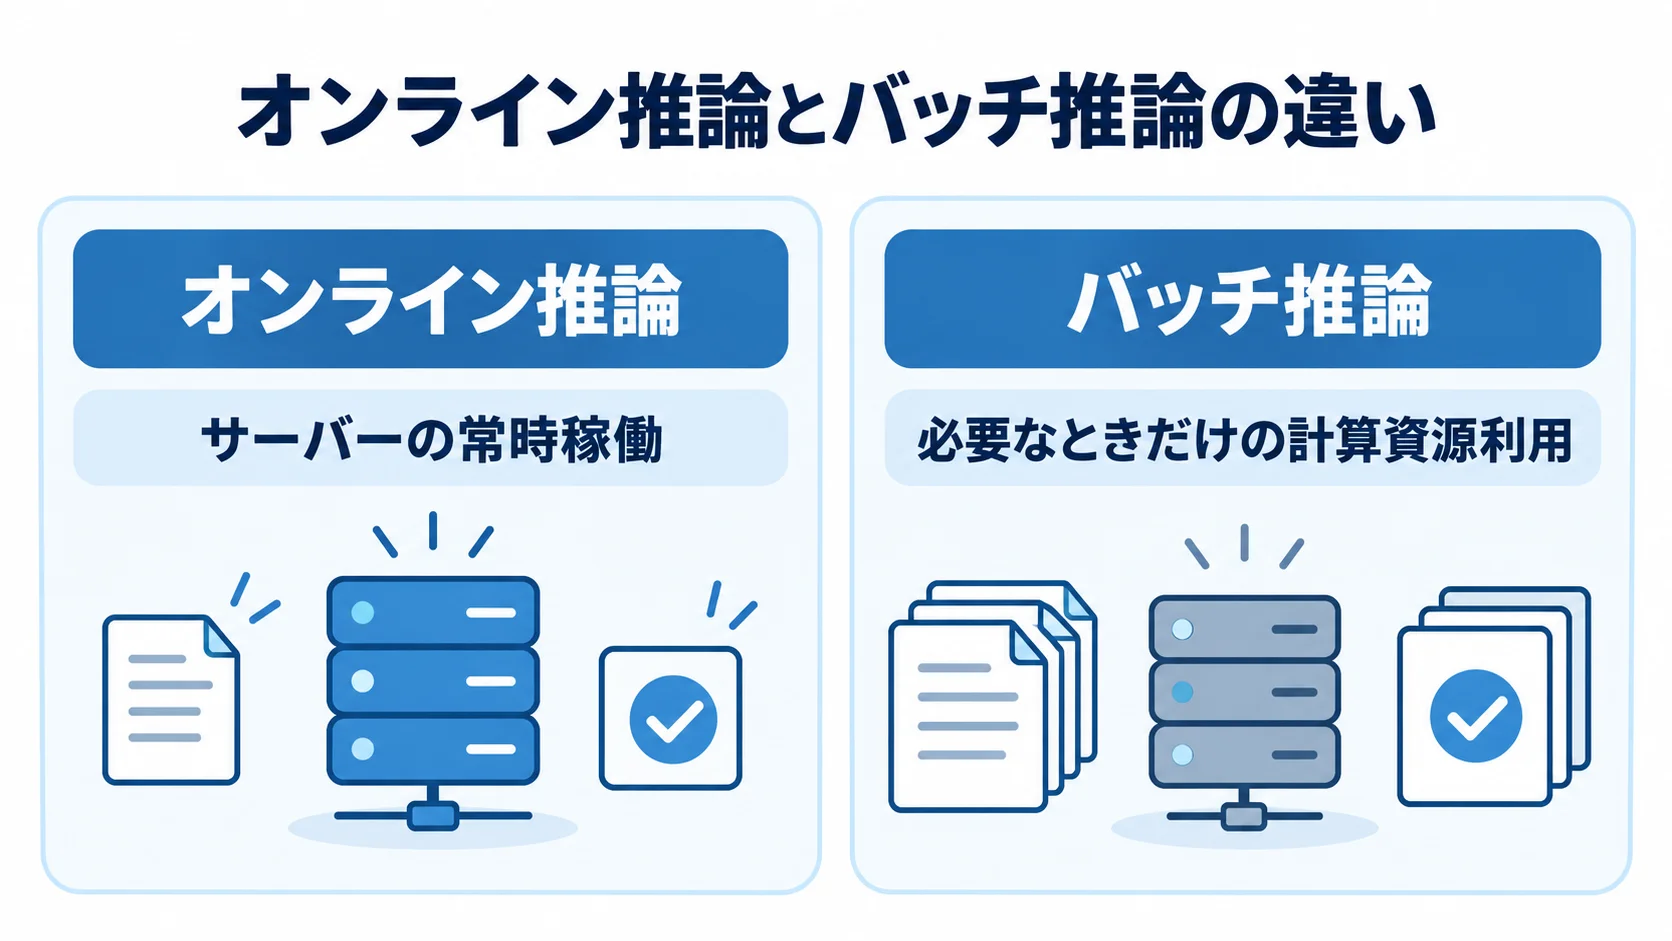
提供方式にも差があります。オンライン推論は、リクエストのたびに即時予測するため、サーバーを常時稼働させる固定費がかかります。
バッチ推論は、夜間などにまとめて予測します。必要なときだけ計算資源を使うため、リアルタイム性が不要な業務では運用費を大幅に抑えられます。
リクエスト数が増えると、従量課金も増えます。想定利用量に応じて設計し、利用の少ない時間帯に規模を自動で縮小する動的スケーリングも検討します。
人的体制(機械学習エンジニア・データサイエンティスト)の稼働費
運用費では、人的体制が最も大きな比重を占めることがあります。精度を維持・改善するには、専門人材の関与が欠かせません。
- 上級機械学習エンジニア:月額60万〜120万円程度です。
- 中級データエンジニア:月額30万〜60万円程度です。
上級者は、高度なチューニング、再学習パイプラインの設計、推論インフラの最適化を担います。一方、中級者は、学習データの収集、パイプラインの維持、前処理の自動化を担当します。
実データの評価やフィードバック分析、精度改善のチューニングを担う運用チームには、月額数十万〜数百万円かかることもあります。人件費は稼働中、毎月固定的に発生します。
体制は、自社で内製するか、外部ベンダーへの準委任などで委託するかを選びます。専門人材は希少で高額なため、内製には費用と採用の両面でハードルがあります。
外部委託では、社内に知識が蓄積されにくいという難点があります。そこで、まず委託で立ち上げ、徐々に内製化するハイブリッド体制を取る企業もあります。
人的費用を低く見積もると、運用段階で採算が崩れます。そのため、初期段階から現実的な体制費を含めておきます。
保守契約とTCO最適化のポイント
ランニングコストを管理するには、保守契約を設計し、TCO(総保有コスト)の視点で最適化します。TCOは、初期開発費とインフラ・人件費・再学習費などの合計です。
運用費は積み上がりやすいため、目先の初期費用ではなく、数年分のTCOで投資判断します。安いベンダーを選んでも、運用保守費が割高になることがあります。契約で押さえる点とTCO最適化の実践策は、どちらも運用費の増減に関わります。
保守範囲と精度SLAを明確にする契約設計
保守範囲は、契約の段階で明確にしておきます。通常の契約では、バグ修正やインフラ監視を含んでも、モデルの再学習や精度改善が対象外になることがあります。
- 保守範囲:精度監視、ドリフト検知、定期再学習とその評価を含めるかを決めます。
- 精度SLA(サービス品質保証):精度が一定水準を下回ったときの対応と、年あたりの再学習回数を定めます。
契約で定めた回数を超える再学習が発生したとき、追加費用がどう生じるかも決めておきます。精度SLAは、運用中の認識違いや費用の膨張を防ぐ助けになります。
入力データの状態が精度を左右するため、ベンダーが一方的に高精度を保証するのは現実的ではありません。そのため発注側も品質確保に協力し、双方で実際に達成できる水準に合意しておきます。保守範囲と精度の取り決めを曖昧にしたまま運用に入ると、後のトラブルや費用超過につながります。
精度劣化を早期検知する監視体制とTCO最適化
TCO最適化の鍵は、精度劣化を早期に自動検知する監視体制と、業務に合った計算資源の使い方です。
- 早期検知:遅れると誤予測の損失が積み上がり、大規模な再学習が必要になることがあります。
- 監視の自動化:精度を常時監視して閾値を下回ると通知し、必要なときだけ再学習することで、長期の費用を抑えます。
- 計算資源の削減:量子化や蒸留により、精度をほとんど落とさず計算量とインフラ費を減らします。
- 推論とモデルの使い分け:可能な業務ではバッチ推論に切り替えると、大幅に削減できます。頻出の予測はキャッシュし、処理別にモデルを選びます。
- 実用精度の設定:過剰な精度を避けて再学習や調整の費用を抑え、業務上必要な水準を定めます。
まとめ
年間の運用費は初期開発費の15〜30%が目安です。費用区分からMLOps、コスト要因、保守契約とTCOまで、順に見てきました。
精度は時間とともに劣化するため、監視と再学習の支出が恒常的に発生します。再学習は1回50万〜200万円で、年2〜4回が一般的です。
推論インフラは月5万〜50万円、人件費は月30万〜120万円規模が目安です。
バッチ推論、モデル軽量化、監視自動化を検討し、数年分のTCOと実用上必要な精度を踏まえて採算を判断します。需要予測や不良検知も、機械学習運用の基盤に支えられています。
▼全体ガイドの記事
・機械学習の完全ガイド
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。