
自然言語処理(NLP)の開発は、PoCで精度を確かめ、規模に応じて本番環境を構築し、運用中も精度を改善していく流れで進みます。期間は導入の規模によって大きく変わり、PoCの1〜2ヶ月から、大規模導入の4ヶ月〜1年以上までの幅があります。
自然言語処理は、形態素解析や構文解析といった基礎処理から、分類、感情分析、固有表現抽出(NER)、要約、機械翻訳までを含みます。近年は、ChatGPTに代表される大規模言語モデル(LLM)により、NLPの精度と汎用性が高まりました。
▼全体ガイドの記事
・自然言語処理の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
自然言語処理開発の期間の全体像
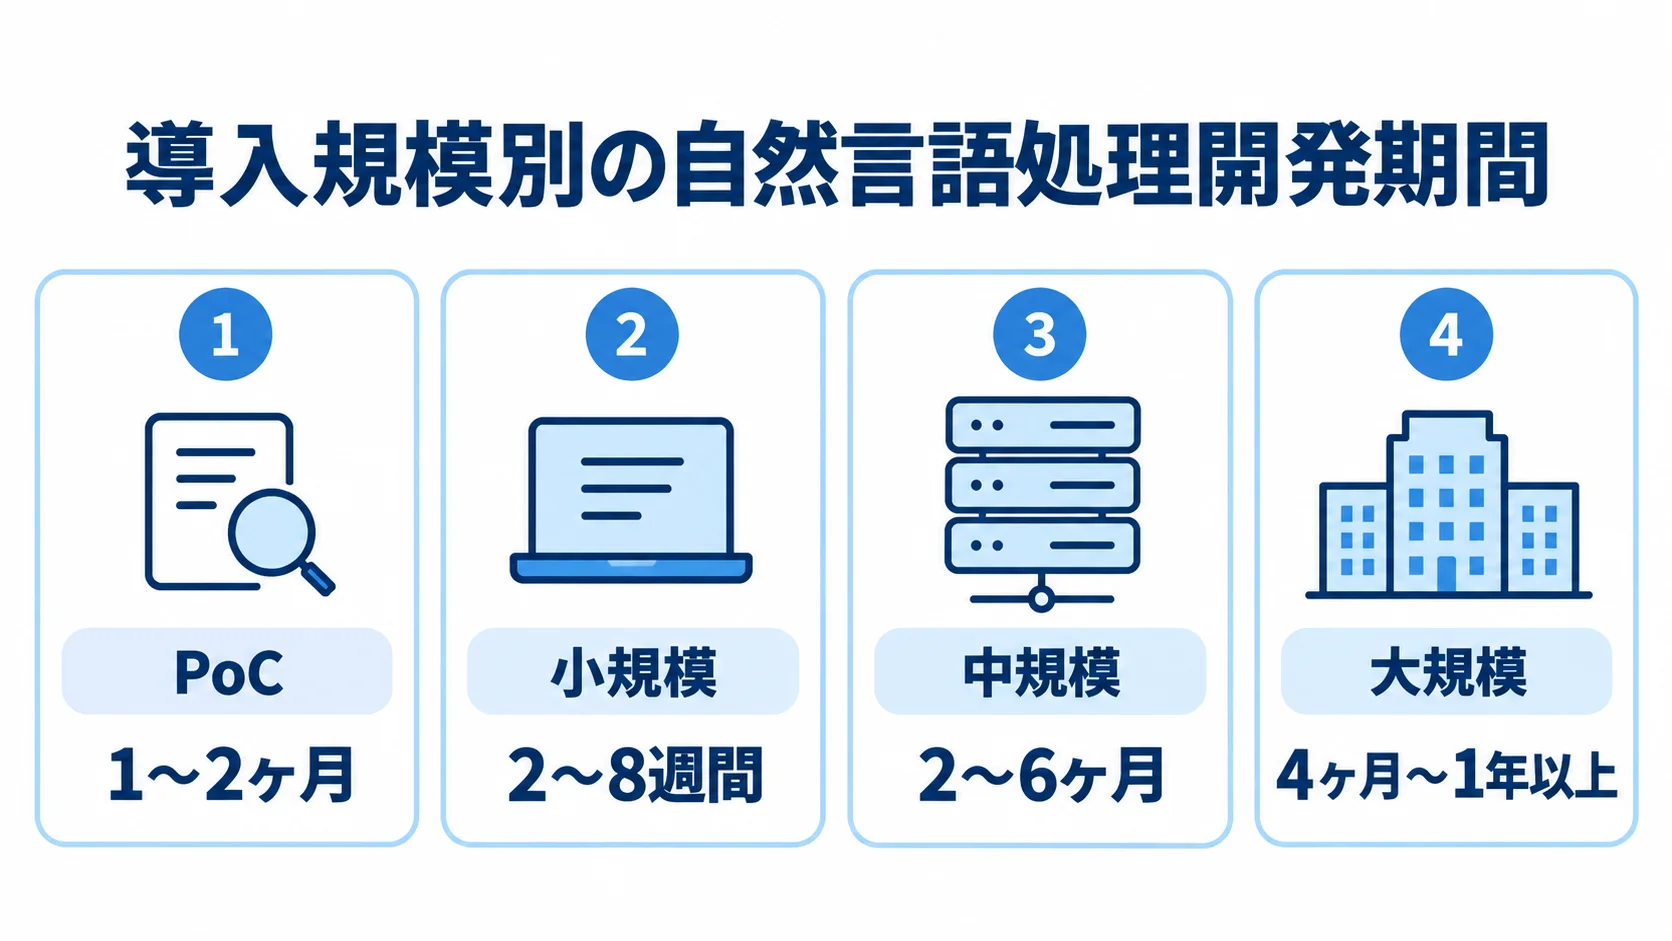
自然言語処理開発の期間は、テキストの量と質、タスクの難易度、目標精度で変わるほか、業務への組み込み範囲にも左右されます。一般にはPoCで1〜2ヶ月かけて精度を確かめ、本番システムを数週間から1年以上かけて構築します。
NLPは要件どおりに作れば完成するとは限らず、着手前に目標精度へ届くかを確定できません。
日本語には英語のような分かち書きがなく、文章の区切りや意味の単位を決める形態素解析からつまずきやすくなります。このため、期間の見積もりも不確実になります。
そのため、精度を高める反復期間を確保しておく必要があります。分類結果の表示にとどめるか、業務システムと深く連携するかによっても、期間は変わります。
規模別・目的別の開発期間の目安
導入規模ごとの期間と用途を並べると、検討中のプロジェクトに近い目安をつかめます。
- PoC:精度と投資対効果(ROI)を見極める段階。
- 小規模:単一タスクを既存APIや事前学習モデルで実用化する。
- 中規模:部門で運用し、認証や既存システム連携を含む。
- 大規模:全社のテキスト統合と日本語モデルの検証を伴う。
PoCでは、問い合わせ履歴やレビュー、社内文書など実際のテキストを使ってモデルを試作します。
PoCは1〜2ヶ月が一般的で、データが整っていれば1ヶ月台に収まります。一方で、抽出・匿名化・ラベル付けに手間取ると、2ヶ月近くかかります。
小規模導入は2〜8週間が目安です。たとえば、社内文書の分類や定型問い合わせの振り分けであれば、既存のクラウドNLP APIや事前学習モデルを使って短期間で導入できます。
中規模導入は2〜6ヶ月です。認証やアクセス制御、業務アプリや社内DBとのAPI連携が加わるため、開発や検証の工数が増えます。
大規模導入は4ヶ月〜1年以上です。複数部門のテキスト統合、日本語特化モデルの検証、専門用語辞書の整備を合わせると、それだけで数ヶ月かかる場合があります。
費用は、既製APIを使う小規模開発で数十万〜数百万円、連携込みのオーダーメイド構築で2,000万〜5,000万円規模に達することもあります。
処理結果の表示にとどまるなら期間は短くなりやすいです。ただし、後続処理や意思決定に直結させるほど、連携とテストが増えます。
一般的なシステム開発との開発期間の違い
期間の予測しやすさを左右するのは、成果物の量から工数を見積もれるかどうかと、精度の不確実性です。
- 業務システム:仕様と画面・機能数から工数を見積もりやすい。
- NLP:テキストデータ次第で精度と試行錯誤の量が変わる。
- 進捗の見方:画面数以外の指標を見る。
業務システムは、要件を固めてから設計・実装・テストへ順に進みます。
NLPで同じ要件でも精度が変わるのは、言葉そのものの扱いにくさがあるためです。
「Apple」「アップル」「林檎」のような表記揺れや、同音異義語、皮肉は精度を左右します。さらに、文脈によって変わる意味や、専門用語、社内独自の言い回しも影響します。
そこで、評価を重ねて辞書やモデルを見直し、再学習する反復を前提に進めます。この進め方は、アジャイル的とも言えます。
進捗は、画面数ではなく分類・抽出の精度や、学習に使えるテキストがどれだけ整ったかで測ります。
NLPプロジェクトのライフサイクルと工程別スケジュール
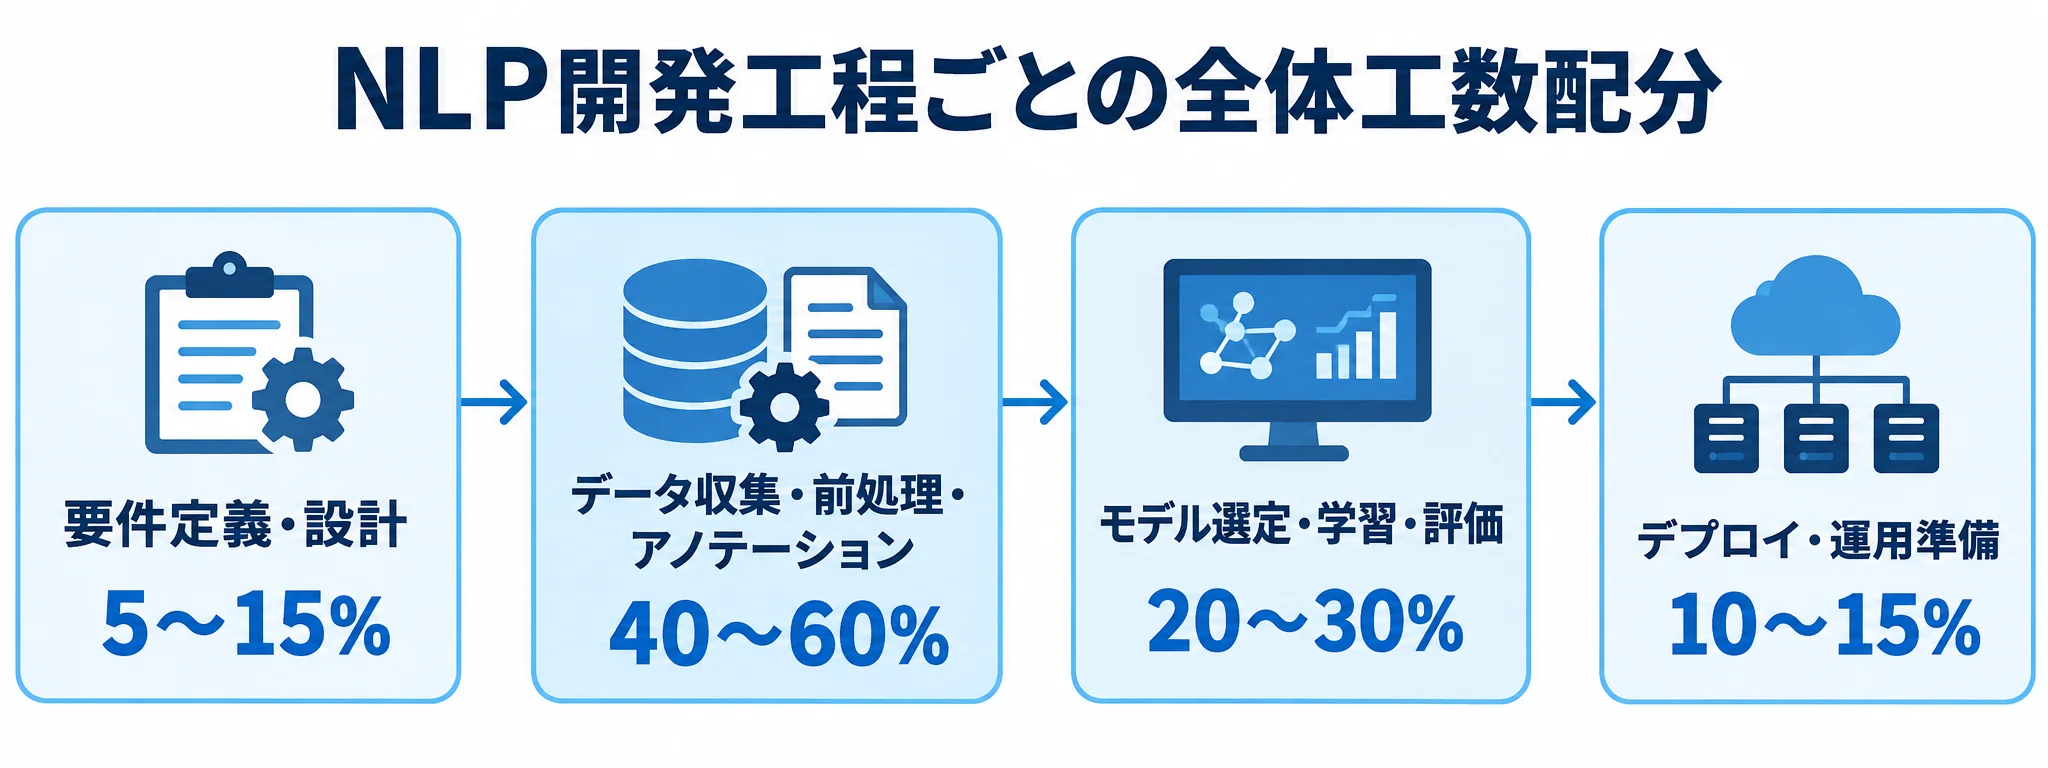
NLPの開発は、要件定義・タスク設計から始まります。その後、データを準備してモデルを学習させ、評価とデプロイを経て、運用・再学習へ続きます。
データ収集・前処理・アノテーションは、全体工数の40〜60%を占めるのが一般的です。
NLPモデル開発というと、アルゴリズムを選んで学習させる作業と思われがちです。しかし実際には、テキストの収集・整備と正解付けが開発の中心になります。
従来の業務システムでは実装とテストが工数の中心ですが、NLPではデータとモデルに重心が移ります。
工数配分の目安は、要件定義・設計が5〜15%、モデル選定・学習・評価が20〜30%、デプロイ・運用準備が10〜15%です。
中規模の費用配分は、要件定義・設計が40万〜200万円、前処理が100万〜300万円です。
続いて、モデル開発・学習が200万〜500万円、API連携が100万〜300万円、テスト・品質保証が50万〜150万円です。
AI駆動開発を使えば、前処理スクリプトやラベル案の作成を効率化でき、期間を短縮できる場合もあります。ただし、テキストの質を高める作業や精度を作り込む反復には、人の判断が欠かせません。
工程を前半と後半に分けて目安を確認すると、データ準備の期間を計画に組み込めます。
要件定義・テキスト収集・前処理・アノテーションフェーズ
ライフサイクルの前半は、自然言語処理開発の成否の多くを左右する工程です。解くタスクと精度指標、その水準は、ビジネス側と合意しておく必要があります。
- 要件定義・タスク設計:1〜3週間。
- テキストデータ収集:2〜6週間。
- 前処理・クレンジング:2〜6週間。
- アノテーション:2〜4週間以上。
要件が曖昧なまま進めると、後から精度を上げても業務上の改善点が定まらず、プロジェクトが迷走します。
収集対象には、問い合わせ履歴、メール、報告書のほか、レビューや外部SNSデータなどがあります。
個人情報の匿名化・マスキングや社内規程との照合が必要になるため、収集に想定以上の時間がかかることがあります。
前処理では、MeCab、Sudachi、JUMAN++などで単語に分割します。そのうえで、表記揺れの統一や正規化、記号・ノイズの除去を行います。
辞書は、UniDicやNEologd、自社辞書を使って調整します。形態素解析の精度は後続の分類や抽出に響くため、辞書整備が欠かせません。
アノテーションでは、「ポジティブ/ネガティブ」や人名・組織名などの正解ラベルを人の手で付けます。
文章数が多い場合や専門知識が必要な判定では、作業が長引きます。前半の工程だけで、全体の半分近くかかることもあります。
モデル選定・学習・評価・デプロイフェーズ
後半は、タスクに合うモデルを選び、訓練・検証・テストを経て本番環境へ組み込みます。
- モデル選定・学習:2〜6週間。
- 評価:2〜6週間。
- デプロイ:2〜4週間。
単純な分類には軽量モデルを使い、文脈理解にはBERTなどをHugging Face Transformersでファインチューニングする方法があります。
高度な生成や要約にはLLMを活用します。また、データを訓練用・検証用・テスト用に分けて性能を確かめます。
検証データで調整したうえで、未使用のテストデータによって汎化性能(未知の文章への対応力)を測ります。
過学習は、訓練データの言い回しに合わせすぎて、本番の多様な文章で精度が出ない状態です。
評価では、Precision(適合率)、Recall(再現率)、F1スコアを使い、目標水準に届いたかを確認します。
目標に届かなければ、辞書やアノテーションを見直し、データ収集へ戻ることがあります。この反復が、期間を読みにくくします。
デプロイでは、モデルを本番環境に組み込み、APIやバッチ処理から呼び出せるようにします。そのうえで、監視も整えます。
後半全体は、規模にもよりますが1.5〜3ヶ月程度を見込みます。
自然言語処理特有でスケジュールに影響する工程
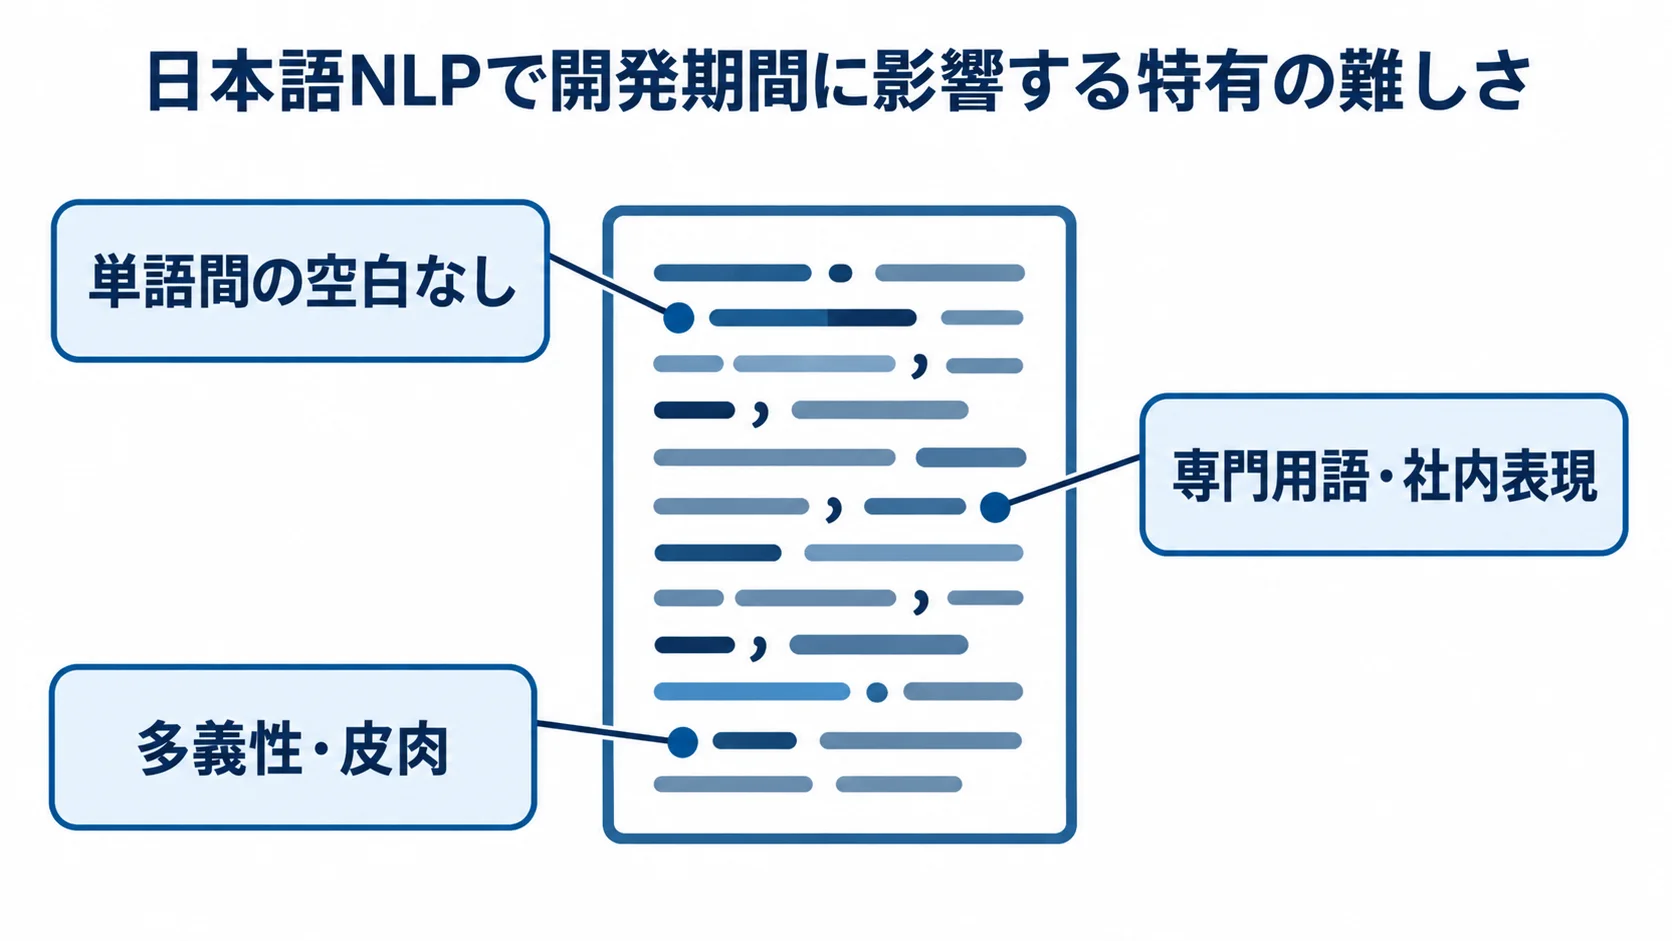
期間を読みにくくする要因は、日本語処理の技術的な難しさと精度調整の不確実性です。
どちらも事前に工数を見積もりにくいため、初期の段階で設計し、スケジュールに余裕を持たせることが納期を守る鍵です。
日本語NLP特有の難しさと辞書・形態素解析の整備
日本語NLPでは、形態素解析と辞書整備が最初の関門になります。英語と違って単語の間に空白がないため、「すもももももももものうち」のように、どこで区切るかも自明ではありません。
- 分割:文章を形態素に分け、品詞を特定する。
- 辞書:専門用語や社内表現を追加する。
- 意味の扱い:多義性や皮肉、婉曲表現への対応。
形態素解析は、あらゆるNLP処理の土台です。分割の精度が低いと、分類や固有表現抽出、感情分析の精度も頭打ちになります。
MeCab、Sudachi、JUMAN++などの解析器と、UniDic、NEologdなどの辞書を使う方法が一般的です。
医療・法律・金融・製造の文書では、標準辞書にない固有名詞や略語、社内表現が多く、辞書の追加調整が必要になります。
専門性が高い分野や表記揺れが多いデータほど、辞書整備の工数が増えて期間に影響します。さらに、意味をどこまで捉えるかでも、作り込みの量が変わります。
着手前に、テキストの専門性と表記揺れを把握しておくことが、期間を見積もる起点になります。
精度と実用性のトレードオフと反復チューニング
精度調整の反復は、期間を膨らませやすい工程です。そこで、実用に必要な精度をあらかじめ決めておくと、過剰な作り込みを避けられます。
- 高精度が必要:反復が増え、期間が延びる。
- 人が最終確認:8割程度の精度でも効果が出る場合がある。
- 運用で改善:誤りを蓄積し、段階的に精度を高める。
精度は一定の水準まで比較的速く上がります。しかし、さらに1%高めるには、辞書やラベル基準の見直しに加え、モデルや追加データにも手を入れる必要があります。
精度が高くなるほど、必要な工数は指数関数的に増えていきます。
曖昧な文章では、人間同士でも判断が分かれます。そのため、100%の精度を目指すことは現実的ではありません。
医療や法律では、誤りが許されにくい点も考慮に入れます。
たとえば、問い合わせの一次仕分けで迷うものだけを人が確認する設計にすれば、Human-in-the-Loopで8割程度の精度でも効率化につながる場合があります。
着手前に実用精度の基準をビジネス側と合意し、達成後に作り込みを止める判断も決めておきます。
基準を決めないと、終わりの見えない精度追求で、期間もコストも際限なく膨らみます。
リリース後も誤りを蓄積して改善する視点があれば、初期開発に過度な負荷を集中させずに済みます。
納期遅延の典型要因と発注側の準備
遅延には典型的な原因があり、発注側が準備すればリスクを大きく下げられます。
NLP開発は、ベンダー任せにはできません。データや業務で使われる言葉の背景を知る発注側の協力が、スケジュールを左右します。
テキストデータの品質・精度未達による手戻り
データの不備や目標精度への未達が、手戻りの主な原因です。準備段階でデータを検証すると、影響を抑えられます。
- 品質・形式:表記揺れ、OCR処理、名寄せに時間がかかる。
- データ不足:正解ラベル付きデータが十分でない。
- 手戻り要因:連携先、専門用語、多言語対応も影響する。
PDF、画像、手書き文書の混在はOCR前処理を増やし、複数システムへの分散は名寄せを難しくします。
自然言語処理にも「Garbage In, Garbage Out(ゴミを入れればゴミが出る)」という原則があります。データの品質はモデルの精度の上限を左右するため、汚れたデータでは整備や辞書調整が欠かせません。
目標精度に届かない場合は、ラベル基準や辞書を見直し、テキスト収集まで戻ることになるため、数週間単位で延びることがあります。
非構造化データのOCR量や既存システムの連携数も、納期を押し上げる要因です。
手戻りを完全に避けることは難しい場合もありますが、PoCでデータの実力を見極めておくと、本開発での大きな手戻りを防げます。
本開発の前に小さく検証してから本番へ進む段取りが、結果として納期の短縮につながります。
現実的なスケジュールを引くための発注側の準備
着手前には、データ、成功基準、担当体制の順に整えておきます。
- データ棚卸し:種類と保管先、量、品質の確認。
- KPIの明確化:タスク、精度、期限、業務改善の定義。
- 担当体制:業務上の意味と正解ラベルを判断できる人の配置。
品質には、表記揺れや専門用語の割合、フォーマットの統一度も含めます。サンプルをベンダーに渡せると、初期見積もりの精度が上がります。
事前に棚卸しをしておくと、データ収集・前処理の工程を大きく短縮できます。
成功基準は、達成の水準を数値で定めます。
この基準があれば、精度を追い続けず、実用ラインで着地しやすくなります。
体制には、タスクを定式化するデータサイエンティスト、パイプラインを実装するエンジニア、基盤を整えるデータエンジニアが関わります。
発注側にも、業務上の言葉の意味やアノテーションの正解基準を判断できる担当者が必要です。
専門用語やラベルの判断には現場知識が欠かせないため、当事者が不在だと、優れたベンダーでも予定どおりに進みません。
データ、成功基準、担当体制の3点を整えることが、遅延を防ぐ確かな準備になります。
まとめ
期間の目安は、PoCで1〜2ヶ月、小規模導入で2〜8週間です。中規模導入では2〜6ヶ月、大規模導入では4ヶ月〜1年以上が目安になります。
データ収集・前処理・アノテーションは全体工数の40〜60%を占めます。また、日本語の分かち書きや表記揺れ、多義性も、形態素解析と辞書整備に影響します。
精度は事前に分からないため、反復期間を確保し、実用に足る精度ラインを決めておくことが期間管理の要になります。
感情分析や文書分類、固有表現抽出は、自然言語処理の応用タスクです。こうした応用では、まずデータを棚卸しし、小さなPoCで精度とROIを確かめると、現実的な計画を立てやすくなります。
▼全体ガイドの記事
・自然言語処理の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。