
自然言語処理のフルスクラッチ開発は、辞書やモデルを自社向けに一から作り込む方式です。機密データを社内で扱う場合や既存システムと深く連携する場合に選ばれ、費用は規模によって大きく変わります。
業務導入では、既製やAPIで足りるかを見極めたうえで、独自要件だけを作るかどうかが分岐点になります。
▼全体ガイドの記事
・自然言語処理の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
自然言語処理におけるフルスクラッチ開発の全体像
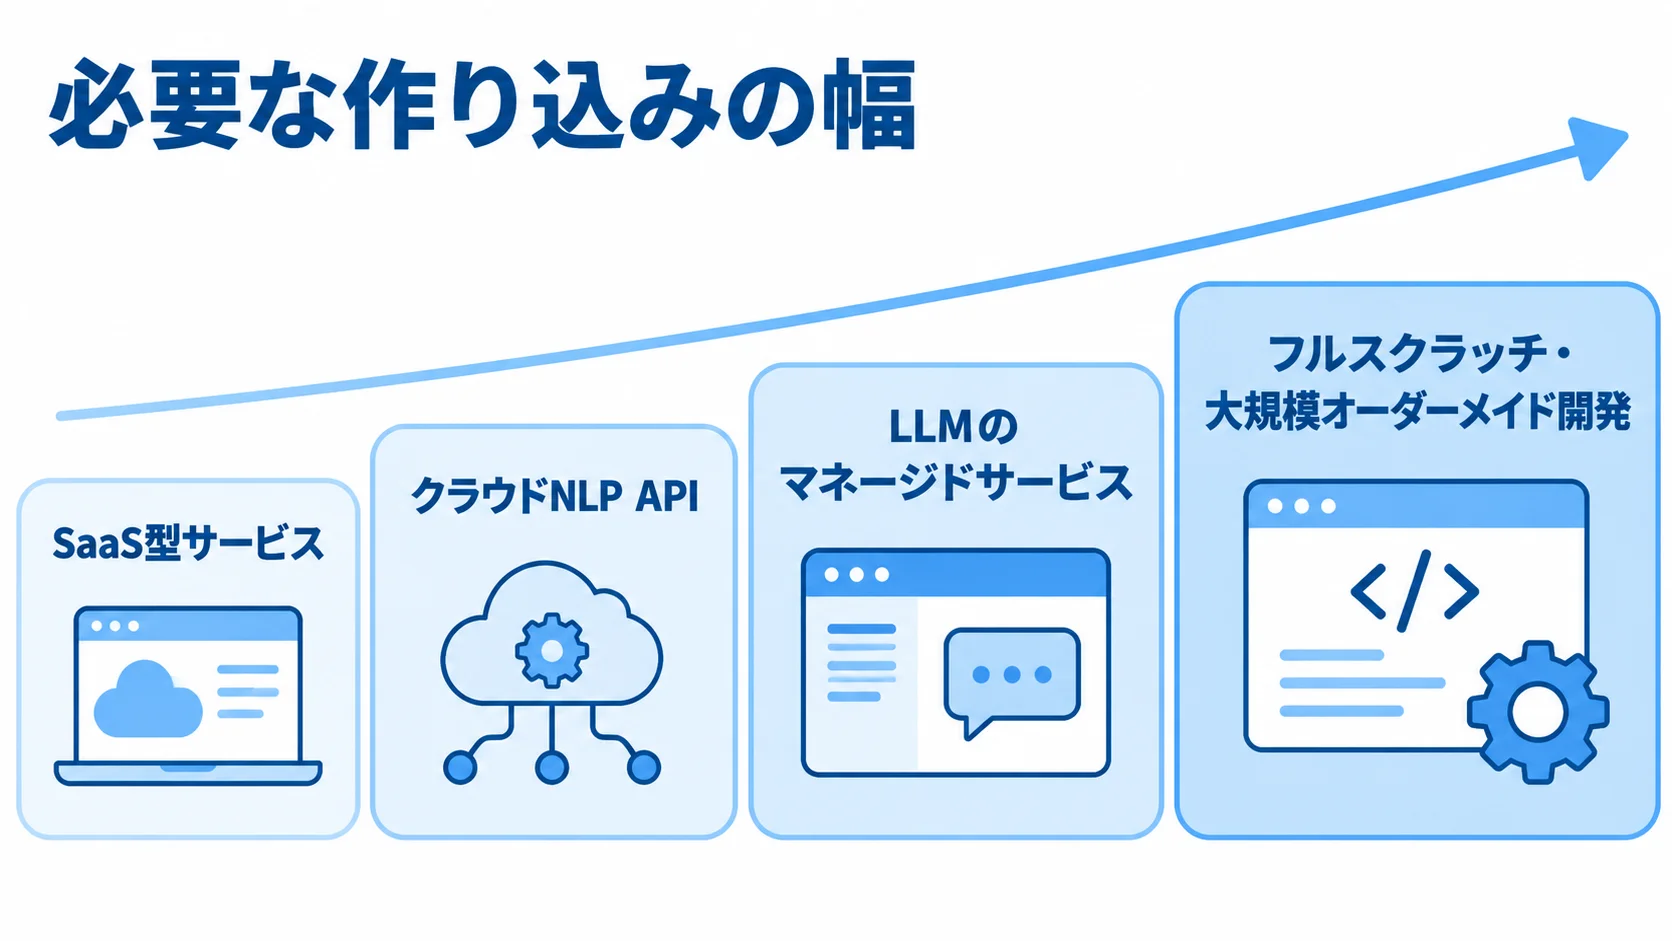
自然言語処理の方法は、既製サービスからフルスクラッチまで段階があり、自社の課題に合うものを選ぶのが基本です。
SaaS型サービスには、感情分析ツールやチャットボットのように用途が定まった製品があります。月数万〜数十万円で利用でき、導入しやすい一方で、カスタマイズには限界があります。
クラウドNLP APIやLLMのマネージドサービスは、自社データとのAPI連携で機能を組み込めます。感情分析、構文解析、固有表現抽出、要約などを、自前でモデルを学習させずに使えるのが特徴です。
クラウドAPIの例には、Google Cloud Natural Language APIがあります。ほかに、Amazon ComprehendやAzure AI Languageも挙げられます。
LLMのマネージドサービスの例には、AWS BedrockやAzure OpenAIがあります。
最も作り込む方法が、フルスクラッチ・大規模オーダーメイド開発です。独自のデータを使い、BERTなどの事前学習モデルをファインチューニングできます。
独自辞書や言語資源を整えたうえで、オンプレミス環境を含むNLP基盤をゼロから設計・実装します。カスタマイズ性は高い反面、専門知識と相応の費用・期間が必要になります。
既製サービス・クラウドNLP API・LLM活用・フルスクラッチの違い
既製サービスからフルスクラッチまでの方法は、コスト・導入速度・カスタマイズ性の3点で比べると違いが分かります。
- SaaS型:初期費用と学習コストが低く、数日で使い始められる製品
- クラウドAPI・LLM:自社テキストを使った分類・抽出・要約
- フルスクラッチ:辞書設計、特徴量、モデル構造、学習方法まで要件に合わせた開発
SaaS型は提供機能の範囲で使うため、独自の用語や業務フローには対応できません。汎用的なタスクを早く安く始めたい場合に向いています。
クラウドAPIやLLMは、専門人材が手薄でも高精度な結果を得られる点が利点です。ただし、初期実装費は50万〜200万円程度で、API従量課金が月10万〜50万円以上続きます。
クラウドAPIやLLMは外部へテキストを送るため、セキュリティやコンプライアンス上の懸念が生じる場合があります。一方、フルスクラッチは数ヶ月〜1年以上かかり、高度な知識と高額な費用も必要です。
汎用的な要件なら、既製サービスやAPIで足りる場合があります。その場合は、競争力の源泉となる中核部分だけを作り込むほうが、費用対効果にかないます。
自然言語処理でフルスクラッチが選ばれる理由
フルスクラッチを検討する主な理由は、次の4つの要件です。いずれかが強く当てはまる場合、選択肢に入ります。
- 高い機密性:外部送信が認められず、自社環境内での処理が必要
- 全社基盤:複数部門・システムのテキストを統合して扱う基盤
- 独自連携:標準APIで接続できない社内システムとの連携
- 専門分野への適合:独自辞書や調整したモデルによる精度の向上
金融・医療・製造では、規制やコンプライアンス上の理由から、顧客情報や機密文書を外部APIへ送れない場合があります。
全社の多様なテキストをまとめる場合、汎用サービスの組み合わせでは限界が生じることがあります。独自システムとの深い連携にも、作り込みが求められます。
医療・法律・特許・金融の文書には、標準モデルでは扱いきれない固有名詞や言い回しがあります。こうした分野では、独自辞書やファインチューニングが精度向上に必要です。
これらに当てはまらなければ、より軽い方法で足りる可能性が高いと考えます。
フルスクラッチで実現できる範囲
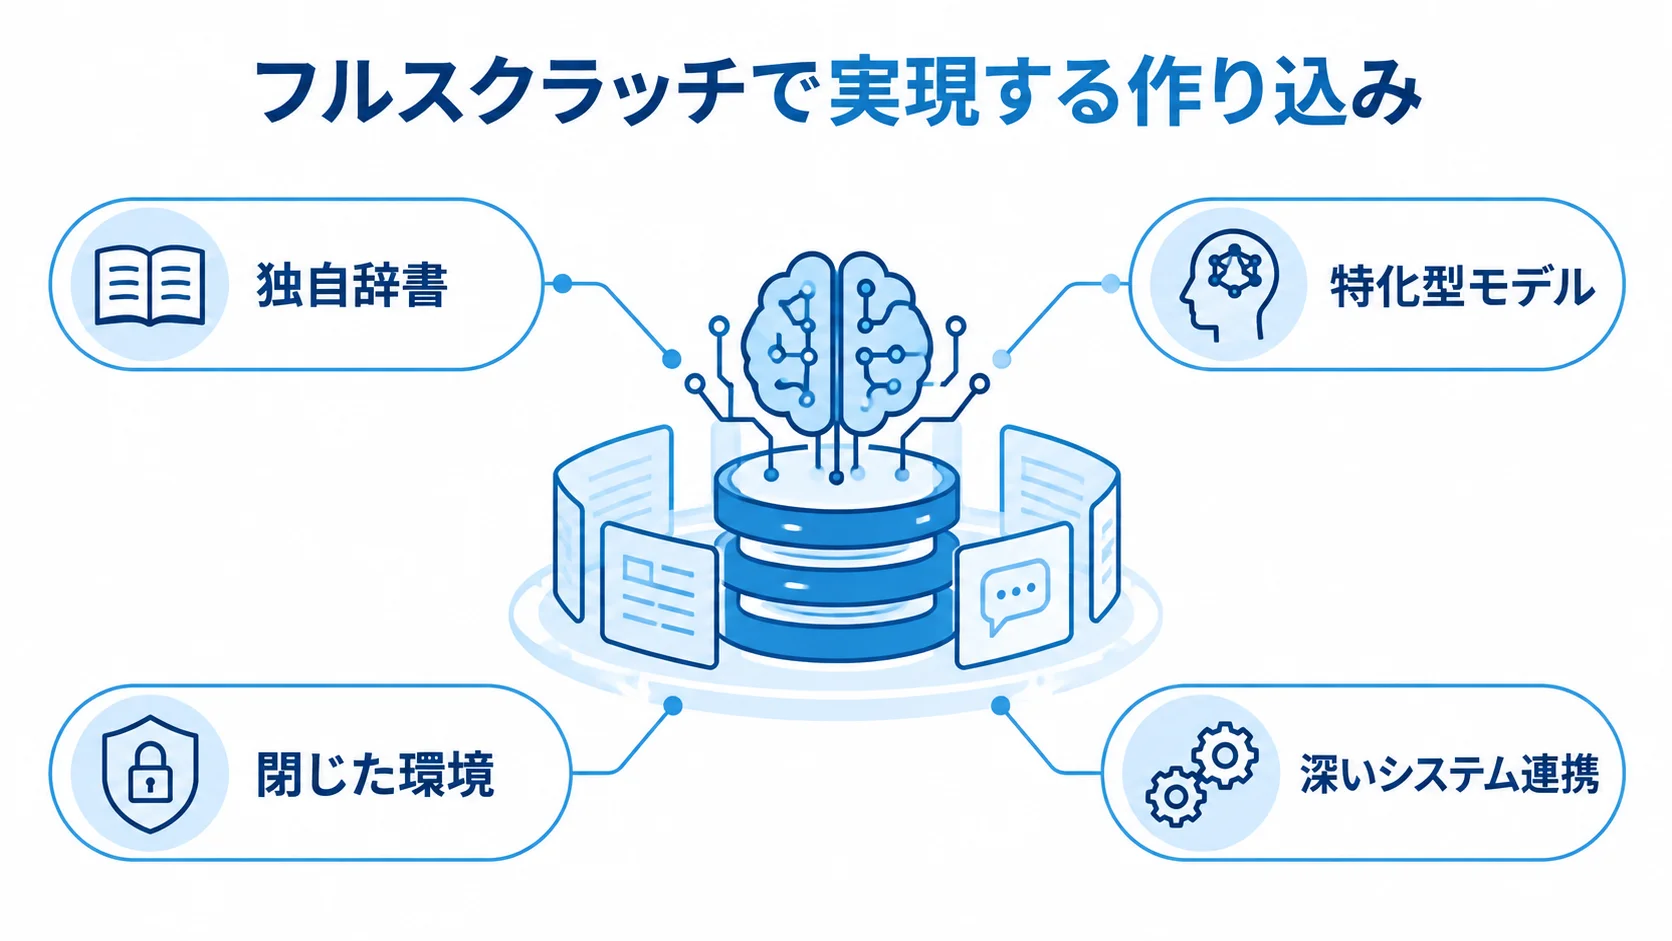
フルスクラッチは、既製品やLLM APIでは届かない領域にも対応できます。主な検討材料は、独自辞書や特化型モデル、機密データの保護、既存システムとの連携です。
なかでも、独自辞書・特化型モデルと、機密データを守る既存システム連携は、導入が必要かを見極める本質的な判断材料です。
独自ドメイン辞書・特化型モデル(SLM)の作り込み
辞書やモデル、業務ルールは、自社の課題に合わせて調整できます。具体的には、次の作り込みが可能です。
- 独自辞書:固有名詞・略語・社内特有の言い回しの登録
- 特化型モデル:自社データを使ったSLMの学習と調整
- 業務ルール:分類条件や制約のモデルロジックへの組み込み
医療・法律・特許・金融の文書には、標準辞書のUniDicやNEologdにない語が頻出します。そのため、業務知識をもとにした辞書の整備が、精度を左右します。
SLMは、自社データからゼロから作る方法と、事前学習モデルをもとに作る方法があります。汎用LLMより軽いため、低コストで推論でき、エッジ環境にも対応できます。
たとえば、業界用語が含まれる文を特定のカテゴリへ分類するなど、現実の業務ルールも組み込めます。既製サービスやLLM APIでは、細かな制約に対応しきれない場合があります。
そのため、自社の言葉に合った出力を設計できる点に、フルスクラッチの価値があります。
機密データの社内処理と既存システムとの深い連携
テキストの管理場所と連携先は、自社の要件に合わせて決められます。機密データの保護と既存システムとの統合を両立できる点が特徴です。
- 閉じた環境:機密テキストを外部に出さない処理
- 深いシステム連携:分類・抽出結果の業務フローへの組み込み
顧客の個人情報や契約書、社内の機密文書は、APIへ送れない場合があります。その理由は、規制、社内ポリシー、顧客との契約などです。
オンプレミスやプライベートクラウド、閉域網内に構築すれば、機密テキストを外部へ一切出さずに処理できます。金融・医療・製造では、この点が決め手になることもあります。
標準APIではつながらない社内システムやデータベースとも連携できます。たとえば、契約書管理システムから文書を取り込み、抽出した条項情報を法務のチェックシステムへ送る仕組みを構築できます。このように、抽出結果は業務プロセスにシームレスに組み込めます。
既製サービスは、サービス内で完結する設計が多いため、深い連携には限界があります。機密保護と既存業務システムとの一体化が必要なほど、独自開発の価値は高まります。
フルスクラッチのコスト・期間・人材とBuy or Buildの判断
フルスクラッチは費用・期間・人材を要するため、判断を誤ると過剰投資になるおそれがあります。まず目安を把握したうえで、Buy or Buildを検討します。
費用・期間の目安とコストクロスオーバーの考え方
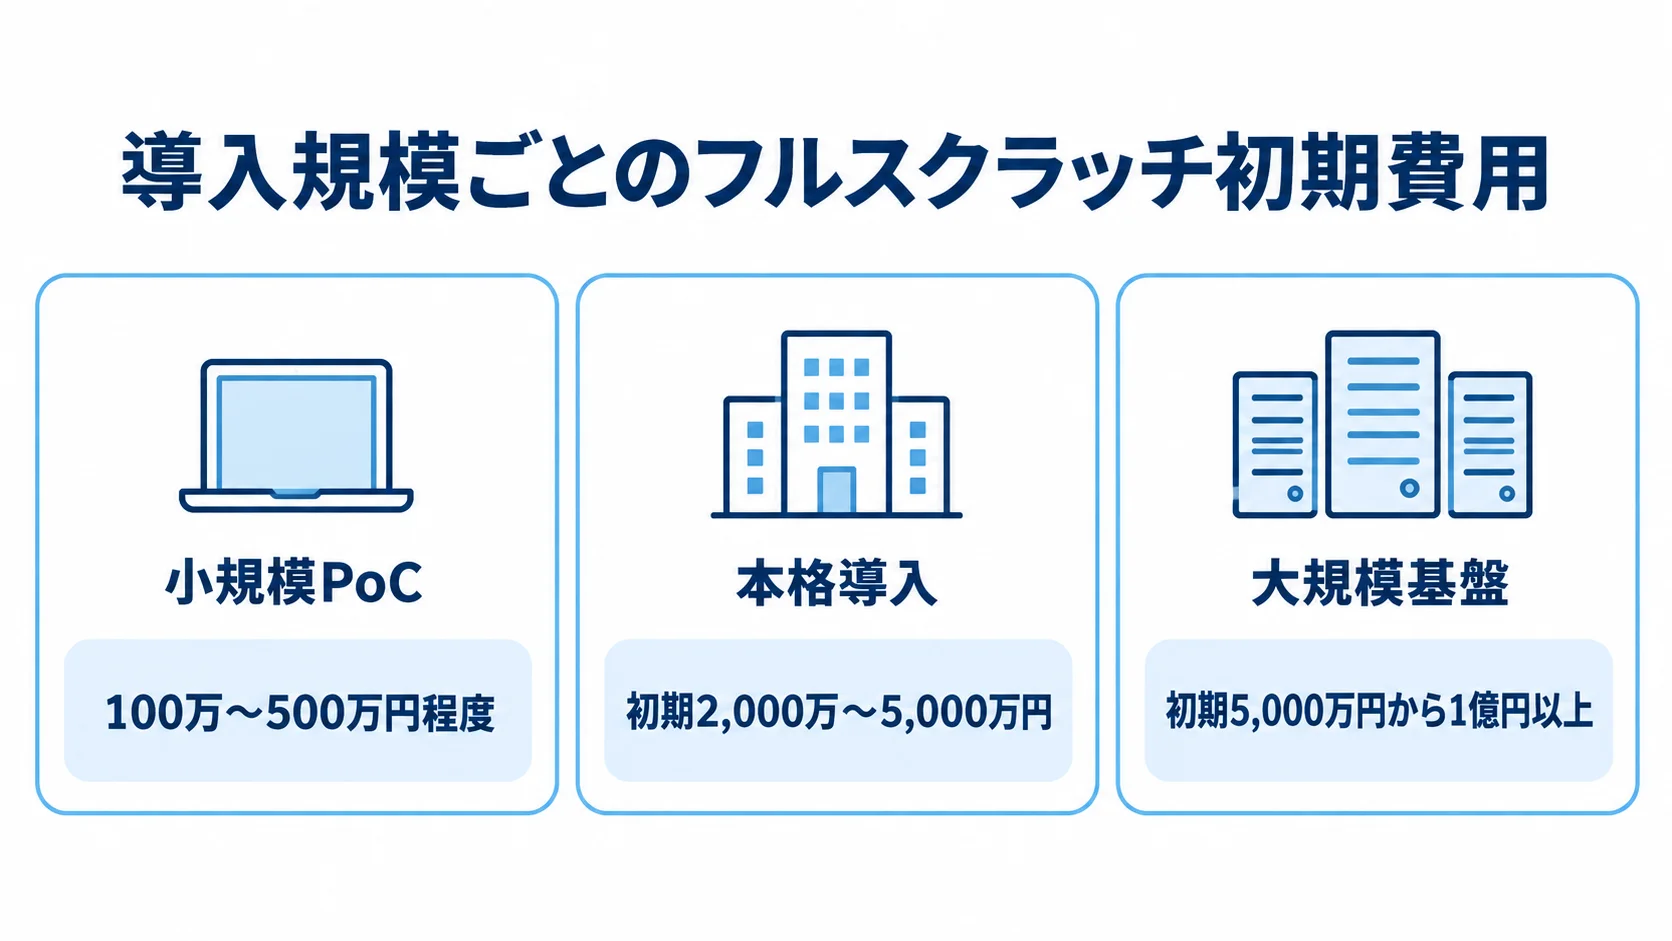
導入の規模が大きくなるほど、初期費用は段階的に膨らみます。その違いを、規模ごとの目安で見ていきます。
- 小規模PoC:クラウドAPI活用を含めた100万〜500万円程度
- 本格導入:連携込みの初期2,000万〜5,000万円、期間6ヶ月〜1年程度
- 大規模基盤:初期5,000万円から1億円以上に達する場合がある
高度な特化型モデルの学習基盤、大規模GPUクラスタ、複数システムとの深い連携が加わると、費用はさらに上振れします。全社横断の基盤を独自の学習環境ごと構築する場合が、大規模基盤の典型です。
本格運用の費用は月額50万〜200万円以上かかります。また、年間の保守費は初期費用の20〜30%が目安です。
API従量課金の額がフルスクラッチのTCO(総保有コスト)を上回る境目を、コストクロスオーバーと呼びます。
API利用量が少ない間は、従量課金のほうが割安です。一方で、月200万〜300万クエリを超える大量利用では、API課金の累計がTCOを上回る試算があります。
想定する利用量が境目のどちら側にあるかを試算することが、開発方式を判断する材料になります。ただし、セキュリティ要件がある場合は、費用より先にオンプレミスの要件が決め手になります。
過剰なフルスクラッチを避けるBuy or Buildの判断
APIやLLMで十分な場合にフルスクラッチを選ぶと、過剰投資になり得ます。そこで、まず既製で足りるかを調べ、対応できない部分だけを作ります。
- 解きたいタスクの要素ごとの分解
- 各要素をクラウドNLP APIで扱えるかの確認
- LLMのプロンプト設計で足りる精度の見込み
- 学習済みモデルのファインチューニングによる転用の可否
- 既製では実現できない競争力の中核部分の開発
専門用語の辞書や機密データのオンプレミス処理などが、独自開発の候補になります。逆に、すべてを一から作ると、車輪の再発明となり、費用と時間を浪費しかねません。
フルスクラッチが、必ず高精度になるとは限りません。汎用的なタスクでは、丁寧に設計したLLMと時間をかけた独自開発の精度差が小さい場合があります。
その精度差が、開発費に見合わないケースもあります。精度を左右する最大の要因は、開発手法よりも、テキストデータの質と辞書整備です。
まず軽い手法で試し、越えられない課題が見えてから独自開発へ進めば、過剰投資を避けられます。
発注時の契約とベンダー選定
外部に発注する場合、契約とベンダー選びが成否を左右します。NLPは、一般的なシステム開発と契約の勘所が異なるうえ、日本語NLPや専門辞書に詳しい会社も限られます。
要件・データ・精度目標の契約、段階的な範囲設計、ベンダー選定の3つの観点が、発注の判断材料になります。
要件・データ・精度目標を握る契約設計
精度はデータの質と量に左右されるため、ベンダーが精度を一方的に保証するのは現実的ではありません。そのため、契約では次の事項を明確にしておきます。
- 要件:分類・抽出・要約の対象と、結果の業務での使い方。
- データ:データを準備する人、品質、期限、辞書監修の担当。
- 精度目標:評価指標と目標水準、未達時の対応。
- 成果物と権利:モデル・辞書・コードの権利、学習データの扱い、受渡範囲。
精度そのものを成果物として約束するより、合意した水準を目指し、定めた手順で開発・検証する過程を対象とするのが一般的です。
これは準委任契約に近い考え方です。発注側も、テキスト品質の確保や専門用語の説明に協力することが前提になります。
データの準備が遅れると、プロジェクト全体も遅れます。そのため、誰が、どの品質のデータをいつまでに用意するかを、契約に明記しておきます。
要件、データ、精度目標が曖昧なまま進むと、開発トラブルの大きな原因になります。
段階的スコープとベンダー選定
投資リスクを抑えるには、PoCから本開発へ進む段階的な契約が有効です。ベンダーを選ぶ際は、次の4点を確かめます。
- NLPの実績:日本語解析や専門辞書、モデル調整の知識と類似実績。
- データへの理解:テキストや表記揺れ、専門用語を丁寧に確認する姿勢。
- 運用体制:辞書更新や精度劣化への対応を続けられる体制。
- 提案と業務理解:相見積もりでの、金額以外の提案内容の比較。
PoCでテキストの実力と実現可能性を確かめ、その結果をもとに本開発を判断します。精度の限界が分かれば、投資や手戻りを抑えられます。
一般的なシステム開発の実績に加えて、日本語の形態素解析や専門辞書、事前学習モデルのファインチューニングに詳しい会社かを見ます。
優れた会社は、モデルを考える前に、テキストの種類や表記揺れ、専門用語の量を確認します。データの重要性をどこまで理解しているかが、判断の材料になります。
自然言語処理は、開発後も辞書の更新や精度劣化への対応が必要です。そのため、運用・保守まで一貫して支援できる体制が備わっているかを見ます。
複数社から見積もりを取り、金額に加えて、技術提案の質や業界・業務への理解度を比べます。信頼できる相手と段階的に進めることが、成功への道筋です。
まとめ
方式の使い分けと、フルスクラッチが選ばれる理由を見ました。独自辞書やSLM、機密データ連携の作り込みに加えて、費用・期間、Buy or Build、契約とベンダー選定も扱いました。
費用の目安は、本格導入で初期2,000万〜5,000万円、大規模基盤で5,000万円以上となる場合があります。加えて、希少な専門人材も必要です。
まず既製やAPIで足りるかを確かめ、独自開発が要る部分だけに絞ります。そのうえでデータと辞書を整え、PoCから段階的に進めれば、過剰投資を防げます。
感情分析や文書分類、固有表現抽出、要約、機械翻訳のどれであっても、既製と独自開発のどちらが合うかは個別に判断する必要があります。
要件を見極めたうえで、信頼できるパートナーと課題に合った作り方を選びましょう。
▼全体ガイドの記事
・自然言語処理の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。