
自然言語処理の運用費は、月10万〜50万円程度の幅で大きく変わります。金額を左右するのは、推論インフラの費用と、辞書更新、再学習、人的保守の費用です。
運用費には、サーバーの維持費に加えて、言葉の変化に追随するための費用も含まれます。全体像は、下の完全ガイドでも確認できます。
▼全体ガイドの記事
・自然言語処理の完全ガイド
AIシステム開発の費用の考え方や見積もりの注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
自然言語処理のランニングコストの全体像
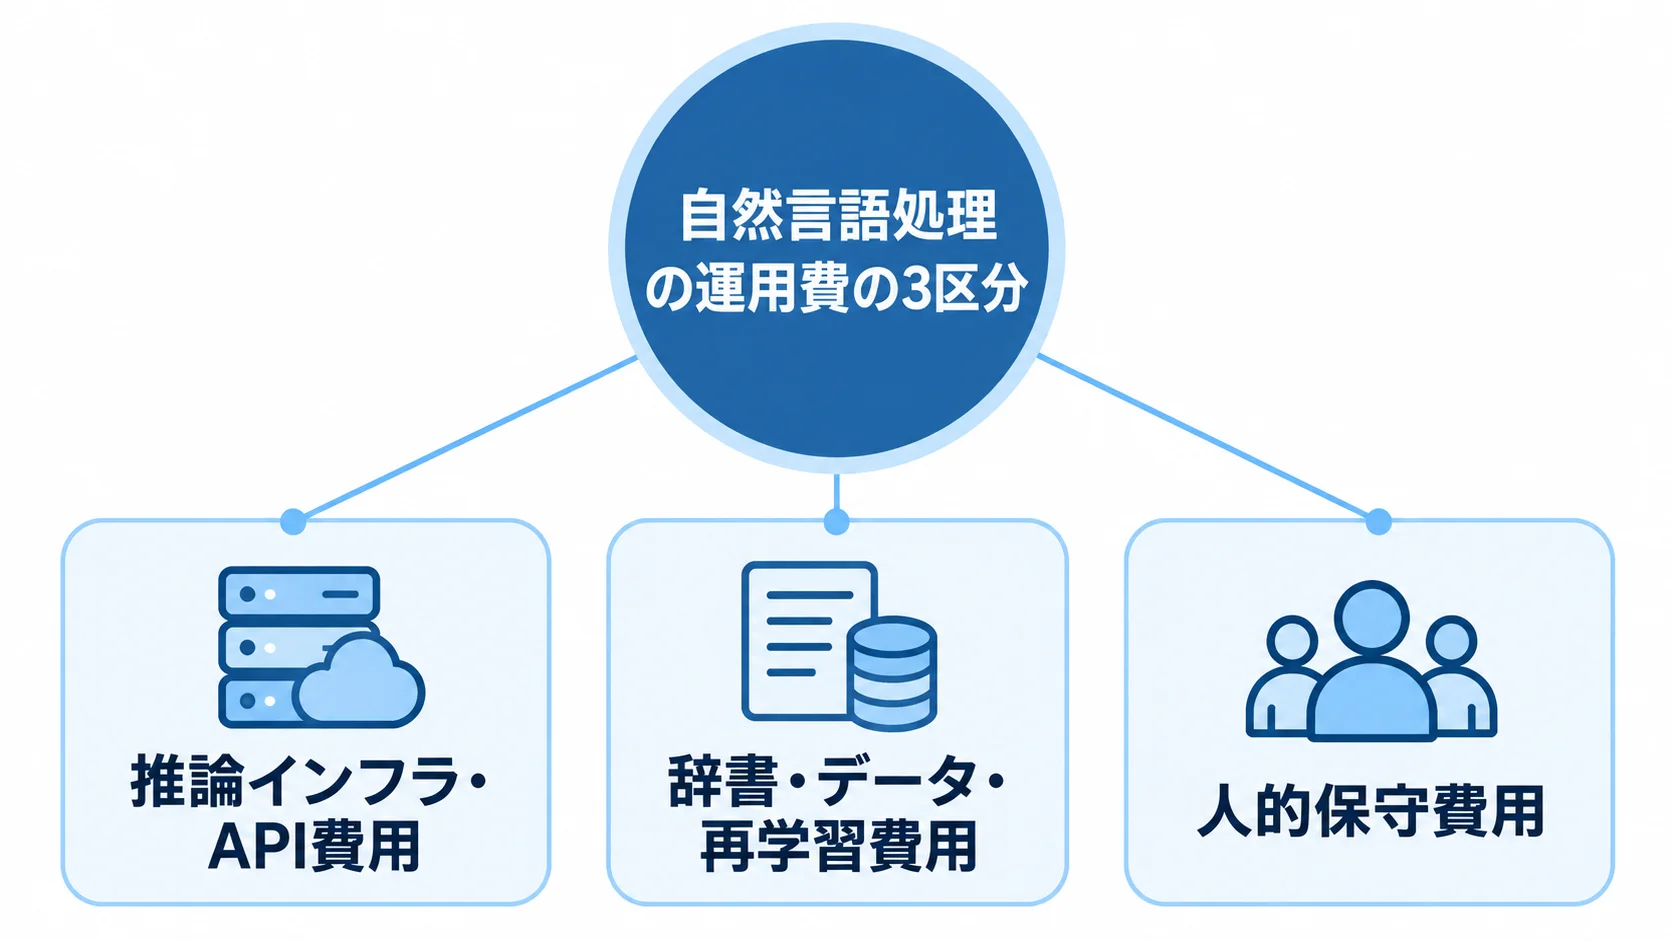
自然言語処理システムの年間運用保守費は、一般に初期開発費の20〜30%が相場です。たとえば初期開発に2,000万円を投じた場合、年間で400万〜600万円がかかります。月額に均すと、小〜中規模のシステムで10万〜50万円程度が継続的にかかります。
NLPのランニングコストは、通常のシステムとは中身が異なります。一般的なシステムは、障害対応やセキュリティパッチで品質を保ちます。一方で自然言語処理は、言葉の変化によって精度が少しずつずれていきます。
たとえば、新語や流行語、新商品名、新しい略語が次々に生まれます。社内の言い回しや業務用語も変わるため、モデルや辞書の更新が欠かせません。更新しなければ、形態素解析の精度から後続処理まで静かに劣化します。
つまり、自然言語処理には言葉の変化に追随する費用が組み込まれています。この点を押さえないまま、作った後は安いと考えると、想定外の費用が発生します。
3つの費用区分と見落とされやすい隠れコスト
運用費は、発生する場面ごとの区分で捉えると、どこに費用が積み上がるかを確認しやすくなります。そのなかには、見積書に現れにくい隠れコストも含まれます。
- 推論インフラ・API費用:モデルを稼働させる費用。
- 辞書・データ・再学習費用:言語資源とモデルを更新する費用。
- 人的保守費用:モデルと辞書を見直す人材の費用。
自社で推論する場合は、月5万〜30万円程度が目安です。一方でLLM APIは、月10万クエリで月10万〜50万円ほどの従量課金になり、API費用だけで運用費全体の80〜90%を占めることもあります。
専門用語辞書のメンテナンスは、月3万〜10万円程度が目安です。再学習やファインチューニングは、1回あたり50万〜200万円かかります。さらに、人的保守では、上級のMLエンジニアが月60万〜120万円程度、中級のデータエンジニアが月30万〜60万円程度が目安です。
隠れコストには、長大なプロンプトによるトークン消費があります。辞書の更新を怠ると誤分類が増え、現場の確認作業も発生します。こうした費用は見積書に現れにくいため、運用設計の段階で洗い出しておく必要があります。
一般的なシステムとの費用構造の違い(言語は生き物という前提)
一般的な保守とNLPの保守は、品質が劣化する理由も対応方法も異なります。
- 一般的な業務システム:壊れたら直す保守が中心。
- 自然言語処理:言葉の変化による精度の低下。
- NLPの保守:辞書とモデルの継続的な更新。
一般的な業務システムは、バグ修正やセキュリティ更新が保守の中心です。軽微な機能追加を行うこともありますが、放置しても機能が劣化するとは限りません。
ところが自然言語処理は、何も変えなくても時間とともに精度が下がります。新しい商品名やサービス名、SNS発の流行語や略語が次々に生まれるためです。
業界特有の言い回しも増え、形態素解析器の辞書は徐々に陳腐化します。さらに、社内の業務プロセスが変われば、アノテーションの正解基準も変わります。
画像認識では、猫は何年経っても猫として扱えます。これに対してテキストは、単語の意味や表現のニュアンスが数ヶ月で変わります。
保守の構造が違うことから、自然言語処理の費用は読み違えやすく、高くなりがちです。そのため、見積もりには、言語の鮮度を保つための継続的な投資を含めておく必要があります。
辞書とモデルの精度を維持するための費用
精度を維持する取り組みは、言語資源の更新とモデルの再学習に分かれます。両方を軽視すると、精度の劣化に気づかないまま業務判断を続けることになります。一方で、更新の仕組みを設計しておけば、必要なときだけメンテナンスを行えます。
辞書・言語資源のメンテナンス費用(新語・流行語・専門用語対応)
日本語NLPでは、形態素解析器と辞書がテキスト処理の精度を支えます。
- 形態素解析器:MeCab、Sudachi、JUMAN++などの利用。
- 辞書:UniDicやNEologdなどの更新。
- 表記揺れ:固有名詞の統一ルールの見直し。
辞書は、一度整備した後も継続的に更新し続ける必要があります。新商品名や流行語、専門用語が次々に登場するためです。
未知語を正しく分割・認識できなければ、後続処理の精度も下がります。また、辞書・言語資源の更新費用は、月額3万〜10万円程度が目安です。
医療・法律・金融・製造などの分野では、固有名詞や略語が多く、更新作業が重くなります。社内独自の言い回しは、標準辞書の範囲を超えるため、別に整備が必要になります。
たとえば、「Apple」「アップル」「林檎」のような表記揺れも統一しておく必要があります。更新を怠ると、モデルを変えていなくても分類精度が落ちたように見えます。
辞書は、使い続ける限りメンテナンスが続くものです。実務では、月次や四半期ごとに未知語の出現頻度をレポートします。そこで、閾値を超えた単語だけをレビューして辞書へ追加すると、工数を抑えられます。
再学習・ファインチューニング費用(データドリフトと知識の陳腐化)
辞書の更新と同じく、モデルの再学習も精度の維持に欠かせません。
- 対象モデル:BERTのファインチューニングやLLMの利用。
- データドリフト:学習時点と現在の言語傾向のずれ。
- 実施判断:学習から6〜12ヶ月を目安にした要否の検討。
学習時点のデータと現在の言語傾向には、時間とともにズレが生じます。このズレを放っておくと、新語や流行語への対応力が落ちます。
再学習・ファインチューニングは、1回あたり50万〜200万円程度が目安です。年2〜4回実施する運用では、年間100万〜800万円規模になります。加えて、再学習の後には評価とリグレッションテストにも、相応の工数がかかります。
この費用は、性能不良による後追いの費用ではなく、言葉が変化し続けるために必ず生じる構造的なコストです。そのため、最初から運用予算に織り込んでおく必要があります。逆に言えば、精度の変化を早く捉えれば、劣化前の軽い再学習で費用を抑えられます。
自然言語処理特有でコストに影響する要素
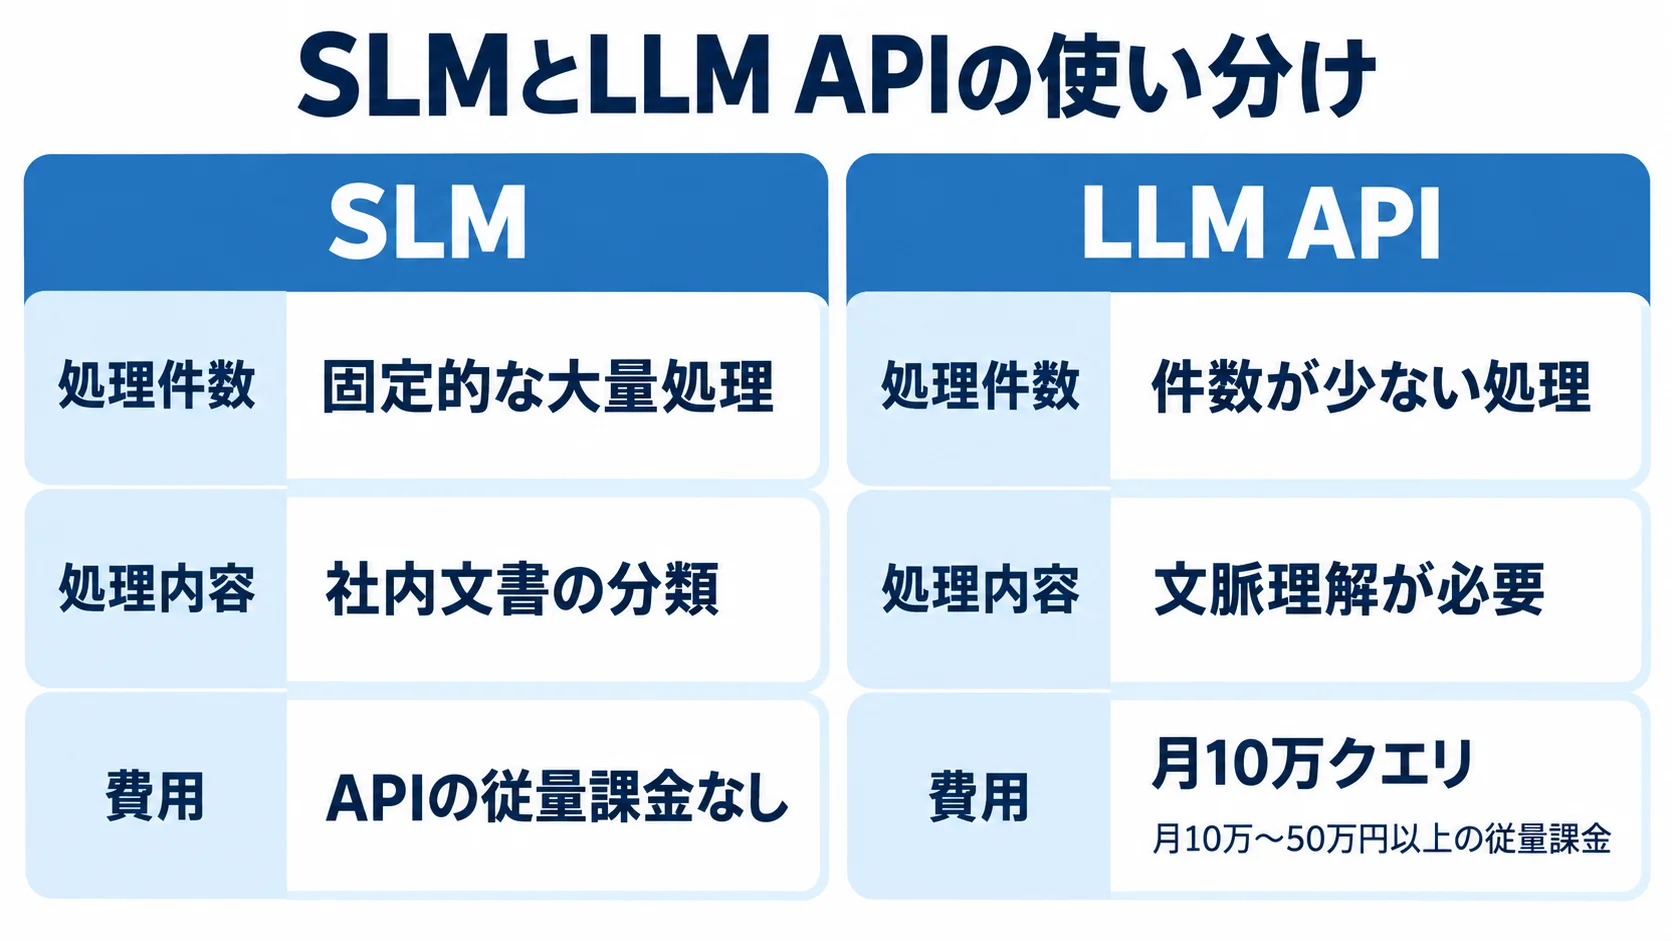
同じNLPシステムでも、選ぶアプローチによってランニングコストは変わります。特に、SLMとLLM APIの選び方と利用方法が費用を左右します。推論まわりの費用は、運用費の大部分を占める一方で、削減の余地もあります。
SLM(特化型・軽量モデル)とLLM APIのコスト構造の違い
タスクの明確さと処理件数で、SLMとLLM APIの向き不向きを判断します。
- SLM:固定的な大量処理で費用対効果を得やすい。
- LLM:文脈理解が必要で件数が少ない処理に向く。
- 高精度化:95点以上を求める場合の費用の増加。
社内文書の分類や定型的な問い合わせには、SLMが合っています。また、SLMを自社環境で推論すれば、リクエストが増えてもAPIの従量課金は生じません。エッジ環境でも動作でき、月々のランニングコストも抑えやすくなります。
LLM APIは、初期50万〜200万円程度の実装費で機能を使い始められます。一方で、月10万クエリなら月10万〜50万円以上の従量課金が続きます。
一般的な精度までは比較的安く抑えられますが、高精度化では費用が非線形に増えます。95点以上を狙ってRAGやファインチューニングを重ねると、その都度、費用が積み上がります。
そこで、すべてをLLMで処理するのではなく、タスクと予算に応じて使い分ける方針を、発注側と開発会社で決めておきます。分類ルールが固定的で件数の多い処理は、まずSLMから検討します。
モデルルーティング・トークン最適化によるコスト削減
LLM APIの費用は、使うトークン量と処理方法を見直すと削減できます。
- プロンプト最適化:必要な情報だけに絞った入力。
- キャッシュ:繰り返す結果の再利用。
- バッチ処理:処理の一括実行。
- モデルルーティング:難易度に応じたモデルの振り分け。
冗長なプロンプトや不要なコンテキストは、トークンを余分に消費し、従量課金を膨らませます。そのため、入力を絞れば、同じ処理の費用が下がります。
繰り返しの多い問い合わせや定型的な分類は、結果をキャッシュして使い回せます。そのことで、API呼び出しの回数そのものを減らせます。また、即時性が求められない処理は、まとめてバッチ処理に回します。
単純な処理をSLMや小型モデルへ回し、複雑な処理だけLLMへ送ります。このモデルルーティングで、推論コストを40〜70%程度削減できた報告もあります。処理ごとに必要な精度を見極めれば、過剰な費用を避けられます。
保守契約とTCO最適化のポイント
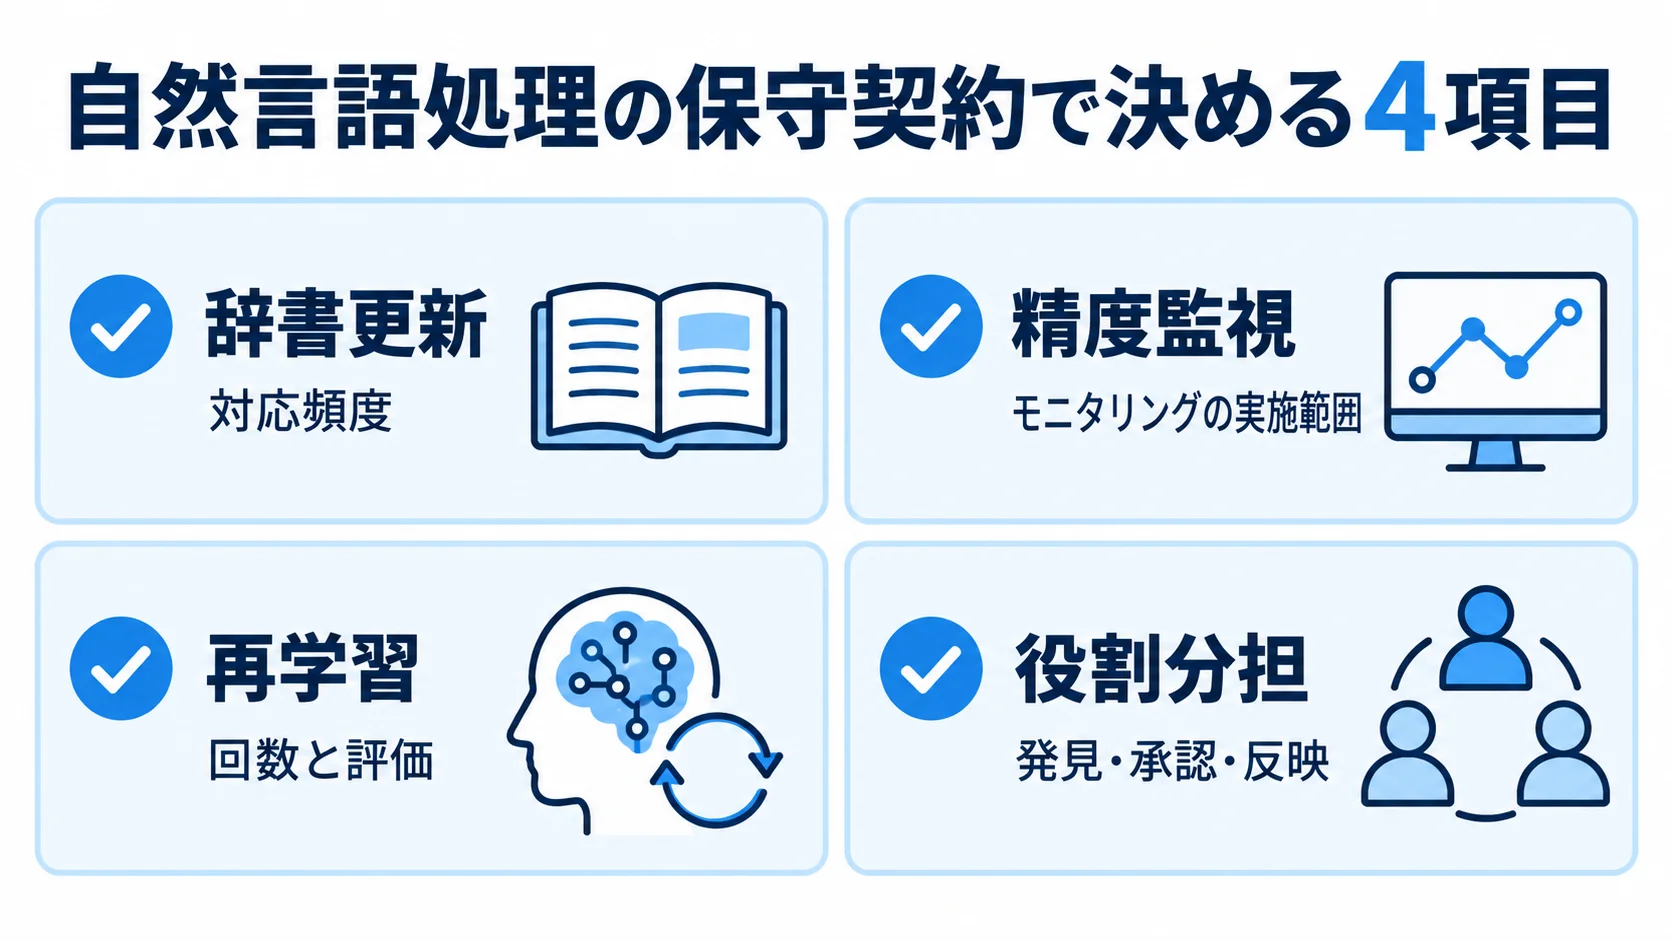
ランニングコストを管理するには、保守契約とTCOの両面から考える必要があります。TCO(総保有コスト)は、運用期間全体の費用を合計したものです。辞書費やAPI従量費、再学習費、人件費も、このTCOに含まれます。
自然言語処理は運用費が積み上がっていくため、投資判断は数年単位で行います。
保守範囲と精度SLAを明確にする契約設計
契約では、インフラ以外にどこまで対応するかを最初に決めます。
- 辞書更新:新語や専門用語への対応頻度。
- 精度監視:モニタリングの実施範囲。
- 再学習:回数と評価の保守範囲への組み込み。
- 役割分担:発見・承認・反映の担当。
一般の保守契約では、監視やバグ修正だけが対象になりがちです。辞書更新やモデルの再学習が範囲外のままだと、契約後に食い違いが生じます。
精度SLAでは、精度が下がったときの対応方法を定めます。あわせて、辞書更新や再学習の回数と、超過した場合の費用も契約に記載します。これにより、運用中の認識違いや費用の膨張を防ぎやすくなります。
精度は入力される言語データの状況に大きく左右されます。そのため、ベンダーが一方的に高い精度を保証する形は、現実的とはいえません。発注側も、専門用語の説明やアノテーション基準の判断に協力する必要があります。
辞書の運用では、未知語を見つける人、承認する人、反映する人を分けて決めておきます。
精度劣化を早期検知する監視体制と実用ラインの設計
TCOを抑えるには、精度劣化を早く検知し、必要な更新だけを行います。
- 自動監視:精度が閾値を下回った際の通知。
- 実用ライン:業務に必要な精度水準の設定。
- 段階改善:事例の蓄積と優先度順の反映。
劣化への対応が遅れると、誤分類や抽出漏れの損失が積み上がります。その結果、大規模な辞書整備や再学習が必要になることがあります。
精度を常時監視しておけば、劣化が大きくなる前に手を打てます。監視を自動化すれば、長期的なランニングコストも下げられます。
Human-in-the-Loopで人が確認するなら、8割程度で十分な場合もあります。一方で、過剰な精度を求めると、辞書整備や再学習の費用が指数関数的に膨らみます。業務に必要な実用ラインを見極め、そこを目標に据えます。
誤分類や抽出漏れの事例を溜めておき、優先度の高いものから順に辞書やモデルへ反映します。小さく反映を重ねれば、大規模改修に頼らずに済みます。さらに、年間を通じた費用のばらつきも、小さくできます。
まとめ
自然言語処理の運用費は、推論、辞書とデータ、人的保守の3区分で考えます。辞書更新や再学習など、精度を保つための費用も継続的に発生します。
年間運用費は初期開発費の20〜30%が目安です。辞書更新は月3万〜10万円、再学習は1回50万〜200万円が目安です。再学習を年2〜4回行うと、年間100万〜800万円規模になります。
LLM APIも月10万〜50万円規模の従量課金になることがあります。SLMとLLMの使い分け、モデルルーティング、トークン最適化が削減の鍵です。
採算は、目先の開発費よりも数年単位のTCOで見極めます。そのうえで、実用ラインを明確にして導入を判断してください。
▼全体ガイドの記事
・自然言語処理の完全ガイド
▼見積依頼前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。