
自然言語処理の試作は、確かめたい対象に応じてモックアップ、プロトタイプ、PoCを使い分け、実データの精度と成功基準を先に固めることで、本開発の判断につながります。試作の設計は、投資対効果を大きく左右します。
自社のテキストで試すまで精度は読めないため、問い合わせの自動仕分け、契約書の固有表現抽出、レビューの感情分析など、テキストを扱う開発は例外なく小さく試して見極めます。試作の進め方は用途を問わず、自然言語処理の開発全般に共通します。
▼全体ガイドの記事
・自然言語処理の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
自然言語処理のPoC・プロトタイプ・モックアップの全体像
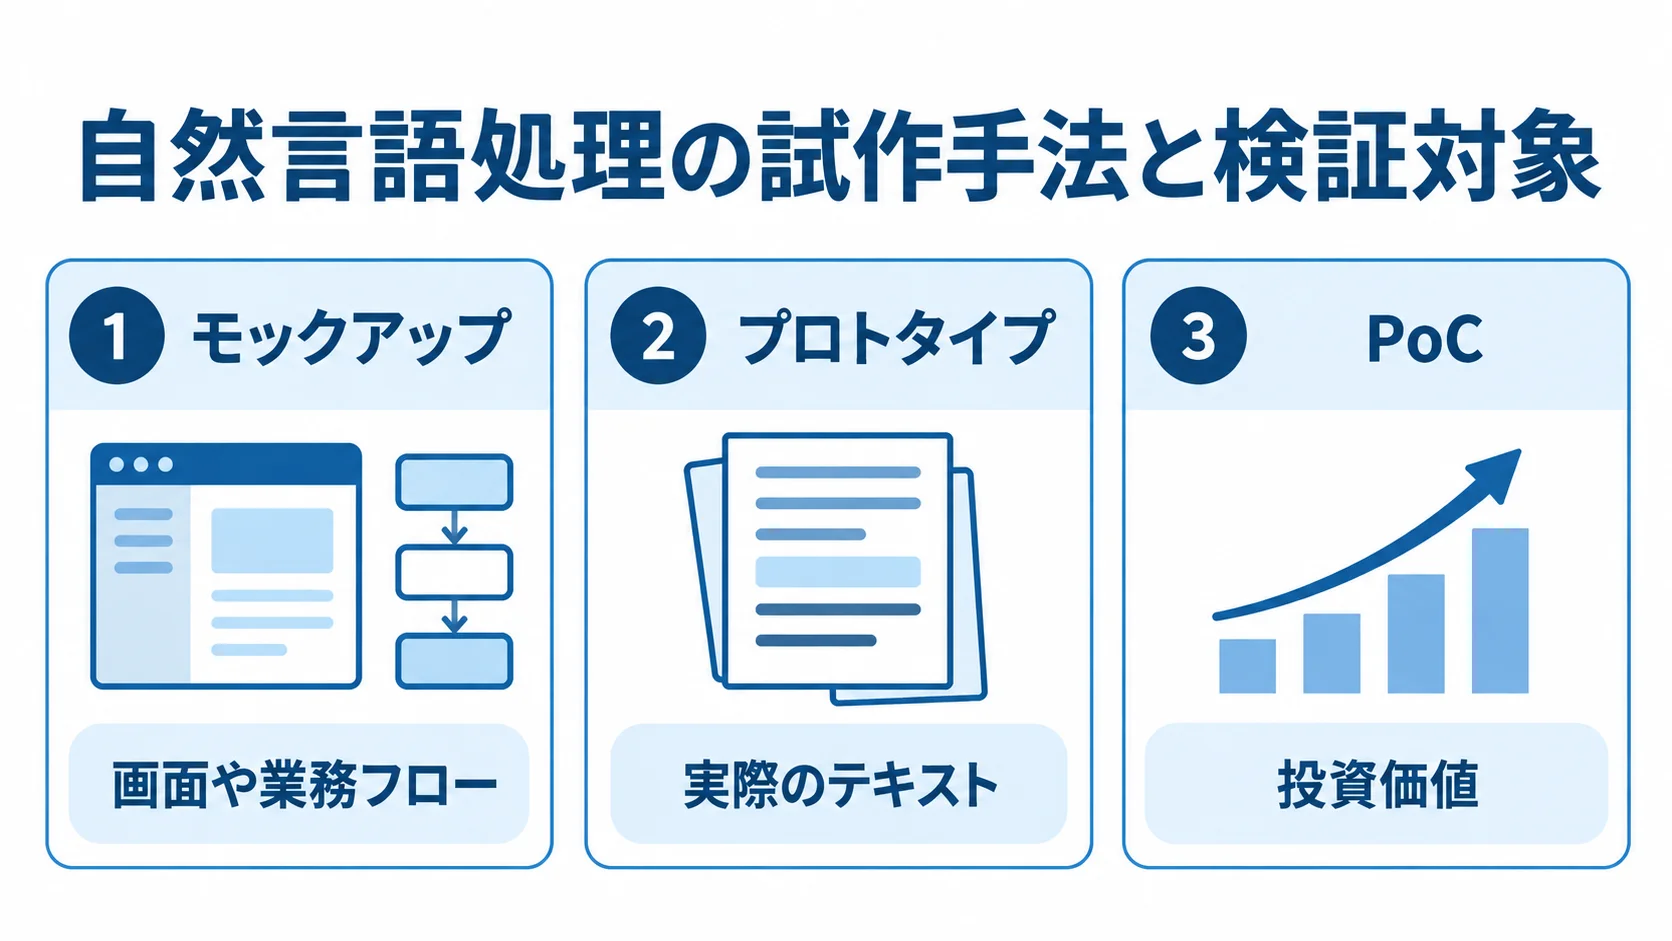
自然言語処理の試作には、目的の異なるPoC(概念実証)、プロトタイプ、モックアップがあります。確かめたい対象によって適した試作が変わるため、まず検証対象を区別して選ぶことが大切です。
モックアップは、分類・抽出・要約の結果を画面や業務フローでどう見せるかを確かめ、プロトタイプは実際のテキストで技術的な精度を検証します。一方、PoCは精度に加えて、業務改善やコスト削減への寄与と運用コストも見たうえで、ビジネス課題を解決できるか、投資に見合うかを確かめます。
業務適合に不安があればモックアップ、精度に不安があればプロトタイプ、投資判断を固めるならPoCから選ぶ方法があります。3つを段階的に、または組み合わせて使い、数週間〜数ヶ月の試作を行います。
試作で対象のテキストと課題に必要な精度の見通しを得てから、本開発へ進みます。一方、試作を省くと、日本語特有の表記揺れや専門用語で精度が出ず、多額の投資が無駄になるおそれがあります。
3つの試作アプローチの目的と使い分け
3つは確かめる対象が違うため、役割ごとに見ると使い分けが分かりやすくなります。
- モックアップ:モデルを作らず、画面やレポートでの見せ方と業務適合を確かめます。
- プロトタイプ:実際のテキストで、狙った精度が技術的に出せるかの検証です。
- PoC:精度が課題解決と採算につながるかを、ビジネス面も含めて実証します。
モックアップでは、問い合わせの分類結果や感情分析のスコアをダミーで表示し、現場の担当者が使えるかを聞きます。なお、ここでは精度を問いません。
プロトタイプでは、本番品質のパイプラインを組まず、形態素解析や既存の学習済みモデルで手元の精度指標を測ります。一方、PoCでは、業務改善やコスト削減への寄与と運用コストを踏まえて投資価値を判断します。
自然言語処理でPoCが特に重要な理由
テキストを実際に入れるまで精度が読めないため、自然言語処理では実現可能性をPoCで確かめる必要があります。
- 言葉の曖昧さ:表記揺れや同音異義語、皮肉のほか、文脈で変わる意味もあります。
- 固有の表現:業界の専門用語、社内独自の言い回し。
- データの状態:辞書にない語や、正解ラベル付きデータの不足が見つかることもあります。
課題は要件定義書の段階では見えにくく、形態素解析やモデルの検証を通して初めて、データごとの精度が分かります。
PoCでは本格投資の前に技術的な実現可能性を確かめます。同時に、社内関係者に「これなら使える」という手応えを共有し、合意形成を図ります。
PoCが重要なのは、PoC死(PoC倒れ)というよくある失敗を避けるためでもあります。生成AIプロジェクトの約3割が、PoC後に本開発へ進まず断念しているという調査結果があり、過度な期待値やデータ品質の軽視が原因とされます。
対象を1つの業務に絞り、特定部署のテキスト30〜50件程度で小さく検証するのが定石です。精度目標に届かなくても、表記揺れや専門用語、正解ラベルの不足を把握でき、その結果、必要な辞書整備やデータ整備が明確になります。
自然言語処理PoCの進め方と成功基準
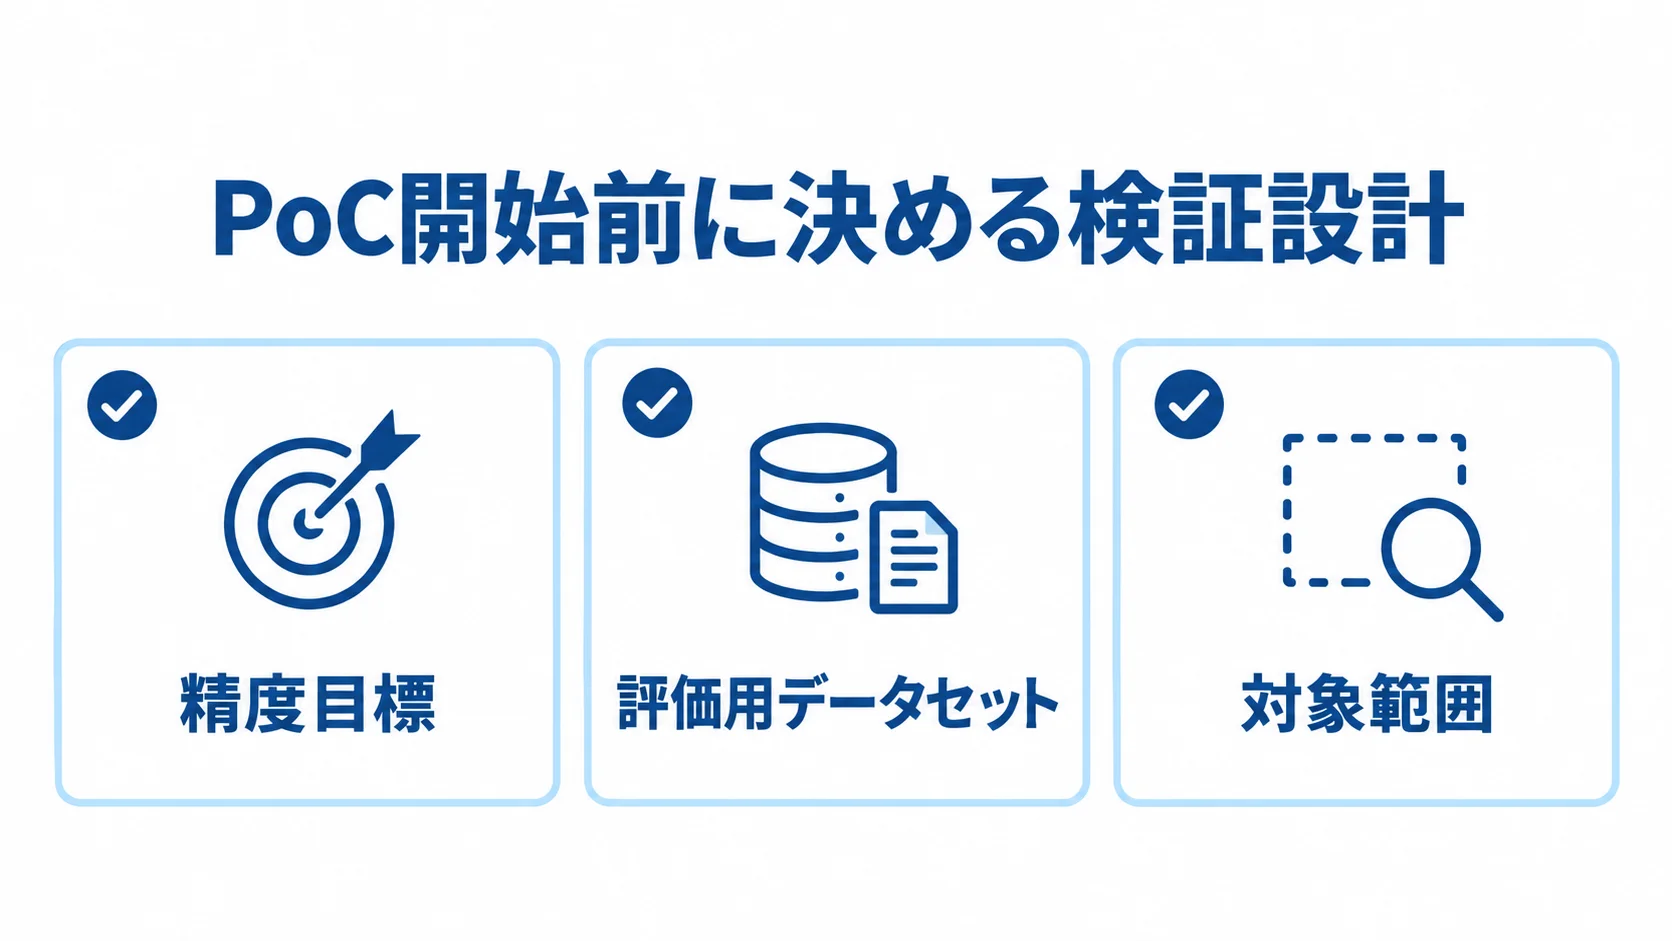
PoCは、「なんとなく分類できていそう」という感覚ではなく、客観的な基準で成否を判断できるように設計します。開始前に、何をどのテキストでどの指標で測り、どの水準を成功とするかを決めておきます。
そうすると、検証と本開発への判断がぶれにくくなります。鍵になるのは、検証設計と、成否を測る評価用データセットです。検証設計の決め方に加えて、期間・費用・体制の目安も押さえておきます。
検証設計:評価用データセット(Gold Standard)と精度指標の決め方
検証設計は、精度目標、評価用データセット、対象範囲の3要素で構成されます。
- 精度目標:業務に意味のある指標と、成功とみなす水準。
- 評価用データ:正解を付けて、成否を測るためのデータ。
- 対象範囲:1つの業務や特定部署のテキストに絞ります。
分類・抽出の精度は、Precision(適合率)、Recall(再現率)、F1スコアで測れます。重要語の見逃しを避けたい場合は、Recall@5で70%以上を目標にする例もあります。
生成や要約では、回答の正確性を80%以上にするという目標や、応答時間をレイテンシP95で5秒以内にするといった非機能要件も検証項目にできます。
Gold Standardは、PoCの成否を測るものさしです。一般的には20〜100件程度のテストデータに、期待される正解を人手で定義します。
データには代表的なケースだけでなく判断の難しいエッジケースも含め、表記揺れや誤字、口語表現を含む本番に近い実データを使います。
整いすぎたデータで成功しても、本番のテキストでは精度が出ないおそれがあります。そこで、対象を絞り、短期間で小さく検証します。
この3点を最初に決めておくことが、PoCを実りあるものにする土台です。
PoCの期間・費用・体制の目安
PoCは期間を区切ったうえで、データ準備の負荷も含めて費用と体制を見積もります。
- 期間:スモールスタートなら1〜2ヶ月が標準的な目安です。
- 費用:外部委託の小規模PoCは50万〜200万円、要件によって100万〜500万円程度です。
- 体制:データサイエンティストが中心で、データエンジニアと現場担当者が加わる形です。
クラウドNLP API(Google Cloud Natural LanguageやAzure AI Languageなど)や既存の学習済みモデルを使えるタスクでは、初期の手応えを短期間で得られることもあります。
ただし、「精度が出るまで続ける」方針だと、期間が延びて本開発を判断できないまま費用だけがかさむことがあります。そのため、あらかじめ期間を厳格に区切っておきます。
正解ラベル付けや表記揺れの統一、専門用語辞書のカスタマイズなど、データを整える作業に手間がかかると、追加費用が発生することもあります。自然言語処理のPoCでは、工数の40〜60%がデータ準備に費やされるのが一般的です。特に、テキストの状態が悪いほど費用は膨らみます。
体制では、データサイエンティストがタスクの定式化とモデル設計を担い、データエンジニアがテキストの抽出・整備を、現場担当者が専門用語の意味や業務背景を説明します。
費用を抑えるなら、本格的なPoCの前にクラウドNLP APIで自社テキストを簡易検証し、課題を解けそうか当たりを付ける方法も有効です。
プロトタイプ・モックアップの検証項目
PoCの枠内では、モックアップが使われ方を、プロトタイプが技術面の問いに答えます。目的に応じて使い分けたり、順に進めたりすることで、本開発前の不安を解消します。
モックアップで出力の見せ方・業務フロー適合を検証
モックアップでは、モデルを作る前に、自然言語処理の出力が現場でどう受け取られ、使われるかを確かめます。
- 判定の根拠:キーワードや確信度を示し、分類の理由を伝えます。
- 画面への表示:ダミーの分類結果や要約文を使った画面イメージ。
- 業務への組み込み:既存の業務画面や作業の流れに合うかどうか。
高精度な分類モデルが完成しても、結果の見せ方や業務フローが現場に合わず、使われないことがあります。分類ラベルしか示されないと、担当者が理由を理解できず、信頼されない場合もあります。
そこで、「この情報が、この形で、このタイミングで出たら仕事に使えるか」を、精度を作り込む前に早期に確認します。得られた意見は、設計に反映できます。
モデルの精度が高くても、使われなければ意味がありません。そのため、見せ方と業務フローを先に固めて、使われない失敗を防ぎます。
プロトタイプで実データでの精度と非機能要件を検証
プロトタイプでは実際のテキストを使い、データの状態から出力品質まで、技術的な成立性と現場での実用性を確かめます。
- データの状態:テキストの質と量、表記揺れや誤字、専門用語、形式。
- 目標精度:解析辞書やモデル、クラウドAPIで届く精度の水準。
- 非機能要件:応答時間や一括処理の速度が業務要件に届くかどうか。
- 出力品質:分類や要約を、現場の担当者が業務で使えるかどうかの評価。
自然言語処理には「Garbage In, Garbage Out(ゴミを入れればゴミが出る)」という原則があります。そのため、テキストの質が結果を左右すると見て検証に臨みます。
たとえば、形態素解析が精度の障害になっていないか、辞書のカスタマイズで改善するかを見ます。BERTなどの事前学習モデルをファインチューニングする方法と、クラウドNLP APIをそのまま使う方法も比べます。
予測のレイテンシが業務要件を満たすか、大量文書のバッチ処理に十分な速度があるかも確かめます。
プロトタイプでは本番品質のパイプラインは不要で、手元でモデルを動かして精度と実用性を測った結果が、本開発の技術的な判断材料になります。
PoC倒れを避けるための実践ポイント
PoC倒れとは、成功したように見えても本開発や本番運用につながらない状態です。実際、生成AIプロジェクトの約3割が、PoC後に断念しているという調査もあります。
PoC倒れを防ぐには、開始前の設計と発注時の合意が欠かせません。そのため、評価基準と契約・成果物を事前に決めておきます。実践策は、Go/No-Goの評価設計と、発注時の契約・成果物の確認の2点です。
PoC死を避ける評価基準とGo/No-Go設計
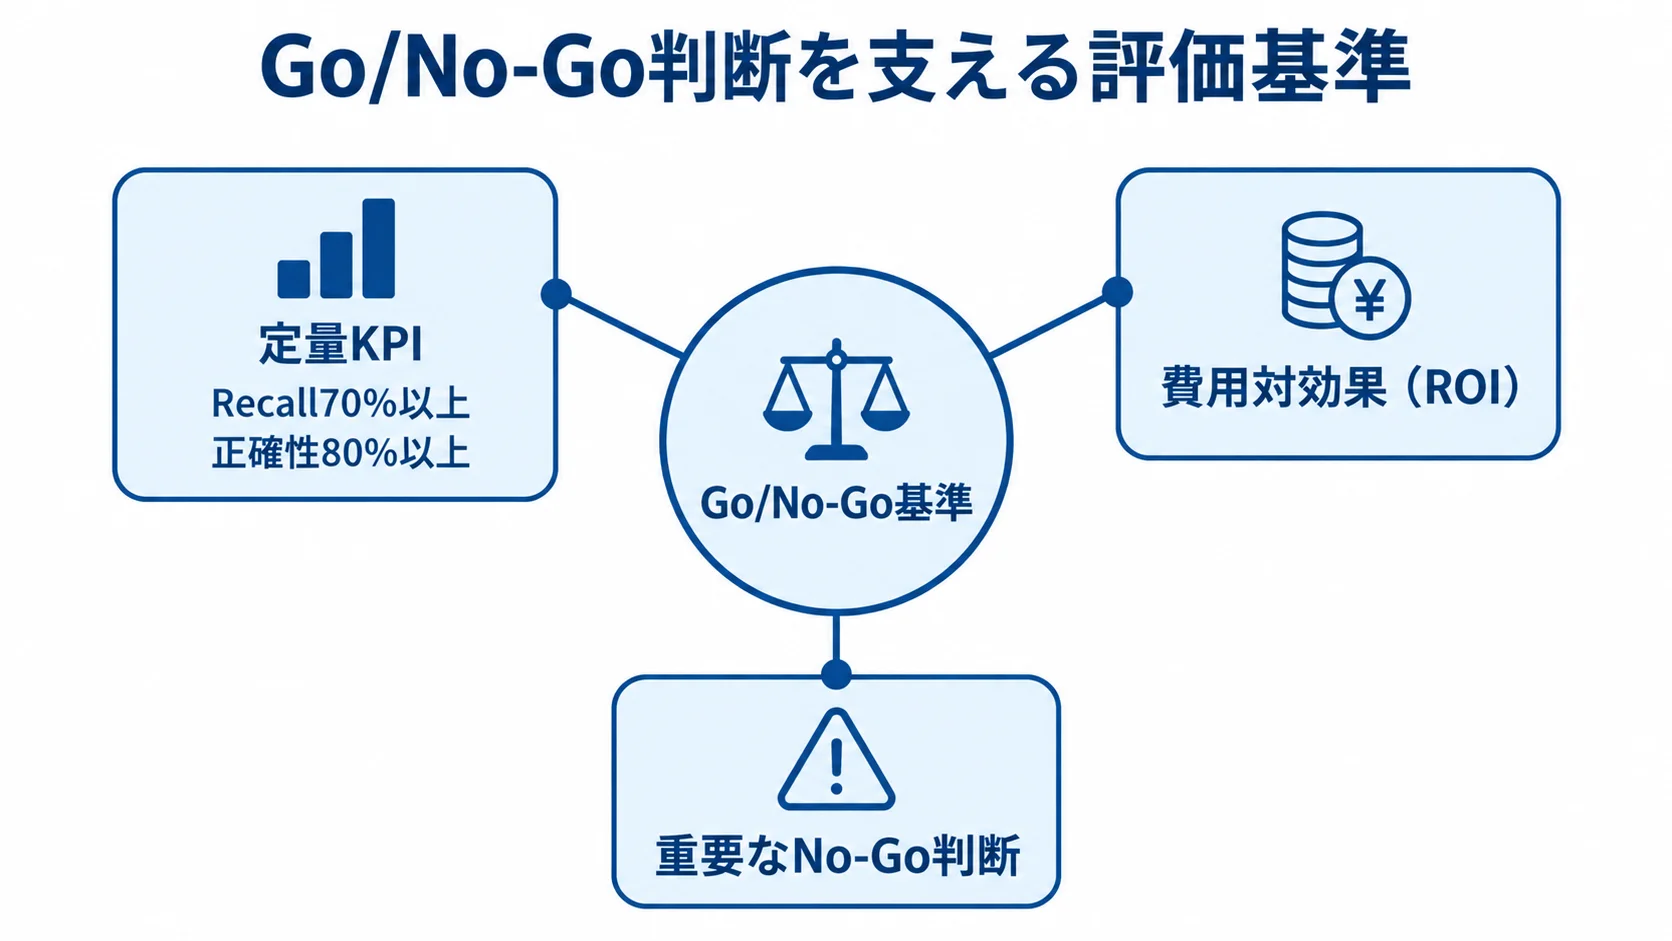
Go/No-Go基準は、PoCの開始前に関係者の間で合意しておきます。定量評価、採算、未達時の対応を、あらかじめ決めておく必要があります。
- 定量KPI:精度やレイテンシが、事前の基準を満たしたかどうか。
- 費用対効果(ROI):継続費用を、業務効率化や対応時間短縮の利益が上回るかを試算します。
- 重要なNo-Go判断:未達時の改善余地と、事前に定める中止条件。
KPIには、事前に定めたテストデータでのRecall70%以上や正確性80%以上といった水準のほか、システム性能も設定できます。
ランニングコストには、推論・API費用、辞書メンテナンス、再学習の費用などがあり、これらを業務改善の利益と比べます。
未達の場合は、辞書のカスタマイズやアノテーション基準の見直し、追加のテキスト収集で目標に届く余地があるかを判断します。
一方で、現在のデータや技術では実現できない場合は中止を検討します。「95%の精度が出て当然」と考えず、段階的なKPIと反復改善を、関係者と共有します。
発注時に確認すべきPoC契約と成果物
外部委託では、契約が精度を保証するものではないと理解したうえで、本開発の判断に必要な成果物を決めておきます。
- 契約の前提:PoCは通常、検証作業に費用を払う準委任契約です。
- 検証の成果物:モデルのソースコードと精度評価レポート。
- 次の判断材料:データの所見、推奨構成、概算見積もり。
精度は実際にテキストを扱うまで読めないため、PoCは成果物の完成を約束する請負契約ではありません。
精度が出なくても、「このテキストではこの精度が限界」と分かることは、正当な成果になります。この前提は、発注側と受注側で共有しておきます。
また、本開発に進む場合、推奨アーキテクチャには、SLMかLLMか、クラウドAPIかファインチューニングかの選択肢を含めます。
なぜその精度になったのか、辞書整備とアノテーションのどちらに投資すべきかも確かめます。これらは、次のステップを決める材料になります。
契約では、動くものを作るだけで終わらせず、本開発へ進むべきか、進むなら何をすべきかを判断できるようにします。PoCへの投資を無駄にしないためです。
まとめ
3つの試作手法の役割と使い分け、PoCの意義を整理しました。さらに、Gold Standardを使った精度評価から期間・費用・体制、各試作の検証項目、Go/No-Go設計までを見てきました。
PoCの目安は、期間が1〜2ヶ月、費用が50万〜500万円程度です。実データと20〜100件程度の評価用データセットを使って、精度を測ります。
まず、開始前に定量KPI(Recall・正確性など)とROIに基づくGo/No-Go基準を合意し、撤退ラインを明確にします。
さらに、感情分析、文書分類、固有表現抽出、要約、機械翻訳などほかの用途も、試作を経て本開発へ進みます。小さく試したうえで、客観的な基準により進退を判断することが、投資を成功させる第一歩です。
▼全体ガイドの記事
・自然言語処理の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。