
AI故障検知の開発は、要件定義・データ収集、モデル設計・開発、テスト・本番導入の順に進みます。
日本国内でも、2024年の市場規模は約7億7,000万米ドルに達し、2033年までに約74億ドル規模に成長すると見込まれています。費用は対象設備の数や連携範囲で大きく変わるため、仕組み、費用の目安、発注先の選び方も合わせて押さえておく必要があります。全体像は、下の全体ガイドで確認できます。
▼全体ガイドの記事
・AI故障検知の完全ガイド
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI故障検知の全体像
世界の予知保全市場は2024年時点で約89億6,000万米ドルに達し、2033年には910億4,000万米ドルへと年平均29.4%のペースで成長すると予測されています。
AI故障検知とは何か・仕組み
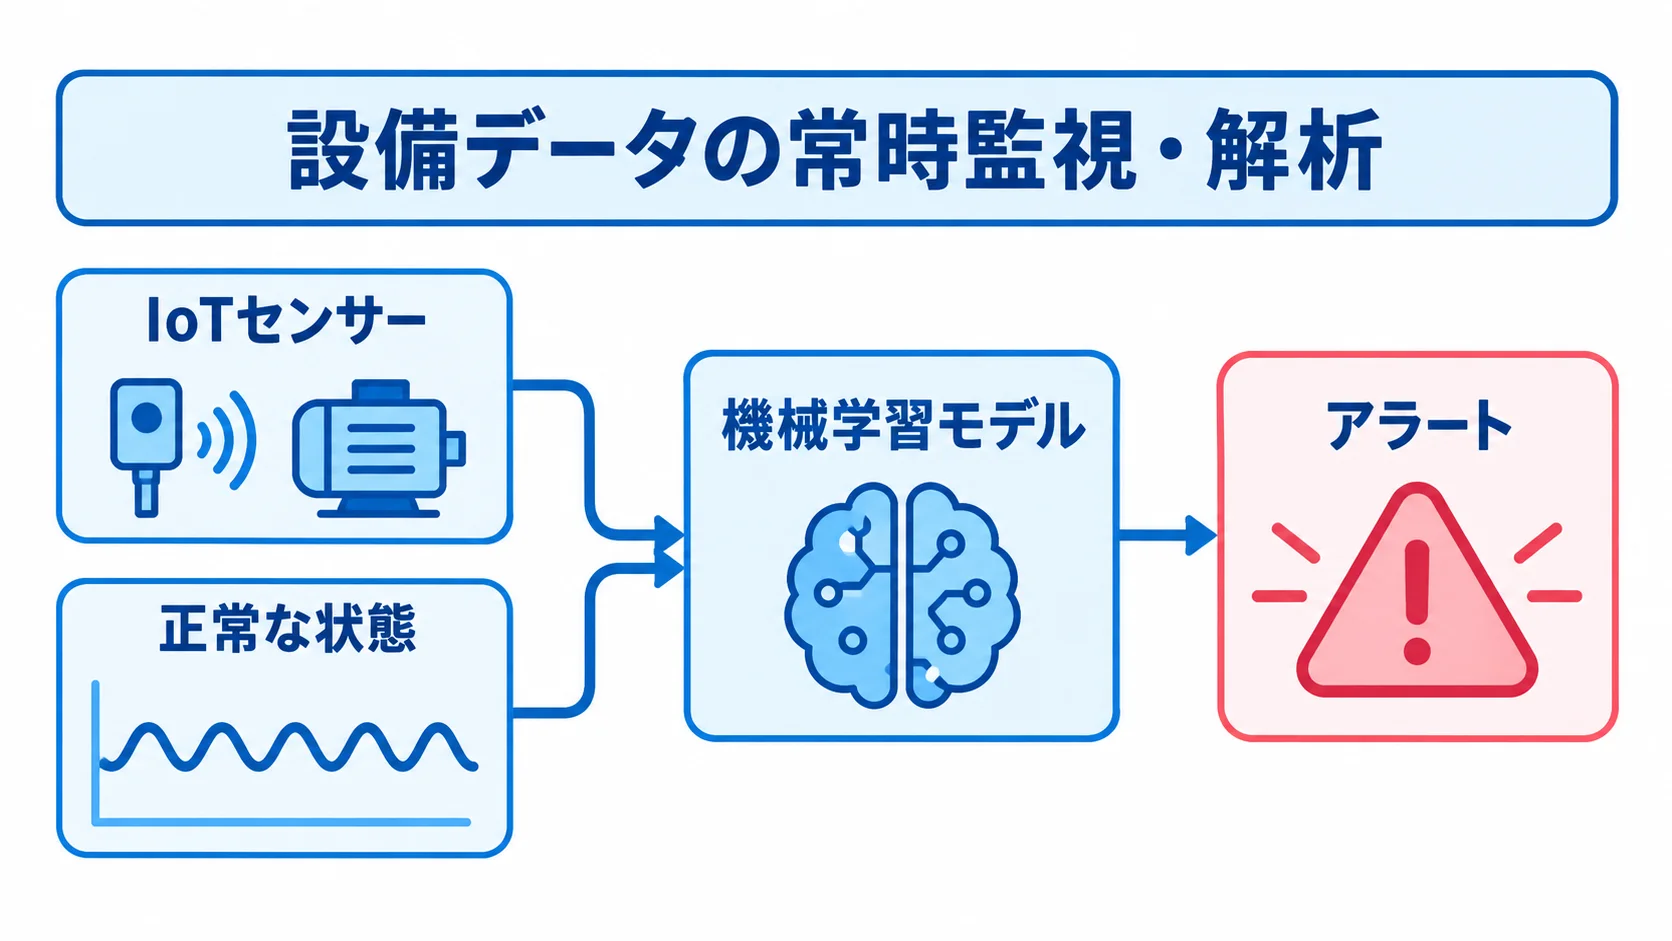
AI故障検知とは、設備や機器に取り付けたIoTセンサーの電流値・温度・振動・稼働音・圧力などのデータを、AIが常時監視・解析し、故障の予兆を早期に見つけるシステムです。従来の設備管理は、人が定期的に点検する「予防保全」か、故障後に修理する「事後保全」が主流でした。一方、AI故障検知はこれらを超えた「予知保全(Predictive Maintenance)」を実現します。
システムの核は機械学習モデルで、正常稼働時のデータを大量に学習させ、「正常な状態」のパターンを把握します。そこから外れたデータが検出されると、異常として検知し、アラートを発します。具体的には、オートエンコーダが正常データを圧縮・復元する過程で「再構成誤差」を算出し、誤差が閾値を超えると異常と判断する手法があります。
また、LSTM(長短期記憶ネットワーク)は、過去の時系列データを参照して将来の異常を予測する手法で、どちらも製造業で広く採用されています。たとえば、ファナック社の「AIサーボモニタ」は、工作機械の駆動軸のトルク・速度データをAIが解析し、故障予兆を自動検出することで、計画外停止を大幅に削減しています。
従来の故障検知との違いと優位性
従来の故障検知には、2つのアプローチがありました。1つは一定の時間間隔で点検する「定期保全(TBM:Time Based Maintenance)」、もう1つは、あらかじめ設定した閾値をデータが超えたときにアラートを出す「ルールベース検知」です。定期保全は、設備の実際の状態にかかわらず保全コストが発生するため、過剰整備になりやすい問題があります。
ルールベース検知は、シンプルで導入コストが低い反面、複雑な故障パターンや複数センサーの相関を考慮できず、見逃しや誤検知が多発します。これに対してAI故障検知は、数十〜数百のセンサーデータを同時に分析し、人間が気づけない微細な変化のパターンを学習することで、高精度な予兆検知を実現します。
JR西日本は、自動改札機に独自の故障予測AIを導入し、2021年9月の全社展開後に点検回数を30%削減、故障発生件数も20%減少させました。また、前川製作所は、産業用冷凍機へのAI故障予知導入により、保守コストの削減と、計画的保守による製造ロスの抑制を実現しています。こうした実績が示すように、AI故障検知はコスト削減を超えて、生産性向上・品質安定・顧客満足度向上という多面的な価値をもたらします。
AI故障検知開発の進め方
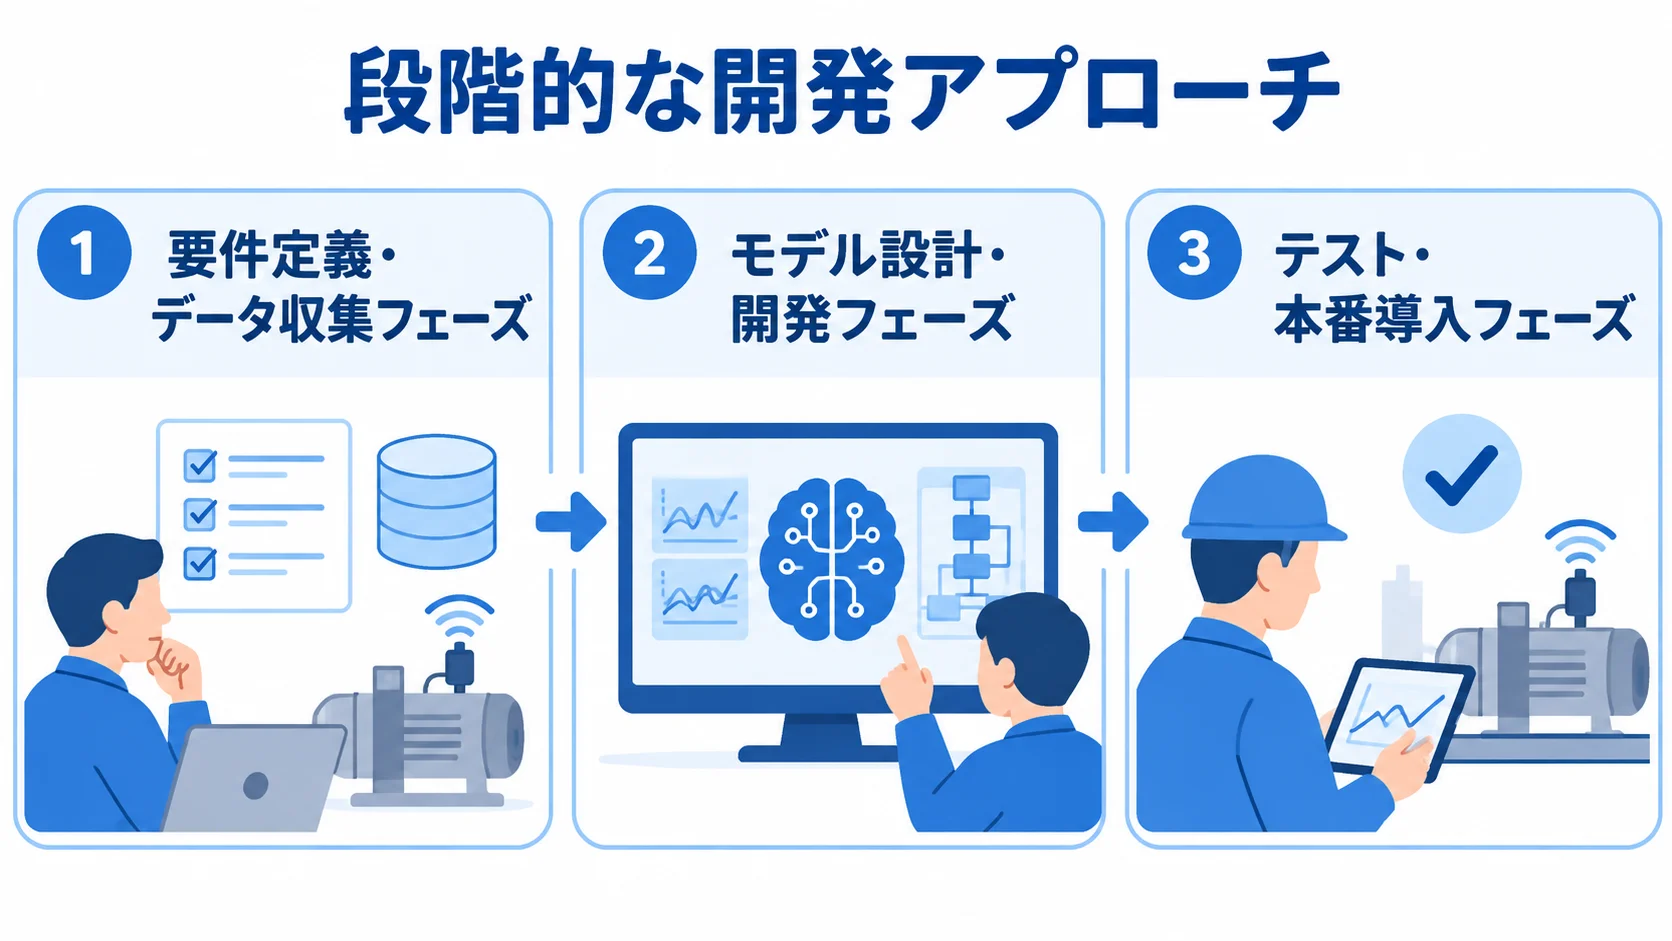
要件定義・データ収集フェーズ
AI故障検知開発の第一歩は、何を検知したいのか、どの設備を対象とするのかを明確にする要件定義です。まず対象設備を洗い出して優先順位を付け、故障時の生産への影響度や過去の故障頻度・修理費用、点検コストを総合して判断します。PoC(概念実証)では、既存の保全記録やセンサーログから少量のデータで検知可能性を確かめ、本格投資に進むのが費用対効果の面で有効です。
収集するデータは、電流値・温度・振動(加速度)・圧力・回転数・稼働音などが一般的です。対象設備に応じてセンサーの種類と設置箇所を選び、PLCやSCADAからのデータ取得やクラウドへの転送を設計します。データ形式の標準化やサンプリング周期(1秒ごと・1分ごとなど)も決めます。
特に見落としやすいのは異常時データで、AIの学習には、正常データに加えて、過去の故障事例や意図的に軽微な異常を再現したデータも必要です。ただし、設備は正常に動くよう設計されているため異常事例は稀で、保全記録やログから探す作業には想定以上の時間がかかります。モデル学習には、最低3〜6ヶ月分、理想的には1年以上の時系列データが、業界標準として推奨されます。
モデル設計・開発フェーズ
要件定義とデータ収集の後は、「データ前処理」「特徴量エンジニアリング」「モデル選定・学習」「評価と改善」の4つのステップで進みます。前処理では、欠損値の補完・外れ値の除去・センサーノイズのフィルタリング・時刻合わせなどを行い、地味ですが全体工数の3〜4割を占める重要な作業です。
特徴量エンジニアリングでは、生の加速度値に加えて、一定時間窓の平均・分散・最大値・周波数成分などを特徴量として加工すると、モデルの精度が大幅に向上します。
モデル選定では、故障パターンとデータの性質によって最適な手法が異なります。異常時データの量、ラベルの有無、時間的な変化の重視度によって、候補となる手法を使い分けます。
- 異常時データが少ない場合:正常データだけで学習するオートエンコーダやOne-Class SVMが有効です。
- 正常と異常の両方にラベルが付いたデータが揃っている場合:ランダムフォレストや勾配ブースティングなどの教師あり学習が高い精度を発揮します。
- 時間的な変化を重視する場合:LSTMやGRUなどのリカレントニューラルネットワークが適しており、長期にわたる劣化パターンの検知に特に優れています。
学習が終わったら、テストデータで検知精度を確かめます。評価では、正解率に加えて、見逃し(偽陰性)と誤報(偽陽性)のトレードオフを表す適合率・再現率・F1スコアを使うのが標準的です。製造現場では見逃しが致命的なため、再現率を重視しつつ、誤報による現場の混乱を防ぐバランスが求められます。
テスト・本番導入フェーズ
モデルの精度が要件を満たしたら、「統合テスト」「パイロット運用」「本番展開」「モニタリング体制構築」の順に導入を進めます。統合テストでは、MES・SCADA・ERPや設備監視ダッシュボードと連携させ、アラート通知や表示の正確性、負荷、遅延を検証します。この段階では、システム間のデータ形式の不整合や通信の問題が発覚することが多いため、2〜4週間の期間を確保することが推奨されます。
パイロット運用では、特定の設備や生産ラインに限って実稼働させます。現場担当者が操作感やアラートの見やすさについてフィードバックを返し、そのデータをUIの改善やアラート閾値の微調整に反映します。期間は最低でも1〜3ヶ月とし、季節変動や生産量の変化の中でも、モデルが安定して機能するかを確かめます。
設備の経年劣化や生産条件の変化で精度が下がる(ドリフト)ことがあるため、本番展開後は、監視指標を設定し、低下時に追加データで再学習する運用フローを決めておくことが、長期の安定運用の前提です。2025年以降は、エッジコンピューティングとの組み合わせによるリアルタイム処理や、継続学習(Continual Learning)フレームワークの活用が、実運用の主要課題として注目されています。
費用相場とコストの内訳
開発規模別の費用目安
AI故障検知システムの開発費用は、対象設備の数やセンサーの種類に加えて、連携範囲と求める精度水準によって大きく異なります。下の一覧は、PoCから大規模までの4段階に分けて、費用と期間の目安を示したものです。
- PoC:100万〜500万円程度で、期間は1〜3ヶ月が標準です。
- 小規模:設備5台以下・単一センサー・既存連携なしの場合で、300万〜800万円、3〜6ヶ月が目安です。
- 中規模:設備10〜30台・複数センサー・MES/SCADA連携ありの場合で、800万〜3,000万円、6〜12ヶ月を見込みます。
- 大規模:開発費用は3,000万〜1億円以上になる場合があります。
PoCでは既存データでモデルの実現可能性を検証し、本格開発へ進む判断材料を得ます。
大規模開発では、対象設備50台以上を扱い、工場全体のデータ基盤構築やリアルタイム処理、マルチサイト展開を含むことがあります。
AIシステム開発の人月単価は、100万〜250万円程度が業界相場です。データエンジニアや機械学習エンジニア、IoTエンジニアなど複数の専門職に加え、プロジェクトマネージャーも関わるため、規模が大きくなるほど費用が増えます。
費用を抑えるには、最初からすべての設備や機能を対象にせず、最も投資効果の高い1〜2設備に絞って、PoC→小規模本番→段階的拡張と進めるのが有効です。
ランニングコストと保守費用
AI故障検知は、初期開発費用に加えて導入後のランニングコストも含めた総所有コスト(TCO)で評価します。導入後は、システムを動かし続けるために毎期かかる費用が積み重なっていきます。
- クラウドインフラ費用:クラウドストレージやAIモデルの計算リソース、データ転送コストなどにかかります。
- システム保守・監視費用:稼働監視と不具合対応、ログ管理、セキュリティパッチ適用などが含まれます。
- モデル再学習費用:設備の経年変化や生産条件の変更に合わせて、年1〜2回の定期再学習が必要になります。
費用の目安は、クラウドインフラが小規模システムで月額5万〜20万円、中規模システムで月額20万〜80万円程度です。保守・監視は月額10万〜50万円程度をベンダーに支払うケースが一般的で、再学習は年間50万〜200万円程度を見込んでおきます。
導入から効果が出るまでは6ヶ月〜1年程度かかるケースが多く、本格的なROI達成には2〜3年を要するとされています。一方、ある製造業では予知保全AIの導入後に保全コストを1割削減しており、ダウンタイムの削減と合わせると、中長期の投資回収は十分に期待できます。
発注判断では、初期費用と継続費用を含む5年間のTCOと、保全コスト削減・計画外停止ゼロ化・品質向上の効果を定量的に評価することが、失敗リスクを下げるポイントです。
開発・導入時のポイントと注意点
学習データの品質確保
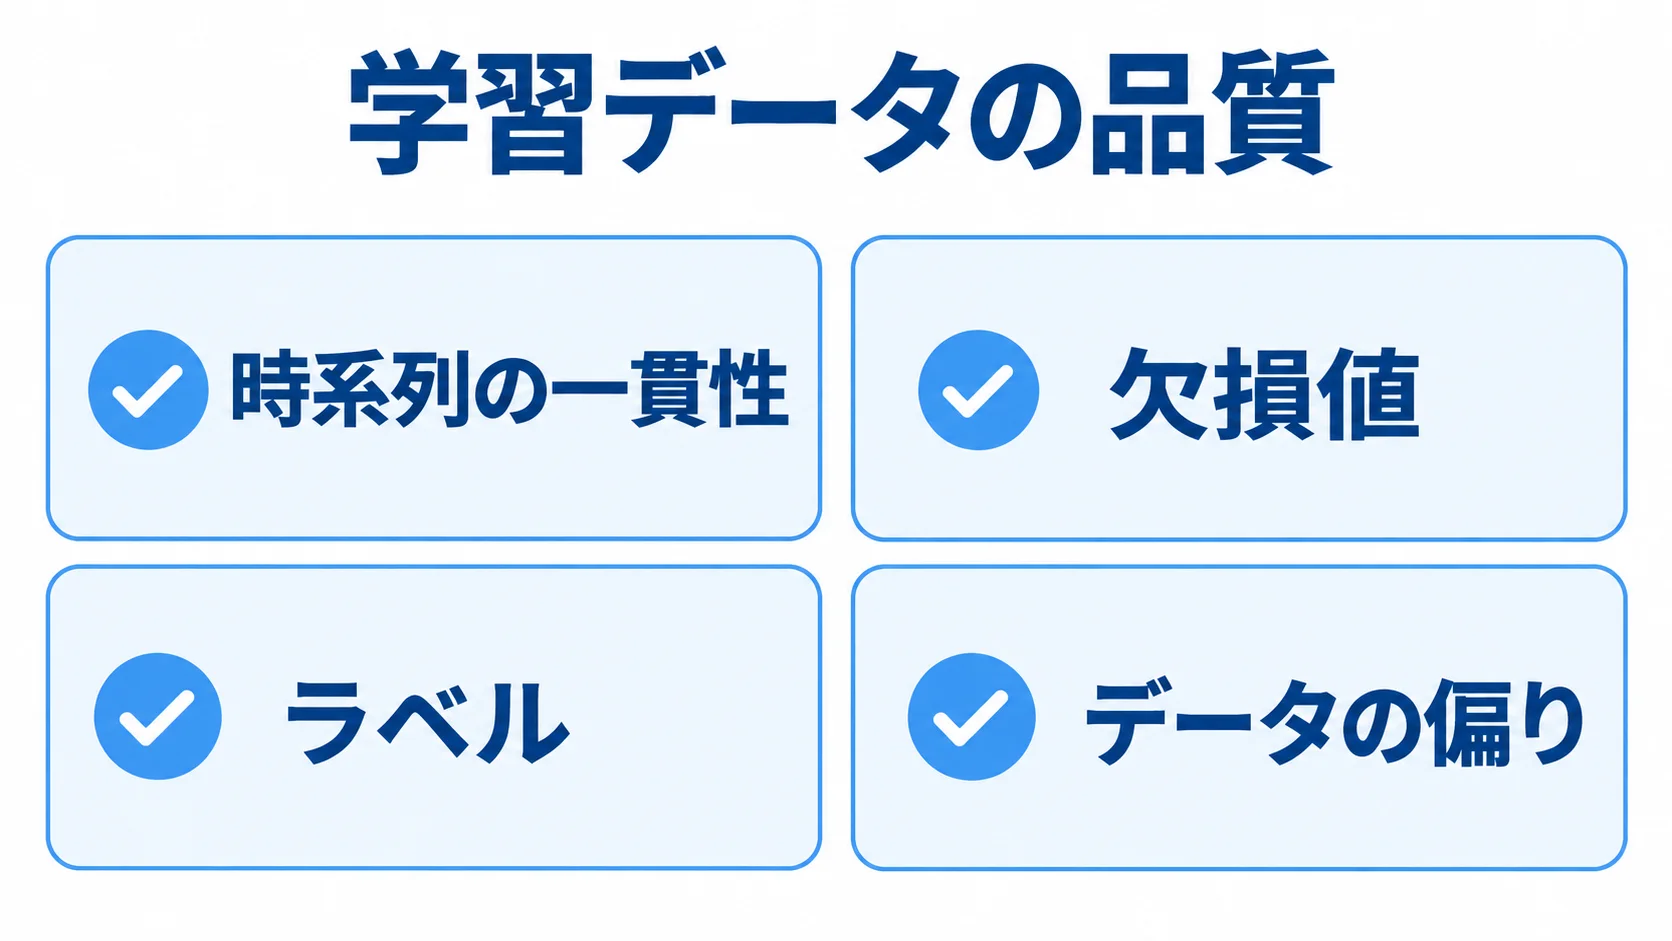
AI故障検知の精度を左右する最も重要な要素は、学習データの品質です。「ゴミを入れればゴミが出てくる(Garbage in, Garbage out)」という機械学習の原則は、故障検知でも変わりません。
- 時系列の一貫性:サンプリング周期が途中で変わったり、設備の稼働・停止状態が記録されていなかったりすると、モデルの学習が正しく行われません。
- 欠損値:処理方針を事前に決め、欠損率が5%以下なら前後の値で補完するのが一般的です。欠損率が高い場合は、その期間のデータを除外します。
- ラベル:過去の保全記録と照合して「正常」「異常」のラベルを付けますが、保全記録が不完全だったり、故障の定義が現場で異なったりすると、ラベルの精度が下がります。
- データの偏り:正常データが大量で異常データが数件しかないと、AIは「常に正常」と判定して高い正解率を出しつつ、異常を全く検知できなくなるおそれがあります。
ラベル付けには、設備を熟知したベテラン技術者の協力も欠かせません。偏りがある場合は、オーバーサンプリング(SMOTE法など)やコスト考慮型学習などの手法で対処します。さらに、データの品質管理は一時的な作業ではなく、本番運用中もデータパイプラインの健全性を監視する仕組みを作っておくことが、長期の安定稼働の基盤になります。
複数社比較と発注先の選び方
発注先の選定は、AI故障検知の成否を分ける最も重要な意思決定です。製造現場の知見とIoTデータ基盤の構築経験を両立させるベンダーは限られるため、複数社の提案を比べることが欠かせません。最低でも3社から提案を受け、比較したうえで最終判断することを強く推奨します。技術力や実績、サポート体制、費用、スケジュール、コミュニケーション品質に配点し、定量的にスコアリングする方法が有効です。
第一の視点は技術領域の適合性です。機械学習の技術力に加え、IoTセンサーのデータ収集・前処理・基盤構築の経験があるかを確かめます。データ基盤やシステム連携に対応できないベンダーに発注すると、別途インフラ構築会社が必要になり、費用と工数が増えます。さらに、本契約の前にPoC契約で技術検証を行い、期待どおりの検知精度を確かめてから本格開発に進むと、費用対効果を高められます。
第二の視点は同業界・同規模の実績で、製造業や社会インフラ、物流など近い業界の導入実績を必ずヒアリングします。事例の量より、同様の設備・データ条件での再現性のある成功パターンが大切です。第三の視点は運用・保守体制です。AIシステムは導入後もモデルの再学習・精度監視・不具合対応が必要なため、24時間対応や迅速なリカバリー体制があるかを契約前に確認します。
まとめ
AI故障検知の全体像から、開発の進め方、費用相場、導入のポイントまでを解説しました。AI故障検知は、製造業やインフラ産業で競争優位の源泉となる重要な経営課題です。
世界市場が年平均29.4%で成長を続けている背景には、JR西日本の点検回数30%削減・故障件数20%減少や、前川製作所の保守コスト削減など、実証された効果の積み重ねがあります。
開発を成功させる核心は3つで、第一に「データの品質」が挙げられます。正常と異常の両方について高品質なラベル付きデータがなければ、どれだけ高度なモデルを採用しても精度は出ません。
第二に「段階的な開発アプローチ」です。最初から全設備・全機能を対象にする全社展開より、投資効果の高い特定設備でPoC→小規模本番→段階的拡張を進めるロードマップが、費用対効果を最大化します。
第三に「運用まで見据えたベンダー選定」です。モデル開発だけでなく、データ基盤・システム連携・継続保守まで一社で対応できるパートナーを選ぶことが、長期的な成功の鍵となります。
費用面では、PoCで100万〜500万円、中規模の本格システムで800万〜3,000万円が目安です。ROI達成には導入から2〜3年程度を見込む必要がありますが、計画外停止ゼロ化・保全コスト削減・品質向上の複合効果を考慮すると、長期的な投資価値は明確です。
導入を検討する場合は、まず現状の設備保全コストと故障による損失を定量化し、優先度の高い対象設備を特定してください。そのうえで複数のベンダーに相談・提案依頼を行い、自社の課題・予算・スケジュールに合った最適なアプローチを設計することが、プロジェクト成功への確実な第一歩となります。
▼全体ガイドの記事
・AI故障検知の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック。詳細は各資料をご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。