
Amazon Redshiftは、AWSのフルマネージド型クラウドDWHです。ペタバイト規模のデータを高速に分析でき、オンプレミスDWHよりコストも抑えられます。
大量データの集計・分析を必要とし、AWSを活用している企業には有力な候補になります。適性は要件や運用体制で変わるため、導入前の性能・費用の検証が欠かせません。
▼関連記事一覧
・Amazon Redshift導入の進め方と事例|手順・プロセスを徹底解説
・Amazon Redshift導入に強いコンサルティング・開発会社・ベンダー・SIer5選|選び方のポイントも紹介
・Amazon Redshiftの導入・開発・構築費用は?コストと予算の目安を解説
Amazon Redshift導入の外注・発注先の選び方|委託・依頼時の注意点も解説もご覧ください。
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Amazon Redshiftの概要とクラウドDWHの基礎知識
Amazon Redshiftは、Amazon Web Services(AWS)が提供するフルマネージド型のクラウドデータウェアハウスサービスです。2013年のリリース以来急速に普及し、現在では世界中の数万社以上の企業がビジネスインテリジェンス(BI)や機械学習のデータ基盤として活用しています。
その最大の特徴は、従来のオンプレミスDWHと比べておよそ10分の1のコストで、同等以上のパフォーマンスを実現できる点です。
MPPアーキテクチャと列指向ストレージの仕組み
Amazon Redshiftは、MPP(Massively Parallel Processing:超並列処理)アーキテクチャと列指向(カラム指向)ストレージを組み合わせて設計されています。MPPは、複数のノードがデータを分散して並行処理する方式です。クエリを複数のスライスに分けて同時に実行するため、大量データのスキャンや集計処理で、高いスピードを発揮します。
列指向ストレージは、必要な列のデータだけを読み込むためI/Oを抑えられ、高い圧縮率でストレージコストも削減できます。これらの技術的な工夫により、他のクラウドDWHと比べて最大3倍以上の処理速度を達成できるケースもあります。
加えて、AQUA(Advanced Query Accelerator)と呼ばれるキャッシュレイヤーが、特定のクエリのパフォーマンスをさらに高めます。RA3ノードでは、ストレージとコンピューティングリソースを独立してスケールできます。
プロビジョンド版とServerless版の違い
提供形態によって課金方法と運用負荷が異なるため、利用パターンに合わせて2つの方式を比べます。
- プロビジョンド版:クラスターを自分で選定・管理し、稼働時間を基準に利用する方式
- Serverless版:インフラ管理の手間を抑え、処理能力の利用量を基準に使う方式
プロビジョンド版では、ノードタイプ(dc2、ra3など)とノード数を選んでクラスターを構築します。予測可能な大規模ワークロードや、リザーブドインスタンスで費用を抑えたい場合に向いています。
もう一つのServerless版(Redshift Serverless)は、インフラ管理が不要なサーバーレスの形態です。クラスターの起動・停止・スケーリングはAWSが自動で管理し、RPU(Redshift Processing Units)という単位で、実際に使った分だけ課金されます。
アイドル時間は課金されないため、利用頻度が不定期なワークロードや開発・テスト環境に特に適しています。
2025年4月には、Serverless版にも1年契約で最大24%割引となる「サーバーレス予約」オプションが追加されました。継続して使う場合のコストを抑える選択肢として役立ちます。
Amazon Redshift導入の5つのメリット
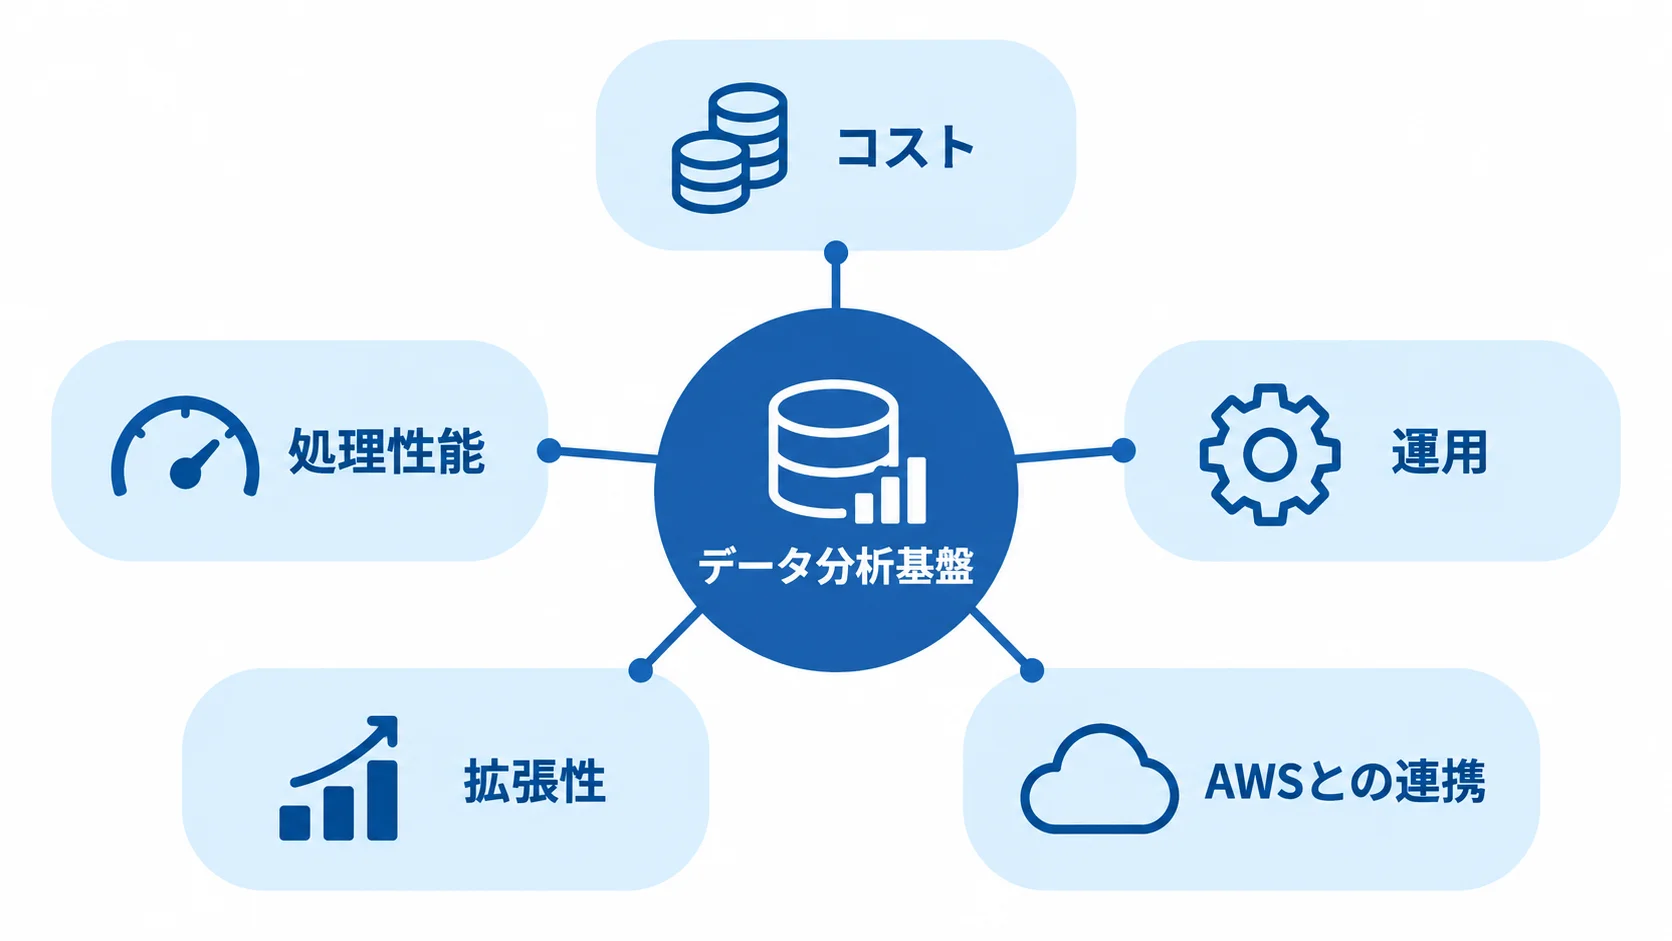
Amazon Redshiftを導入すると、データ分析基盤で多くの恩恵を受けられます。主なメリットは、コスト、処理性能、運用、拡張性、AWSとの連携という5つの観点から整理できます。
コストの大幅削減と予測可能な料金体系
Amazon Redshiftの料金は、従来のオンプレミスDWHと比べておよそ10分の1に抑えられるとAWSは説明しています。高額なハードウェア購入費・保守費・データセンター運用費が不要になるうえ、リザーブドインスタンスを使えば、オンデマンド料金から最大75%の割引を受けられます。
たとえば、プロビジョンド版の代表的なノードタイプであるra3.4xlargeは、東京リージョンでオンデマンド時間あたり約3.26ドルから利用できます。3年リザーブドインスタンスを選ぶと、このコストを大幅に圧縮できます。
また、Serverless版はアイドル時間の課金が発生しないため、分析頻度が低い組織では、さらにコストを削減できます。加えて、料金はAWSコンソールで確認できるため、コスト管理が透明になり、予算計画も立てやすくなります。企業のCFO・情報システム部門からも高く評価されています。
ペタバイト規模の高速データ処理性能
Amazon Redshiftは、数十テラバイトから数ペタバイト規模のデータを高速に処理できる性能を備えています。MPPアーキテクチャでクエリを複数ノードに分散して並列実行するため、従来のRDBMSで数時間かかっていた大規模集計が、数分以内に終わるケースも珍しくありません。
さらに、Redshift Spectrumを使えば、Amazon S3上のデータレイクに保存されたエクサバイト規模のデータをRedshiftから直接クエリできます。S3のデータをクラスターにロードせずに分析できるため、ストレージコストの削減とクエリの柔軟性を両立できます。
BI(ビジネスインテリジェンス)ツールのTableauやAmazon QuickSightと組み合わせれば、リアルタイムに近いダッシュボードの更新も実現できます。
フルマネージドによる運用負荷の軽減
オンプレミスDWHでは、ハードウェアの調達や保守に加え、OSパッチの適用やバックアップ、障害対応まで自社で行うため、多くの人手がかかりました。Amazon Redshiftはフルマネージドサービスなので、こうした運用作業のほとんどをAWSが担います。
自動バックアップはデフォルトで有効になっており、クラスター内のデータは自動的にスナップショットとしてS3に保存されます。ノード障害が起きた場合もAWSが自動で復旧処理を行うため、情報システム部門がインフラ障害対応に割く時間を大幅に減らせます。
また、Redshift Advisorという機能が、テーブルの分散キーやソートキーの最適化案、圧縮設定の改善案を自動でレコメンドします。そのため、DBAの経験が浅い組織でもパフォーマンスを保てます。
ビジネス成長に合わせた柔軟なスケーラビリティ
ビジネスの成長でデータ量が増えると、オンプレミスDWHではハードウェアの追加調達に数週間から数ヶ月かかることがあります。Amazon Redshiftなら、AWSコンソールで数回のクリックを行うだけで、数分以内にノードを追加したりノードタイプを変更したりできます。
RA3ノードを使う場合は、コンピューティングとストレージを独立してスケールできます。そのため、データが増えても、コンピューティングコストを抑えつつストレージだけを拡張するといった柔軟な対応ができます。
Serverless版なら、アクセス量の増減に応じてAWSがリソースを自動でスケールアップ・ダウンします。突発的なピーク時のパフォーマンス低下を気にしなくてよい点も特徴です。
AWSエコシステムとのシームレスな連携
すでにAWSを使っている企業にとって、Amazon RedshiftはAWSエコシステムとの深い統合が大きな強みです。Amazon S3とのデータ連携はCOPYコマンドで簡単に行え、AWS GlueがETL(データ抽出・変換・ロード)処理を自動化します。
Amazon SageMakerと連携すれば、Redshift内のデータを機械学習モデルのトレーニングに活用できます。さらに、Amazon KinesisやAWS Lambda、Amazon EventBridgeなどと組み合わせると、ほぼリアルタイムのデータパイプラインも構築できます。
IAM(Identity and Access Management)による細かなアクセス制御や、VPC(Virtual Private Cloud)内への配置によるネットワーク分離も、標準でサポートされています。こうした機能により、エンタープライズレベルのセキュリティ要件を満たしやすい点も評価されています。
Amazon Redshiftが適したユースケースと活用事例
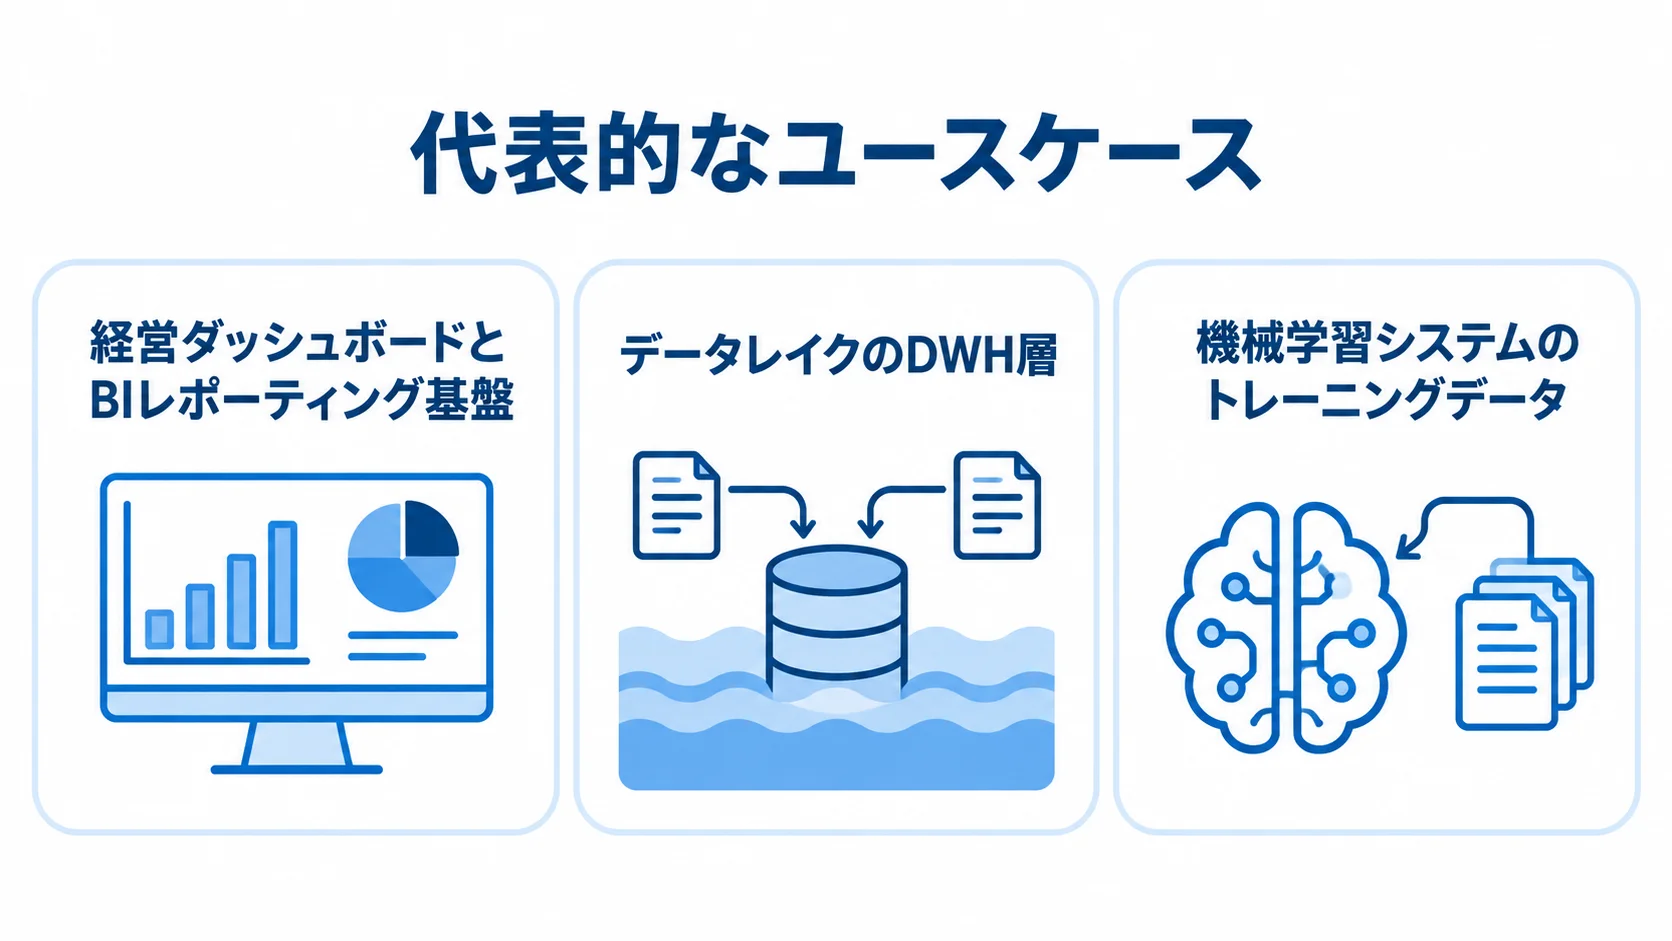
導入を判断するには、Amazon Redshiftがどのような場面で最大の効果を発揮するかを知っておくことが、導入判断では欠かせません。代表的なユースケースと、企業の活用事例を紹介します。
経営ダッシュボードとBIレポーティング基盤
Amazon Redshiftが最も多く使われる用途のひとつが、経営ダッシュボードやBIレポーティング基盤の構築です。基幹システムやCRM、広告媒体などから日次・週次でデータを集め、Redshiftに集約します。
こうして集めたデータをTableauやAmazon QuickSight、Power BIなどのBIツールと接続すると、経営陣が売上・コスト・KPIを、リアルタイムに近い形で確認できます。一方、従来のExcelベースのレポート作成では数時間かかっていたデータ集計が、Redshiftを使うと数分に短縮された事例も多く報告されています。
特に、数千万から数億行規模の取引データを扱うEC企業や金融機関での導入実績が豊富です。
データレイクの中核を担うDWH基盤
Amazon S3を中心としたデータレイクでは、Amazon Redshiftが構造化データを管理するDWH層として重要な役割を担います。ログデータや非構造化データはS3に格納し、分析に必要な構造化データだけをRedshiftにロードするハイブリッド構成が、多くのグローバル企業で採用されています。
導入事例として、バイオテクノロジー企業のModernaは、Amazon Redshiftを「Single Source of Truth(唯一の信頼できる情報源)」と位置づけています。研究データから業務データまでをまとめて管理するDWH基盤として使っており、バックアップをS3に保存するシンプルな構成により、容量の心配やリカバリ作業の手間が解消されたと報告されています。
クチコミ・レビューサービスのYelpは、急増するユーザーデータや行動ログの分析基盤としてRedshiftを導入し、機械学習システムのトレーニングデータの準備にも活用しています。
Amazon Redshift導入の進め方・ステップ
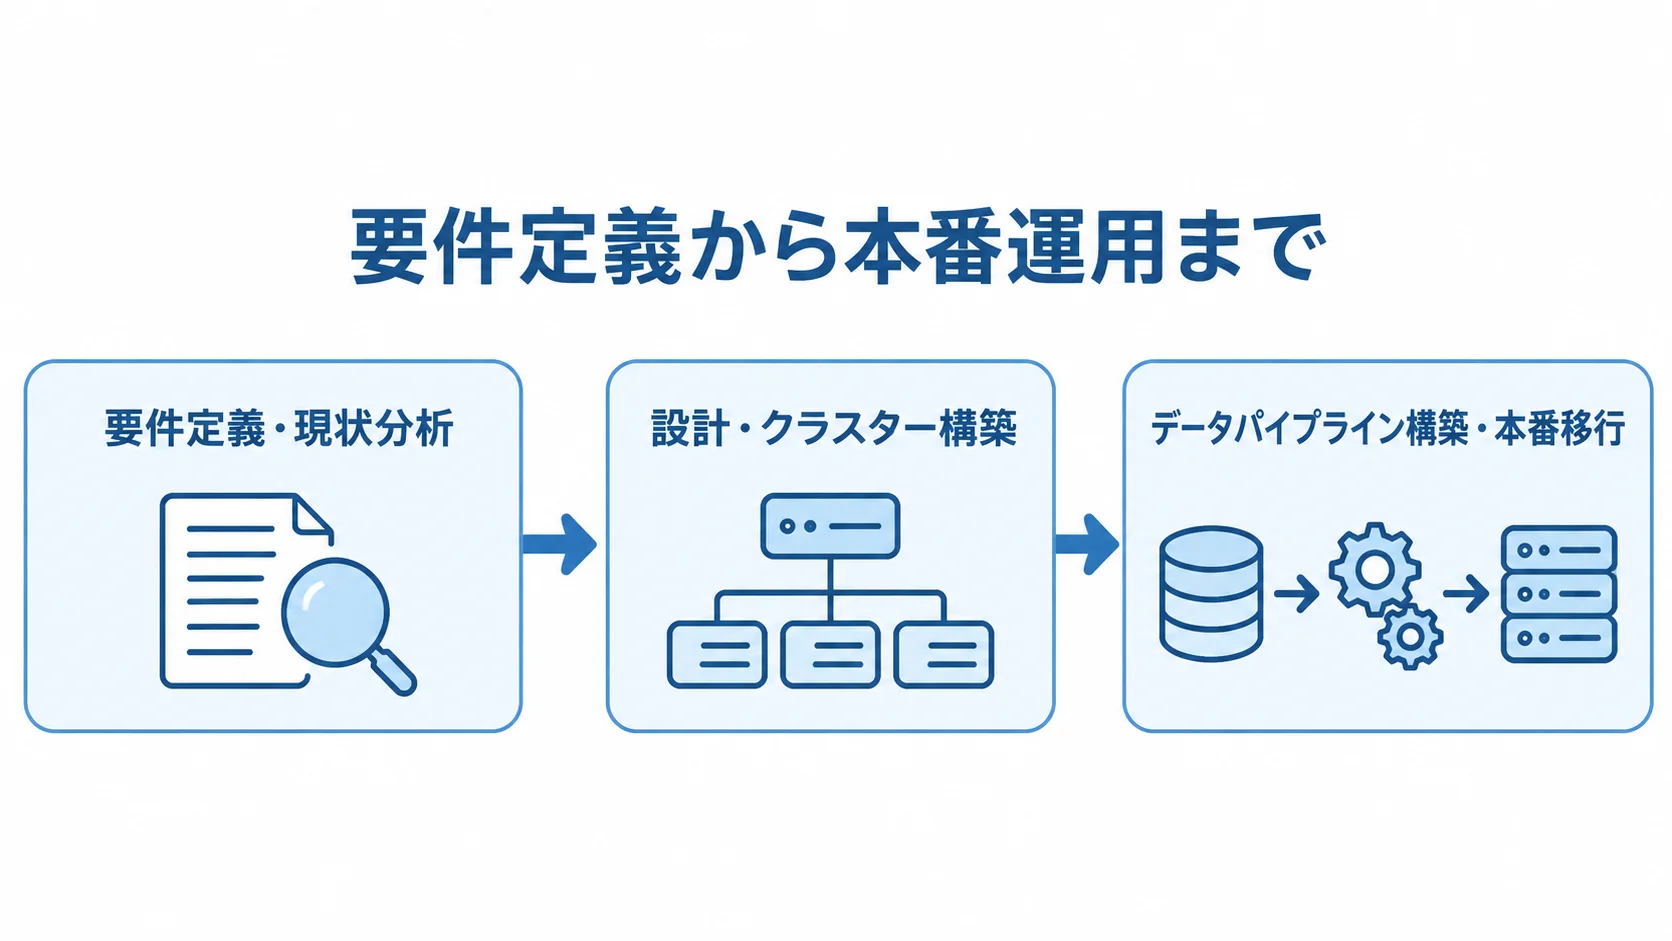
Amazon Redshiftの導入を成功させるには、要件定義から本番運用まで段階を追って進めることが欠かせません。各フェーズでの判断ミスは後のパフォーマンス問題やコスト超過につながるため、手順を先に押さえておくと役立ちます。詳細な進め方は、Amazon Redshift導入の進め方ガイドも参考になります。
フェーズ1:要件定義・現状分析
導入の最初のステップは、自社のデータ活用要件を明確にすることです。どのシステムのデータを、どの頻度でRedshiftに集約するか、どのようなクエリを実行するか、同時接続ユーザーは何人程度かを決めます。この整理は、発注側の担当者と開発会社が一緒に進めることで、後の認識のずれを減らせます。
現在のデータ量(テラバイト規模か、将来的にペタバイトに達するか)と保存期間、ISMSやPCIDSS、個人情報保護法などへの対応も、発注側と開発会社が同時に整理します。
この段階では、「Serverless版かProvisioned版か」という重要な選択も行います。利用頻度が高く大規模なワークロードが続く場合はProvisioned版、利用頻度が不定期・低頻度の場合や、まず試験導入から始めたい場合はServerless版が推奨されます。
フェーズ2:設計・クラスター構築
要件が固まったら、クラスター設計とテーブル設計に進みます。クラスター設計では、ノードタイプとノード数を選びます。現時点では多くのケースでRA3ノードが推奨されており、用途に合わせて、ra3.xlplus(2ノード〜)やra3.4xlarge、ra3.16xlargeなどから選びます。
テーブル設計では、Amazon Redshift特有の「分散キー(DISTKEY)」と「ソートキー(SORTKEY)」を設定します。分散キーは、データを分散させるノードを決めるキーで、結合頻度が高いカラムに設定すると、ノード間のデータ移動を最小化できます。
ソートキーは、ディスク上のデータの並び順を決めるもので、WHERE句でよく使われるカラムに設定すると、ゾーンマップを活用した効率的なスキャンが可能になります。VPCの設定やセキュリティグループ、IAMロールの割り当ても、この段階で行います。
フェーズ3:データパイプライン構築・本番移行
クラスターが準備できたら、データを継続的にRedshiftへ投入するETLパイプラインを構築します。AWSでは、AWS GlueまたはAmazon Data Firehoseを使ったマネージドETLが多く採用されています。
既存のオンプレミスDWHから移行する場合は、AWS Schema Conversion Tool(SCT)で既存DDLをRedshift用に変換します。そのうえで、AWS Database Migration Service(DMS)でデータを移行するのが一般的です。
データロードは、次の2つの方法を比べて進めます。
- 推奨する方法:S3経由でCOPYコマンドを使う方法で、最も効率的です。
- 避けたい方法:INSERT文で1行ずつロードすることで、パフォーマンス上の鉄則です。
本番移行の前には十分なパフォーマンステストを行い、代表的なクエリが期待どおりの応答速度で返ってくることを確かめてから、切り替えを実施します。
Amazon Redshift導入の費用と料金体系
導入の判断には、Amazon Redshiftの費用を正確に把握しておくことが欠かせません。AWSの料金はサービス・リージョン・利用形態によって変わるため、主な費用項目と目安を押さえておく必要があります。詳細な費用の試算は、Amazon Redshift導入の費用・料金比較記事もご覧ください。
プロビジョンド版の料金(東京リージョン目安)
プロビジョンド版の料金は、ノードタイプと台数で決まります。現在の主流であるRA3ノードのオンデマンド料金(東京リージョン)の目安は、ra3.xplusが1ノードあたり時間0.886ドル、ra3.4xlargeが時間3.26ドルです。ra3.16xlargeは時間13.04ドル程度です(2025年時点)。
最小構成はra3.xplusの2ノードからで、月額換算では約1,300ドル(約20万円前後)が最低ラインとなります。また、リザーブドインスタンスを1年契約で購入すると、オンデマンド比で約40〜50%割引、3年契約では最大75%割引が適用されます。
データ転送費(Redshiftクラスターへのデータ転送は無料、クラスター外への転送は有料)や、スナップショットのストレージ費用(GB/月単位)も加わります。構築支援を外部のシステムインテグレーターに依頼する場合は、別途数十万円から数百万円の初期費用が発生します。
Serverless版の料金と初期導入から運用までのトータルコスト
Serverless版の料金は、RPU(Redshift Processing Units)という単位で計算されます。東京リージョンでは1RPU時間あたり0.495ドル程度で、デフォルトの最低キャパシティは8RPUです。ワークロードに応じて、自動でスケールします。
アイドル時間(クエリが実行されていない時間)は課金されません。そのため、1日のうち業務時間のみ(8時間程度)しか使わない場合は、プロビジョンド版よりも大幅にコストを抑えられる可能性があります。
トータルコストは、総所有コスト(TCO)で見ることが大切です。AWSの利用料のほか、ETLツール(AWS Glue)やBIツールのライセンス料、構築・移行費用(SIer委託の場合)、社内エンジニアの工数も含めて評価します。一般的に、RedshiftのAWS利用料だけで月額数万円から数十万円の範囲になるケースが多く、大規模システムでは月額数百万円に達することもあります。
Amazon RedshiftとBigQuery・Snowflakeの比較
クラウドDWHを選ぶ際は、Amazon Redshiftと並んでよく比べられるのがGoogle BigQueryとSnowflakeです。
それぞれの特徴を理解し、自社に合うサービスを選ぶことが、導入を成功させる第一歩になります。
Google BigQueryとの比較
Google BigQueryは、Googleが提供するサーバーレス型DWHです。インフラ管理がほぼ不要な点と、クエリ量(スキャンしたデータ量)に応じたオンデマンド課金が特徴です。1TB分の無料枠があるため、小規模なアドホック分析では費用を抑えやすい一方、大量のクエリを頻繁に実行する環境では、コストが予測しにくくなることがあります。
Amazon RedshiftはAWSエコシステムとの親和性が高く、すでにAWSを使っている組織なら、既存の認証・ネットワーク設定を流用できる点が有利です。また、RedshiftはSQLの方言がPostgreSQLに近いため、PostgreSQL経験者は学習コストが低い傾向があります。
一方、BigQueryはリアルタイム分析(ストリーミングインサート)との親和性が高く、Google WorkspaceやLooker Studioとのシームレスな連携も強みです。既にGoogle Cloudをメインクラウドとして使っている企業には、BigQueryの方が適している場合があります。
Snowflakeとの比較
Snowflakeは、AWS・GCP・Azureに対応したマルチクラウドのDWHです。コンピューティングとストレージを完全に分離したアーキテクチャが最大の特徴です。「仮想ウェアハウス」と呼ばれるコンピューティングリソースを複数起動すれば、部門ごとに独立したワークロードを実行できるため、大規模な組織での利用に向いています。
また、半構造化データ(JSON、Parquet等)の扱いやすさはSnowflakeが優れており、スキーマオンリード(データロード時に変換不要)の設計により、柔軟なデータ活用が可能になります。Amazon Redshiftと比べると、AWSとの深い統合とコスト予測のしやすさ(リザーブドインスタンス活用)の2点で、Redshiftに優位性があります。
マルチクラウド対応が必要な場合や、複数部門が独立してデータ分析を行う組織では、Snowflakeが選ばれることが多い傾向です。
Amazon Redshift導入時の注意点と失敗を防ぐポイント
Amazon Redshiftは優れたサービスですが、設計や運用の落とし穴を知らずに導入すると、期待したパフォーマンスが得られなかったり、コストが想定を大きく超えたりすることがあります。
テーブル設計の失敗とパフォーマンス低下
Amazon Redshiftで最もよくある失敗のひとつが、分散キー(DISTKEY)とソートキー(SORTKEY)の設計ミスです。分散キーを適切に設定しないと、特定のノードにデータが偏るデータスキューが起き、クエリの性能が大きく下がります。
たとえば、ユニーク値の数が少ないカラム(性別、都道府県など)を分散キーに選ぶと、ほとんどのデータが1〜2つのノードに集中してしまいます。ソートキーも、WHERE句で頻繁に使われるカラムに設定するのが基本です。これを怠ると、ゾーンマップの効果が得られません。
VACUUMとANALYZEというメンテナンス操作も、定期的に実行しないとパフォーマンスが劣化します。Redshift Advisorは改善案を自動でレコメンドしてくれます。提案は、実際のクエリパターンと照らし合わせて検討することが大切です。
Redshiftが向かないユースケース
Redshiftは、ペタバイト規模の大量データを高速に集計・分析することに特化したサービスです。そのため、データ基盤の要件によって向き不向きがあり、導入の要否は慎重に判断する必要があります。特に、リアルタイムデータの更新・参照が必要なOLTP(オンライントランザクション処理)には向きません。
Redshiftは列指向ストレージを採用しているため、1件ずつのレコードの挿入・更新・削除は性能が出にくいです。トランザクション系のデータベースには、Amazon RDSやAuroraなどを使うのが適切です。
また、JSONやXMLなどの半構造化データの扱いは、SnowflakeやBigQueryと比べると柔軟性が低めです。頻繁に構造が変わるデータを大量に扱う場合は、他のサービスも検討する必要があります。さらに、データ量が数GBから数十GB程度と小さい場合は、RDSやAurora Serverlessのほうが効率的なこともあります。
コスト管理と最適化の継続的な取り組み
Amazon Redshiftは、適切に管理しないと想定外のコストが発生することがあります。特にProvisioned版では、使っていない時間帯もノードが稼働し続けるため、開発・テスト環境を24時間365日稼働させると、無駄なコストが積み重なります。
開発環境はServerless版に切り替えるか、使わない時間帯にクラスターを一時停止する運用を検討できます。また、Redshift Spectrumを使ってS3のデータを直接クエリする場合は、スキャンされたデータ量に応じて課金されるため、パーティショニングでスキャン量を絞ることが欠かせません。
AWS Cost Explorerや予算アラートで月次コストを監視し、Redshift Advisorが示すコストの見直し案も定期的に確認する運用体制を整えることをお勧めします。
Amazon Redshift導入の外注・発注方法
社内にAWSの専門エンジニアがいない場合や、短期間でスムーズに導入したい場合は、AWSパートナーであるシステムインテグレーター(SIer)へのアウトソーシングが有効です。発注の進め方・選び方の詳細については、Amazon Redshift導入の外注・発注ガイドをご参照ください。信頼できるパートナーを探している方は、Amazon Redshift導入支援会社の比較記事も参考になります。
外注できる作業範囲と内製化のバランス
Amazon Redshift導入プロジェクトで外注が有効な作業は、要件定義の支援、アーキテクチャ設計、クラスター構築・設定などです。テーブル設計のレビュー、ETLパイプライン開発、既存DWHからのデータ移行も含まれます。さらに、BIツールとの接続設定や初期チューニング、社内担当者へのトレーニングも外注の範囲に入ります。
一方、自社のビジネスロジックに基づくデータモデル設計(どのデータを・どのような形で分析したいか)は、業務部門の知識が不可欠なため、内製化すべき部分です。自社の情報システム部門やデータエンジニアリングチームが主体となって要件を定義し、SIerはその技術的な実現を支援する役割分担が理想的です。
プロジェクト完了後の運用保守(監視、チューニング、コストの見直し)は、外注を続けるか内製化するかを、事前に決めておく必要があります。
信頼できる導入支援パートナーの選び方
Amazon Redshift導入支援パートナーを選ぶ際には、判断の基準がいくつかあります。まず、AWSの認定資格(AWSパートナーネットワークのティアや専門コンピテンシー)を確認することが基本です。
それだけでなく、実際にRedshiftを使ったデータ基盤構築の実績数や、業界(製造・流通・金融・ヘルスケアなど)での経験も重視してください。提案の段階では、自社の業務要件を理解したうえでアーキテクチャ案を出してくれるか、コスト試算の根拠が明確かどうかも、評価の目安になります。
また、導入後の運用保守や追加開発への対応体制、SLAの明確さ、担当エンジニアの経験レベルも確認しておくとよいでしょう。複数社から見積もりを取り、技術提案の内容、費用、アフターサポートを総合的に比べて判断することをお勧めします。
まとめ
Amazon Redshiftは、フルマネージドで高性能なクラウドデータウェアハウスとして、大量データの分析基盤を必要とする企業にとって非常に有力な選択肢です。MPPアーキテクチャと列指向ストレージによる高速処理性能、オンプレミスと比べた大幅なコスト削減、AWSエコシステムとの深い統合は、大きな強みです。
さらに、Serverless版による柔軟な利用形態も強みです。一方で、テーブル設計の良し悪しがパフォーマンスに直結することや、リアルタイムのトランザクション処理には向かないこと、コスト管理を怠ると想定外の費用が発生することなど、押さえておくべき注意点もあります。
導入を成功させるには、要件定義と設計から始め、データパイプライン構築や本番移行、運用の見直しまで各フェーズを丁寧に進めることが大切です。必要に応じて、専門的な導入支援パートナーを活用することも有効です。
本記事が、皆さんのAmazon Redshift導入の意思決定と計画策定に役立てば幸いです。
開発を相談する前に、次の無料ホワイトペーパーも参考にしてください。
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブックもご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。