
Azure Synapse Analyticsは、データウェアハウスとビッグデータ分析を一つの環境で扱う、Microsoftの統合データ分析サービスです。
導入は、要件定義から設計、本番移行へと進みます。進め方の詳細はAzure Synapse Analytics導入の進め方をご覧ください。
▼関連記事一覧
- Azure Synapse Analytics導入の進め方と事例|手順・プロセスを徹底解説
- Azure Synapse Analytics導入に強いコンサルティング・開発会社・ベンダー・SIer5選|選び方のポイントも紹介
- Azure Synapse Analyticsの導入・開発・構築費用は?コストと予算の目安を解説
- Azure Synapse Analytics導入の外注・発注先の選び方|委託・依頼時の注意点も解説
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Azure Synapse Analyticsの全体像
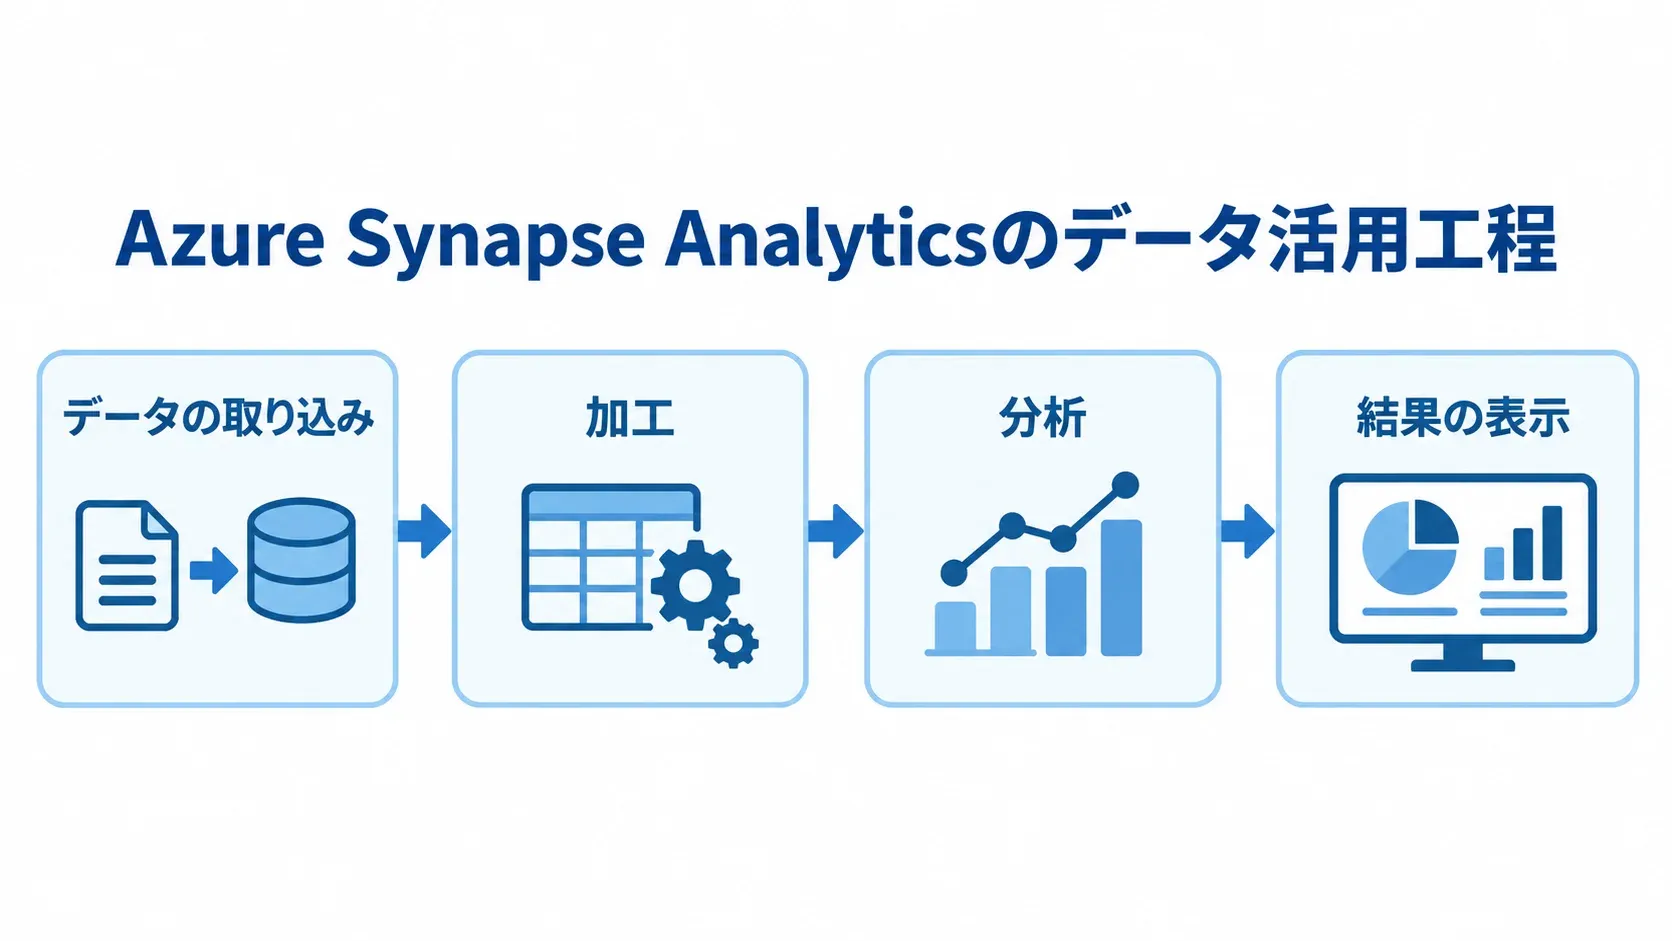
Azure Synapse Analyticsは、Microsoftが2020年に正式リリースした統合データ分析サービスです。従来は、データウェアハウス(Azure SQL Data Warehouse)とビッグデータ分析(Azure HDInsight)が別々のサービスでした。一方、Azure Synapse Analyticsでは、一つの統合されたワークスペースで管理できるようになりました。
データの取り込みから加工、分析、結果の表示まで、データ活用の全工程を単一のプラットフォームで実行できることが最大の特徴です。さらに、データレイクとデータウェアハウスの双方のユースケースに対応できるため、企業の多様なデータ活用ニーズを一元的に満たせます。
主要コンポーネントと機能
Azure Synapse Analyticsの主な機能は4つあり、データウェアハウス、データレイクへのSQL実行、Spark分析、データ統合を担います。
- 専用SQLプール:従来のAzure SQL Data Warehouseに相当し、大規模なデータウェアハウスを構築する。
- サーバーレスSQLプール:データレイクのデータにSQLクエリを実行する機能。事前のインフラ準備が不要で、分析したデータ量に応じて従量課金。
- Apache Sparkプール:オープンソースの分散処理フレームワークApache Sparkを使うビッグデータ分析機能。
- Synapse Pipelines:データ統合・オーケストレーション機能。コードを書かずにGUIで、多様なデータソースの取り込みと変換処理を設計できます。
専用SQLプールは、MPP(Massively Parallel Processing)アーキテクチャを採用しています。ストレージ層とコンピューティング層が分離しているため、それぞれ独立してスケーリングできます。
Sparkプールは、Python、Scala、Javaなど複数の言語に対応しており、機械学習モデルの構築や複雑なデータ変換処理を実行できます。
他のAzureサービスとの違い・連携
Azure Synapse Analyticsは、Power BIやAzure Machine Learningとネイティブに統合されています。そのため、分析結果をダッシュボードとして可視化したり、機械学習モデルの構築から運用までを一貫して行ったりできます。
Azure Data Factoryと比較すると、Synapse Pipelinesは機能的にほぼ同等です。ただし、Synapseワークスペース内で完結できる点が利点です。
Azure Databricksとの間には、役割の棲み分けがあります。Synapseは統合プラットフォームとして幅広い機能を扱うのに対し、Databricksはデータエンジニアリングと機械学習に特化した深い専門機能を持ちます。さらに、すでにMicrosoft 365やDynamics 365を利用している企業であれば、Synapseとの連携でデータ活用の幅が大きく広がります。
Azure Synapse Analytics導入のメリット
Azure Synapse Analyticsの導入で得られるメリットは多岐にわたります。単なるデータウェアハウスの置き換えにとどまらず、データ活用全体の効率化と高度化を実現できる点が、多くの企業に選ばれている理由になっています。
統合環境による業務効率化
Azure Synapse Analyticsの最大のメリットは、データ統合・蓄積・分析・表示までを一つのワークスペースで完結できる点です。従来のデータ基盤では、取り込みには別のETLツール、分析にはデータウェアハウス、可視化にはBIツールと、複数のサービスを組み合わせる必要があり、それぞれの管理や連携に多くの工数がかかっていました。
Synapse Studioと呼ばれる統合開発環境上で、データエンジニア・データサイエンティスト・ビジネスアナリストが同一の環境を利用できます。たとえば、データエンジニアはコーディングなしでGUI操作によりパイプラインを構築でき、データサイエンティストはPoCを短時間で構築できます。
ビジネスアナリストは、連携されたPower BIを使って数分でダッシュボードを構築できます。これにより、組織全体のデータ活用スピードが大幅に向上します。
ペタバイト規模のスケーラビリティ
Azure Synapse Analyticsは、ペタバイト単位のデータを高速に処理できるスケーラビリティを備えています。ストレージ層とコンピューティング層が独立して分離されているため、データ量が増えてもストレージを拡張しながら、分析の負荷に応じてコンピューティングだけを柔軟に増減できます。
独立したスケーリングの柔軟さは、季節変動やキャンペーン時期のように、アクセス負荷が一時的に急増するビジネスシナリオで特に効果を発揮します。また、使用しない時間帯はコンピューティングリソースを停止(一時停止)でき、コストを大幅に削減できるため、オンプレミスのデータウェアハウスに比べて運用コストを抑えられます。
専用SQLプールの性能はDWU(Data Warehouse Unit)という単位で管理され、ワークロードに応じてリアルタイムに調整できます。
Microsoftエコシステムとのシームレスな連携
Synapseは、Power BIやAzure Machine Learningをはじめ、Microsoftのサービスと連携して使えます。認証や監視、CI/CDといった運用の領域まで連携先に含まれます。
- Power BI:分析結果を、インタラクティブなダッシュボードとして即座に可視化。
- Azure Machine Learning:Synapseワークスペース内で、モデルのトレーニングからデプロイメントまでを一貫して実施。
- Azure Active Directory・Azure Monitor:認証・認可の管理と、監視。
- Azure DevOps:CI/CDパイプラインの構築。
- Microsoft 365・Dynamics 365:データをSynapseに取り込んで分析。
SaaSサービスとのデータ共有は数クリックで設定でき、実務上の大きな利点です。さらに、CRMデータや業務システムのデータを統合した高度なビジネスインテリジェンスを実現している企業も増えています。
Azure Synapse Analytics導入の進め方・手順
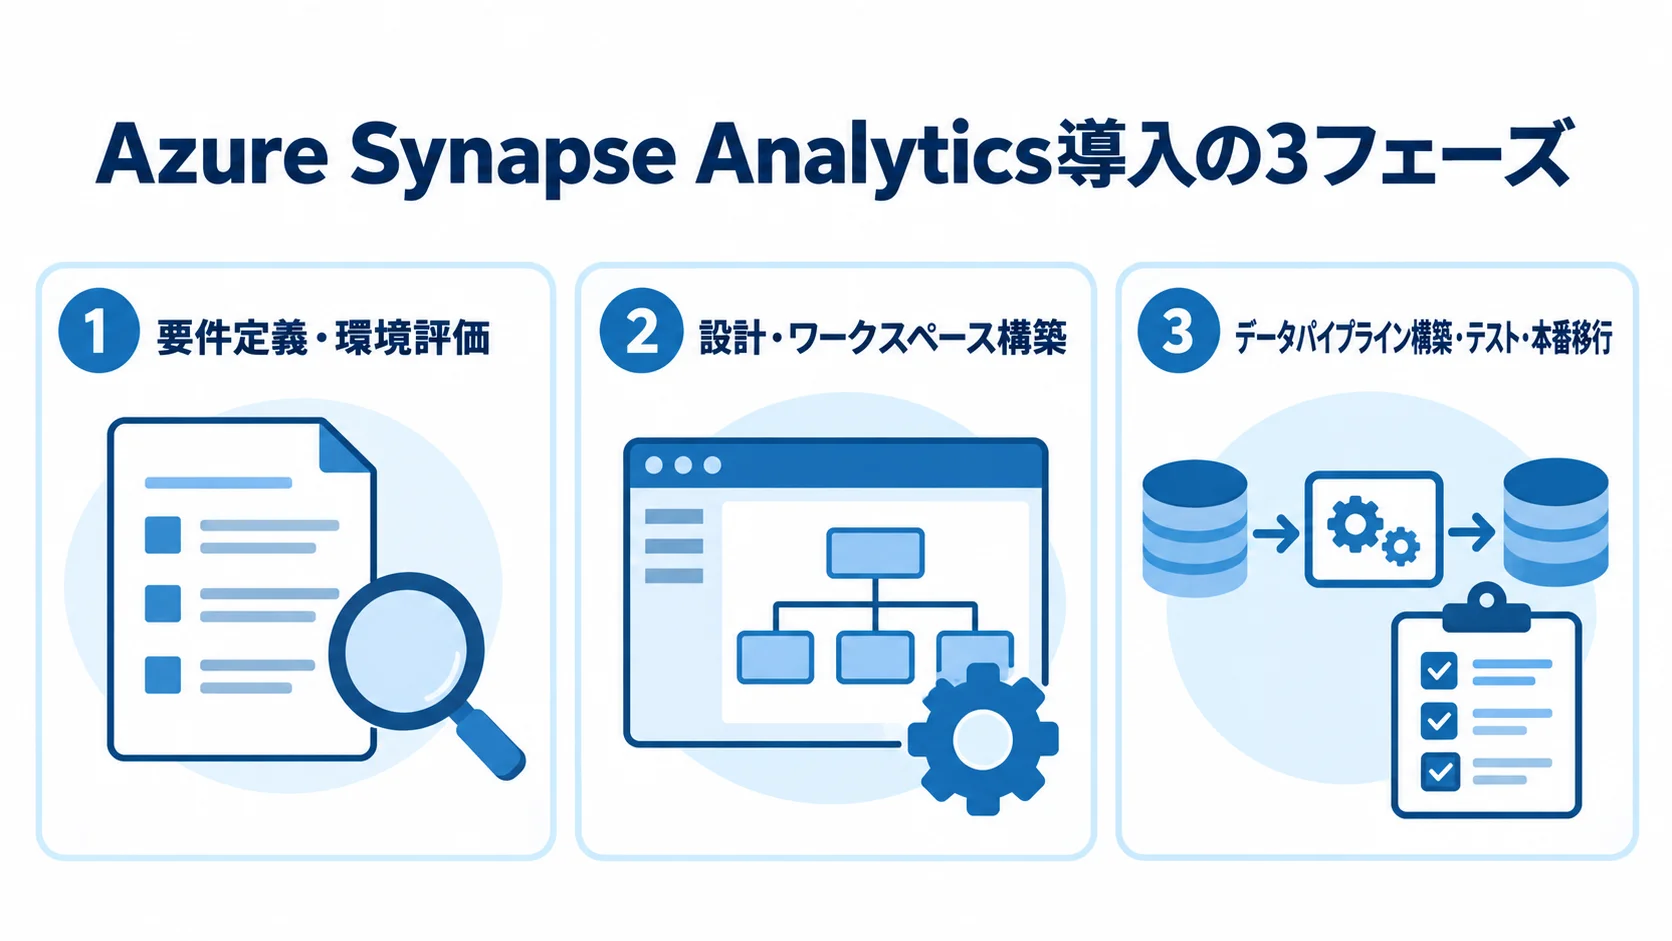
導入を成功させるには、計画的に進めることが欠かせません。そのため、環境の評価から設計、構築、テストまでを各フェーズで順に踏むことで、後戻りを減らした安定した導入が実現できます。詳しい進め方はAzure Synapse Analytics導入の進め方でも解説しています。
フェーズ1:要件定義・環境評価
導入プロジェクトの最初のステップは、現状の環境を評価して要件を明確にすることです。Microsoftが推奨する「設計による実装の成功」の手法でも、環境評価が最初の重要なステップとして位置づけられています。具体的には、保有しているデータの種類・量・形式と、データソースの多様性(オンプレミスDB・SaaS・IoTデバイスなど)を洗い出します。
あわせて、分析ユーザーのスキルセットと人数、セキュリティ・コンプライアンス要件、既存システムとの連携要件も整理します。要件が曖昧なまま構築を始めると、後工程での設計変更や手戻りが発生するため、この段階に十分な時間を割くことが欠かせません。
また、PoC(概念実証)フェーズを設けて小規模なパイロットを行い、技術的な実現可能性とパフォーマンスを事前に確認する方法も有効です。Azure Synapse Analyticsの無料トライアルやAzure無料アカウントを使えば、コストをかけずに試験的な検証を行えます。
フェーズ2:設計・ワークスペース構築
要件定義が完了したら、アーキテクチャ設計とワークスペースの構築に進みます。ワークスペースの作成は、Azure Portalで「Azure Synapse Analytics」を選び、「作成」をクリックするところから始まります。そのうえで、ワークスペースの設定を行います。
- ワークスペース名:名称を入力。
- リージョン:日本国内のデータを扱う場合は、Japan EastまたはJapan Westを推奨。
- ストレージアカウント:Azure Data Lake Storage Gen2を指定。
設計では、専用SQLプールとサーバーレスSQLプールのどちらを使うかが大きな判断になります。
- 専用SQLプール:大規模な定型クエリが多い場合に向いています。
- サーバーレスSQLプール:アドホックな分析や、コストを抑えることを優先する場合に適しています。
また、Apache Sparkプールのノードサイズとノード数は、処理するデータ量とパフォーマンス要件に基づいて設計します。ネットワーク設定では、マネージドプライベートエンドポイントを活用することで、インターネットを経由せずに安全なデータ転送を実現できます。
フェーズ3:データパイプライン構築・テスト・本番移行
ワークスペースの構築が完了したら、Synapse Pipelinesを使ってデータ取り込みのパイプラインを構築します。取り込み元は、Azure Blob StorageやAzure SQL Databaseのほか、オンプレミスのSQL ServerやSalesforceなど多様です。必要な変換処理を施してデータレイクやSQLプールに格納する流れを設計します。
Azure DevOpsと統合してパイプラインのバージョン管理とCI/CDを設定し、開発・テスト・本番の各環境を分けて管理します。次に、テストフェーズでは、データ品質の検証(欠損値・重複データ・型不整合のチェック)、パフォーマンステスト(クエリ応答時間・スループット)、セキュリティテスト(アクセス権限・データ暗号化の確認)を実施します。
本番移行の前に切り戻し手順を明確にしておくことで、問題が起きたときにも迅速に対応できます。また、移行後は、Azure Monitorを使い、リソース使用量・クエリパフォーマンス・コストを継続的に監視する体制を整えます。
Azure Synapse Analytics の費用・料金体系
Azure Synapse Analyticsの費用は、利用するコンポーネントと使用量に応じた従量課金が基本です。そのため、費用を見通すには各料金項目の仕組みを正しく理解しておくことが欠かせません。費用の詳細はAzure Synapse Analytics導入費用の詳細解説もご参照ください。
コンポーネント別の料金体系
Azure Synapse Analyticsの主な料金項目は4つあり、専用SQLプールとサーバーレスSQLプールのほか、Apache SparkプールとSynapse Pipelinesがあります。
- 専用SQLプール:パフォーマンス単位(DWU)×稼働時間で課金。最小構成(DW100c)の場合、1時間あたり約231円からかかります。
- サーバーレスSQLプール:クエリで分析したデータ量1TBあたり約765円という従量課金制が適用されます。
- Apache Sparkプール:使用した仮想コアの時間数に基づいて課金。Small(4 vCores)で1時間あたり約85円から利用できます。
- Synapse Pipelines:オーケストレーションアクティビティの実行回数やデータ移動量(DIU×時間)に応じて課金。
専用SQLプールでは、ストレージ層がコンピューティング層とは別に課金されるため、一時停止中はストレージ費用のみが発生します。
頻度の低いアドホック分析には、サーバーレスSQLプールがコスト効率の高い選択肢です。
Synapse Pipelinesは、たとえば2週間程度の試験運用では数千円程度に収まることも多く、常時稼働の場合でも月額1〜数万円から始められます。
コスト最適化のポイント
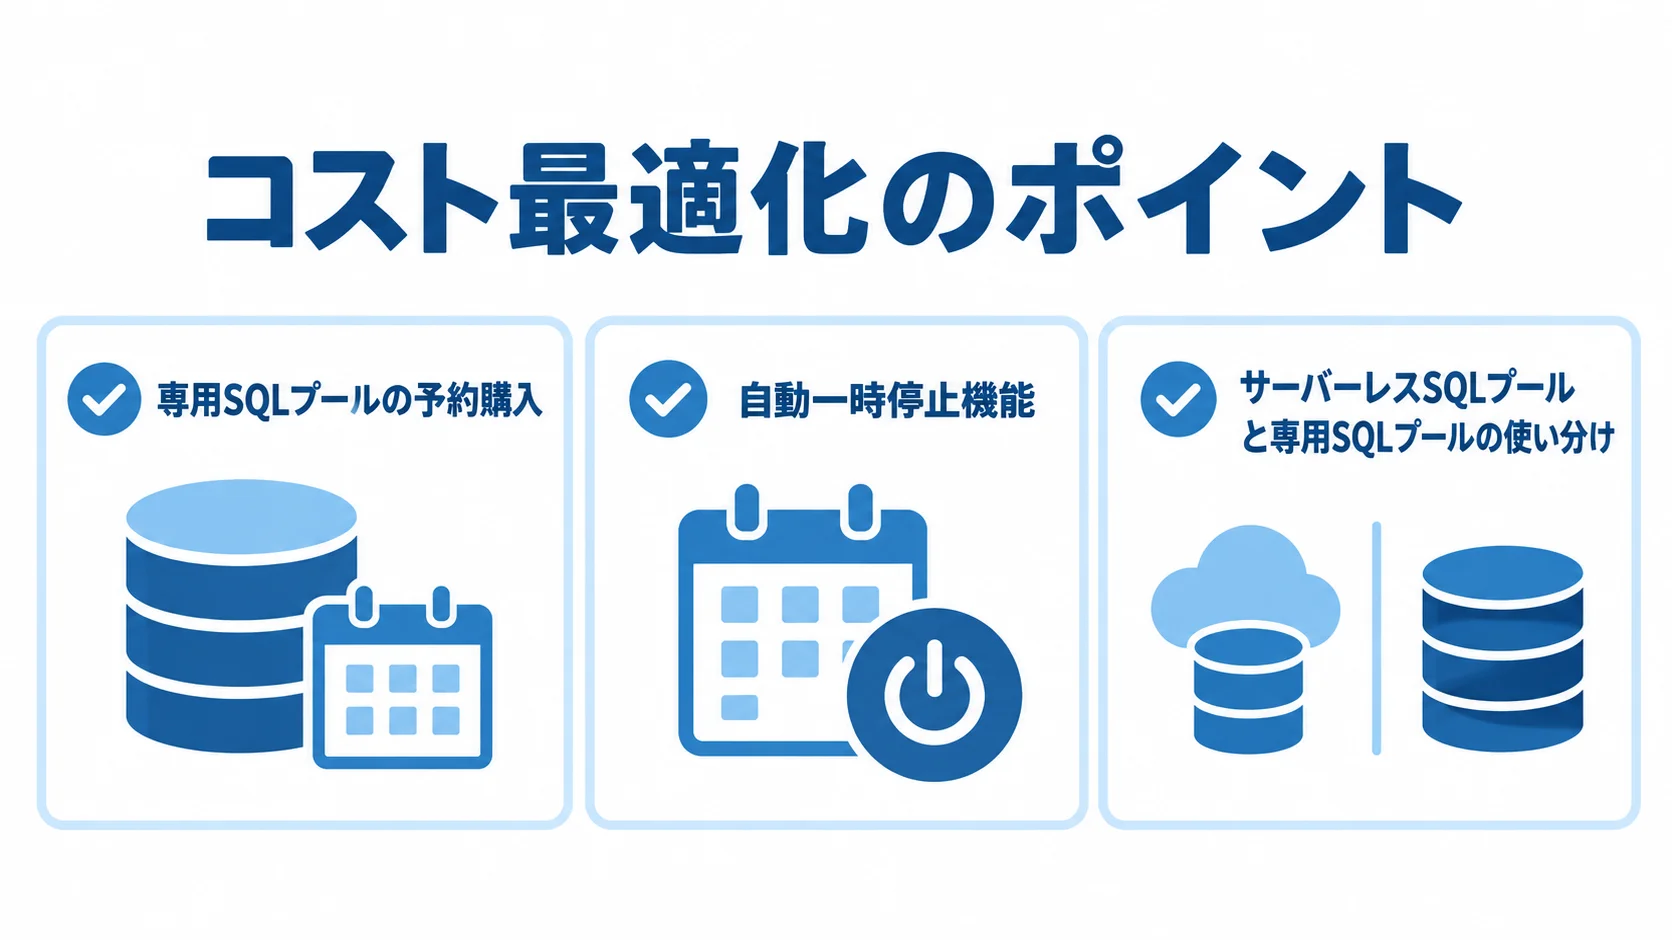
まず、専用SQLプールの予約購入が効果的です。従量課金制と比較して、1年予約で最大37%、3年予約で最大65%のコスト削減が実現できます。長期的に安定した利用が見込まれる場合は、積極的に予約購入を検討すべきです。
次に、専用SQLプールの自動一時停止機能を活用すると、業務時間外や週末など利用しない時間帯のコンピューティング費用をゼロにできます。たとえば平日9〜18時のみ稼働させれば、月の稼働時間を約195時間から約180時間に減らせ、コストを大幅に抑えられます。用途によってサーバーレスSQLプールと専用SQLプールを使い分けることも有効です。
定期的な大規模クエリには専用SQLプールを、臨時のデータ探索にはサーバーレスSQLプールを選ぶと、全体のコストを抑えられます。Azure Cost ManagementとBudgetアラートで月次のコスト上限を設け、超過時に通知を受け取る仕組みを整えることも重要です。さらに、Microsoftの「事前購入プラン」を使うと、Synapse Pipelinesのコストも予測可能な形で抑えられます。
Azure Synapse Analytics の活用事例
Azure Synapse Analyticsは、国内外のさまざまな業種・規模の企業で導入が進んでいます。実際の事例を見ると、自社での活用イメージを具体的に描きやすくなります。
出版業:株式会社集英社のデータ分析基盤構築
株式会社集英社は、紙媒体の出版に加えて、デジタルコンテンツや海外市場の売り上げデータのサイロ化が課題となっていました。そこで、各部門に分散した販売データを統合・管理・分析する基盤を、Azure Synapse AnalyticsとPower BIを活用して2021年4月から構築し、2022年4月に本格運用を開始しました。
現在では、コミック系の編集部や営業関連部署の担当者約500名が、Power BIで作成した定型レポートを通じて、作品ごとの販売データをリアルタイムで閲覧・出力できる環境を実現しています。
同プロジェクトでは、散在するデータをAzure Synapse Analyticsに集約し、手作業で集めていたデータを自動化しました。その結果、意思決定のスピードが大幅に向上した成功事例として評価されています。
製造・小売・金融など多業種での活用
Synapseによるデータ分析は、製造・小売・金融・ヘルスケアの各業種で活用されています。
- 製造業:生産ラインのデータをリアルタイムで分析し、設備の予知保全や品質管理の精度向上に活用。
- 小売業:販売・在庫・マーケティング施策のデータを統合分析し、需要予測の精度向上や商品配置に活用。
- 金融業:不正検知モデルの精度向上に活用。
- ヘルスケア:電子カルテデータや医療機器データを統合分析し、診療の質の向上や病院経営の効率化に活用。
製造業では、工場内の数万点にのぼるセンサーデータを、Azure IoT HubからSynapse Analyticsに取り込みます。そのうえで、Apache Sparkを使った機械学習モデルで異常検知を行い、設備停止によるロスを大幅に減らしている企業もあります。
金融業では、複数のシステムに分散していた取引データをSynapseに集約し、コンプライアンスレポートの作成を自動化している事例もあります。
Azure Synapse Analytics導入時の注意点と対策
Azure Synapse Analyticsは強力なプラットフォームですが、導入時にはいくつかの落とし穴があります。そのため、事前に注意点を把握しておけば、プロジェクトをスムーズに進めやすくなります。
コスト管理の複雑さ
Azure Synapse Analyticsは複数のコンポーネントが独立して課金されるため、適切に管理しないと想定外の費用が発生するおそれがあります。特に注意が必要なのは、専用SQLプールを使わない時間帯に一時停止の設定を忘れた場合です。DWU数×稼働時間で課金されるため、24時間365日稼働させると月額数十万円以上になることもあります。
データ転送量が多いパイプラインを頻繁に実行すると、Synapse Pipelinesのコストが積み上がります。その対策としては、Azure Cost ManagementでBudgetアラートを設定し、日次・月次でコストを監視する習慣をつけておくことが大切です。
本番環境に移行する前に、Azureの料金計算ツールで月次コストの試算を行い、想定コストを事前に把握しておくことが推奨されます。
専門知識・スキルセットの確保
Azure Synapse Analyticsを効果的に活用するには、SQLやPython・Scalaなどのプログラミングスキル、クラウドアーキテクチャの知識、データエンジニアリングの経験が必要です。特に、Apache Sparkを使った大規模データ処理やMLOps(機械学習の運用)に取り組む場合は、高度な専門知識が求められます。
社内にこれらのスキルを持つ人材が不足している場合は、外部の専門パートナーに支援を依頼することを検討すべきです。また、Microsoft Learnには充実した無料の学習コンテンツが提供されています。そのうえで、Azure Synapse Analytics関連の認定資格(DP-203: Azure上のデータエンジニアリングなど)の取得を社内エンジニアに奨励することも、人材育成の観点から有効です。
導入支援会社の選び方については、Azure Synapse Analytics導入会社比較をご参照ください。
セキュリティとガバナンスの設計
企業の重要なデータを扱うデータ基盤では、セキュリティ設計が最優先事項の一つです。Azure Synapse Analyticsには、多層防御の仕組みが備わっています。具体的には、Azure Active DirectoryによるRBAC(ロールベースアクセス制御)と、カラムレベル・行レベルのセキュリティ設定があります。
加えて、データの暗号化(保存時・転送時)と、マネージドプライベートエンドポイントによる閉域ネットワーク通信も提供されています。導入時には、最小権限の原則に基づいてユーザーごとのアクセス権限を細かく設定することが欠かせません。特に、個人情報や機密データを扱う場合は、動的データマスキング機能を活用してデータへのアクセスを制御することを推奨します。
また、Azure Policyを使ってガバナンスルールを自動的に強制する仕組みを設けることで、設定ミスによるセキュリティインシデントのリスクを低減できます。コンプライアンス要件(GDPR・個人情報保護法など)への対応も、導入設計の段階から考えておくことが大切です。
Azure Synapse Analytics導入を外注・発注するポイント
Azure Synapse Analyticsの導入を外部パートナーに委託する場合は、適切なパートナーを選べるかどうかで成果が大きく変わります。外注・発注の具体的な進め方は、Azure Synapse Analytics導入の発注方法で詳しく解説しています。
パートナー選定の基準と確認事項
導入支援パートナーを選ぶ際は、まずMicrosoftのパートナー認定(Microsoft Certified Partner)の有無を確認することが基本です。「Azure Expert MSP」や「Data & AI」領域の専門認定を持つパートナーは、Azure Synapse Analyticsに関する深い技術力と実績が証明されています。
次に、類似業種・類似規模での導入実績を確認します。製造業のデータ分析基盤構築と金融業の実績では、求められるノウハウが異なります。そのため、自社の業種・規模に近い事例を持つパートナーを優先することが賢明です。
また、コンサルティングから設計・構築・運用保守まで一気通貫で対応してもらえるか、それとも構築までで、その後は自社で管理することになるかも、重要な確認事項です。導入後の運用・保守サポートの体制(SLA・サポート時間・担当者の継続性)も、長期的な観点から必ず確認してください。
見積もり・提案依頼書(RFP)作成のポイント
パートナーへの発注を進める際は、精度の高い提案と見積もりを得るために、RFP(提案依頼書)の質を高めることが大切です。RFPには、プロジェクトの目的とゴール(ビジネス課題と解決したい内容)、現状のデータ環境(データソースの種類・量・形式)、スケジュールと予算の目安を記載します。
加えて、セキュリティ・コンプライアンス要件や、求めるサービス範囲(コンサルのみか、設計のみか、構築・運用保守までか)も盛り込みます。そのうえで、RFPを複数のパートナーに提示して相見積もりを取ると、価格と提案内容を比べられます。
提案を評価するときは、価格の安さだけでなく、アーキテクチャの妥当性やチームのスキル・経験も確認することが大切です。あわせて、コミュニケーション方針やリスクマネジメントの考え方も、評価の対象にします。外注先の選び方について詳しく知りたい方は、Azure Synapse Analytics導入会社の比較記事もご覧ください。
まとめ:Azure Synapse Analytics導入の成功に必要な要点
Azure Synapse Analyticsは、データウェアハウスとビッグデータ分析を統合した強力なプラットフォームです。ペタバイト規模の処理能力、Microsoftエコシステムとのシームレスな連携、柔軟なコスト体系など、多くのメリットを備えています。
集英社の事例のように、正しく導入することで、約500名の業務ユーザーが日常的にデータを活用できる環境を作り、組織全体のデータドリブン経営を加速させられます。導入を成功させるには、要件定義での徹底的な環境評価、コンポーネントの適切な選択と設計、コスト管理の仕組み化を押さえることが大切です。
加えて、セキュリティ・ガバナンス設計を先に進めておくことと、適切なパートナーを選ぶことも欠かせません。導入の進め方・費用・発注方法について、より詳しく知りたい方は、関連する子記事(進め方・費用・会社比較・発注方法)もあわせてご参照ください。
Azure Synapse Analyticsの導入に関して不明な点やご相談がある場合は、ぜひriplaへお問い合わせください。また、コンサルティングから設計・構築・運用保守まで一気通貫でご支援いたします。
導入準備に役立つ資料も確認できます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。