
Google BigQueryの導入は、要件定義・企画、設計・開発、テスト・リリースの3段階で進みます。データソースが3〜5件で、BIツール連携を含む中規模の場合は、全体で3〜6ヶ月を見込むのが目安です。
導入の全体像は、以下の記事にまとめています。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Google BigQueryの全体像
Google BigQueryは、Google Cloudが提供するサーバーレス型のデータウェアハウス(DWH)です。従来のオンプレミス型DWHと違い、サーバーの調達や管理が要りません。使った分だけ課金されるため、初期投資を抑えながら大規模なデータ分析基盤を構築できます。
企業がBigQueryを導入する前に、まず特性とユースケースを正しく理解しておくことが、スムーズな導入の第一歩となります。
BigQueryの主な特徴とできること
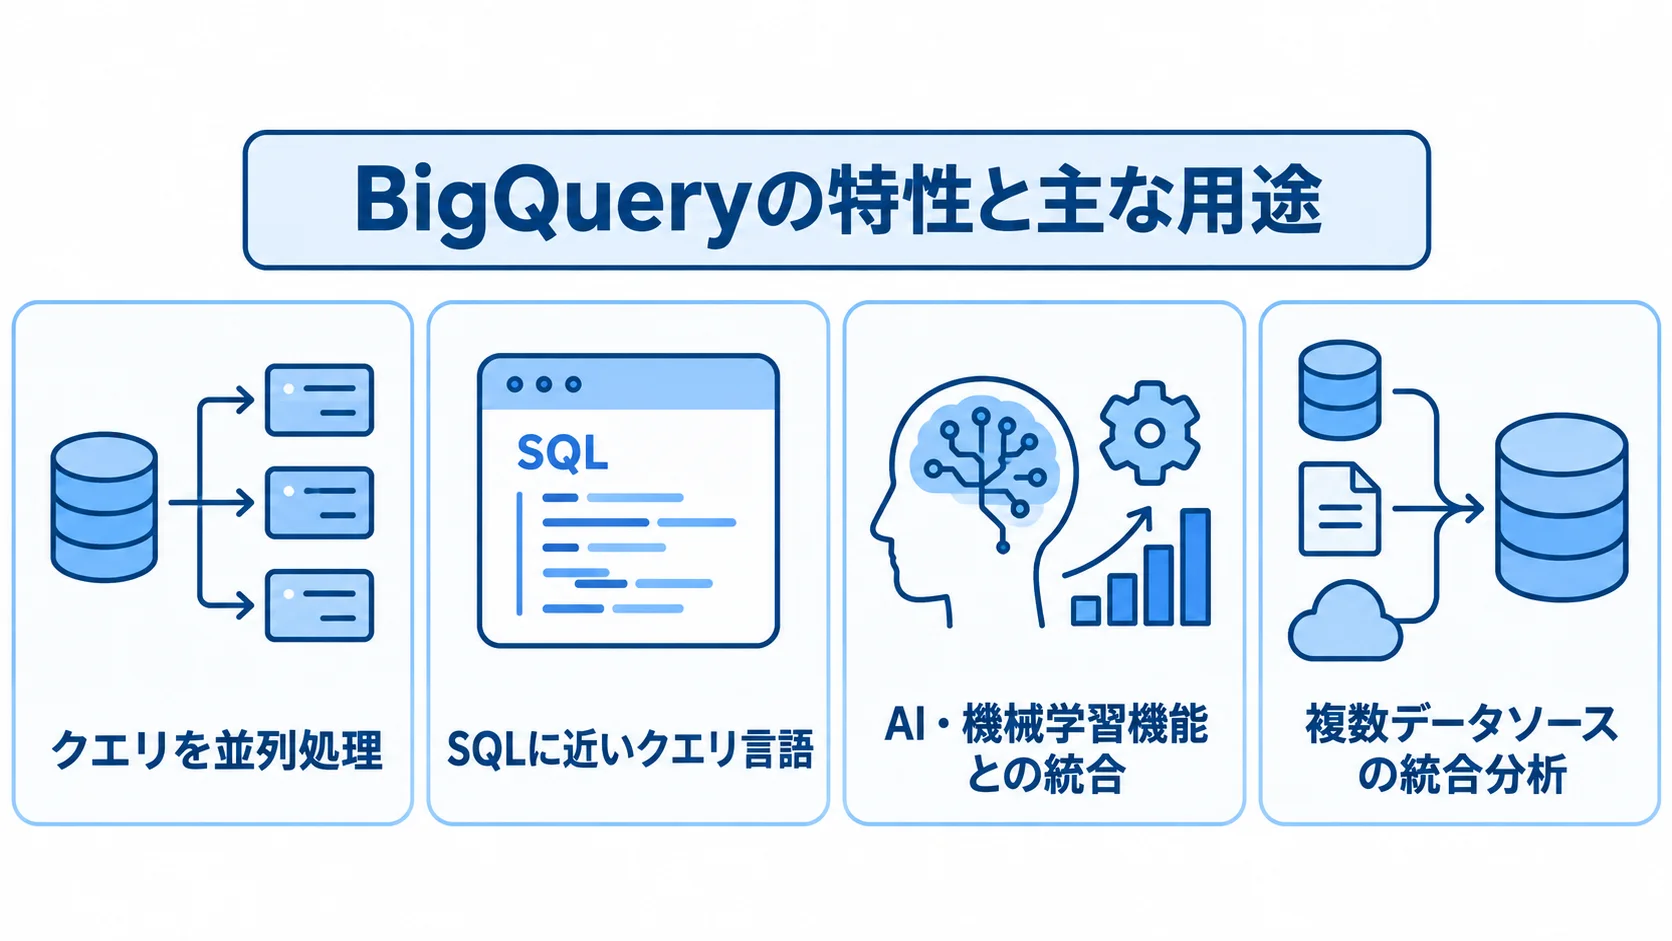
BigQueryの最大の特長は処理速度です。Googleの大規模なインフラ上で数千台規模のサーバーがクエリを並列処理するため、テラバイト・ペタバイト規模のデータでも数秒から数分で分析結果を得られます。たとえば、従来のRDBMSで数時間かかっていた集計処理が、BigQueryでは数十秒で完了するケースも珍しくありません。
SQLに近いクエリ言語を使うため、SQLを扱えるエンジニアや分析担当者なら、スムーズに利用を始められます。これは大きなメリットです。
GeminiをはじめとするAI・機械学習機能との統合も進んでおり、予測モデルの構築や自然言語による分析クエリの生成も実現できます。マーケティング分析、顧客行動分析、製造ラインのIoTデータ分析など、業種や部門を問わず幅広く使える点が、多くの企業に選ばれる理由となっています。
BigQueryが適しているケースと注意点
BigQueryは、「大量データの一括分析」「複数データソースの統合分析」「BI・AIとの連携」を必要とする企業に適しています。たとえば、ECサイトの購買履歴、アクセスログ、広告データを一元的に統合し、顧客セグメントごとの行動分析を行うような場合には、BigQueryの性能が最大限に発揮されます。
一方、数件から数千件程度の少量データに対する単純なCRUD操作や、トランザクション処理には向いていません。BigQueryはスケールしやすい反面、設計を誤るとクエリのコストが予想外に膨らむリスクがあります。
特に、「将来使うかもしれないデータ」を過剰に取り込んだり、最適化されていないクエリを実行し続けたりすると、月々のコストが急増する可能性があります。こうした事態を防ぐには、導入前に「何のためにBigQueryを使うのか」という目的を明確にし、最小構成から始めることが大切です。
Google BigQuery導入の進め方
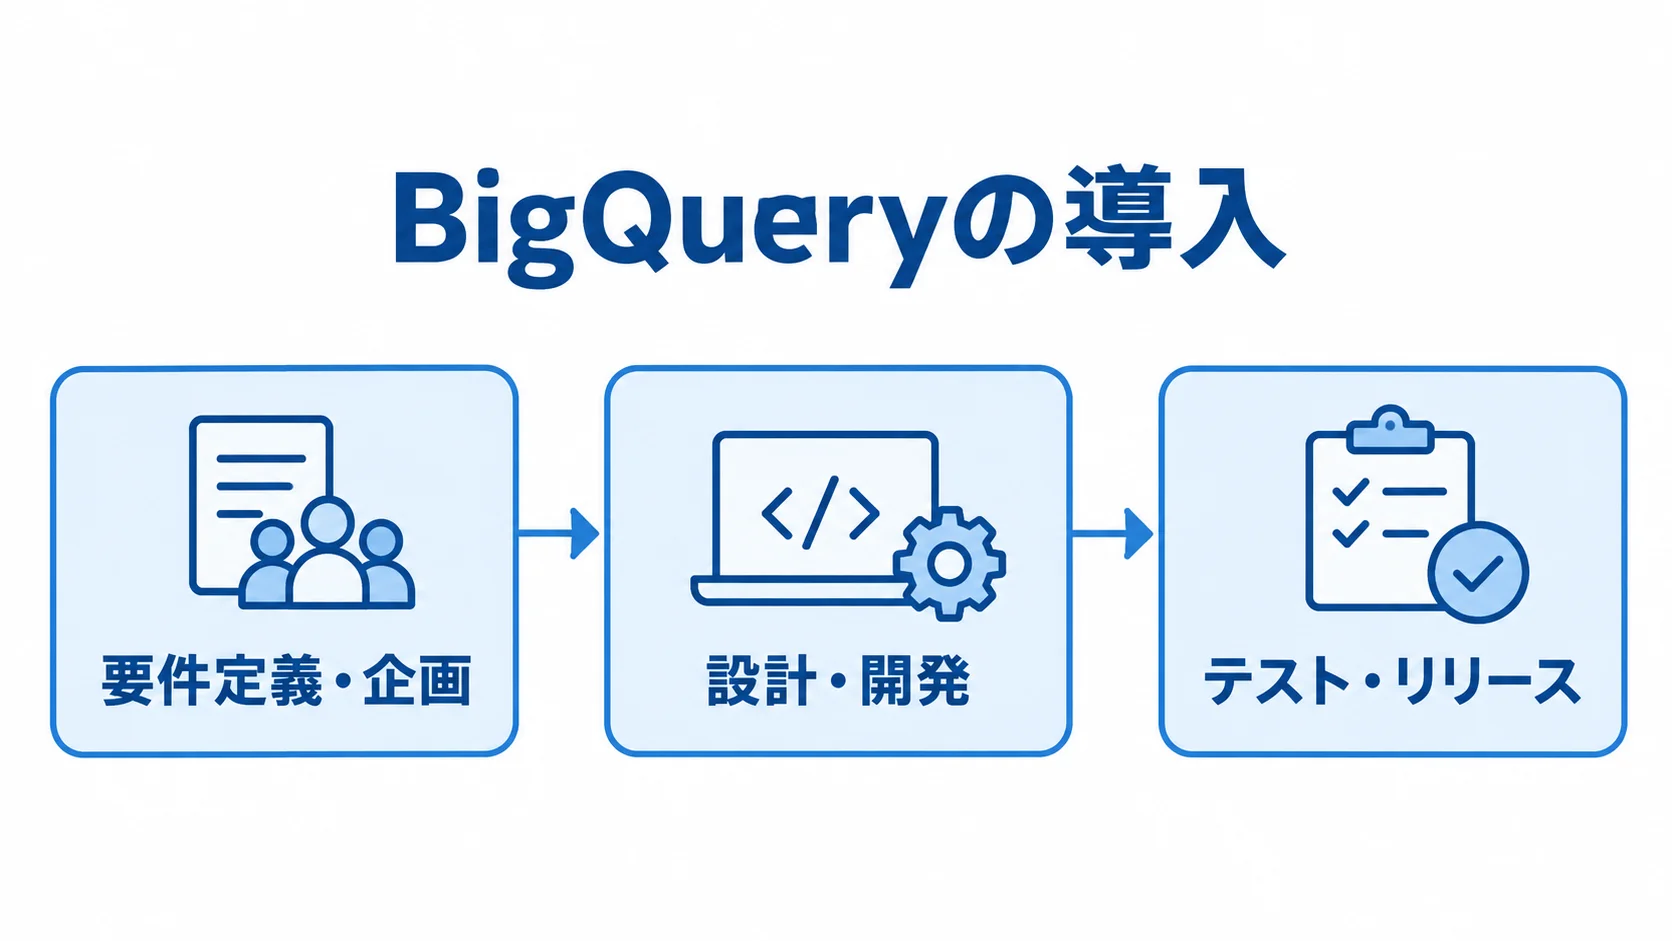
Google BigQueryの導入は、目的と要件を固めてから基盤を構築し、検証を経て運用に移す流れです。各段階で決めることを分けておくと、作業の範囲と次の工程が明確になります。
- 要件定義・企画:導入目的、データソース、利用者と必要な権限の決定。
- 設計・開発:データ基盤の構成と、データ連携の仕組みの設計・構築。
- テスト・リリース:データ品質と処理の検証、監視や利用者向け準備を経た運用開始。
要件定義・企画フェーズ
導入プロジェクトの成否は、要件定義の質で大きく左右されます。要件が曖昧なまま設計・開発に進むと、後から大幅な仕様変更が発生し、コストと工数が膨らむリスクがあるため、このフェーズにしっかり時間をかけることが大切です。
このフェーズでは、まず「なぜBigQueryを導入するのか」という目的と、「導入によって何を実現したいのか」というゴールを明確にします。そのうえで、分析に時間がかかりすぎる、データがバラバラで統合できていないといった現状の課題を洗い出し、導入後の理想の状態を定めます。このフェーズは通常2〜4週間を要します。
次に、どのデータソースを連携するかを決めます。基幹システム(ERP・CRMなど)、Google Analytics 4(GA4)、広告プラットフォーム、IoTセンサーデータなど、連携候補を挙げて優先順位をつけます。また、誰がBigQueryを使うのか(データエンジニア、データアナリスト、ビジネス部門のメンバーなど)を明らかにし、必要な権限の設計方針も検討します。
設計・開発フェーズ
設計フェーズでは、BigQueryを中心としたデータ基盤全体のアーキテクチャを描きます。その土台となるデータレイヤは、一般的に「RAWレイヤ(生データ)」「DWHレイヤ(整形・統合データ)」「データマートレイヤ(分析用集計データ)」の3層構造を採用します。その3層を前提に、データモデリングや非正規化テーブルの活用、データパイプラインの方針を固めます。
- データレイヤの構成:3層それぞれの役割と管理方針。
- データモデリング:各データソースのスキーマの整理と、テーブル構造の決定。
- 非正規化テーブル:JOIN処理を多用するとコストが増えるBigQueryの特性を踏まえた活用の検討。
- データパイプライン:各データソースからBigQueryへデータを転送する仕組みの設計と構築。
Google Cloudのネイティブサービス(Cloud Storage、Dataflow、Pub/Subなど)や外部ETLツール(Fivetran、troccoなど)を組み合わせて使います。その組み合わせで、収集・変換・ロードの一連の流れを実装します。
BIツール(Looker Studio、Tableauなど)との接続方式も、設計段階で決めておくと後工程がスムーズに進みます。開発フェーズでは、設計に基づいてBigQueryプロジェクトの環境を構築し、データパイプラインの実装とテーブル作成を進めます。このフェーズには通常1〜3ヶ月程度かかります。
テスト・リリースフェーズ
テストフェーズでは、データパイプラインの動作確認とデータ品質の検証を行います。主なチェック項目は、データの正確性(ソースシステムとBigQueryのデータ件数・数値の突合)、データパイプラインの安定性(定期実行の遅延・エラー発生状況)、クエリのパフォーマンス(実行時間・処理コスト)などです。
特に本番データを使ったパフォーマンステストは欠かせません。テスト環境では問題がなくても、本番の大規模データで予期せぬコスト増や速度低下が起こるケースがあるためです。テストが完了したら、リリースに向けて、監視・アラートの設定(データパイプラインのエラー検知、コスト異常の通知など)、ユーザーへの操作トレーニング、運用マニュアルの整備も必要です。
段階的リリース(まず一部のデータソースや一部のユーザーに限定して開始する方式)を採用すると、リスクを最小限に抑えながら本番稼働に移行できます。リリース後も、継続的なモニタリングと改善を繰り返して、データ基盤の品質と活用度を高めていくことが大切です。
費用相場とコストの内訳
BigQuery導入の費用は、「初期導入費用(開発・構築費)」と「ランニングコスト(BigQueryの利用料金)」の2種類に大きく分けられます。
初期費用は導入の規模や複雑さによって異なりますが、中規模プロジェクトの目安として100万〜500万円程度が一般的です。ランニングコストは、データ量とクエリ頻度によって変動します。
人件費と工数
BigQuery導入プロジェクトにかかる費用の大半は人件費です。外部のシステム開発会社やコンサルティング会社に依頼する場合は、エンジニアやコンサルタントの工数に応じて費用が発生します。
一般的な単価の相場は、データエンジニア(パイプライン設計・開発)が月80〜150万円程度、データアーキテクト(全体設計・アドバイザー)が月100〜200万円程度、プロジェクトマネージャーが月80〜120万円程度です。小規模なPoC(概念実証)であれば、2〜3名のエンジニアが1〜2ヶ月稼働する程度で、総費用200万〜500万円程度で済む場合もあります。
一方、基幹システムとの連携や複数のデータソースを扱う本格的な導入では、5〜10名以上のチームが3〜6ヶ月稼働し、総費用が1,000万〜3,000万円以上になるケースもあります。内製で対応すれば外注費はかかりませんが、社内エンジニアの学習コストや工数がかかる点に加え、専門的なノウハウ不足による設計品質低下のリスクも考慮する必要があります。
初期費用以外のランニングコスト
BigQueryのランニングコストは「ストレージ料金」と「クエリ料金(分析料金)」の2つで構成されています。ストレージ料金は保存するデータ量に応じて課金され、アクティブストレージ(直近90日以内に更新があったデータ)は月$0.02/GB程度、長期保存ストレージ(90日以上更新がないデータ)は月$0.01/GB程度です。
たとえば、データ量が10TBであれば月200ドル程度(ストレージのみ)となります。クエリ料金は、オンデマンド課金の場合、クエリで処理したデータ量に対して$6.25/TBで課金されます(毎月最初の1TiBは無料)。大量のクエリを実行する場合は、BigQuery Editionsという新しい料金体系でスロット(処理能力)を予約購入すると、コストを抑えられるケースがあります。
その他、データをBigQueryへ転送するためのCloud Storageや各種データ転送サービス(Dataflowなど)の費用、BIツールのライセンス費用も発生します。これらを合算すると、中規模の活用では月5万〜30万円程度のランニングコストが一般的です。
見積もりを取る際のポイント
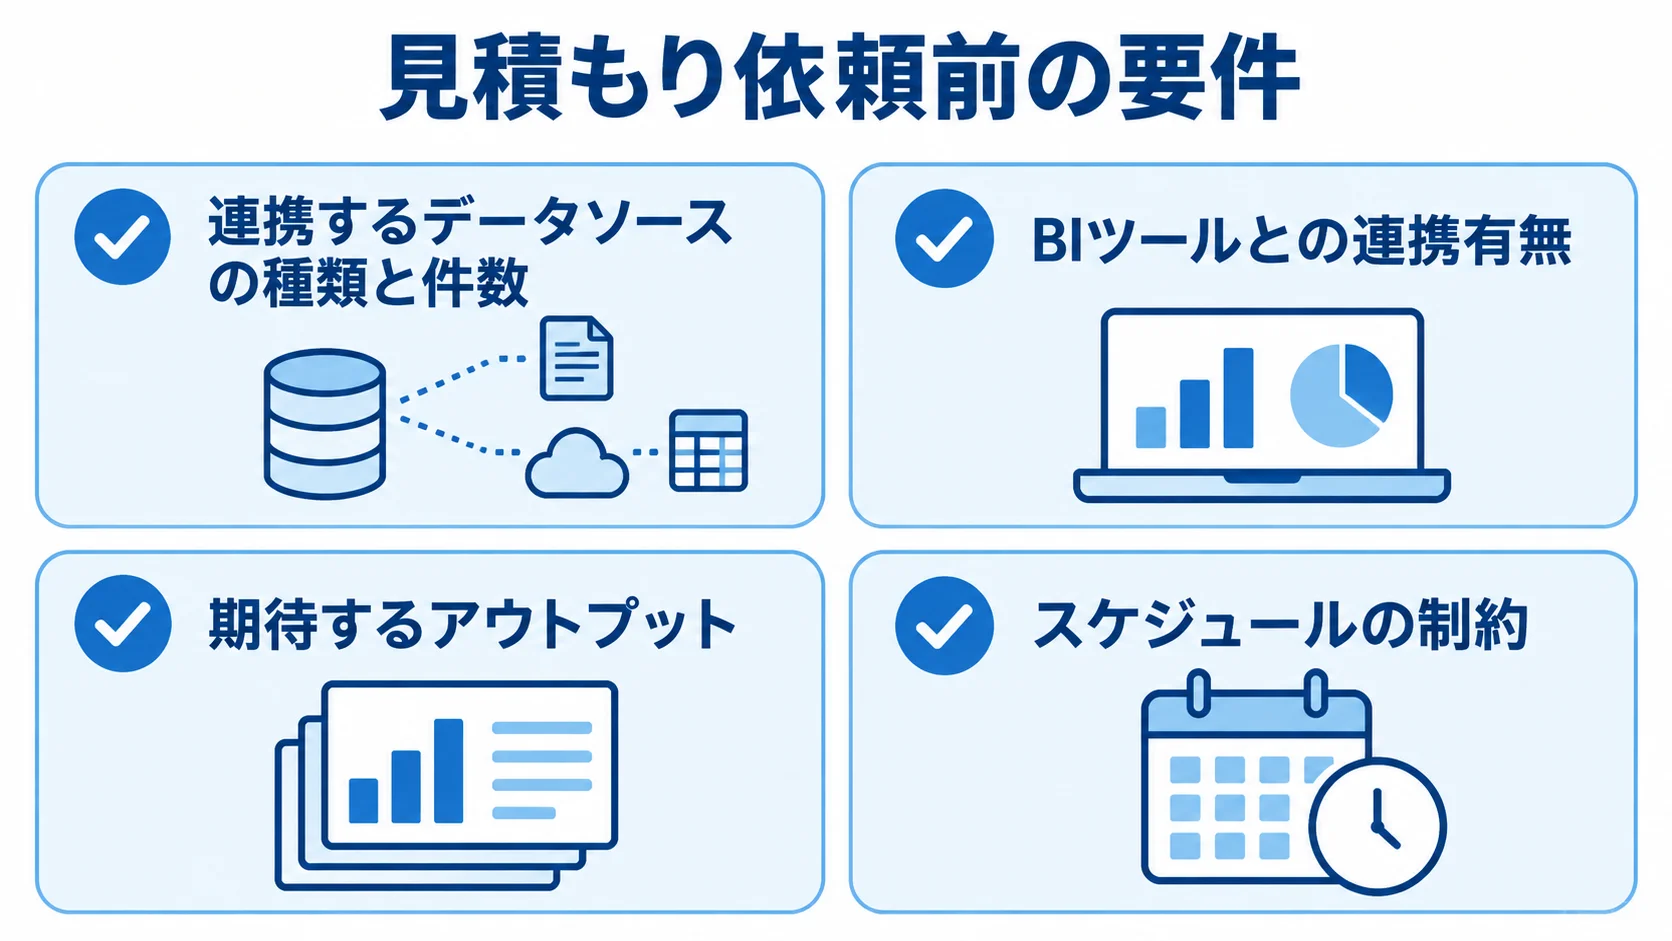
外部会社に見積もりを依頼する際は、事前の準備と比較検討が欠かせません。適切な見積もりを得るには、まず自社の要件を整理し、連携するデータソースの種類、データ量、更新頻度などを明確にしてから依頼します。
さらに、複数社から見積もりを取って比較すると、適正価格を把握できるだけでなく、各社の提案内容からプロジェクトへの理解度や技術力を判断する材料も得られます。
要件明確化と仕様書の準備
見積もり精度を高めるには、依頼前に要件をできる限り詳しくまとめることが大切です。具体的には、「何のためにBigQueryを導入するか」という目的とゴール、連携するデータソースの一覧(システム名・データ形式・件数・更新頻度)、利用するユーザー数と役割を整理します。
さらに、希望する完成形のイメージ(例:Looker StudioでのKPIダッシュボード作成など)、スケジュールの制約(いつまでに稼働させたいか)、予算感の上限(ある程度でも共有する)も加えます。これらをRFP(提案依頼書)にまとめると、複数社から質の高い提案や見積もりを集めやすくなります。
要件が曖昧なまま依頼すると、会社ごとに見積もりの範囲が違って比較が難しくなるうえ、契約後に追加費用が発生するリスクもあります。最低限、「連携するデータソースの種類と件数」「BIツールとの連携有無」「期待するアウトプット(ダッシュボードの内容)」の3点を整理するだけでも、見積もり依頼の質が大幅に上がります。
複数社比較と発注先の選び方
BigQuery導入の発注先を選ぶ際は、価格だけでなく複数の観点から比較することが大切です。まず確認したいのは「BigQueryの導入実績」です。同様の規模・業種での導入事例があるか、具体的な成果事例を提示できるかを確認します。
Google Cloudのパートナープログラムにおけるパートナーランクや、Google Cloudの認定資格保有者数も、技術力を判断する目安になります。次に、「サポート体制」も大切な観点です。導入後の運用・保守まで対応してくれるか、問題発生時の対応スピード、継続的な改善提案をしてくれるかなどを確認します。
また、「コンサルティング能力」も見ておきたい観点です。言われたとおりに構築するだけでなく、自社の課題を理解して最適な設計を提案してくれるかを見極めます。見積もり比較では、「何が含まれ、何が含まれないか」を明確にし、同じ条件で比べることが欠かせません。なお、見積もりが著しく安い場合は、後から追加費用が発生するリスクがあるため注意が必要です。
注意すべきリスクと対策
BigQuery導入プロジェクトで起こりやすいリスクと対策を理解しておくと、失敗を未然に防げます。最もよくあるリスクは「コストの想定外の増大」で、設計が最適化されていないままクエリを実行し続けると、予想を大幅に超えるコストが発生することがあります。
対策としては、Google Cloudのコスト管理機能(予算アラートの設定、クエリコストのモニタリング)を活用し、定期的にコストを確認・最適化する運用を確立することが大切です。また、「データ品質の問題」も頻発するリスクです。ソースシステムのデータが汚染されている(重複・欠損・誤入力など)と、BigQuery上の分析結果も不正確になります。
データパイプラインにデータ品質チェックの工程を組み込み、異常値を検知する仕組みを設けることが対策になります。さらに「社内定着しない」というリスクも深刻で、せっかく構築したデータ基盤が活用されないまま放置されるケースは珍しくありません。導入当初から現場を巻き込み、定期的な勉強会やユースケースの横展開で、組織全体にデータ活用の文化を育てることが成功の鍵です。
まとめ
BigQueryは大規模データを高速・低コストで分析できる強力なプラットフォームですが、導入を成功させるには、明確な目的の設定と段階的な進め方が欠かせません。
最初から完璧な基盤を目指す必要はありません。まず小規模なPoCから始め、成果を確かめながら対象範囲を広げていくことをお勧めします。
さらに、Google Cloudに精通した信頼できるパートナーを選ぶことも、プロジェクトの成否を大きく左右します。本記事では、全体像の把握から要件定義・設計・開発・テスト・リリースまでの各フェーズ、費用相場、見積もりのポイントまで解説しました。自社に合う導入計画を立てる際の参考になります。
BigQuery導入の相談先としては、専門的な知見を持つ開発会社への問い合わせも検討してください。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
開発を相談する前に、次のホワイトペーパーもご活用ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。