
データ分析・活用は、目的を決め、データを集めて整え、分析し、その結果を業務に反映するという順で進めます。この順で進めると、分析結果が意思決定や業務改善につながります。
▼全体ガイドの記事
・データ分析/活用の完全ガイド
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データ分析・活用の定義と重要性
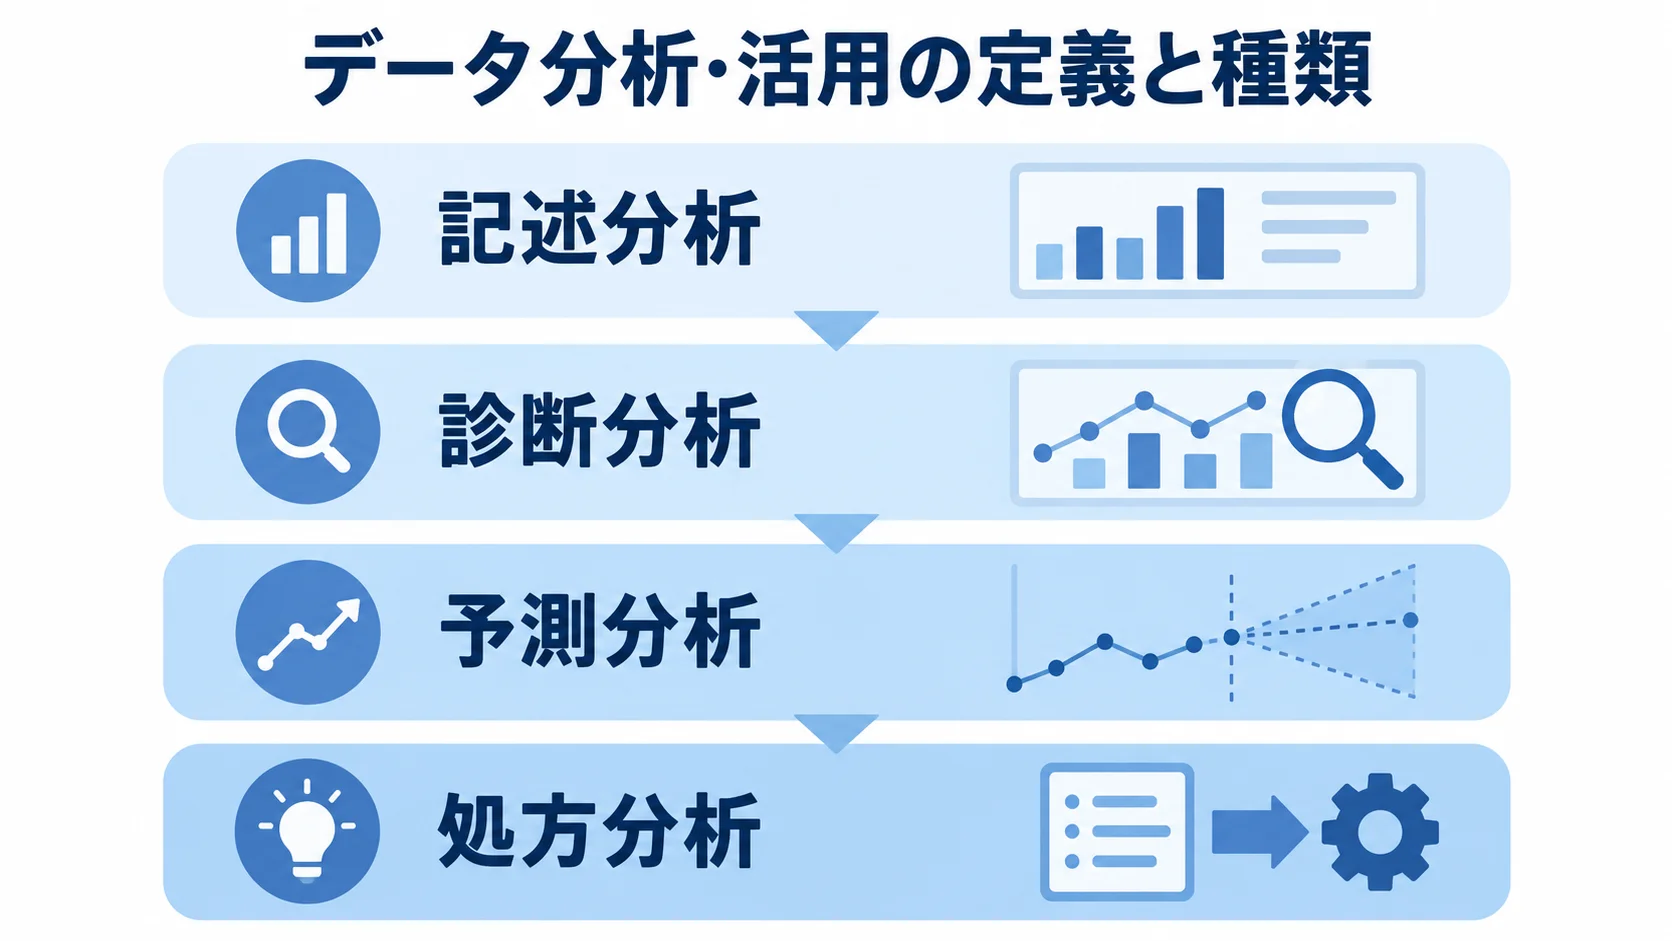
データ分析・活用とは、企業のデータを収集・整理・分析し、意思決定や業務改善に役立てる取り組みです。対象には、売上、顧客、行動ログ、市場のデータがあります。
これらを統合して分析し、4つの視点から示唆を引き出すことが、データ活用の本質です。4つの視点とは、何が起きているか、なぜ起きているか、これから何が起きるか、どうすればよいかです。
データ分析・活用の定義と種類
分析手法は、知りたいことに合わせて選びます。過去の状況の把握から次の行動の提案まで、主な種類は次の4つです。
- 記述分析(Descriptive Analytics):現状を把握するために、月別売上推移、顧客属性の分布、商品別利益率を集計し、BIで日常的に追います。
- 診断分析(Diagnostic Analytics):起きた現象の原因を掘り下げる分析。
- 予測分析(Predictive Analytics):過去のパターンを機械学習モデルで学び、需要、チャーンリスク、不正を予測します。
- 処方分析(Prescriptive Analytics):予測をもとに、価格設定、在庫補充量、マーケティング施策を推奨します。
たとえば診断分析では、売上が前月比で落ちたときに、どのセグメント、商品、チャネルが影響したかをドリルダウンで調べます。
近年は、生成AIによる自然言語での分析や、AutoMLによる予測モデル構築の自動化が普及しています。これにより、分析を専門家以外も担う動きが進んでいます。
どの分析から取り組むかは、ビジネス課題と優先度を見て決めます。
データ分析・活用が重要な理由
ビジネス環境の変化が速まるなか、データ分析・活用の効果は、判断の速さや根拠から、AI活用、業務の価値、経営戦略にまで及びます。
- 判断の速さ:市場・顧客・競合の変化をリアルタイムで捉えるデータドリブン経営が、競争優位性につながります。
- 判断の根拠:経験だけの判断は機会損失や無駄を生み、市場規模が大きく競争も激しい業種では不利になります。
- AI活用:質の高いデータ整備が成否を左右し、未整備の企業との差は広がると予想されます。
- 業務価値:顧客体験の個別化や在庫の適正化に使えるほか、不正検知や製造ラインの予知保全にも活用できます。
- 経営戦略:データ分析への投資をIT投資にとどめず、経営の中核に位置づけます。
データ分析・活用の進め方:各フェーズの詳細
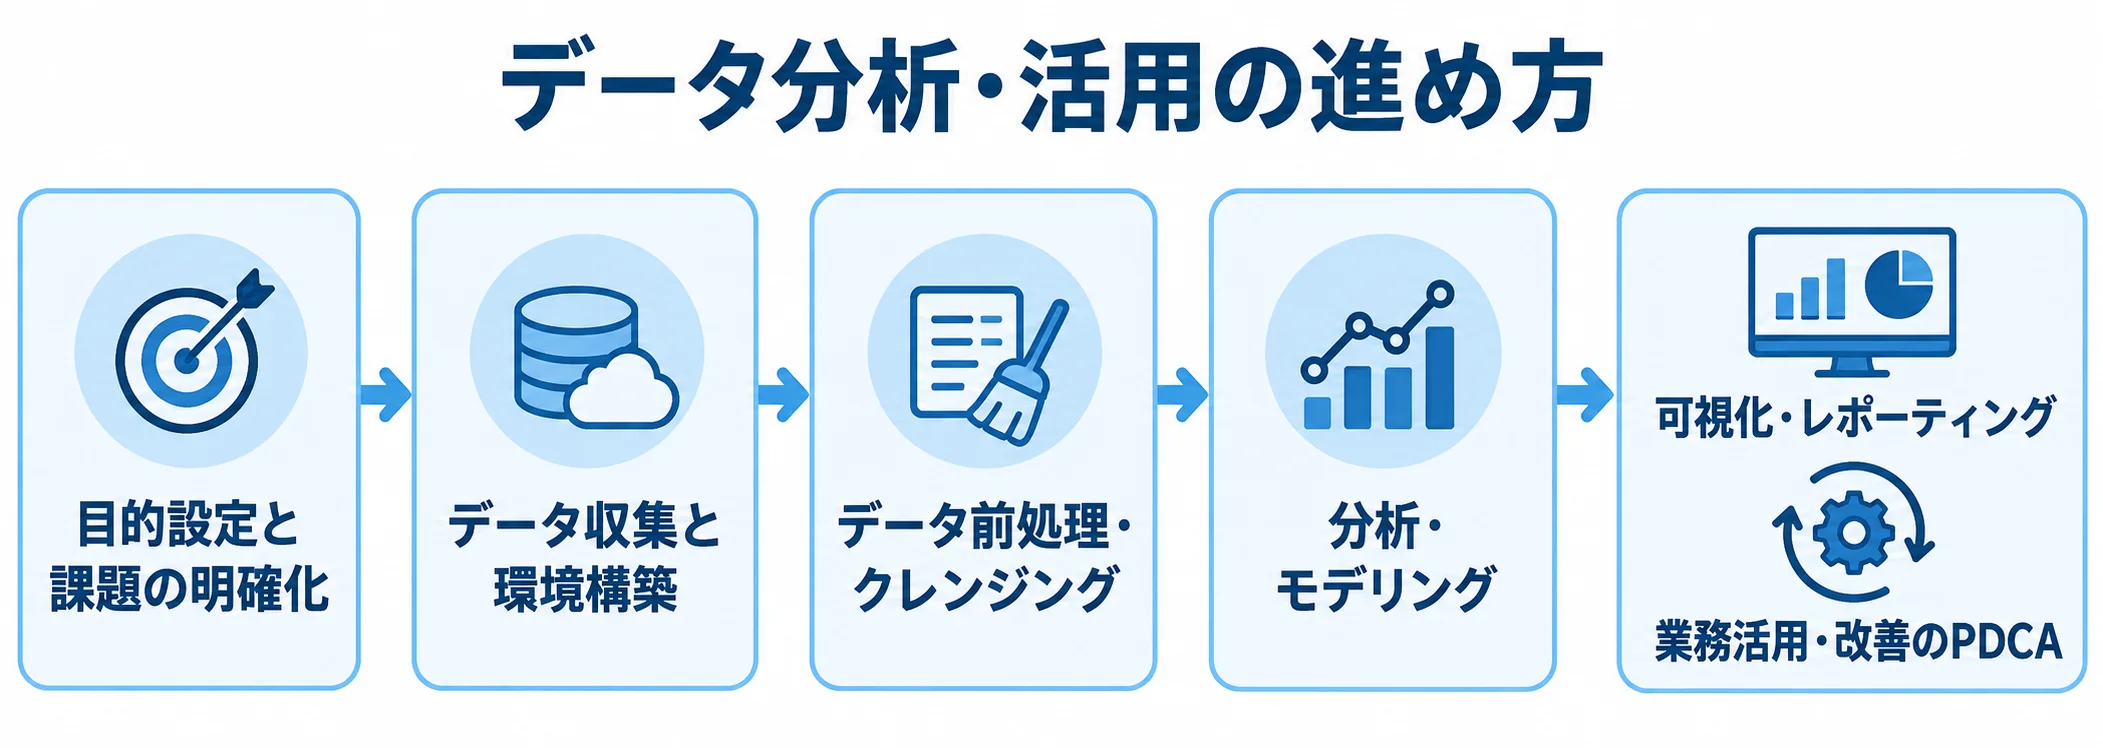
基本の流れは6つのフェーズです。まず目的設定を行い、データ収集と環境構築を進めます。次に前処理・クレンジングを経て、分析・モデリングへ進みます。その後、可視化・レポーティングを行い、業務活用・改善のPDCAへ進みます。順を追って進めると、分析の精度と業務への貢献度を高められます。
フェーズ1:目的設定と課題の明確化
目的が曖昧なままデータを集めることは、プロジェクトが失敗する主な原因の一つです。そこで、分析の対象と判断の基準を最初に決めておきます。
- 課題:分析で解決したいビジネス課題を決めます。
- 意思決定:分析結果を活かす判断の内容。
- KPI:成功を測る具体的な基準。
目標の例は、顧客解約率を半年で5%削減すること、在庫欠品率を10%改善すること、マーケティング費用対効果を20%向上させることです。ワークショップでは、ビジネス部門の課題オーナーとデータ部門の分析担当者が、優先順位と分析範囲に合意します。
そのうえで、分析に使うデータが実際にあるか、分析に必要な期間とコストはどの程度かを、早い段階で確認しておきます。そうすれば、後工程での範囲変更を抑えられます。
大規模に始めるよりも、小さなPoC(概念実証)で成果を示してから段階的に広げるほうが、合意と継続的な支援を得やすい傾向があります。
フェーズ2:データ収集と環境構築
目的が定まったら、必要なデータを集め、分析の環境を整えます。データの取得元と品質は、早期に確認しておきます。
- 社内データ:ERP、CRM、SFA、ECサイトなどから抽出します。
- 外部データ:市場調査、気象データ、SNSデータなどを集めます。
- 個別データ:IoTセンサーや実験から得たデータです。
まずサンプルを取り出し、必要なデータがそろっているか、品質に問題がないかを確認します。具体的には、NULL率、重複、フォーマットの一貫性を調べます。
分析環境は、データ量、分析の目的、チームのスキルに合わせて選びます。たとえば、数万行以下の小規模な分析なら、ExcelやGoogle Sheetsでも対応できます。一方、大規模または継続的な分析では、クラウドDWHとBIツール(DWH+BI)の組み合わせが有効です。
DWHにはSnowflake、BigQuery、Redshiftなどがあります。BIにはTableau、Looker、Power BIなどがあります。また、高度な機械学習には、Pythonのpandas、scikit-learn、PyTorchなどを使います。
このほか、機械学習の基盤としてAWS SageMaker、Google Vertex AI、Azure Machine Learningも検討できます。データパイプラインの自動化には、変換用のdbtや、オーケストレーション用のApache Airflowが広く使われています。
フェーズ3:データ前処理・クレンジング
前処理・クレンジングは、一般に全工数の50〜80%を占めるとされます。生データの品質問題は、次のように整えます。
- 欠損値:削除、平均値補完、高度な補間モデルによる推定で処理します。
- 外れ値:IQR法・Z-score法などの統計的手法と、ドメイン知識に基づく判断。
- 重複:主キーを設定して一意性を確保します。
- 形式と結合:文字列を数値に変換し、表記ゆれ(例:「株式会社○○」と「(株)○○」)を整え、日付形式や単位の不一致を直して、JOINで複数ソースをキー結合します。
- 特徴量:機械学習用の変数を加工します。
問題を適切に処理しないと、分析結果の信頼性が損なわれ、誤った判断につながるおそれがあります。
前処理は一度で終わらず、新しいデータの追加に合わせて継続します。そのため、dbtやPythonスクリプトのAirflow化などで、この作業を自動化します。
フェーズ4:分析・モデリング
データの準備が整ったら、分析・モデリングに進みます。記述・診断・予測の分析ごとに、使う手法が異なります。
- 記述分析:SQLやPythonのpandasで集計します。
- 診断分析:ANOVA、相関、コホート分析で原因を探ります。
- 予測分析:機械学習モデルによる、将来の値や分類の推定。
記述分析では、平均、中央値、標準偏差、百分位数などを算出します。あわせて、クロス集計や時系列トレンド分析も行います。
需要を予測したり、価格を最適に決めたりする場合は、Prophet、SARIMA、LightGBMなどの時系列分析を使います。チャーン予測や信用スコアリングには、分類モデルを使います。分類モデルには、ロジスティック回帰、ランダムフォレスト、XGBoostなどがあります。
推薦では、協調フィルタリングや深層学習を使うケースが多いです。
評価では、学習データだけでなく、未知のデータであるホールドアウトデータも確認します。AUC、RMSE、精度、再現率などで検証し、過学習が起きていないかを調べます。
SHAP値などで特徴量の寄与度を調べ、モデルの解釈可能性を確かめておきます。ビジネス担当者への説明責任を果たすうえで、これは欠かせない作業です。
フェーズ5:可視化・レポーティング
分析結果を意思決定に活かすには、経営層や業務担当者に伝わる形で見せることが欠かせません。伝え方の基本は、次の3点です。
- メッセージ:伝える内容を一つに絞ります。
- グラフ:比較、変化、割合、分布の目的に合わせて選びます。
- 表示設計:色、サイズ、軸で誤解を防ぎます。
分析者が面白い結果を得ても、ビジネス担当者に伝わらなければ活用されません。伝える手段として、継続的な監視にはBIダッシュボードが有効です。Tableau、Looker、Power BI、Google Looker StudioなどでKPI推移を示します。
設計の前には、利用者が知りたいことと必要な粒度を聞き取り、使いやすいUIを整えます。さらに、アラートやドリルダウン分析を組み込むと、経営層や事業部門が日常的にデータを使う文化を育てられます。また、週次・月次の定期レポートも、習慣づけに役立ちます。
フェーズ6:業務活用・改善のPDCA
分析の価値は、結果をビジネスの行動に結びつけて生まれます。改善を続けるために、次の流れを繰り返します。
- Plan・Do:分析結果をもとに施策を実施します。
- Check:施策の効果をデータで検証します。
- Act:検証結果を次の分析・改善につなげます。
結果が行動につながらないときは、担当者との連携、伝え方、意思決定プロセスへの組み込みのどこかに原因があることが多いです。
A/Bテスト(ランダム化比較試験)は、施策の因果効果を測る最も信頼性の高い手法です。そのため、マーケティングやUI改善、価格変更などの検証に積極的に使います。
また、機械学習モデルでは、時間とともに性能が落ちるモデルドリフトが起きます。そこで、定期的な再学習と性能の監視を、運用に組み込んでおきます。
成功事例を社内で共有し、他部門へ展開することで、データドリブン文化を組織に根づかせられます。
データ分析環境構築・外注費用の目安
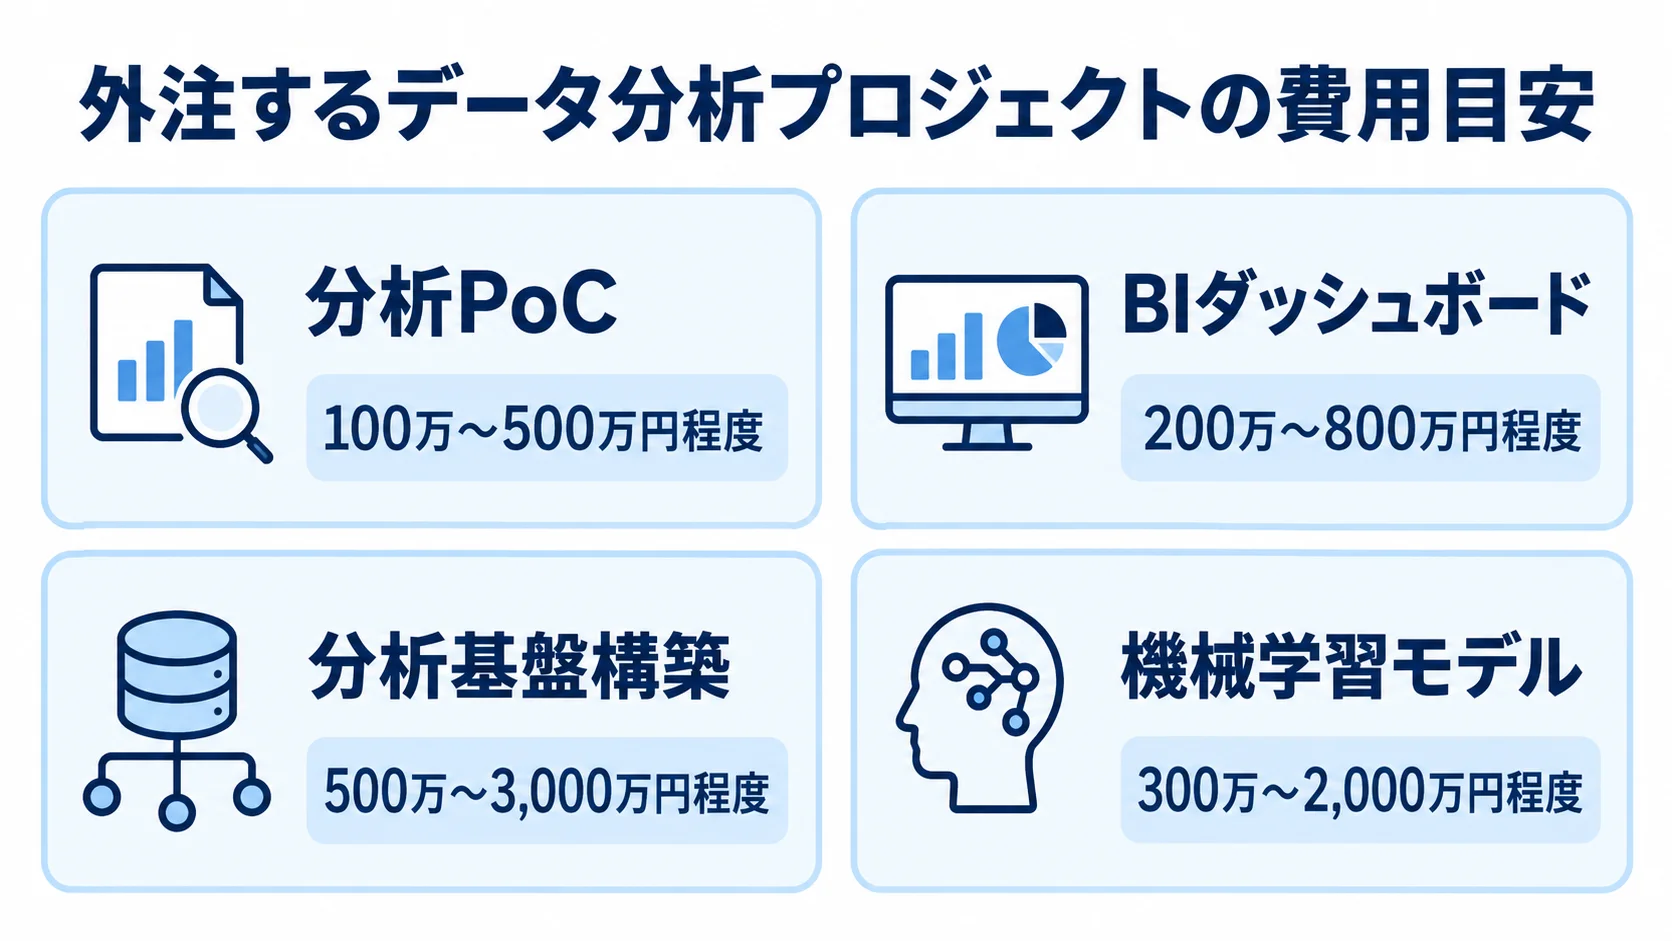
費用は、分析の規模や目的、外注の有無によって変わります。手元のツールで行う小規模な分析から、本格的な分析基盤の構築まで、幅があります。
分析ツール・環境費用の目安
ツールごとに料金体系と費用が異なるため、BIやデータウェアハウス、機械学習、パイプラインの4つに分けて見積もります。
- BI:無償のものから年約10万円/ユーザー以上まであります。
- クラウドDWH:従量課金で、中規模利用は月数万〜数十万円が目安です。
- 機械学習基盤:開発時は月数万円、本番時は月数十万円からが目安です。
- パイプライン:SaaSは月数万円からで、OSSは運用費がかかります。
具体的には、Tableau Creatorは約10万円/ユーザー/年からです。Power BIはMicrosoft 365に含まれる場合があり、Power BI Proは約1,500円/ユーザー/月です。
一方、LookerはGoogle Cloudのサービスで、月数十万円からです。Google Looker Studioは無償です。
Snowflakeは、コンピューティングが$2〜$4/クレジット、ストレージが$23/TB/月です。BigQueryは、クエリ処理が$5/TB、ストレージが$0.02/GB/月です。
機械学習基盤にはAWS SageMaker、Google Vertex AI、Azure Machine Learningなどがあります。料金は、インスタンスタイプと利用時間に応じた従量課金です。
SaaSコネクタのFivetran、Airbyteのクラウド版、dbt Cloudは、いずれも月額数万円からです。dbt CoreやApache Airflowは、ライセンス費用が不要です。ただし、自社でホストするにはインフラ費用と運用工数が必要です。
外注費用の規模別目安
外注費用は、プロジェクトの範囲と複雑さによって変わります。そのため、案件の種類ごとの金額幅を比べながら予算を検討します。
- 分析PoC:100万〜500万円程度
- BIダッシュボード:200万〜800万円程度
- 分析基盤構築:500万〜3,000万円程度
- 機械学習モデル:300万〜2,000万円程度
PoC(概念実証)は、特定の課題について分析モデルを試作して検証する工程です。分析コンサルタント1〜2名で1〜3か月ほどの案件が多いです。
BIダッシュボードの費用には、KPIの要件定義からTableauやPower BI上での実装までが含まれます。一方、本格的な基盤の費用には、DWHの構築も含まれます。
機械学習モデルの開発・本番実装には、需要予測、チャーン予測、レコメンデーションなどの用途があります。費用は、複雑さとデータ準備の工数で変わります。
コンサルタントの人月単価は、ジュニア(経験〜3年程度)が60万〜80万円/月、シニア(経験5年以上)が100万〜200万円/月です。外注範囲は、費用と、売上向上やコスト削減、リスク低減などの価値を数字で試算して決めます。
データ分析・活用を成功させるポイント
成功させるには、技術に加えて、ツール、人材、組織体制も整える必要があります。
ツール選定の考え方
ツールを比べるときは、課題を解決できるかだけでなく、チームのスキルや将来の拡張、費用に見合う価値まで見ておきます。
- 必要機能:現時点の課題を解決できる機能の有無
- チーム適合:メンバーのスキルに合っているか
- 拡張性:将来の利用拡大への対応力
- 費用対効果:価格に見合う価値があるかどうか
高機能で高価格なツールでも、使いこなせなければ意味がありません。そのため、Google Looker StudioやPower BIで始め、需要に応じて高機能なツールへ移る方法が現実的です。
AWS、GCP、Azureのいずれかに統一するか、複数のクラウドを使うかも判断します。複数利用は連携が複雑になるため、初期は単一クラウドのほうが管理しやすい場合があります。一方で、複数クラウドはベンダーロックインを避けるために選ばれることもあります。
dbtやApache Airflow、MetabaseなどのOSSは、費用を抑えられるものの、社内運用のスキルが必要です。ツールの変更にはコストがかかるため、トライアル、PoC、社内レビューを経て慎重に決めます。
人材育成とスキルセット
必要な役割を把握したうえで、採用と育成を組み合わせます。一人ですべてを担える人材に頼るより、役割ごとに体制を組むほうが現実的です。
- データエンジニア:データ基盤の構築とパイプライン開発を担います。
- データアナリスト:BI、集計分析、レポート作成。
- データサイエンティスト:機械学習モデルの開発と評価。
- ビジネスアナリスト:ビジネス課題の定義、分析結果の解釈、業務への橋渡しを担います。
社内では、SQLやExcelの基礎を全社員に広げ、データリテラシーを高めます。中級者にはPythonのpandasやmatplotlib、BI操作の研修が効果的です。上級者には、機械学習、統計解析、データエンジニアリングの研修を用意し、段階的な育成プログラムとして組み立てると役立ちます。
専門人材の需給は逼迫しているため、未経験者の育成と経験者採用を組み合わせ、外部コンサルタントやフリーランスも活用します。外部専門家の活用は、立ち上げを速めながら社内人材を育てる方法にもなります。
組織体制とデータガバナンス
組織体制には集中型(CoE:Center of Excellence)、分散型、ハイブリッド型があります。専門性と現場対応のバランスを見て選びます。
- 集中型:専門性を集約できますが、対応が遅れる場合があります。
- 分散型:現場に近い一方、データの一貫性が難しくなります。
- ハイブリッド型:基盤・統制と各部門の分析を分担します。
たとえば集中型では、中央の専門チームが各部門のニーズに応えます。分散型では、各部門に担当者を置きます。なお、多くの企業では、中央に基盤と統制を担うデータエンジニアリングチームを置き、各部門にアナリストを配置する形が最適とされています。
統制では、データの責任者を明確にし、データカタログや品質基準を整えます。あわせて、定期チェックとロールベースのアクセス権限管理も行います。
統制が不十分だと、データの信頼性が下がり、分析結果への疑念が広がります。活用の文化も根づきにくくなるため、統制は組織推進の基盤として整備します。
まとめ
データ分析・活用は、6つの段階を順に進めます。目的設定と収集・環境構築から始め、前処理と分析を経て、可視化と業務改善へ進みます。各段階を丁寧に踏むと、分析の精度と業務への貢献度が高まります。
費用の目安は、ツールや環境が月数万円〜数十万円、PoC外注が100万〜500万円、本格基盤の構築が500万〜3,000万円です。
目的を定め、ツールや人材育成、データガバナンスを整えます。そのうえで、スモールスタートで成果を確かめながら、段階的に広げます。この進め方が、多くの企業での成功につながります。
▼全体ガイドの記事
・データ分析/活用の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。