
データ分析システム開発の期間は規模によって変わり、目安は小規模で1〜3ヶ月、中規模で3〜6ヶ月、大規模で6〜12ヶ月以上です。
納期を現実的に守るには、要件定義、データ基盤・ETL・BIの構築、検証、本番移行の順に工程を組み、規模に応じた工程設計をすることが大切です。
▼全体ガイドの記事
・データ分析システムの完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データ分析システム開発の全体像とプロジェクトの位置づけ
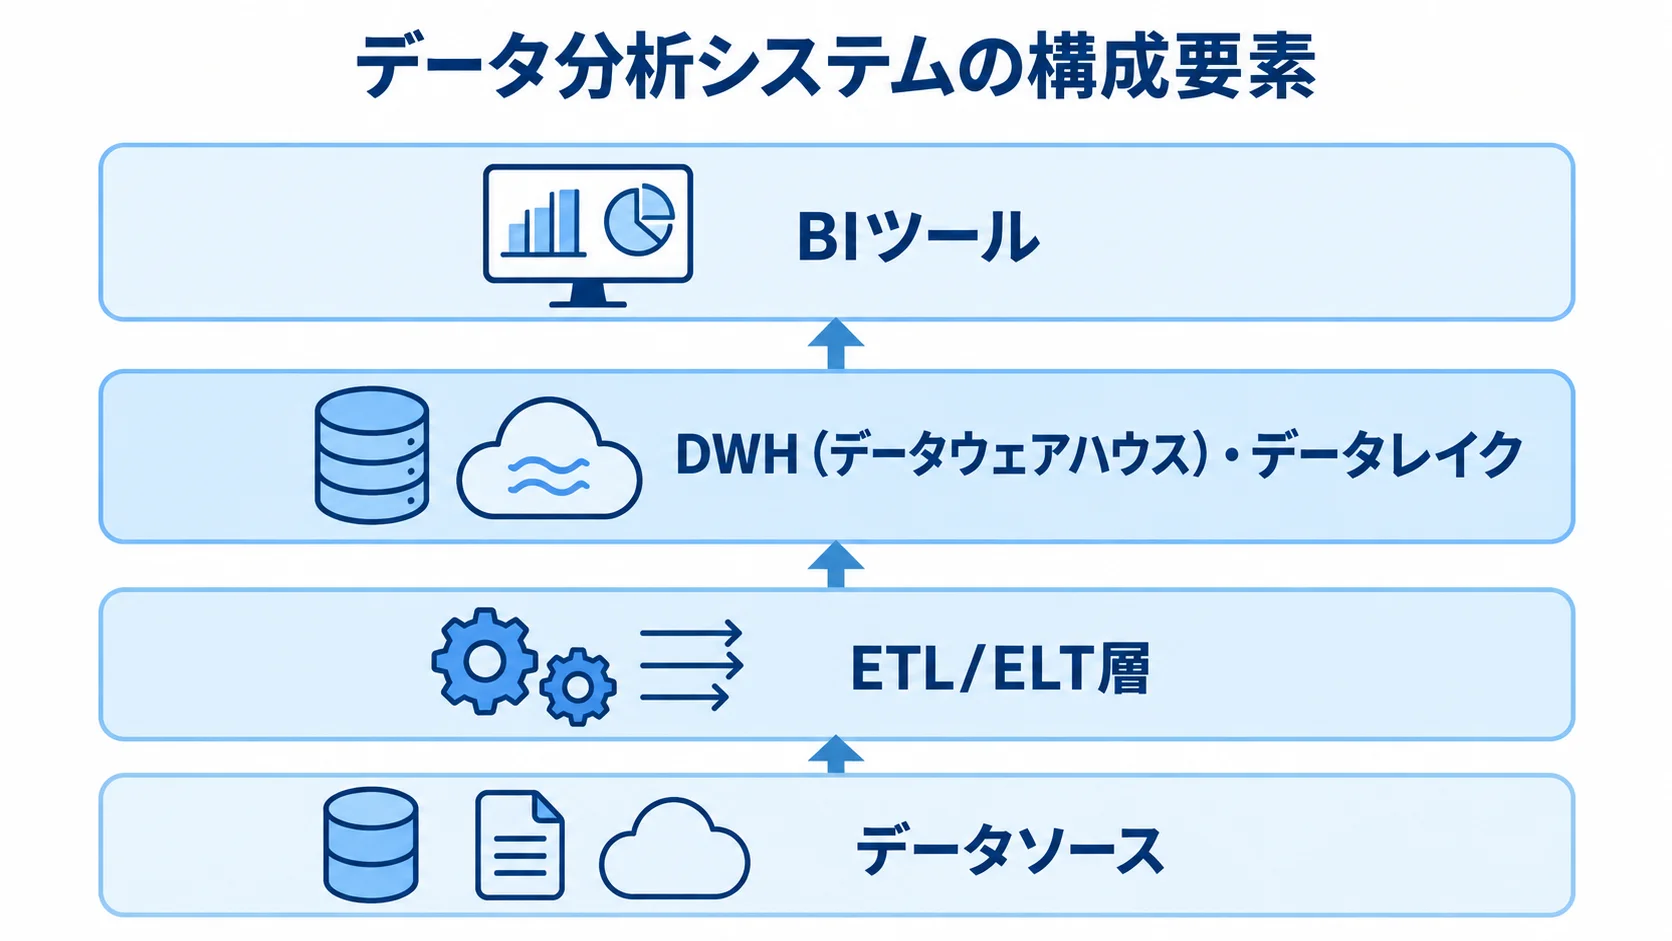
データ分析システムは、複数のデータソースを集め、加工・蓄積し、BIツールで可視化する仕組みです。
高機能なBIツールを1つ契約するだけでは、データ分析システム開発は完結しません。分析画面を支えるには、データの流れ全体を組み立てることが欠かせません。
まず、販売管理・会計・CRMなどの基幹システムや、SaaS、センサー、Webログから、ETL/ELT層でデータを抽出・変換します。次に、DWH(データウェアハウス)やデータレイクの層で集約・蓄積し、BIツールの層で分析・可視化します。さらに、三層をつなぎ、権限管理やデータ品質管理の仕組みも一体で構築します。
データ分析システム開発は、これら複数の構成要素を統合システムとして企画・設計・構築するプロジェクトです。
構成要素はそれぞれ奥が深く、なかでも全体アーキテクチャ設計やベンダー選定、プロジェクト管理といった上流の判断が期間を左右します。
「データ分析/活用」との違い
計画を立てる前に、「データ分析/活用」と「データ分析システム開発」で見る視点が異なることを確認しておきます。
「データ分析/活用」は、KPIや意思決定の文化、人材育成といった、ビジネスや組織の側のテーマです。一方、「データ分析システム開発」は、データを集め、貯め、加工し、見せる技術基盤を構築します。
両者は車の両輪ですが、この記事が焦点を当てるのは、決まった要件をいつまでにどう作るかという実装計画です。
- 活用側の論点:KPI設計、意思決定文化、人材育成
- 開発側の論点:データ基盤の構成、構築工程、必要な期間
統合システムだからこそ期間見積もりが難しい理由
開発期間は、画面の数よりも、裏側のデータの複雑さに左右されます。
販売管理・CRM・会計・在庫などの複数システムでは、データの形式や更新タイミングがそれぞれ異なります。そのため、これらを整合させるETL処理の難易度が上がり、開発期間を押し上げます。
たとえば、同じ画面でも、データソースが1つの場合と5つの場合とでは、収集・変換・検証の工数が異なります。また、製品の選定や、既製サービスと個別開発の分担も、期間に直結する判断です。
- データソース:数や品質、連携方式を確認する
- 全体構成:製品と既製サービスの利用範囲を決める
見積もりの前提として、要件定義でこれらを洗い出し、全体アーキテクチャを固めておきます。
規模別の開発期間の目安
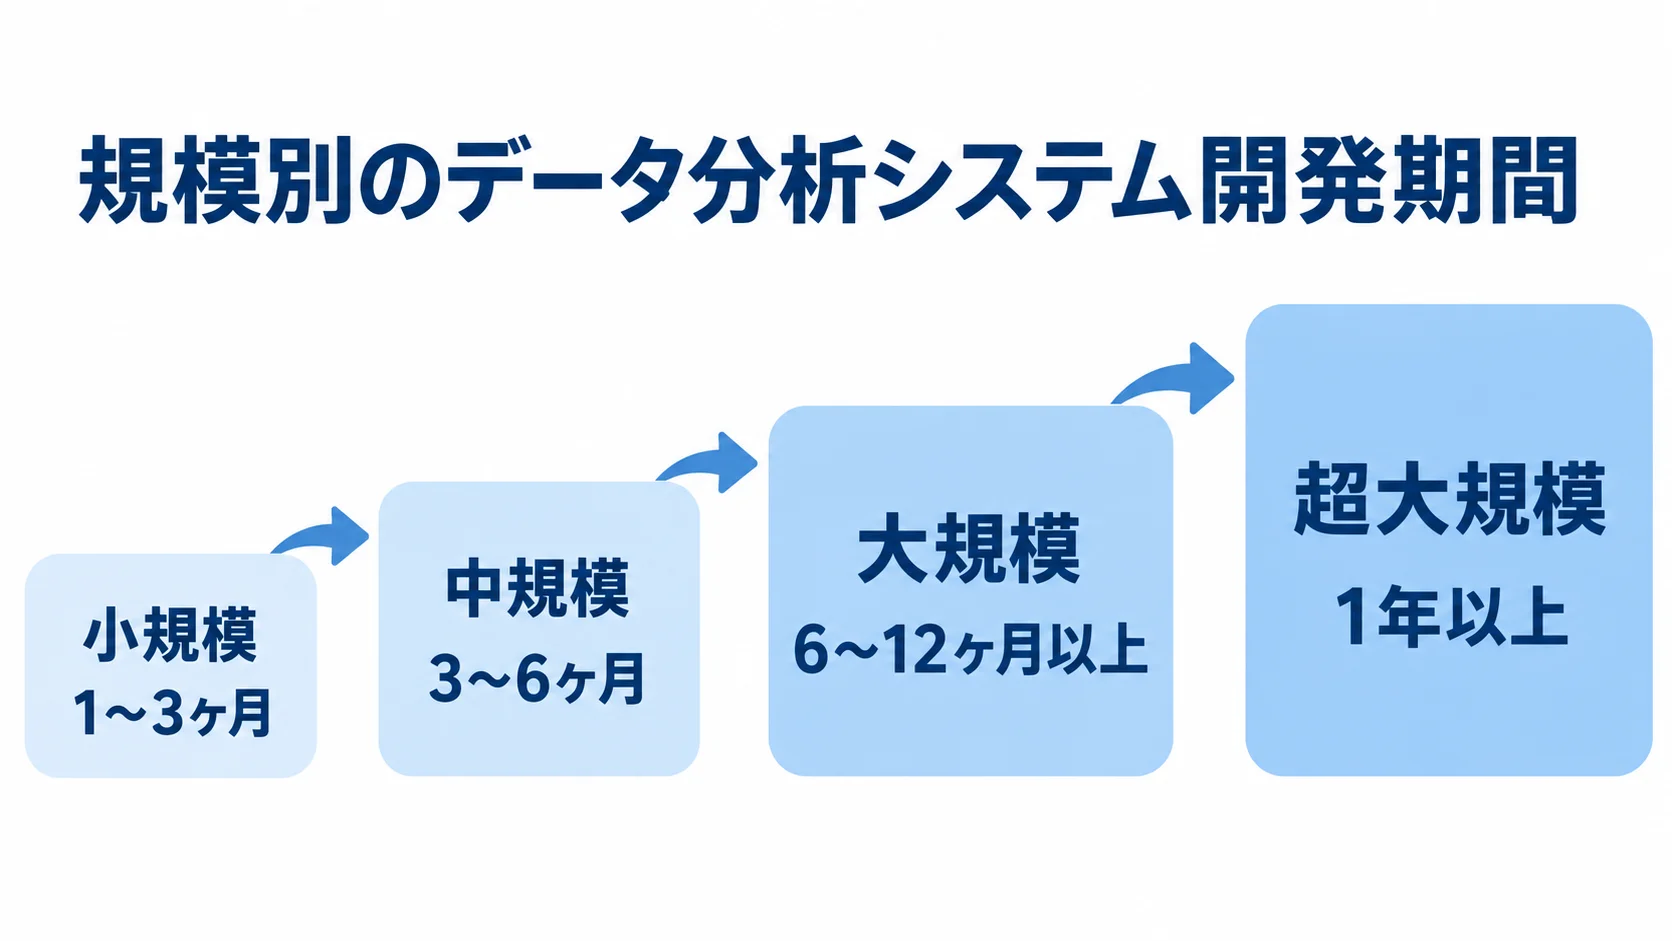
期間は、データソースの数、システムの複雑さ、分析の高度さによって変わります。
スモールスタート(MVP)は、単一データソースの取り込みと簡易な加工、基本的な集計画面を対象とする規模です。この規模であれば、1〜3ヶ月程度で立ち上げられます。
中規模では、複数ソースのETL、複雑なデータ設計、複数の画面、アラートや外部連携を含みます。
本格的な業務利用を想定すると、期間は3〜6ヶ月が目安です。
大規模では、全社のDWHやデータレイク、リアルタイム処理、部門をまたいだ利用などを構築します。
高度な権限制御やAI予測モデルを含む場合は、6〜12ヶ月が現実的な範囲です。
独自AI基盤やマルチエージェント基盤のように高度な処理を要する超大規模案件は、1年以上を見込みます。
全社のデータと分析を最初からすべて網羅しようとすると、期間が長引き、プロジェクトの頓挫を招きます。
小規模・中規模・大規模の期間と費用の目安
小規模では、単一の業務システムから売上や在庫などを集約し、限られたテーマの画面を構築します。
従量課金型のクラウドDWHとマネージドのデータパイプラインを使えば、短期で立ち上げられます。
中規模では、複数の基幹システムやSaaS、ログを統合し、部門をまたぐKPIや権限管理を備えます。
中心となる工程は、データモデル設計、ETL/ELTパイプラインの整備、複数ダッシュボードの構築です。
チームは、データエンジニア、BIエンジニア、プロジェクトマネージャーで編成するのが標準です。
大規模では、全社DWHとデータレイクを中核に、リアルタイム処理やAI・機械学習の前処理基盤を含みます。
大量データの性能設計、厳格なガバナンス、段階的な全社展開が必要になります。
- 小規模:1〜3ヶ月、100万〜300万円程度
- 中規模:3〜6ヶ月、300万〜1,500万円程度
- 大規模:6〜12ヶ月以上、1,500万〜5,000万円以上
いずれも目安にすぎず、製品の選定や自社の体制によって変わります。そのため、見積もりには余裕を持たせておくことが大切です。
開発期間を左右する変数
中規模の案件でも、期間が3ヶ月で済む場合と6ヶ月かかる場合があります。
第一に、元データの品質と前処理の量が期間を左右します。表記ゆれや重複、欠損が多いと、名寄せやクレンジングに数ヶ月かかることもあります。
データ整備・前処理は、全体工数の20〜30%が一般的で、品質が低いとさらに膨らみます。
第二に、データソースの数と連携方式が影響します。1システムの取込と複数システムのETLでは、設計・実装・テストの工数が異なります。
第三に、選定製品と既存クラウドの利用状況が影響します。親和性の高いDWHなら、ネットワーク設計や権限管理を流用できます。
第四に、分析要件やダッシュボードの複雑さが影響します。定型レポートか、部門別指標やドリルダウン分析まで求めるかで、作り込みが変わります。
- データ品質:前処理の量と期間に影響する
- 連携内容:ソース数と方式で設計・検証工数が変わる
- 製品と分析要件:既存環境や画面の複雑さが構築量を左右する
開発期間を左右する変数を、要件定義の段階で洗い出すことが、精度の高い納期見積もりにつながります。
工程別のスケジュールと期間配分
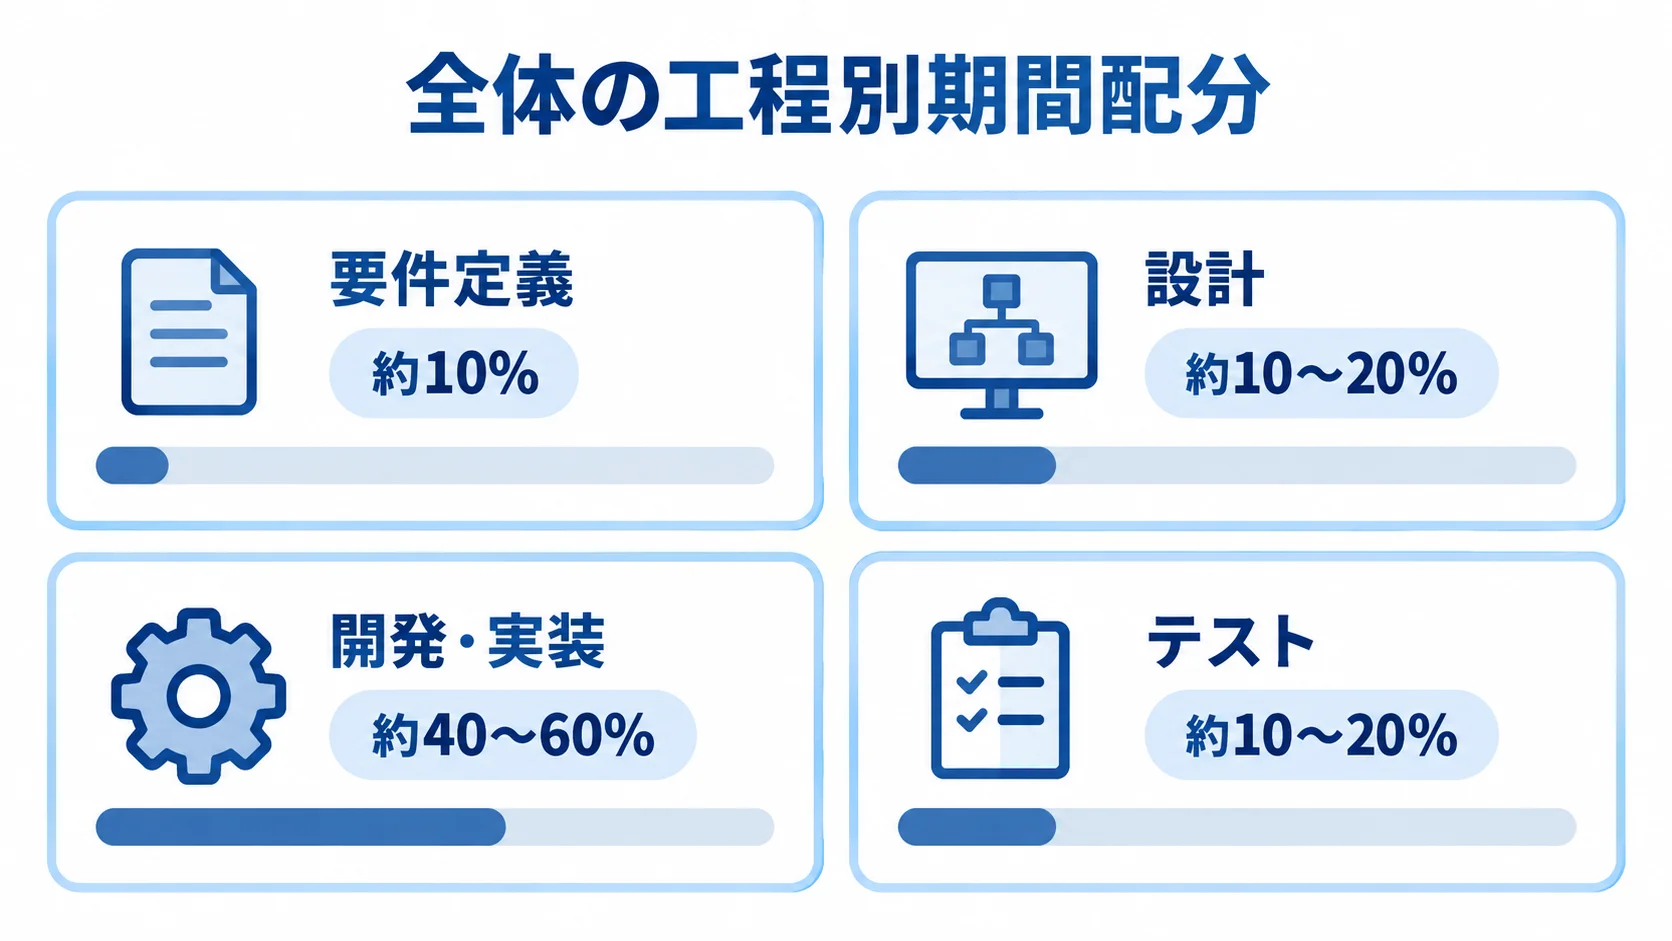
全体の期間を工程に分け、各工程に充てる割合を把握しておくと、計画を立てやすくなります。
一般的な配分は、要件定義が約10%、設計が約10〜20%です。
開発・実装は約40〜60%、テストは約10〜20%を占めます。
統合システム開発の特徴は、開発・実装フェーズが最も工数の大きい山場になる点です。
6ヶ月(約26週)の中規模案件を例にすると、要件定義に約2〜3週、設計に約4〜5週を充てます。開発・実装は約13〜15週、テスト・データ検証・本番移行は約4〜5週が配分の例です。
要件定義・設計では、データ設計とKPI定義が重要です。集約する粒度や可視化する指標によって、開発工数と画面の実用性が左右されます。
上流工程に十分な時間を確保すると、納期の遵守につながります。
要件定義・全体アーキテクチャ設計フェーズ(全体の約10〜30%)
要件定義と全体設計は、統合システム開発の成否を左右します。対象業務のKPIや、データソースの発生量・更新頻度を整理するところから始めます。
全体アーキテクチャは、既存のクラウドやセキュリティ要件と整合させながら固めます。
- 分析要件:誰が何を分析し、どの意思決定に使うか
- 構成方針:ETL/ELT、DWH、データレイク、BIの役割と接続
- 製品選定:既製サービスと作り込みの分担
構成方針を設計書に残すことは、後工程の手戻りを防ぐ最大の予防策です。
要件定義は2週間〜1ヶ月が目安です。全体設計まで含めると、規模によっては全体の3割近くを上流工程に充てることになります。
データ基盤構築・ETL開発・BI構築フェーズ(全体の約40〜60%)
開発・実装は全体の約40〜60%を占め、複数のレイヤーを構築します。ネットワークやセキュリティ、データモデルも、この段階で整えます。
ETL/ELTでは、データの抽出や欠損の補完、重複の排除、初期ロードと差分連携を実装します。バッチ処理やジョブ管理を設定し、BIツールとの接続と画面構築を進めます。
三層はそれぞれ独立した技術領域です。そのため、SQLベースのビュー定義やdbtによるELT、ジョブ管理用のパイプラインツールなどを、各層に合わせて選びます。
- データ基盤:DWH・データレイクとデータモデルを構築
- ETL/ELT:抽出・加工・ロードとジョブを実装
- BI:データを接続し、ダッシュボードを構築
取込・集計・可視化は、2週間〜1ヶ月単位のスプリントで反復する進め方が適しています。
レイヤー間の接続やデータの受け渡しでは、想定外の調整が起きやすいため、結合部分の検証時間を厚めに確保します。中規模では、この工程に13〜15週程度を見込みます。
テスト・データ検証・本番移行フェーズ(全体の約10〜20%)
テストでは、要件と集計結果を検証し、問題がなければ本番運用に移します。
画面が整っていても、ETLの集計誤りやデータ連携の欠損で数値がずれると、意思決定を誤らせる重大な問題になります。
また、想定データ量でのクエリ性能と、権限設定によるアクセス制御もテストします。さらに、統合システムでは、既存システムの過去データ移行や、新旧システムを並行稼働させる期間の工数も見込みます。
- 数値検証:元データと件数・金額を照合する
- 性能・権限:クエリ性能とアクセス制御を確認する
- 本番移行:過去データ移行と並行稼働を計画に含める
とくに、原因を一つずつ特定する作業は、画面の実装以上に工数がかかることもあります。
移行や並行稼働を予定に含めないと、リリース直前の遅延につながります。
テスト後はパイロット部門やユースケースから段階的に運用し、利用者の声を集めて継続改善します。
統合システムのスケジュールを最適化する進め方
すべての工程を直列に進めなくても、複数レイヤーの並行作業と体制づくり、スコープを絞るMVPの工夫によって、納期を現実的に短縮できます。
並行工程と内製×外注ハイブリッド体制
統合システムでは、複数のレイヤーを担当者ごとに並行させて、リードタイムを圧縮します。たとえば、データエンジニアはETL/ELT連携とクレンジングを進めます。
BIエンジニアは、少量のサンプルデータや仮のデータマートを使って、画面の設計・実装を先行します。本番データを後から流し込む段取りにすれば、直列で進めるより数週間の短縮が見込めます。
体制面では、プロジェクト全体を最適化する内製×外注のハイブリッド型が推奨されます。
- 外注:ETLパイプラインや複雑なバックエンドの技術実装
- 内製:要件の具体化、現場への定着準備、並行運用
すべてを外注すると要件調整に時間がかかり、すべてを内製にすると専門人材の不足が障壁になりがちです。
役割を分けて並走させる体制が、統合開発で現実的な最短ルートとなり、期間とコストの最適化につながります。
1〜2ユースケースに絞ったMVPアプローチ
最初のリリース範囲を絞ることが、納期の短縮につながります。全社のデータと分析を一度に扱うと、要件や連携先が増え、合意にも時間がかかります。
そのため、成果や現場への影響が大きい1〜2のユースケースを選び、Phase 1(MVP)を構築します。例として、営業部の月次レポート自動化や、商品・店舗別の売上・粗利の可視化が挙げられます。
対象を絞ると、データソースとモデルが限られ、1〜3ヶ月で成果を出せます。
- 対象を選ぶ:意思決定に直結するものに絞る
- 小さく始める:Phase 1の成果を社内の理解と予算につなげる
- 段階的に広げる:Phase 2以降でデータソースや画面を拡張する
完璧な全社統合基盤を最初から目指すより、小さく作って早く価値を出し、段階的に育てるほうが、全体を最短で立ち上げられます。
各スプリントの終わりに動く画面を関係者に見せると、指標の定義や切り口のずれを早く修正でき、大きな手戻りを防げます。
納期を膨張させる要因と対策
統合システムには、固有の遅延リスクがあります。発生しやすい要因を、データ品質と要件・検証の2つに分けて見ていきます。
データ品質・前処理の見積もり漏れ
元データの品質問題は、データ分析システム開発で最も多い納期遅延の原因です。
実データを取り込むと、表記ゆれや重複、欠損が大量に見つかる場合があります。形式がそろっていない場合もあります。
システム構築が順調に進んでいても、名寄せやクレンジングだけで数ヶ月かかることがあります。
前処理は全体の20〜30%が一般的ですが、低品質のデータでは、さらに20〜30%上振れするリスクがあります。
「明日からデータを活用したい」という期待とは裏腹に、データ整備はプロジェクトに潜む大きな山になります。そのため、データが整っていると決めつけず、前処理の工数を最初から見積もりに含めます。
- 実態を確認:実データのサンプルを要件定義で確認する
- 対象を限定:優先ユースケースに必要な範囲から整える
- 継続運用:一度で終わらない品質改善に備え、クレンジングルールを運用する体制を整える
完璧なマスターの整備を待つより、必要な範囲から段階的に進めるほうが有効です。
数値のズレ検証と要件の曖昧さ
数値の不一致や曖昧な要件による手戻りも、典型的な遅延要因です。
画面の見た目よりも、数値のずれのほうが致命的です。そのため、ETLの誤り、元データの欠損、システム間の更新時差を切り分けます。
複数のソースを統合する場合、どのソースのどの段階でずれたのかを追う作業が複雑になります。
利用できるデータや分析結果のシステム連携要件が曖昧なままだと、仕様変更が頻発します。その結果、費用や期間が30〜50%増えるリスクがあります。
- 検証基準:サンプルデータと期待値を事前に準備する
- 範囲を明確化:要件定義でPhase 1の対象を決める
- 変更を管理:影響と工数を見積もり、合意後に反映する
既存の帳票やシステムの集計値との照合も欠かせません。追加の要望はPhase 2以降のバックログに記録し、初回リリースの範囲を保ちます。
まとめ
開発期間の目安は、単一データソースの小規模で1〜3ヶ月、中規模で3〜6ヶ月、大規模で6〜12ヶ月以上です。
工程の配分は、上流設計が約10〜30%、開発・実装が約40〜60%、テスト・検証・移行が約10〜20%が目安です。
データ分析システムは、DWH・ETL・BIを組み合わせる統合プロジェクトです。期間は画面の数より、裏側のデータの複雑さに左右されます。
複数のレイヤーを並行させ、内製と外注を組み合わせると、期間の短縮につながります。さらに、1〜2件のMVPとアジャイルな反復開発で価値を示し、短期の本番稼働を目指します。
元データの品質、数値の検証、要件の曖昧さは遅延につながります。そのため、実データの確認と変更管理を計画に含めます。
KPI設計や組織文化の醸成は、データ分析/活用の論点です。システム計画とあわせて検討すると、投資に見合う成果を引き出せます。
▼全体ガイドの記事
・データ分析システムの完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。