
データベース構築は、要件定義・現状分析、設計・開発、テスト・本番移行の3つのフェーズに沿って進めます。各フェーズで何を決め、関係者がどこで承認するかを押さえると、全体の流れを把握できます。
全体の詳しい説明は、次の完全ガイドにまとめています。
▼全体ガイドの記事
・データベース構築の完全ガイド
データ基盤構築の工程ごとの進め方と注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
データベース構築の全体像
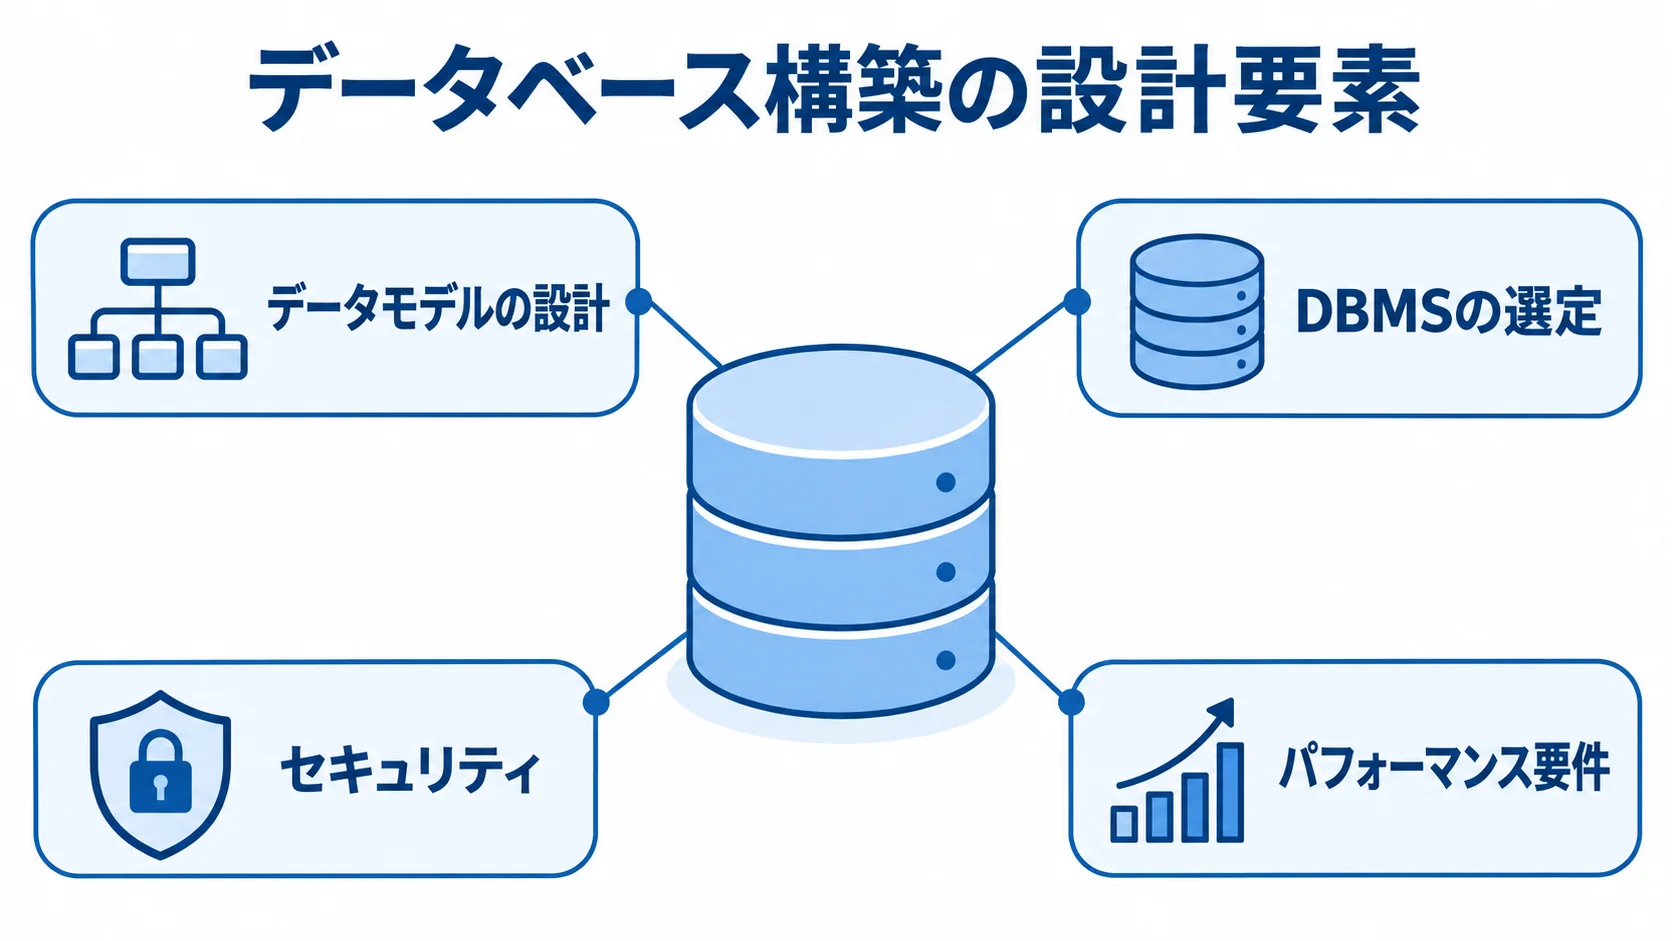
データベース構築とは、業務データを効率よく管理・活用するためのシステム基盤を設計し、実装するプロセスです。データを保存する箱を用意するだけでなく、業務に合ったデータモデルの設計、適切なDBMS(データベース管理システム)の選定、セキュリティ・パフォーマンス要件の充足まで、多岐にわたる作業が求められます。
構築の全体像をつかんだうえで、各フェーズの目的と作るものを明確にしながら進めることが大切です。
データベースの種類と特徴(RDB・NoSQL・NewSQL等)
データベースは大きく3種類に分けられ、それぞれに得意な用途と特性があります。まず、最も広く普及しているのがRDB(リレーショナルデータベース)です。RDBは表形式でデータを管理し、行と列で構成されるテーブルにデータを格納します。
MySQL、PostgreSQL、Oracle Databaseなどが代表例で、データの整合性や一貫性を保ちやすく、SQLによる複雑な検索・集計処理に対応できる点が強みです。業務システムや基幹系システムでは、現在も主流の選択肢となっています。
RDB以外の方式は、まとめてNoSQL(Not only SQL)と呼ばれ、データの持ち方によって型が分かれます。型ごとの代表的な製品を、下の一覧にまとめます。
- キーバリュー型:Redis等
- ドキュメント型:MongoDB等
- カラム型:Apache Cassandra等
- グラフ型:Neo4j等
NoSQLは、スキーマが柔軟で、大量データの書き込みや水平スケールアウトに優れています。SNSのタイムラインデータやIoTセンサーログのように、形式が不定、または量が膨大なデータを扱う場合に適しています。一方で、トランザクション処理や厳密な整合性管理はRDBほど得意ではないため、用途に応じた使い分けが必要です。
近年注目を集めているのがNewSQLです。RDBの堅牢なトランザクション処理能力とNoSQLの高いスケーラビリティを兼ね備えた新世代のデータベースで、Google Cloud SpannerやCockroachDBなどが代表例です。NewSQLは、大規模なオンライントランザクション処理(OLTP)が求められるシステムで採用が進んでいます。
データの規模・アクセスパターン・整合性要件を踏まえて最適な種類を選ぶことが、データベース構築の第一歩になります。
構築形態の選択肢(オンプレミス/クラウド)
データベースの構築形態は、オンプレミスとクラウドに大きく分かれ、オンプレミスは自社のデータセンターや社内サーバールームにハードウェアとソフトウェアを設置して運用する方式です。自社環境内でデータが完結するため、セキュリティポリシーを厳密に適用しやすく、カスタマイズの自由度が高い点が特徴です。一方で、初期投資が大きく、ハードウェアの調達・設置・保守に多くのリソースが必要です。
長期間にわたって安定稼働させる基幹システムや、法規制上クラウド利用が制限される業種では、依然としてオンプレミスが選ばれるケースが多いです。クラウド型は、AWSのAmazon RDS、Google Cloud SQL、Microsoft Azure Database for MySQLなど、クラウドベンダーが提供するマネージドサービスを利用する形態です。
インフラの調達や初期設定の手間を大幅に減らせ、スペックも必要なときに拡張・縮小でき、従量課金モデルが多いため、利用規模に応じて費用を最適化できます。スタートアップや新規プロジェクトでは、クラウドファーストで始め、必要に応じてオンプレミスとのハイブリッド構成へ移すパターンが増えています。選定では、データの機密性と既存システムとの連携、社内のITスキル、TCO(総所有コスト)を総合的に比べます。
データベース構築の進め方
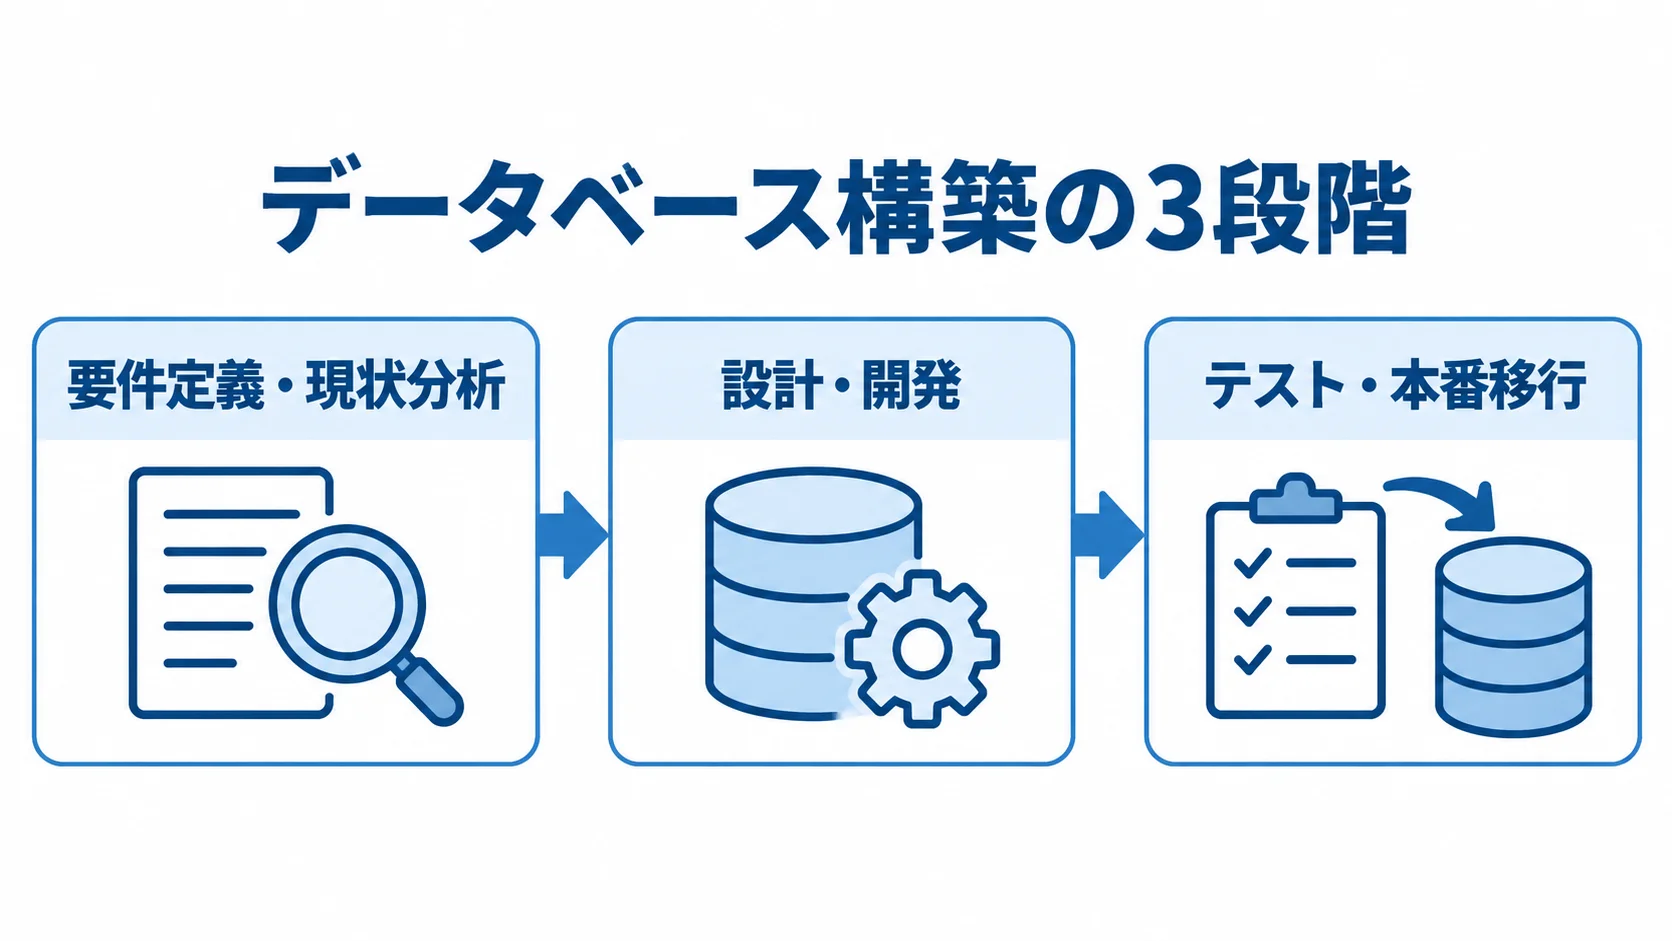
データベース構築は、要件定義・現状分析から始め、設計・開発、テスト・本番移行へと段階を踏んで進みます。
- 要件定義・現状分析
- 設計・開発
- テスト・本番移行
要件定義・現状分析フェーズ
データベース構築の最初のフェーズは要件定義と現状分析で、「何のためにデータベースを構築するのか」「どのようなデータを扱うのか」「誰がどのように利用するのか」を明確にします。業務部門へのヒアリングでは、管理するデータの種類・量・更新頻度を整理します。利用ユーザー数や必要なレスポンスタイム、他システムとの連携要件なども、網羅的に洗い出します。
要件定義では、機能要件に加えて非機能要件を定めることも欠かせません。性能要件(ピーク時の同時アクセス数・処理件数)と可用性要件(稼働時間・RTO/RPO)は、この段階で定めておきます。これらを決めておかないと、設計・構築フェーズで後から要件が追加され、大幅な手戻りが発生するリスクがあります。
また、セキュリティ要件(アクセス制御・暗号化・監査ログ)と拡張性要件(将来的なデータ量の増加予測)も、この段階で決めておきます。さらに、現状分析では、既存システムのデータ構造や業務フロー、移行対象データの品質・量なども確認します。そのうえで、要件定義書・業務フロー図・データ一覧表を作り、関係者全員の確認と承認を得てから次のフェーズに進みます。
設計・開発フェーズ(論理設計・物理設計)
設計フェーズは「概念設計」「論理設計」「物理設計」の3段階で進みます。業務の言葉で考える段階から、使うDBMSの形に落とし込む段階へと、順に詰めていきます。
- 概念設計:業務で扱う顧客・商品・注文などのエンティティと関連を整理し、ER図を作成する
- 論理設計:概念データモデルをもとに、テーブルやカラムの定義を設計する
- 物理設計:論理設計の内容を、実際に使うDBMS上で実装できる形に変換する
概念設計は特定のDBMSに依存せず、業務の本質的なデータ構造を表すことが目的です。論理設計では正規化も重要で、第1〜第3正規形(場合によってはボイスコッド正規形)へ段階的に進めることで、重複排除・更新異常の防止・整合性確保を実現します。ただし、過剰な正規化はクエリの複雑化やパフォーマンス低下を招くこともあるため、業務要件に応じて意図的な非正規化も検討します。
物理設計では、テーブルスペースとパーティショニングを設計し、インデックスを最適化します。ストレージ容量のサイジングやバックアップ設計、レプリケーション構成の決定なども行います。インデックスは検索パフォーマンスを大きく左右するため、主要な検索条件・結合キーに設定し、将来のデータ増加を想定してストレージに余裕を持たせます。
開発では、設計書をもとにDDL(データ定義言語)を実装し、アプリケーションとの連携確認も並行して進めます。
テスト・本番移行フェーズ
設計・開発が完了したら、単体テスト・結合テスト・性能テスト・セキュリティテストの4段階で進めるのが一般的です。単体テストでは、各テーブルへのCRUD操作(作成・読み込み・更新・削除)が正しく機能するかを検証します。結合テストでは、アプリケーションとデータベースの連携、トランザクション処理、データ整合性を確認します。
性能テストは特に重要で、要件定義で定めた性能要件を、実際のデータ量やアクセス量を模擬した環境で検証します。想定されるピーク時のトランザクション数・クエリレスポンスタイムを測定し、ボトルネックを特定して、インデックスの追加、クエリチューニング、ハードウェアスペックの見直しを行います。セキュリティテストでは、不正アクセスの試行、SQLインジェクション耐性、権限設定の妥当性を検証します。
本番移行では、データ移行計画を事前に詳細に策定することが成功の鍵で、移行リハーサルを本番と同じ手順で複数回行い、移行時間と手順の妥当性を確認すると、本番当日のトラブルを最小化できます。既存システムからのデータ移行では、データのクレンジング(重複排除・表記揺れの統一・欠損値の補完)を丁寧に行い、移行後の整合性チェックを必ず実施します。切り替え直後は、異常を早期に検知できるよう監視体制を強化します。
データベース構築の費用相場とコスト内訳
データベース構築の費用は、システムの規模・複雑性・選択するDBMS・構築形態によって大きく異なります。「まず費用感を把握してから計画を立てたい」という担当者のために、規模別の費用目安とコスト内訳を整理します。なお、費用はあくまで参考値のため、実際のプロジェクトでは複数社から見積もりを取り、正確な金額を確認することをお勧めします。
規模別の費用目安
個人事業主や小規模な用途であれば、5万円〜30万円程度で構築できるケースもあります。テーブル数が少なく、データ量も限られ、セキュリティ要件もシンプルな場合がこれに当たります。中小企業向けの業務データベース(受発注管理・顧客管理・在庫管理など)では、初期構築費用として100万円〜300万円程度が目安となります。
これは、要件定義・設計・構築・テスト・データ移行を含む場合の金額で、年間保守費用として別途20万円〜50万円程度を見込んでおくとよいでしょう。大企業の基幹系データベース(ERPシステム・会計システム・生産管理システムなど)では、500万円〜3,000万円以上の費用が発生することも珍しくありません。
複数のシステムとの連携や高い可用性・性能要件、大規模なデータ移行が伴う場合は、さらに高額になります。クラウド型は初期費用を抑えられますが、データ量・アクセス量に応じた月額費用が継続的に発生するため、3〜5年の総コストで比較することが重要です。また、テーブル数・カラム数・リレーションの複雑さ、セキュリティ対策の強度なども費用に影響する主要な要素です。
ライセンス・インフラ・開発費の内訳
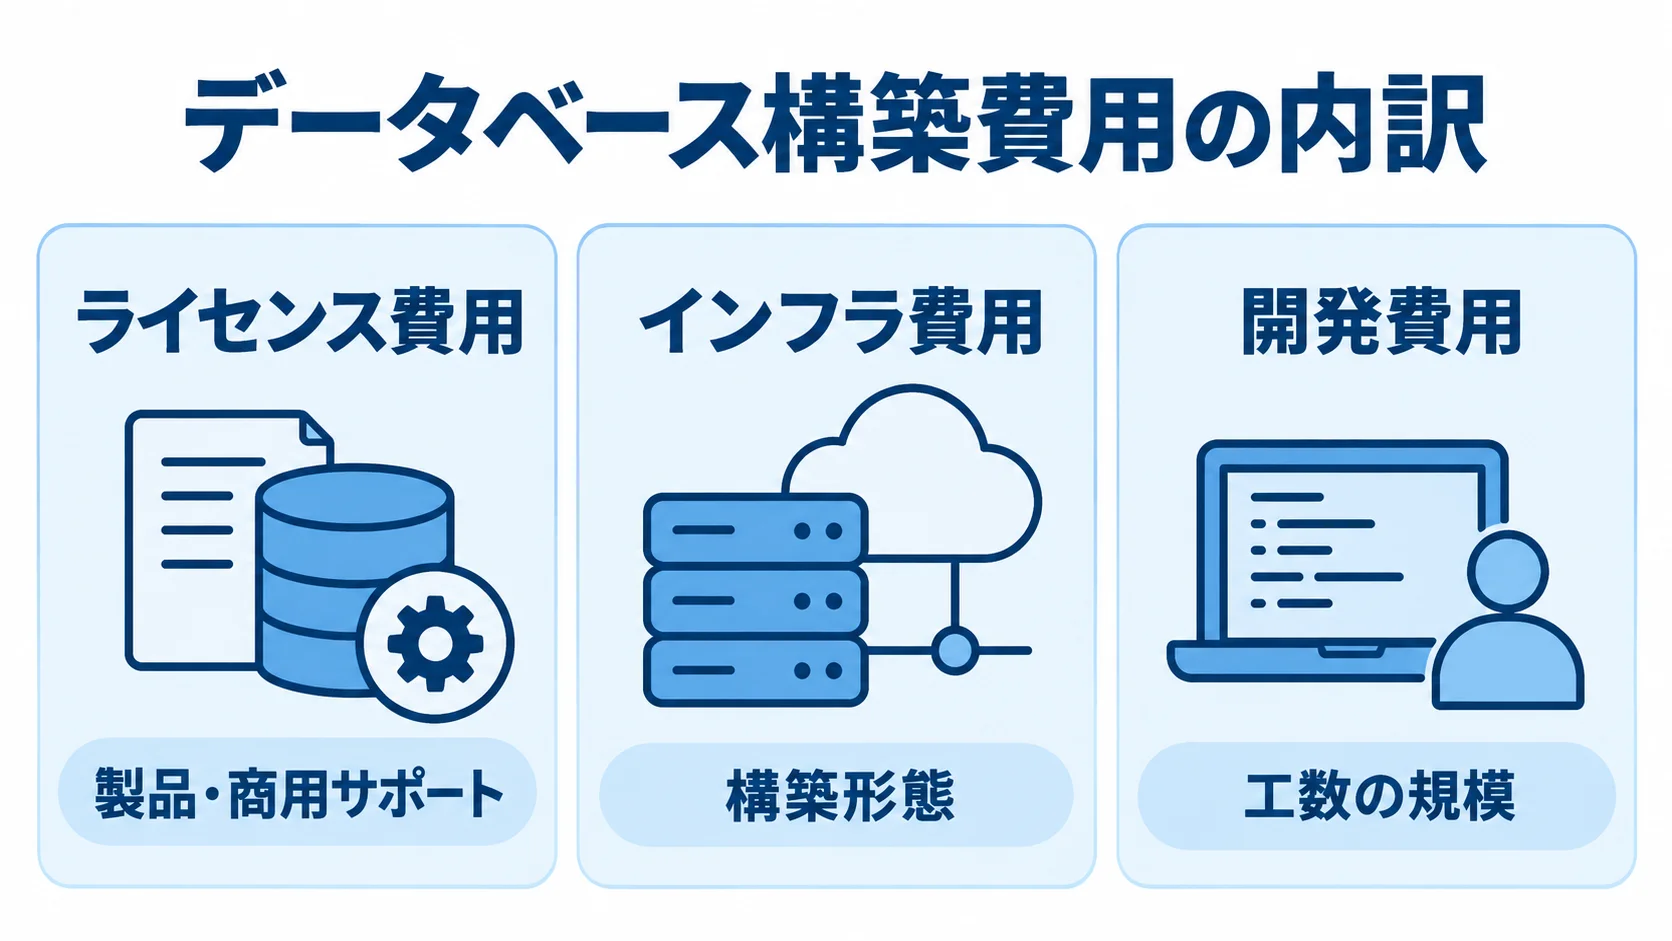
データベース構築の費用は、ライセンス費用・インフラ費用・開発費用の3つに大きく分かれます。
- ライセンス費用:利用する製品と、商用サポートの要否で決まる
- インフラ費用:構築形態(オンプレミスかクラウドか)によって内訳が変わる
- 開発費用:工数の規模がプロジェクトによって大きく変わる
MySQLやPostgreSQLなどのオープンソースDBMSは基本無償で、商用サポートが必要な場合のみ費用がかかります。そのため、オープンソースDBMSを選べば、ライセンスコストをゼロにできるのは大きなメリットです。
一方で、Oracle Database Enterprise EditionはCPUコアあたり約600万円以上(国内価格)と高額で、エンタープライズ用途では相応の予算が必要です。また、Microsoft SQL ServerはエディションによりStandard(約90万円〜)からEnterprise(約350万円〜)まで幅があります。
オンプレミスの場合は、サーバーハードウェア・ネットワーク機器・データセンター利用料が主な費用項目となり、初期投資として数百万円〜数千万円が必要なケースもあります。クラウドでは、インスタンス料金・ストレージ料金・ネットワーク転送料が月額で発生します。
開発費用は、設計から導入支援までの工数に人月単価を掛けた金額が基本です。エンジニアの人月単価は概ね60万円〜120万円が相場で、プロジェクト規模に応じて3人月〜50人月以上の工数が必要になります。さらに、運用フェーズの保守・監視費用も、長期的なコストとして計画に含めておく必要があります。
データベース構築を成功させるポイント
データベース構築プロジェクトの成否は、技術的な実装スキルだけでなく、要件定義の質、設計段階での先見性、パートナー選定の適切さによって大きく左右されます。過去に「構築後にパフォーマンスが出ない」「セキュリティインシデントが発生した」「運用フェーズに入ってから大規模な改修が必要になった」というトラブルを経験した企業の多くは、これらを疎かにしていたケースが見られます。
構築を確実に成功へ導くための要点を、要件定義から発注先の選び方まで順に見ていきます。
要件定義での注意点
要件定義で特に注意したいのは、現在の業務要件だけでなく、将来の業務変化を見据えて定義することです。現在のデータ量やユーザー数だけで設計すると、数年後に限界を迎えて大規模な再構築が必要になることがあります。少なくとも5年後のデータ量・アクセス量・業務範囲の変化を想定し、拡張性を持たせた設計方針を要件定義の段階で固めておくことが大切です。
業務部門とIT部門は、別々に要件を整理するのではなく、密に連携してヒアリングを行う必要があります。なぜなら、業務部門は業務の詳細を知っていますが、技術的な制約には疎いことが多く、IT部門は技術に強い半面、業務の細部を把握しきれていないことがあるためです。
そのうえで、双方の知識を持ち寄り、業務要件と技術要件を統合した要件定義書を作成すると、認識のずれによる手戻りを防げます。さらに、要件定義書は関係者全員が内容を理解・合意したうえで承認のサインをもらう、というルールを設けることを強くお勧めします。
性能・セキュリティ設計のポイント
性能設計では、クエリの実行計画(EXPLAIN)を使ってボトルネックを早期に見つけます。インデックスは検索パフォーマンスを大きく左右しますが、過剰なインデックスは更新時のオーバーヘッドを増やすため、主要な検索条件・結合キー・ソートカラムに絞って設計します。また、テーブル設計の段階でパーティショニング(データの論理的・物理的分割)を検討すると、データ量の増加に伴う性能劣化を防げます。
本番に近いデータ量で性能テストを必ず行い、要件を満たさなければ早期にチューニングします。セキュリティ設計では、最小権限の原則(アクセスに必要な最低限の権限のみを付与する)を徹底することが基本です。加えて、データベースユーザーは用途別に分け、アプリケーション用・バッチ処理用・管理者用などに分離することで、万が一の不正アクセス時の被害を最小化できます。
個人情報や機密データは暗号化して保存し、パスワードは必ずハッシュ化(ソルト・ストレッチングを組み合わせ)します。さらに、データベースへのアクセスログ・監査ログを取得・保管することで、不正アクセスや内部不正の検知・証跡管理が可能となります。バックアップは定期的に取得し、リストア手順と所要時間を事前に検証しておくことも必須の対策です。
パートナー選定のポイント
データベース構築を外注する場合、パートナー選定はプロジェクトの成否を左右する重要な判断で、まず確認したいのは同種のデータベース構築実績です。自社と同業種・同規模のプロジェクト経験があるかを確認すると、業務特有のデータ構造や規制要件への対応力を測れます。単なる「実績件数」ではなく、「類似プロジェクトの実績」を見て評価することが大切です。
次に、コミュニケーション体制と担当者との相性を重視することをお勧めします。いくら技術力が高い会社でも、要件のすり合わせや進捗報告が不十分では、プロジェクトはスムーズに進みません。提案段階から丁寧にヒアリングを行い、疑問点に分かりやすく回答してくれるか、リスクを率直に伝えてくれるかを見極めましょう。
さらに、開発後の運用・保守サポート体制も重要な評価項目です。データベースは、構築後も継続的な監視・チューニング・バージョンアップ対応が必要になるため、長期的なパートナーシップを築ける会社を選ぶのが理想的です。複数社から見積もりを取り、価格だけでなく提案内容・体制・実績・サポート範囲を総合的に比べて、発注先を決めましょう。
まとめ
データベース構築は、要件定義・現状分析から始まり、概念設計・論理設計・物理設計を経て、開発・テスト・本番移行まで、段階を追って進める必要があります。各フェーズで作成する資料に関係者の承認を確実に得ながら進めることで、手戻りを抑え、品質・コスト・スケジュールのバランスを保ったプロジェクト運営が実現します。
データベースの種類はRDB・NoSQL・NewSQLから業務要件に合わせて選び、構築形態はオンプレミス・クラウド・ハイブリッドを総所有コストと要件を踏まえて決めることが大切です。費用は規模によって5万円から数千万円以上まで幅広く、ライセンス・インフラ・開発費を合わせてトータルで計画する必要があります。
成功のカギは、将来の拡張性を見据えた要件定義の質、性能・セキュリティを設計段階から織り込む先見性、適切なパートナー選定の3点に集約されます。本記事の内容を参考に、自社のデータベース構築プロジェクトを着実に前進させていただければ幸いです。
▼全体ガイドの記事
・データベース構築の完全ガイド
開発を相談する前に読みたい無料ホワイトペーパーをご紹介します。
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。