
ETLツール導入の納期は、連携するソース数や変換の複雑さ、基盤の規模で変わります。目安は、小規模で1〜3か月、中規模で3〜6か月、大規模で6〜12か月以上です。
納期は、要件定義、設計、構築、テスト・運用開始の4段階に期間を割り当てて組みます。全体像は、ETLツール導入/構築の完全ガイドでご覧いただけます。
▼全体ガイドの記事
・ETLツール導入/構築の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
ETLツール導入の全体像とデータ基盤での位置づけ
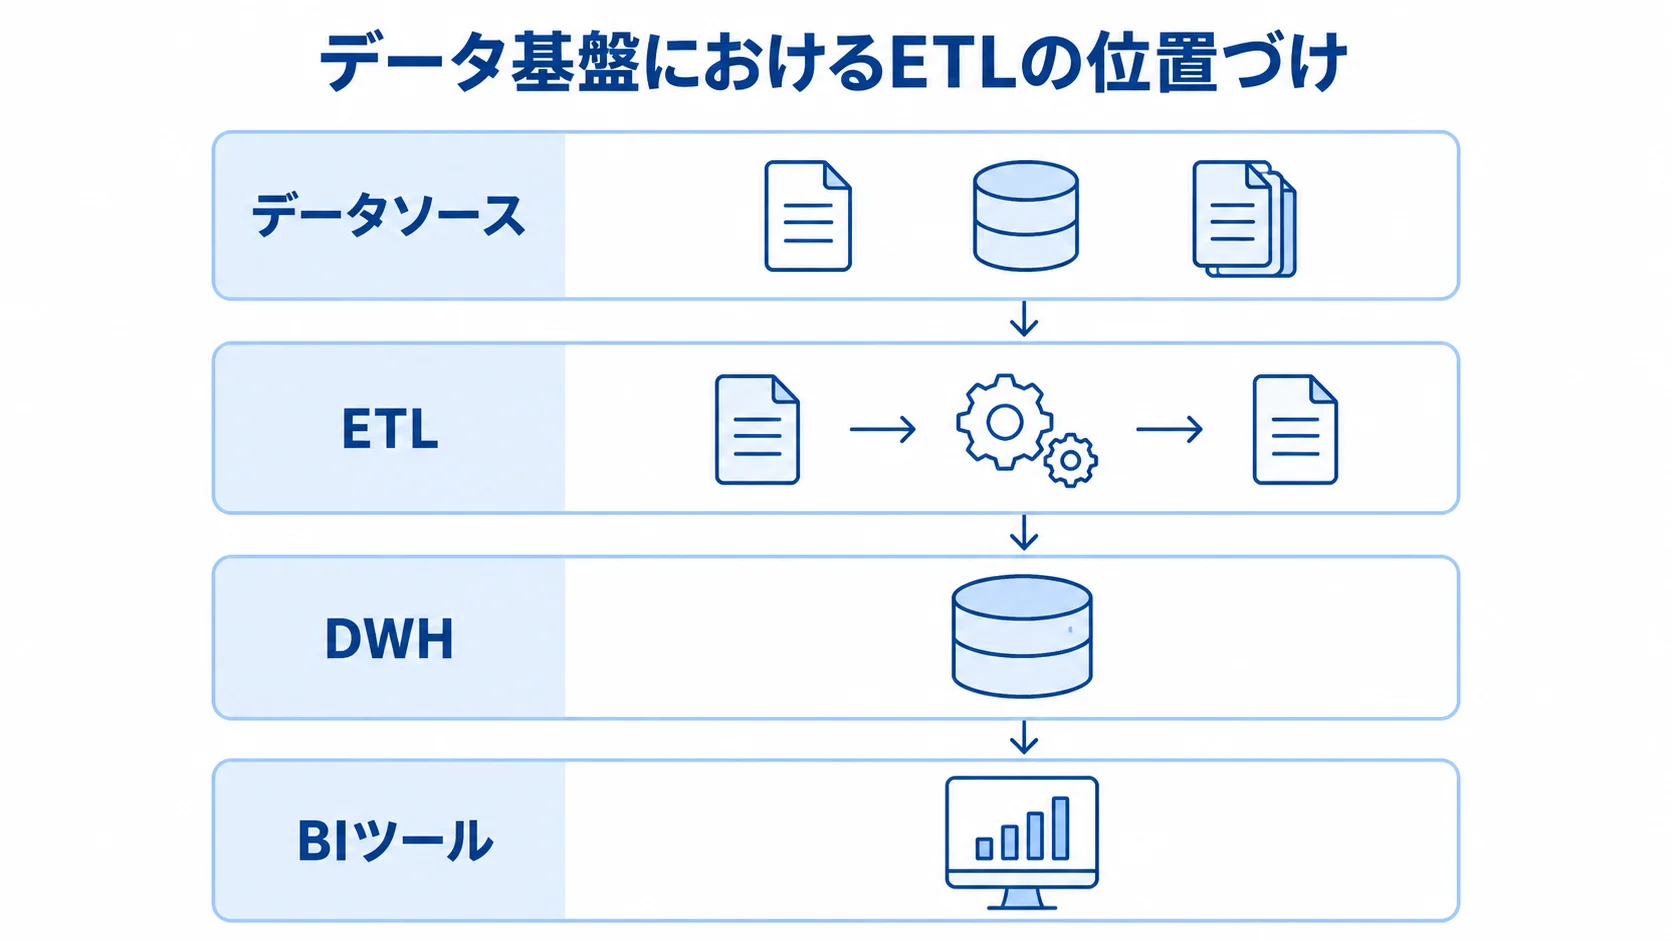
開発期間を正しく見積もるには、ETLがデータ基盤のどこで何を担うかを理解する必要があります。役割が曖昧なままだと、見積もりから工程が抜けやすくなります。
ETLは単体で完結せず、データソース、ETL、DWH、BIツールをつなぐ中間層です。両端のシステムの間を受け持つため、連携先が増えるほど作業も増えます。特に、前後のシステムとの連携の複雑さが、期間を大きく左右します。
DWHだけを導入しても、データを流し込む仕組みがなければ分析は始まりません。このため、ETL層はデータ供給を担い、プロジェクトの工数の中心になることがあります。
期間を見積もる前に、ETLの役割と、混同されやすいETL/ELTの違いを押さえておきましょう。
データ基盤におけるETL層の役割
企業のデータは、基幹システムやCRM、広告媒体のほか、会計ソフトや各種SaaS、CSVファイルにも散らばっています。形式や更新のタイミングも統一されていません。
ETLは、異なるソースからデータを抽出(Extract)し、変換・整形(Transform)して、分析基盤のDWHへ格納(Load)する工程を自動化します。処理は次の3段階です。
- 抽出:必要なデータを各ソースから取り出す
- 変換・整形:データを分析しやすい形にそろえる
- 格納:整えたデータをDWHへ投入する
変換では、表記揺れや単位をそろえ、欠損を補い、複数のテーブルを結合します。ETLは、散らばったデータを分析できる形に整えて一箇所へ運ぶ「配管」にあたります。
DWHやBIツールが保管場所や見せ方を担う一方、ETLはデータを整えて運び込みます。DWH導入とETL構築は別の工程ですが、互いを補い合う関係にあります。
汚れたデータが流れ込むと、BIダッシュボードの数字を信頼できなくなります。ETLの品質は、データ活用全体の土台になります。
ETLとELTの違いと期間への影響
ETLツール導入の設計では、ETLとELTの違いを避けて通れません。変換(Transform)の場所と時期が異なり、特にその違いは開発期間にも影響します。
- ETL:DWHへ格納する前に、外部で変換する
- ELT:抽出した生データをまずDWHへ格納し、その後にDWH内部で変換する方式
従来型のETLは、転送するデータ量を抑えられる一方で、変換ロジックが複雑になりがちです。主にレガシーなオンプレミス環境で使われてきました。
ELTは、BigQueryやSnowflakeなどクラウドDWHの計算能力を活用できます。さらに、dbtなどを使えば変換ロジックをSQLで管理しやすく、クラウドDWHでは主流です。
ELTは生データを先に取り込み、後から変換を追加できます。そのため、初期の立ち上げが速く、段階的な開発に向いています。これに対して、ETLは変換を事前に固めるため、設計が厚くなりがちです。
自社のDWHがクラウド型かオンプレミス型か、変換要件がどれほど複雑かを踏まえ、アプローチを早めに決めます。それが、スケジュール設計の前提になります。
代表的なETLツールの種類
ツールの選定は、接続するデータソースの種類、変換要件の複雑さ、社内のエンジニア体制で変わります。そのため、選定は要件定義の段階で話し合っておくテーマです。
- SaaS・マネージド型:trocco、Fivetran、AWS Glueなど
- 変換特化型:ELTの変換をSQLで扱うdbt
- OSS・自前構築寄り:Embulk、Talend、Apache Airflow
- エンタープライズ型:大規模・高信頼環境で使われてきたInformatica
SaaS・マネージド型には、Azure Data FactoryやGoogle Cloud Dataflowもあります。
豊富なコネクタを使えば、SaaSやデータベースへ短期間で接続でき、インフラの管理も事業者に任せられます。
dbtは、ELTの「T(変換)」をSQLで管理し、バージョン管理やテストを行いやすくします。OSS・自前構築型は、ライセンス費用がかからない反面、実行基盤の構築・運用とエンジニアの工数が必要です。
正確な料金や機能は改定されることがあるため、導入時には各社の公式情報を確認してください。
ETLツール導入の開発期間の目安(規模別)
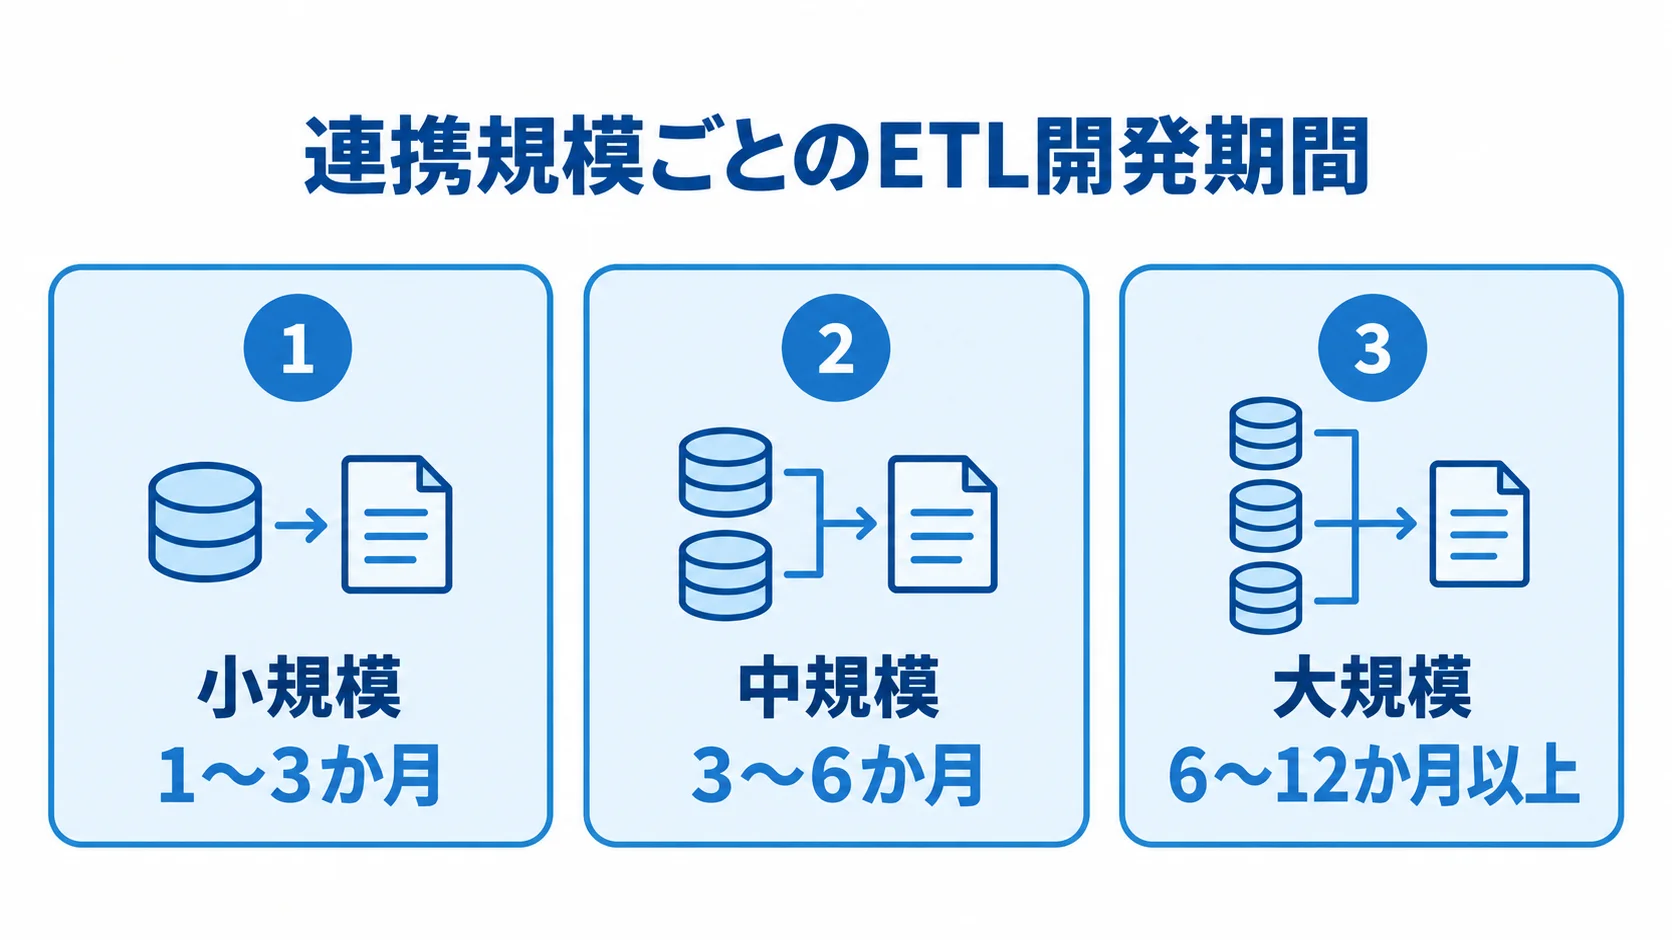
期間は、連携するソース数、変換ロジックの複雑さ、投入先の分析基盤の規模で大きく変わります。元データの品質や既存システムの状況によっても、前後します。
連携の範囲が広がるほど期間も延びるため、規模ごとの目安を並べて比べます。
- 小規模:単一ソース連携で1〜3か月
- 中規模:複数ソース統合で3〜6か月
- 大規模:全社基盤で6〜12か月以上
小規模:単一ソース連携(1〜3か月)
小規模では、単一のデータソースからDWHやデータベースへ定期的に連携します。対象は、基幹システムの1テーブルや1つのSaaSなどです。
- 対象を絞る:営業部の月次レポートに必要なデータなど
- 変換を限定する:基本集計や表記統一にとどめ、複雑なロジックは後回しにする
- 標準コネクタを使う:SaaS型ツールに用意された接続機能を利用する
標準コネクタで接続できる場合、本稼働まで1〜3か月程度で到達できることがあります。また、MVP(最小構成)レベルの費用は、100万〜300万円程度が目安です。
短期間でデータが流れ、分析に使える状態を体験できます。そこで得た知見は、中規模以降の拡張設計に生かせます。
全社の理想形を一度に目指すより、まず1つのデータの流れを通すほうが、結果として近道になります。
中規模:複数ソース統合(3〜6か月)
中規模では、複数のソースを統合し、部門横断で使う分析基盤へデータを供給します。基幹の受発注、CRMの顧客、広告媒体の実績をDWHに集める例があります。
- マスタを整合する:顧客IDや商品コードを統一する
- 更新差を吸収する:ソースごとのタイミングのズレに対応する
- 増分更新を実装する:前回以降に変わったデータを取り込む
顧客IDや商品IDで名寄せして統合するため、変換ロジックは複雑になります。期間は3〜6か月、費用は300万〜1,500万円程度が目安です。
全ソースを一度につなぐより、優先度の高いソースから順に追加するほうが現実的です。1つずつ価値を確かめながら広げれば、手戻りを抑えて基盤を育てられます。
大規模:全社データ基盤(6〜12か月以上)
大規模では、多数のソースをリアルタイムに近い頻度で統合し、AI・機械学習の前処理も見据えたパイプラインを構築します。データソースが数十に及ぶこともあります。
- 接続と変換:多数のソースに対応する
- 品質と監視:品質チェックと監視を設計する
- 障害対応:障害時のリカバリまで用意する
期間は6〜12か月以上です。特に、AI活用を含む全社基盤では、費用が1,000万〜5,000万円以上に達することもあります。
最初から完成形を作ろうとすると、費用と時間が膨らみ続けます。そのため、後述するMVPと段階的なロールアウトが欠かせません。
経営層の関心が高い1〜2のユースケースから始め、Phase1で成果を出します。そのうえで、対象データや変換の高度化を段階的に広げていきます。
全社基盤ほど、初期に作り込みすぎず、価値を出しながら育てる設計が求められます。
要件定義から運用開始までの工程とスケジュール
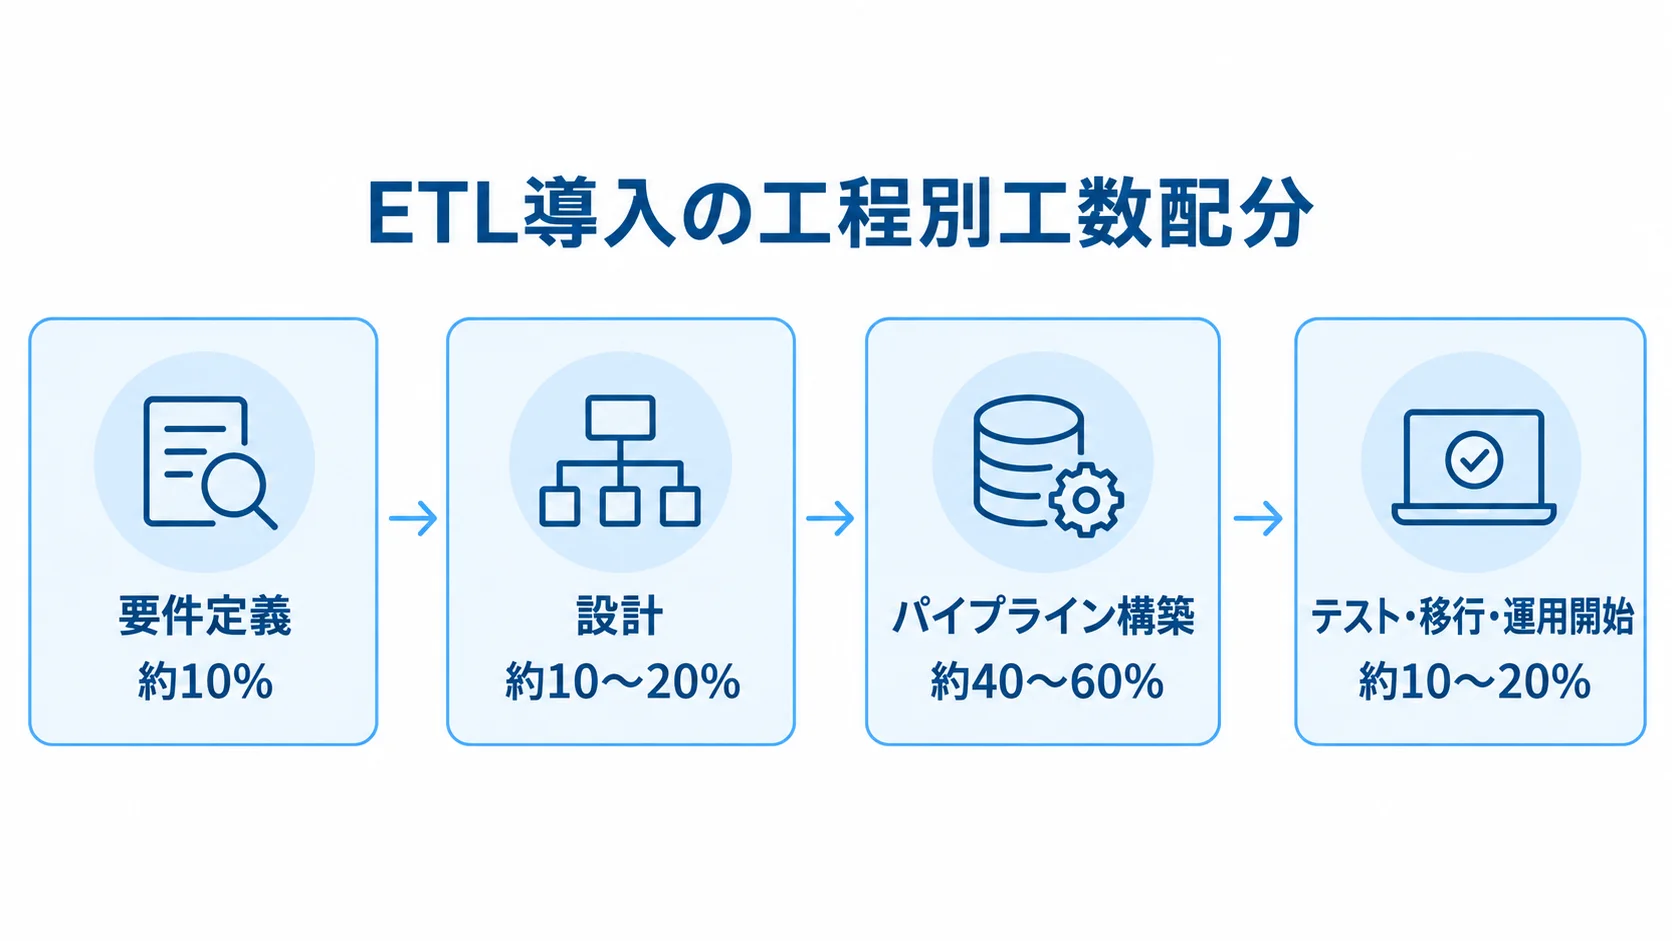
ETL導入は、要件定義、設計、構築、テスト・運用開始の4段階で進めます。各工程の期間や工数を把握しておくと、現実的な予定を組めます。
工程ごとの要点と、スプリントによる進め方を順に説明します。
4つのフェーズと工程別の工数配分
工程ごとの工数配分には、次の目安があります。中心となる構築では、データの抽出・変換・ロードを担うパイプラインを実装し、要件定義やテストにも期間を確保します。
- 要件定義:全体の約10%
- 設計:約10〜20%
- パイプライン構築:約40〜60%
- テスト・移行・運用開始:約10〜20%
要件定義では、発注側と開発会社が、対象業務、データ、連携頻度、連携先を決めます。ここが曖昧なまま進むと、後工程で仕様変更が多発し、期間が大きく延びてしまいます。
設計では、開発会社がソースごとの接続方式と変換ロジックを固めます。そのうえで、DWHのスキーマや増分更新、エラー時のリトライの扱いを決めます。
構築では、コネクタを設定して変換処理を実装し、スケジュールを組みます。テストでは、元データと連携後の件数や金額を突合します。
ETLは、見た目にエラーがなくても数値がずれることがあります。そのため、突合を軽視すると、本番で数字が合わない問題につながります。
各工程の期間は、要件定義が2週間〜1か月、設計が2〜4週間、構築が1〜3か月、テストが2〜4週間を目安に組みます。
スプリントによる段階的な進め方
構築は、2週間〜1か月単位のスプリント(短い開発サイクル)に区切り、アジャイルに進める方法が有効です。
全ソースをウォーターフォール型で一気に作ると、最後のテストで不具合が噴き出し、期間を見通しにくくなることがあります。
- 1つのデータソースを連携し、DWHへデータを流す
- 分析に使える状態まで仕上げる
- 作ったものを確認し、次の連携へ進む
各スプリントで動くものを確かめられるため、早い段階で軌道修正できます。
価値の高い1〜2のユースケースをPhase1(MVP)として3〜6か月で実現し、その後に対象データや変換を高度化する全体戦略にもつながります。
小さく作って動かし、確認してから広げるリズムなら、期間を現実的に管理できます。また、途中で優先順位が変わった場合にも、柔軟に対応できます。
開発期間を短縮する仕組みと手法
進め方とツール選定を工夫すれば、ETL導入の開発期間を大きく短縮できます。「作らずに済むものは作らない」という視点も重要です。
期間を短縮する手法は、ツールの使い方と、MVPから始める進め方に分けて説明します。
SaaS/マネージド型ツールによる実装工数の削減
自前のスクリプトで全てを構築すると、接続処理、認証、エラー処理、リトライ、実行基盤の管理まで、コードを書いて維持する必要があります。
- 標準コネクタ:主要なデータソースへ接続する
- 運用委任:実行基盤の管理を事業者に任せる
- 個別実装:標準対応外の連携だけ自前で作る
trocco、Fivetran、AWS Glueなどを使えば、対応するソースならコネクタを選ぶだけで接続できます。既存のツールを活用して車輪の再発明を避ければ、コーディングの工数を大きく減らせます。
SaaSやクラウドサービスでは、公式コネクタの有無によって実装工数が数倍変わることもあります。特に、要件定義の段階で、必要なソースに標準対応があるかを確認しておくと安心です。
標準コネクタのないマイナーなシステムは自前で実装する必要があり、工数がかさみます。ただし、その部分だけを個別に開発し、ほかはツールに任せる設計が現実的です。
MVP志向とスモールスタート
期間を縮める方法として、スコープを絞ったMVPから始めることがあります。全社の全ソースを網羅しようとすると、費用も時間も膨らみます。
- ユースケースを絞る:関心の高い1〜2件から着手する
- 段階的に構築する:単一ソースから立ち上げる
- 基盤を育てる:事業やデータ量に合わせて移行する
対象を絞り、3〜6か月で早期の成果を目指します。データ量が数テラバイト未満で、複雑なAI活用をまだ想定しない初期段階なら、高価なDWHや大規模な基盤は過剰になりがちです。
たとえば、既存データベースのPostgreSQL参照用レプリカなどを使えば、月額数千円〜数万円程度の固定費で、小さく分析基盤を始められます。
事業やデータ量の成長に応じてDWHへ移行すれば、キャッシュアウトを抑えながら進められます。
最初から全体をつなぎ込まず、まず1本の流れを通して価値を確かめます。必要に応じて増やしていく進め方が、最短で成果に届く道筋です。
納期遅延の典型要因と対策
ETL導入では、当初の見積もりを超える典型的な遅延要因があります。対策を計画に含めておくと、納期を守れる可能性が高まります。
データ品質・前処理の見積もり漏れ
現場のデータは、分析向けに整っていないことが多くあります。品質の問題や前処理の工数が見積もりから漏れると、遅延の原因になります。
- 実データを確認:要件定義の早い段階でサンプルを取り寄せ、汚れ具合を確かめる
- マスタを統一:顧客IDや商品IDの対応表を整える
- 検査方針を設計:欠損・重複・異常値をどう扱うかを決める
表記揺れや重複、欠損、部門ごとに異なるコード体系が重なると、名寄せとクレンジングだけで半年かかる事態も珍しくありません。
前処理は見積もりに含めにくく、ETL工数の大部分を占めることもあります。軽視すると計画が崩れるため、現実的な見積もりが欠かせません。
データの状態を把握しないまま「とりあえず3か月」と約束すると、計画は破綻します。実データを早く確認することが不可欠です。
スコープの膨張とテスト工数の不足
遅延につながるほかの要因は、追加要望によるスコープの膨張と、テスト工数の不足です。対策では、変更の扱い方と検証にかける時間を、あらかじめ明確にします。
- 変更を管理する:影響調査、見積もり、承認、実施の順で扱う
- 優先度を共有する:低い要望は早めに示し、Phase2以降へ回す
- 突合を続ける:元データとの件数・金額を早くから検証する
進行するにつれて「あのデータも連携したい」「この変換も追加したい」と要望が重なり、当初の範囲を超えて膨らむことがあります。
対策の基本は、変更管理の手順を最初に合意しておくことです。口頭での小さな追加によって納期が圧迫されるのを防ぎます。
パイプラインがエラーなく動いても、連携後の件数や金額が元データと一致するとは限りません。期間別やセグメント別まで突合すると、想定以上の工数がかかります。
十分なテスト期間を確保し、件数や金額の一致を継続して確かめます。そうすると、リリース直前の手戻りを防ぎ、納期を守りやすくなります。
まとめ
ETLツール導入/構築の開発期間・スケジュール・納期を、基盤での位置づけ、規模別の目安、工程、短縮策、遅延要因と対策の順に整理しました。
ETLはデータを抽出・変換してDWHへ投入し、BIの分析データを支えます。DWHが保管場所を用意し、ETLはデータの流れを設計・実装します。
- 期間の目安:小規模1〜3か月、中規模3〜6か月、大規模6〜12か月以上
- 工数配分:要件定義約10%、設計約10〜20%、構築約40〜60%、テスト等約10〜20%
- 短縮策:マネージド型ツール、MVP、段階的なスプリントを活用
- 遅延要因:前処理の見積もり漏れ、スコープ膨張、数値検証の工数不足
小規模は単一ソース、中規模は複数ソース、大規模は全社基盤という違いがあり、構築範囲に応じて期間が変わります。
工程期間の目安は、要件定義2週間〜1か月、設計2〜4週間、構築1〜3か月、テスト2〜4週間です。工程ごとに確認を挟むと、計画と実態のずれを早めに捉えられます。
ツールで実装工数を抑え、1〜2ユースケースのMVPから始める進め方が有効です。また、2週間〜1か月のスプリントで段階的に拡張できます。
実データを早期に確認し、変更管理を整え、テスト期間も十分に確保します。こうした準備が納期遵守の鍵です。
▼全体ガイドの記事
・ETLツール導入/構築の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。