
Google BigQuery導入の期間は、小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上が目安です。
要件を定め、データ基盤を設計・構築したうえで、テストと段階的な運用開始へ進めると、現実的な納期につながります。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Google BigQuery導入の開発期間の全体像
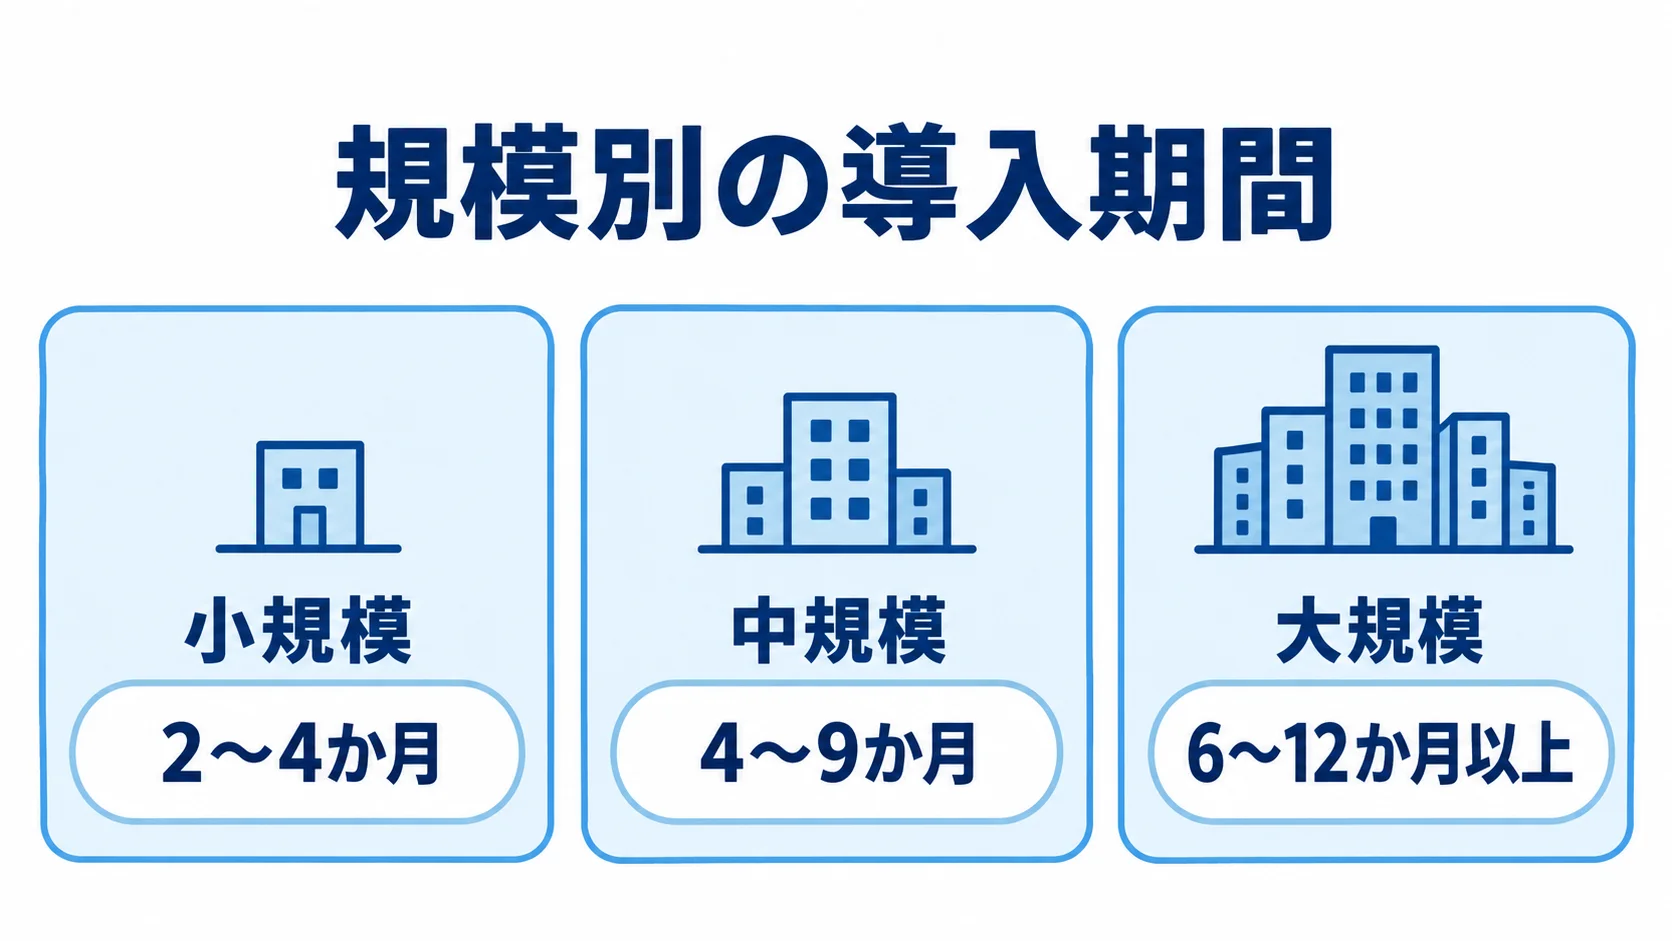
導入期間は、データ量、既存システムとの連携数、分析要件の複雑さによって変わります。そこで、まず規模ごとの目安を押さえておくと、計画の見通しが立ちます。
DWH導入で失敗しやすいのは、全社のデータと分析を一度に網羅しようとする進め方です。こうした進め方では期間が長期化し、プロジェクトの頓挫を招くおそれがあります。
事業課題に直結する1〜2のユースケースに絞り、3〜6か月で成果を出すMVP(実用最小限の製品)型が推奨されます。実際の導入事例では、EC企業が売上分析の1つに絞り、3か月でMVPを構築しました。
BigQueryはサーバーレスのフルマネージドサービスのため、エンジン構築やサーバー調達の工数がほぼ要りません。その分、期間の多くをデータ移行・加工・モデリング・可視化に充てられます。この特性を踏まえることが、導入納期を見積もる土台になります。
規模別の導入期間と費用の目安
規模別の期間と初期費用は、連携するデータや分析基盤の範囲によって変わります。自社のプロジェクトがどの規模に近いかを見て、下の目安と照らし合わせてください。
- 小規模:単一データソースと基本ダッシュボード
- 中規模:複数ソース統合と部門横断の分析基盤
- 大規模:全社基盤とAI・機械学習の前処理
小規模は、単一の業務システムのデータを集めて売上や在庫などを分析する規模で、期間は2〜4か月、初期費用は100万〜300万円程度です。サンドボックスや無料枠ですぐに試せるうえ、Fivetranなどのマネージド型SaaSコネクターで連携を簡素化でき、短期間で立ち上げられます。
中規模は、基幹システム・SaaS・ログを統合し、部門横断のKPIや権限管理を備える規模です。期間は4〜9か月、初期費用は300万〜1,500万円程度です。
中心となる工程は、データモデル、ETL/ELT、複数のダッシュボードです。体制は、データエンジニア、BIエンジニア、プロジェクトマネージャーの編成が標準です。
大規模は、Cloud StorageのデータレイクやBigQuery MLを含む全社基盤です。期間は6〜12か月以上、初期費用は1,500万〜5,000万円以上に及びます。
性能設計、厳格なデータガバナンス、段階的な全社展開が必要で、期間の見積もりには十分な余裕を含めます。
どの規模でも、費用はクラウド利用料より設計・開発の人件費が中心です。その理由は、BigQueryがインフラを持たないためです。
導入期間を左右する変数
同じ中規模でも、期間は4か月で済む場合と9か月かかる場合があります。その差を生む変数を要件定義の段階で洗い出すと、納期を見積もりやすくなります。
- データ品質:表記ゆれ、重複、欠損と前処理の量
- 連携先と方式:移行元の数、標準コネクターの有無
- 分析要件:レポート、ドリルダウン、予測モデルの複雑さ
- 利用者と運用:クエリ作成、保守、教育の体制
特に元データが整っていない場合は、名寄せやクレンジングだけで数か月かかることがあります。「明日からデータ活用」という理想に反して、前処理がプロジェクト期間の大部分を占めるケースもあります。
もう一つは、移行元システムの数と連携方式です。連携元が1つか、基幹システム・複数SaaS・IoTログを統合するかで、ETL/ELTの設計・実装・テスト工数が異なります。さらに、Data Transfer ServiceやFivetranの標準コネクターがあるかどうかも、期間を左右します。
分析要件は、定型レポートだけで済むか、部門別指標やドリルダウン、BigQuery MLの予測モデルまで必要かで、モデルやBIの作り込みの量が異なります。利用者のスキルと運用体制も、期間を左右する要素です。Connected Sheetsで非エンジニアも扱いやすい一方、クエリを書く人や保守する人によって、教育や文書整備の期間が変わります。
工程別のスケジュールと期間配分
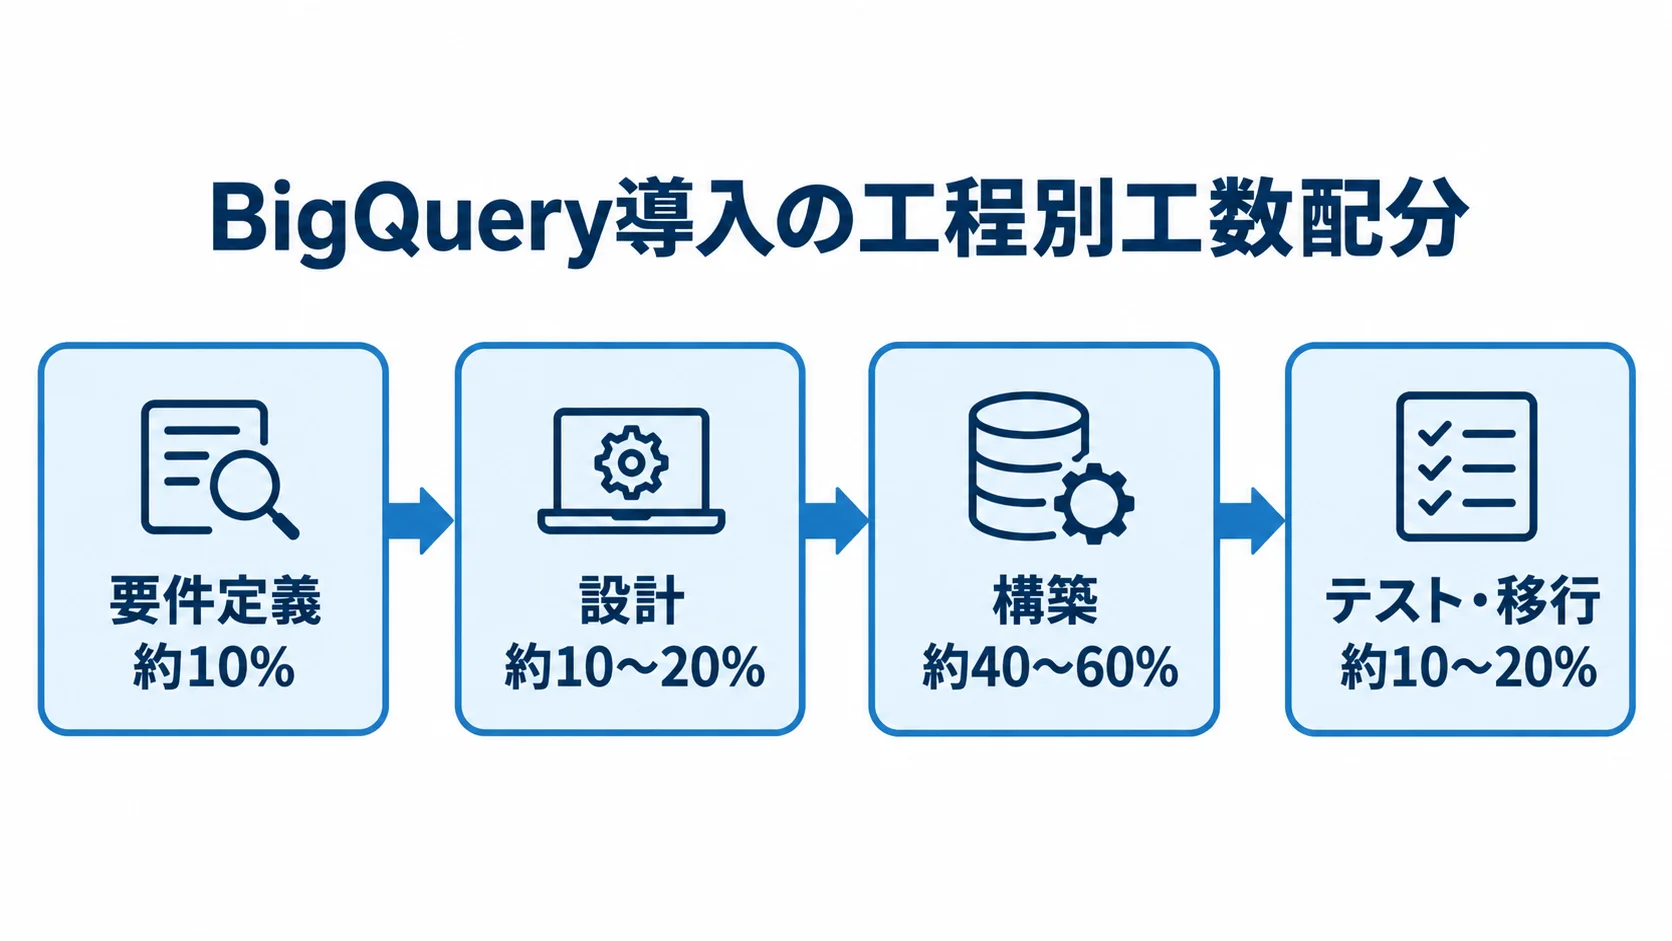
全体は3つのフェーズに分けて考えると、期間の配分を見通しやすくなります。一般的な工数配分は、要件定義が約10%、設計が約10〜20%、構築が約40〜60%、テスト・移行が約10〜20%です。中でも開発(構築)が最も工数の大きい山場です。
6か月(約26週)の中規模案件なら、要件定義は約2〜3週、設計は約4〜5週です。構築には約13〜15週、テスト・移行・運用開始には約4〜5週を割り当てます。
BigQueryでは、サイジングやノード設計、インフラ構築がほぼ不要です。そのぶん、データの粒度や可視化する指標の設計に時間を振り向けられます。
上流のデータ設計とKPI設計は、構築工数やダッシュボードの実用性を左右します。そのため、上流に時間を確保することが、納期を守ることにつながります。
要件定義・技術選定フェーズ(全体の約10%)
要件定義・技術選定は、BigQuery導入の成否を左右する重要な工程です。技術を先に決めて「話題だからBigQueryで作る」としてしまうと失敗につながるため、まず、解決したい事業課題から逆算して分析範囲とKPIを定めます。
- 業務とデータ:KPI、分析要件、データソース、発生量、更新頻度
- 料金モデル:オンデマンドかEditionsの容量ベースか
- 利用ツール:データレイク、ETL/ELT、BIの役割と製品
BigQuery自体の製品選定はシンプルです。コンピュート課金は、オンデマンド(従量課金)かBigQuery Editions(スロットの容量ベース課金)かを決めます。そのとき判断材料になるのは、想定するクエリ量、利用パターン、予算の固定度合いです。
たとえば、断続的な利用や利用量が読めない初期段階では、オンデマンドが適しています。一方で、利用が安定して大量になり、予算を固定したい運用期は、Editionsの容量予約が向いています。
Cloud Storageとの役割分担も決めます。ETL/ELTは、Dataflow・Dataform・dbt・Fivetranなどから選びます。
BIは、LookerやLooker Studio、Tableauなどを検討します。Power BIやConnected Sheetsも候補になります。
決めた方針は文書に残しておくと、後工程での手戻りを防げます。このフェーズの期間は、1〜3週間が目安です。
設計・構築フェーズ(全体の約50〜70%)
設計・構築は全体の5〜7割を占める工程で、データ設計から連携・可視化までを進めます。
- 設計:データモデル、テーブル、KPI、ダッシュボード、権限
- 構築:テーブル、ETL/ELT、初期・差分連携、BI接続
- 開発運用:短期スプリント、コード管理、レビューとテスト
分析向けのデータモデルでは、スタースキーマやディメンショナルモデルを定義します。BigQuery固有の設計として、パーティション分割やクラスタリングも決めます。
パーティションとクラスタリングは、クエリコストと性能に直結します。丁寧に設計すれば、運用コストも抑えられます。
権限はIAMを使い、データセット・列・行の各レベルで設定します。
構築では、データセットとテーブルを作ったうえで、パイプライン、初期ロード、差分連携を実装します。BIツールとの接続やダッシュボードの開発も行います。
サーバーのプロビジョニング、パッチ、バックアップ、スケーリングはGoogle Cloudが担います。そのため、開発チームは加工ロジックとモデリングに集中できます。
開発は、2週間〜1か月単位でスプリントを組み、作ったものを定期的に確認しながら進めるアジャイル開発が適しています。中規模では13〜16週程度を見込みます。
SQLのビューやDataform・dbtのELTでは、変換ロジックをコードで管理します。レビューとテストを組み込むと、品質を確保できます。
テスト・移行・運用開始フェーズ(全体の約10〜20%)
構築したBigQuery分析基盤が要件を満たし、集計結果が正確かどうかを検証してから、本番運用へ移します。
- 数値検証:既存帳票やシステムとの集計値の照合
- コストと権限:スキャン量、最適化、アクセス制御
- 移行と定着:UAT、段階運用、研修、問い合わせ窓口
集計ロジックや連携の欠損によって数値がずれると、意思決定を誤らせるおそれがあります。既存の帳票や現行システムとの照合には、見た目の実装以上に工数がかかることもあります。
BigQuery特有の観点として、クエリコストのテストも欠かせません。各クエリのスキャン量を見積もり、パーティションやクラスタリングで抑えられるかを確かめます。
権限設定が意図どおりかもテストします。テスト後は、ユーザー受け入れテスト(UAT)を行います。全部門へ一斉に広げず、一部門やユースケースから運用を始めます。
パイロット部門では、利用者のフィードバックを集めて、データモデルやダッシュボードを継続的に改善します。また、操作研修や問い合わせ窓口の整備も行います。このフェーズは3〜5週程度が目安です。
BigQueryならではの期間短縮の仕組み
オンプレミスやフルスクラッチ、他のクラウドDWHと比べても、BigQueryは導入期間を短縮しやすいサービスです。エンジンとインフラ全体をGoogle Cloudが管理します。期間を支える仕組みは、インフラを用意しなくてよいサーバーレスと、すぐ検証を始められるサンドボックスやオンデマンド課金の2つです。
サーバーの調達・構築やOS・ミドルウェアの導入が不要です。パッチやバックアップ、冗長化も必要ありません。加えて、クラスターのサイジングや拡張も要らず、本来は数週間から数か月かかる作業そのものがないことが、サーバーレスの本質です。
サーバーレスによるインフラ構築工数のゼロ化
Amazon RedshiftやAzure Synapse Analyticsでは、ノードや専用プールのサイジング、クラスター構築、ネットワーク設定が必要です。こうした作業が、設計・構築期間を占めます。
BigQueryでは、インフラ構築の工程そのものがなくなります。起動したままにしておくクラスターという概念も、基本的にありません。
- クラスター管理が不要:標準SQLの実行に合わせて計算資源を割り当て
- 自動スケール:負荷に応じた処理能力の調整
- 段階的な分析:データ蓄積後に分析を順次追加
BigQueryでは、プロジェクト、データセット、テーブルを用意すれば利用を始められます。アクセス増加時のノード増設や、夜間バッチ向けの拡張設計も原則として不要です。
他のDWHでは設計・構築の一部を占めるインフラ工数が、BigQueryではほぼゼロになります。そのぶん、その時間をデータ設計や可視化に回せます。
ストレージと計算処理は分離されています。そのため、データを保存するだけならクエリの計算課金は発生せず、蓄積してから分析を段階的に組み立てられます。
サンドボックスとオンデマンド課金による即時検証
サンドボックスと無料利用枠を使えば、初期の検証にすぐ取りかかれます。課金設定をせずに試せる範囲もあります。
- サンドボックス:一部機能に制限があるが、すぐに利用可能
- 無料枠:毎月のクエリ処理とストレージの一定量
- オンデマンド課金:スキャンしたデータ量に応じた従量制
サンドボックスは、クレジットカード登録や課金設定なしで開始でき、初日から実データの検証を進められます。公式の無料枠には、毎月のクエリ処理(一般的に1TiBのスキャン相当)とストレージ(一般的に10GiB相当)が含まれます。
そのため、小規模なPoCであれば、実質的に費用をかけずに試せる場合があります。無料枠の詳細は、公式料金ページで最新情報を確認してください。
利用量の少ない検証であれば、使った分だけの少額で済み、大きなリソースの予約も要りません。即時起動と従量課金は、PoC(概念実証)やプロトタイピングに適しています。
要件定義と並行して実データを検証でき、全体のリードタイムを短縮できます。インフラ構築や運用設計を省けるため、初期投資ゼロで検証を始められる点が、納期短縮の核心です。
BigQuery導入で納期を短縮する具体的な方法
サーバーレスの利点に加えて、進め方を工夫すれば、BigQuery導入の納期をさらに短縮できます。
まず、範囲を絞るMVPの進め方が効果的です。そのうえで、SaaSコネクターやアジャイル開発、段階的な展開も取り入れられます。
1〜2ユースケースに絞ったMVPアプローチ
最初のリリース範囲を絞ることは、納期短縮に効果的です。全社のデータを一度に扱うと、要件や連携先が増え、合意形成にも時間がかかります。範囲が膨らむと、本番稼働にたどり着けないおそれもあります。
- 課題を選ぶ:成果や現場への影響が大きいテーマ
- 範囲を絞る:1〜2のユースケースでPhase 1を構築
- 段階的に広げる:MVPの成果を次の拡張につなげる
たとえば、月次の売上・粗利を商品・店舗軸で可視化するなど、意思決定に直結するテーマを選びます。先述のEC企業のように1つに絞れば、3か月程度でMVPを立ち上げられる場合があります。
範囲を絞るとデータソースが限られ、モデルも簡素になるため、短期間で成果が見えます。その成功体験は、社内の理解や予算につながり、Phase 2以降を進めやすくします。
全社基盤を最初から完璧に作るより、小さく作って早く価値を出し、育てていく考え方が最短ルートです。また、従量課金かつサーバーレスなので、基盤を広げてもMVPの資産を作り直す必要はありません。
SaaSコネクター活用とアジャイル・段階的ロールアウト
データ連携を自社で一から作ることを避け、開発を短いサイクルで進めることも、納期短縮の柱です。
ETL/ELTは、各業務システムやSaaSからBigQueryへデータを取り込む工程で、データ分析基盤の構築では意外に工数がかかる部分です。
- 連携:Data Transfer Serviceや管理型コネクターを使う
- 開発:2週間〜1か月のスプリントで反復する
- 本番展開:パイロット部門から段階的に広げる
API連携をゼロから自社で開発すると工数がかかり、接続先の仕様変更への対応も必要になります。一方で、Data Transfer Service、Fivetran、troccoなどを使えば、主要SaaSやデータベースとの連携をノーコードに近い形で構築できます。連携を管理型ツールに任せれば、チームは分析ロジックやダッシュボードに集中でき、構築期間を圧縮できます。
短いスプリントでは、指標定義のずれを早く見つけて修正できます。さらに、データ取込、集計、可視化、フィードバックを繰り返すことで、後工程の大きな作り直しを防げます。
展開は、まず一部のパイロット部門から始めます。運用上の問題やデータの不整合を確かめながら対象を広げると、リスクを抑えて定着させられます。段階展開は一見遠回りに見えますが、大きな手戻りや運用トラブルによる遅延を防ぎ、全体の納期を守る現実的な方法です。
納期遅延の典型要因と対策
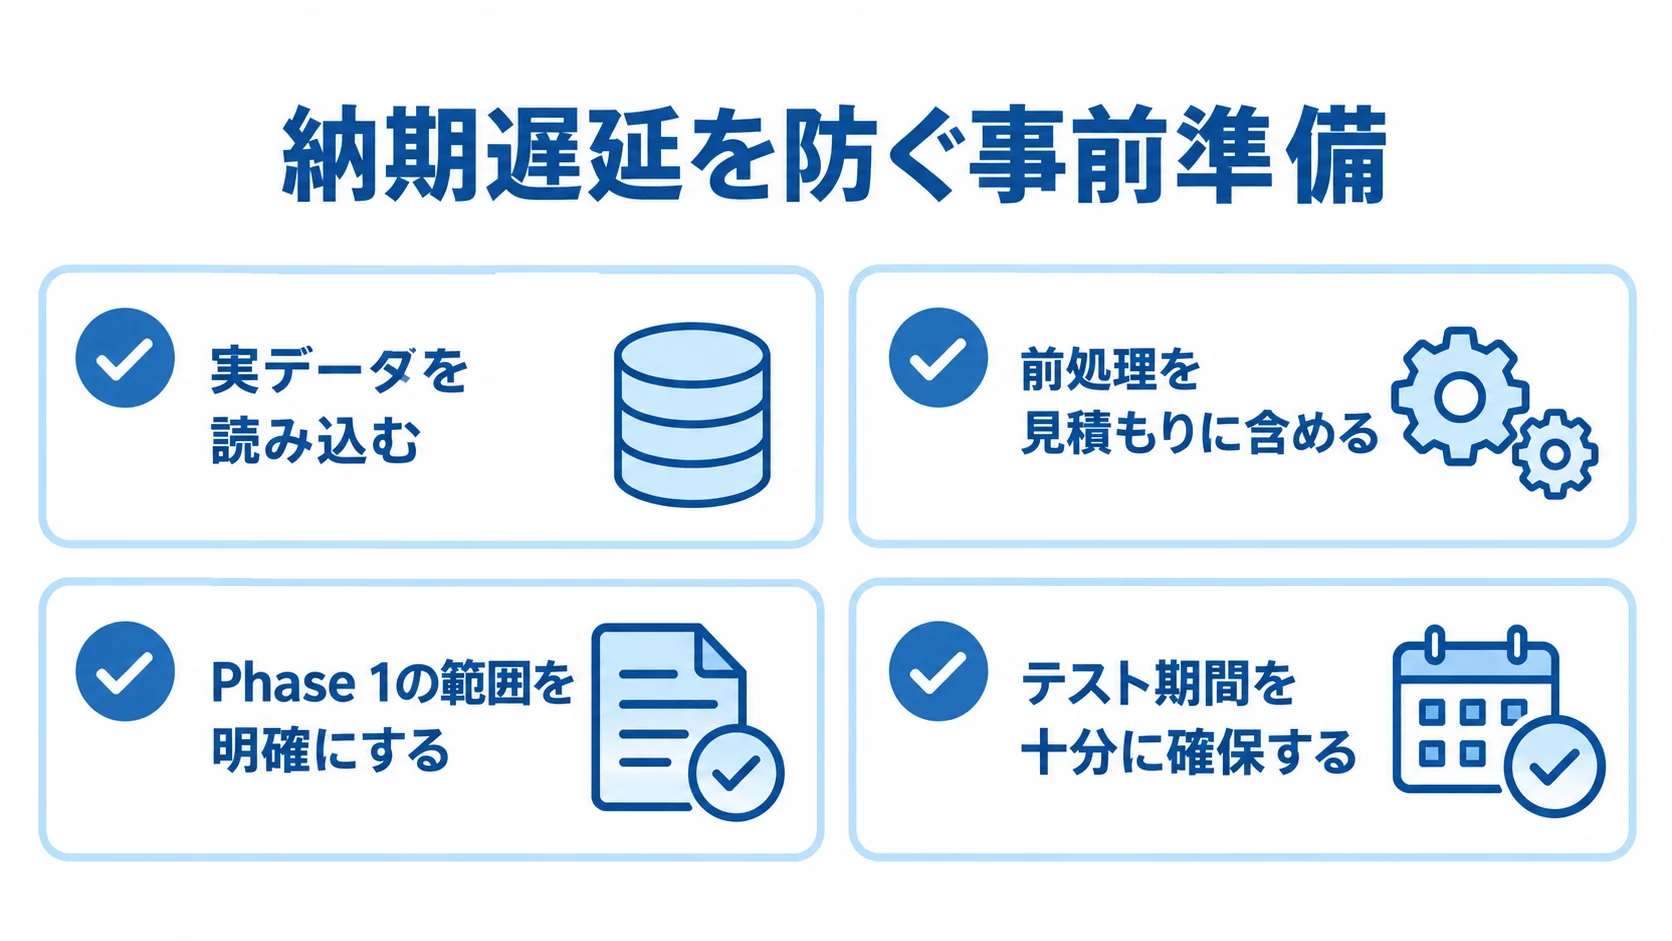
BigQueryはサーバーレスの構造で納期短縮に役立つ一方、DWH導入には特有の遅延リスクもあります。
特に発生頻度が高いのは、データ品質・前処理の見積もり漏れと、スコープの拡大や数値検証の工数です。事前に備えておくと、計画の破綻を防げます。
データ品質・前処理の見積もり漏れ
元データの品質問題は、BigQuery導入で多い遅延要因です。インフラ構築が順調に進んでも、実データを取り込む段階で問題が見つかることがあります。
- 早期確認:要件定義で実データを読み込む
- 工数の計上:前処理を見積もりに含める
- 段階的な整備:優先ユースケースから対応する
表記ゆれ(同じ取引先が別名で登録されている等)や重複、欠損値、形式の不統一が、大量に見つかることもあります。名寄せやクレンジングだけで、数か月かかる場合もあります。データ整備は、プロジェクトの隠れた大きな山です。
立ち上げが速いぶん、前処理の工数が相対的に大きく見えることもあります。そこで、データが整っていると決めつけず、サンプルを読み込んで状態を把握しておきます。
完璧なマスターデータが整うのを待たず、優先ユースケースに必要な範囲から始めます。データ品質の改善は一度で終わらないためです。そのうえで、Dataformやdbtで変換・クレンジングのロジックをコード化し、継続的に運用・改善できる体制も設計します。
スコープの拡大と数値検証の工数
要件範囲の拡大や、数値検証の見積もり違いも遅延を招きます。そのため、変更管理とテスト期間の確保が必要です。
- 要望管理:追加要望の影響範囲と工数を見積もる
- 変更合意:Phase 1の境界を決め、追加分は後続へ
- 検証準備:サンプル、期待値、コスト想定を早めに用意
ダッシュボードができると、指標や切り口の追加要望が増えがちです。対象データやモデルで大きな手戻りが起きないよう、Phase 1の範囲を明確にしておきます。
追加要望は、影響範囲と工数を見積もってから合意し、Phase 2以降のバックログに記録します。最初のリリース範囲を動かさないことが大切です。
分析基盤では、見た目の実装以上に、集計値の正しさを確かめる作業に時間がかかります。現行の帳票やシステムと照合して、差異の原因が連携にあるのか、集計ロジックにあるのかを切り分けます。
BigQueryでは、クエリコストの検証も欠かせません。想定外に大量のデータを読み込むクエリを見つけて、パーティションやクラスタリングで抑えます。テスト期間を十分に確保しておくと、遅延リスクを小さくできます。
まとめ
Google BigQuery導入の期間の目安は、小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上です。工程ごとの配分を踏まえ、規模と要件に合わせて計画を立てます。
サーバーレスのためインフラ構築が要らず、データ設計や可視化に工数を充てられます。サンドボックスや無料枠を使えば、実データの検証にもすぐ着手できます。
1〜2ユースケースのMVP、コネクターによる連携、2週間〜1か月のスプリント、段階的な展開を組み合わせると、価値を確かめながら本番稼働を目指せます。
一方で、データ品質や前処理、スコープの拡大、数値・クエリコストの検証不足は遅延要因になります。実データの早期確認、変更管理、十分なテスト期間によって備えます。
判断軸を押さえたうえで、自社のデータ活用に合うスケジュールと体制を検討してください。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。