
BigQueryを使うフルスクラッチ・オーダーメイド開発は、マネージドなBigQueryを基盤にして、その上に自社固有のデータ連携や集計、ダッシュボードを作り込む形です。DWHエンジンを一から作るわけではありません。
PoCで効果を確かめてから範囲を決めれば、投資の無駄を防げます。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
BigQueryにおけるフルスクラッチ・オーダーメイドの正しい捉え方
一般にフルスクラッチ開発とは、システムをゼロから自作することを指します。しかし、データ分析基盤では、DWHエンジンやクラウドサーバー、ETLツールの基盤まで自作する意味ではありません。この言葉を文字どおりに受け取ると、大きな誤解を招きます。
これらのインフラは、BigQueryなどのクラウドサービスを利用料を支払って使うのが前提です。その利用料はシステム維持費にあたり、自社開発の対象ではありません。
BigQueryは、Googleが検索エンジンなどで培った分散処理技術を集めたサーバーレスDWHです。同等の基盤を自前で開発することは、潤沢な予算があっても現実的ではありません。
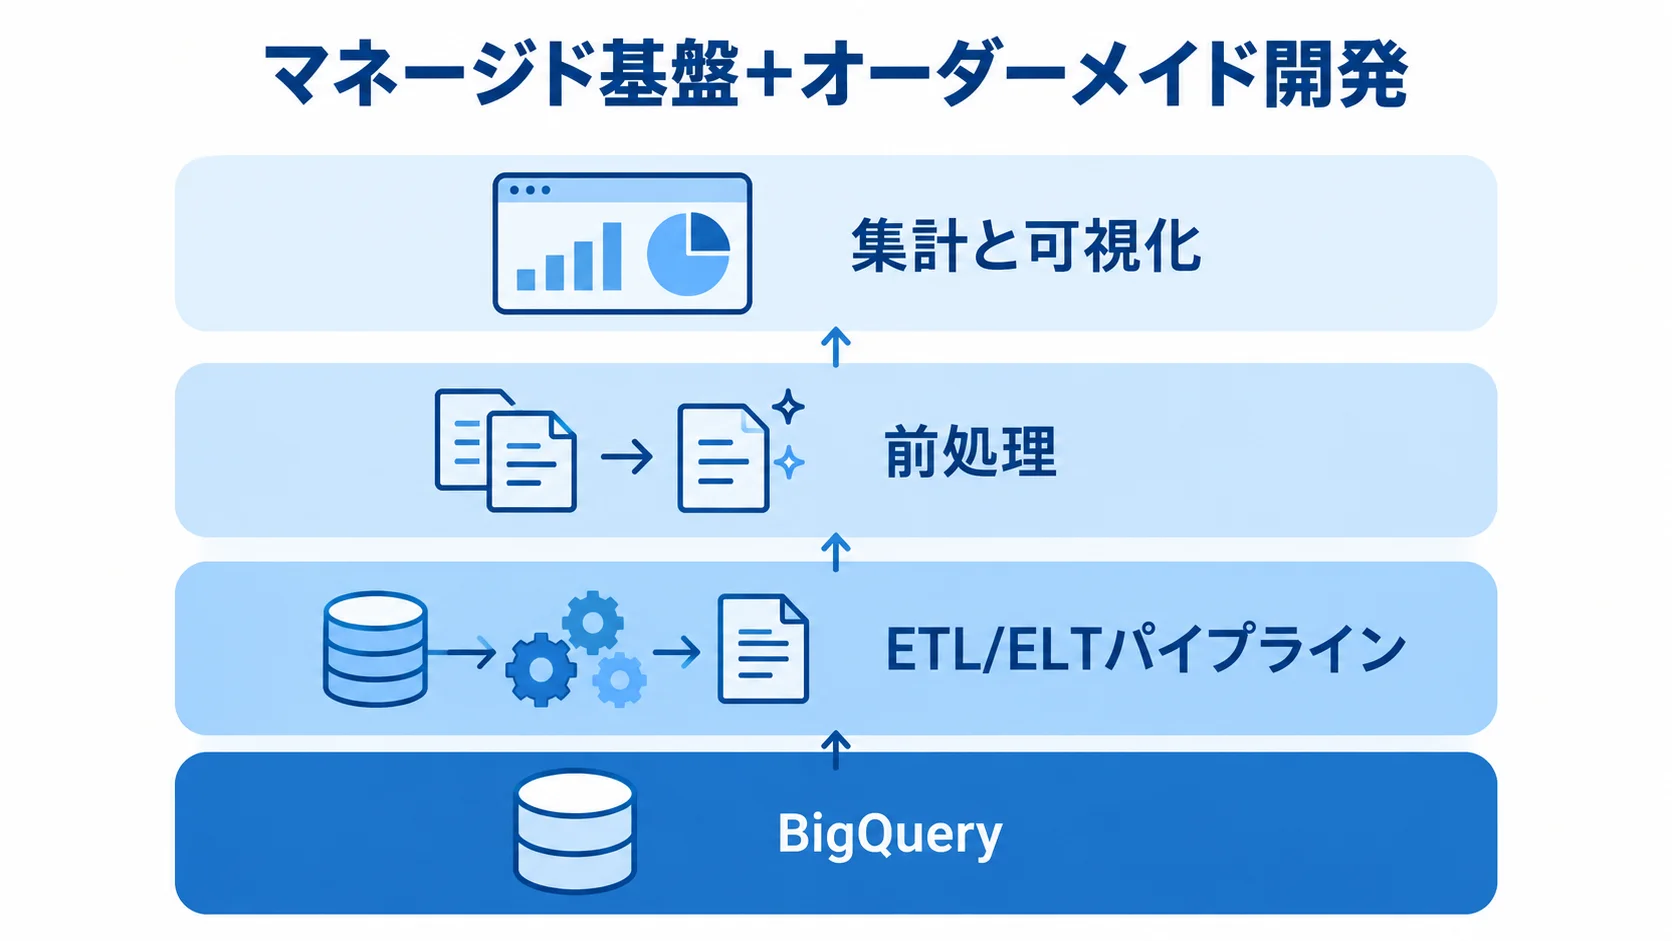
BigQueryを使うオーダーメイド開発では、完成した基盤の上に、自社固有のデータパイプラインや集計ロジックを構築します。ダッシュボードや分析アプリケーションも、作り込む対象です。
つまり「基盤は借り、その上を作り込む」構造です。この切り分けが、過剰な投資や実現しにくい計画を避ける出発点になります。
DWHエンジンの自作が非現実的な理由
DWHエンジンを自作するには、何が必要になるのでしょうか。まず、BigQueryがすでに統合している機能を確認します。
- 分散処理:ペタバイト級のデータを高速に分析するストレージと、大規模な並列クエリ処理エンジン。
- 運用機能:自動スケーリング、可用性や冗長性の担保、セキュリティ機能。
これらを自作するには膨大な費用と長い期間がかかり、完成後も継続的な保守や性能改善が必要です。そのため、総コストは非常に大きくなります。
Googleが世界規模で運用するBigQueryの性能や信頼性、機能を、自作のシステムが上回ることはまず期待できません。それは「車輪の再発明」にあたります。
基盤の自作に人手を割くと、本来は分析による価値創出に充てるべき人員が、基盤づくりに費やされてしまいます。BigQueryは月額のシステム維持費で使い、開発リソースは自社固有のデータ活用ロジックに集中させるのが賢明です。
BigQueryの登場以前は、DWH構築に多大なインフラ投資が必要でした。一方で、サーバーレスDWHの普及により、企業は基盤づくりの負担を減らし、分析そのものに集中できます。
「マネージド基盤+オーダーメイド開発」という現実解
現実的な進め方は、BigQueryをマネージド基盤として使い、その上に自社固有の部分を作り込む形です。BigQueryはDWHの中核機能を提供します。ただし、分析基盤として完結させるには、それ以外の部分も必要です。
業務システムやSaaSからのデータ収集、整形や統合、指標の可視化は、業務ごとに異なります。そのため、既製品だけでは実現できない部分を、オーダーメイドで作ります。
業務ごとに違う部分は、BigQuery上で次の3つの作業に分けて作り込みます。
- データ連携:ETL/ELTパイプラインの設計と実装。
- 前処理:データクレンジングや名寄せのルールづくり。
- 集計と可視化:KPIに合わせた集計ロジックやデータモデル、ダッシュボードの作成。
BigQueryはサーバーレスのため、開発チームはインフラよりもビジネスロジックとデータ設計に集中できます。基盤は任せ、差別化につながる分析ロジックに力を注ぐ考え方が、投資対効果を高める現実解です。
オーダーメイドで作り込む領域と既製品を活かす領域
費用を抑えつつ成果を出すには、自作する範囲と既製品に任せる範囲を分けることが重要です。何でも自作しようとすると、そのぶん費用が膨らみます。既製品を使えば、限られた予算や人手を価値の出る作業に振り向けられます。
オーダーメイドの主戦場:ETL/ELTと集計・可視化
費用の多くを占めるのは、データを集めて整える作業と、指標を作って見せる作業です。どちらも自社の業務に合わせた設計が欠かせません。
- ETL/ELT:データのBigQueryへの取り込み、分析しやすい形への整形・統合。
- データクレンジング:表記ゆれ、重複、欠損などを、自社データに合わせて処理。
- 集計と可視化:KPIの定義に沿った指標の算出と、業務に合ったダッシュボードの作成。
ETL/ELTでは、基幹システムやSaaS、ログデータなど複数の情報源を扱います。それぞれ発生時期や更新頻度、データ形式が違うため、その違いに合わせた実装が必要です。
開発費の一般的な40〜60%は、データエンジニアによるETL/ELTや前処理、集計ロジック、ダッシュボードの構築が占めます。企業ごとに事情が異なるため、この領域は既製品では賄いきれません。
データクレンジングでは、元データの品質に合わせてルールを作ります。集計ロジックでは、企業ごとに異なる売上計上の時期や按分方法を反映します。
ダッシュボードは、経営層や現場が見る指標、切り口、粒度に合わせて実装します。こうした部分に開発リソースを集中させることが、データ活用による差別化につながります。
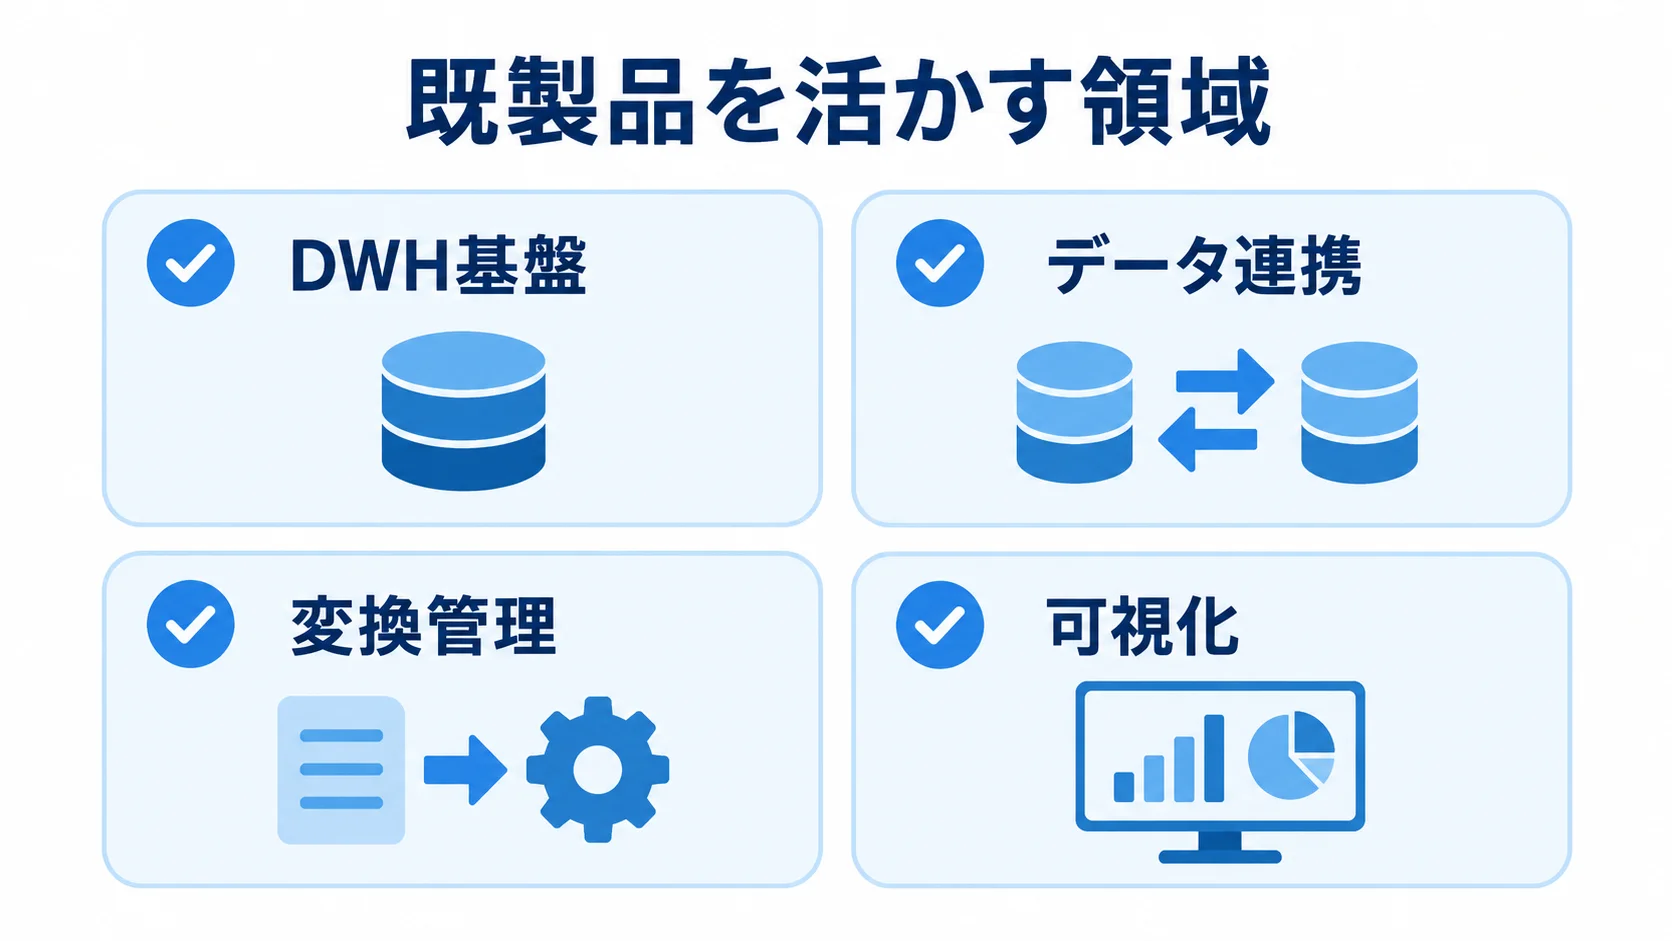
既製品を活かす領域:基盤・コネクター・BIツール
無理に自作せず、既製のサービスやツールを活用すべき領域もあります。自社固有のロジックに集中するため、共通の機能は既製品に任せます。
- DWH基盤:基盤そのものはBigQueryが担う。
- データ連携:ゼロから作らず、標準的な接続はマネージドコネクターに任せる。
- 変換管理:DataformやdbtによるSQL変換処理の管理。
- 可視化:既製のBIツールで、指標や見せ方を設定。
BigQuery Data Transfer Service、Fivetran、troccoなどは、主要なSaaSやデータベースに対応します。これらを使えば、ノーコードに近い形でデータを取り込めます。一方で、API連携を自作すると開発工数がかかり、接続先の仕様変更に追随する保守の負担も生じます。
Looker Studio、Looker、Tableau、Power BIには、ダッシュボードの土台が備わっています。そのため、自社はどの指標をどう見せるかの設定に注力できます。
基盤、連携、変換管理、可視化の土台は既製品に任せ、自社固有のロジックを作り込みます。そうすれば、費用を抑えながら価値を高められます。
フルスクラッチ開発の費用相場と期間
BigQueryを中核とする分析基盤をオーダーメイド開発するなら、費用と期間の目安を先に押さえておきたいところです。ここで示す金額は一般的な目安で、実際の見積もりは要件の詳細によって変動します。
規模別の費用相場と開発期間の目安
費用相場は、開発規模と複雑さによって幅があります。小規模か中規模か大規模かで、連携するデータの範囲と作り込む範囲が変わります。
- 小規模:単一データソースとの連携と、限定的なダッシュボードの構築。
- 中規模:複数の基幹システムやSaaSを統合し、部門横断のKPIや権限管理に対応。
- 大規模:複数部門で利用し、予測モデルや高度なデータ統合を含む。
小規模開発は100万〜300万円程度から始められ、中規模の分析基盤は300万〜1,500万円程度が目安です。大規模なフルスクラッチ開発は、1,500万〜3,000万円以上です。
複雑なケースでは1,000万円〜1億円以上に及ぶこともあります。大規模開発の期間は6か月〜2年程度が一般的です。規模が大きいほど要件が複雑になり、関係者も増えるため、期間と費用が増えます。
これらの開発費は、DWHエンジンの自作費用ではありません。BigQuery上に作るETL/ELTや集計ロジック、ダッシュボードなどの開発費です。費用の大部分は、それらを設計・実装するデータエンジニアやBIエンジニアの人件費です。
一方で、BigQueryの利用料は月額数万円〜数十万円ほどのランニングコストで、初期開発費とは性質が異なります。事前にPoCで要件を固めると、見積もりの精度が上がり、投資の無駄も防げます。
請負契約と準委任契約の違いと費用への影響
外部パートナーに委託する場合、契約形態が費用に影響します。請負契約と準委任契約には、それぞれ異なる特徴があります。
- 請負契約:決めた成果物の完成と納品を約束する契約。
- 準委任契約:作業時間や体制に対して費用が発生する契約。
請負契約は、仕様が明確で変更が少ない場合に向いています。予算の見通しを立てやすい一方で、仕様変更のたびに追加見積もりや再調整が必要になります。
開発側は納期や品質のリスクを費用に含めるため、請負は準委任の人月計算に対して、一般に1.3〜1.5倍程度になります。たとえば、準委任で500万円の想定なら、請負では650万〜750万円になる例があります。
準委任契約は、要件が実際にデータを見て初めて固まる分析基盤の開発に適しています。実データや分析結果を確認しながら、仕様や優先順位を変えやすいためです。
要件が固まっていない探索的な分析プロジェクトでは、柔軟に進められる準委任契約のほうが相性のよい場合があります。中規模以上のデータ活用では、準委任によるアジャイルな進め方が主流です。要件が明確な定型開発には請負、要件が流動的な分析基盤の構築には準委任と使い分けると、費用対効果を高められます。
フルスクラッチが本当に選ばれるべき基準
現実解は、BigQueryの基盤の上に独自部分を作ることです。深い作り込みが正当化される条件と、避けたい失敗を、あわせて押さえておきたいところです。
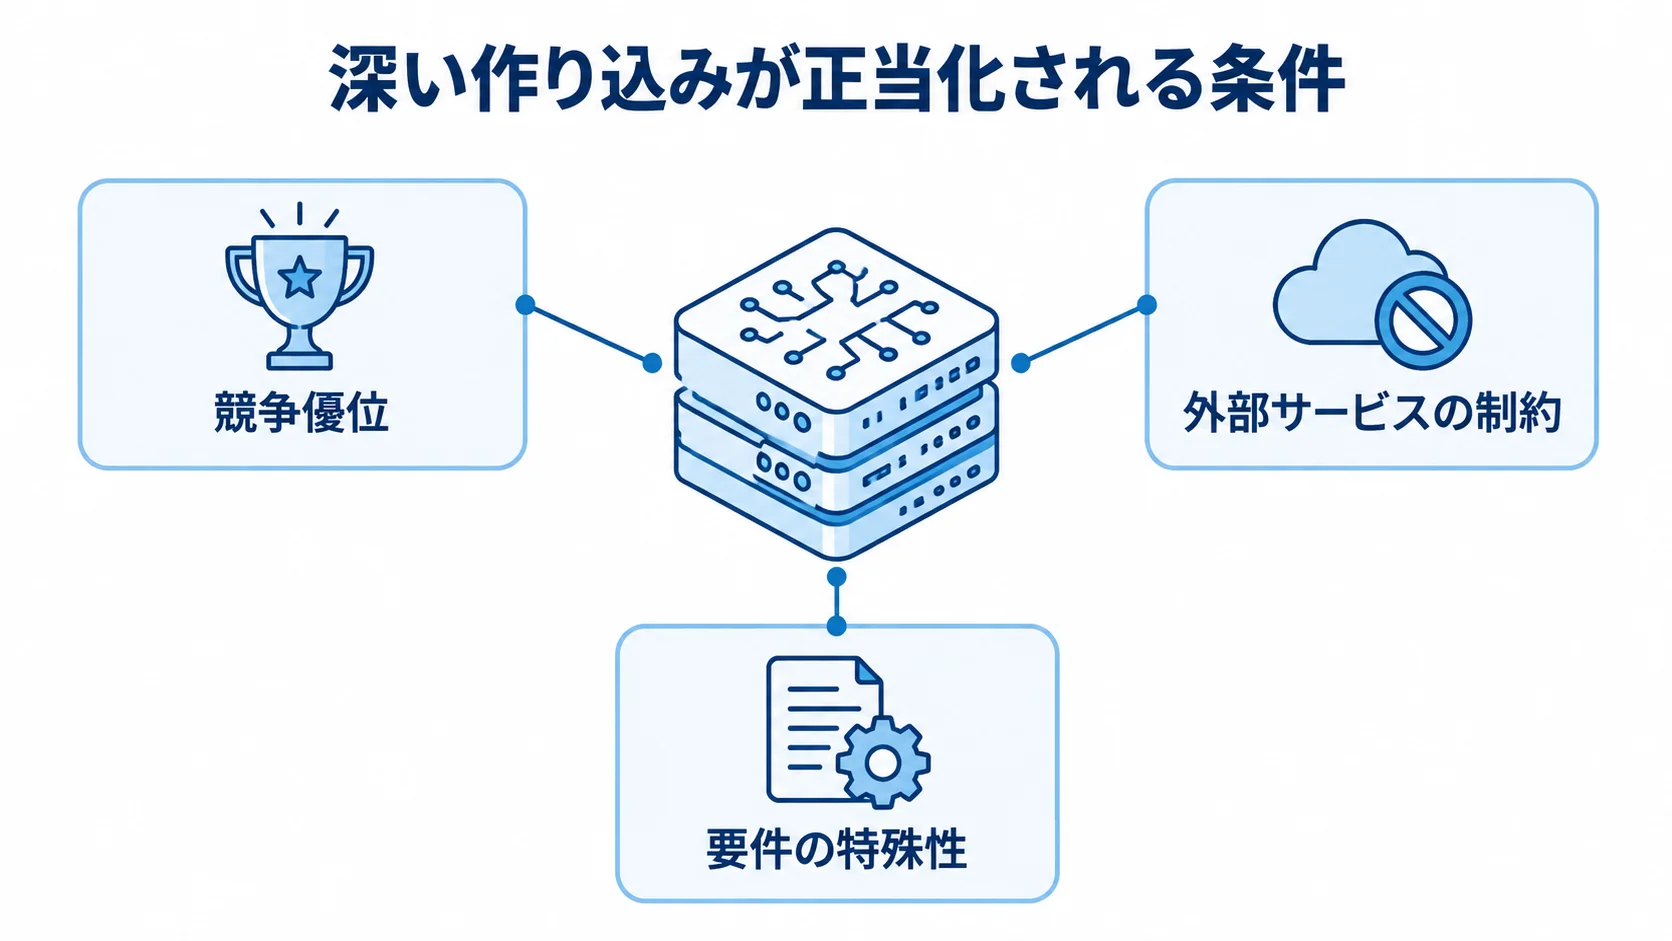
深い作り込みが正当化される3つの条件
既製ツールを使わない深い作り込みは、初期費用が数千万円から1億円以上になることがあります。そこで、次のいずれかに該当するかが判断材料になります。
- 競争優位:業界固有の知識を反映した独自のアルゴリズムやロジックが、自社の強みの源泉になる。
- 外部サービスの制約:機密性が極めて高く、セキュリティやコンプライアンス上、APIやSaaSへデータを送れない。
- 要件の特殊性:既存のAPIやSaaSでは、複雑な要件を満たせない。
たとえば、他社にまねできない独自の分析手法や予測モデルがあるなら、その部分への投資には意味があります。外部サービスを使えない場合は、自前のデータ連携が必要になります。
標準ツールで対応できない特殊な要件がある場合も、深い作り込みが選択肢になります。一方で、これらに該当しなければ、BigQueryと既製のコネクターやBIツールによる開発で十分です。自社の要件が条件に本当に当てはまるかを見極めることが、過剰投資を避ける判断につながります。
過剰投資という失敗の回避
前述の3つの条件に該当しなくても、自社専用の完璧なシステムを目指して深い開発を選ぶと、投資対効果に見合わないことがあります。既製品の10倍の開発費をかけても、分析精度や効果は1.2倍程度にとどまる例があります。このため、作れるかどうかだけでなく、事業成果に見合う投資かを問い直すことが、データ活用投資の判断軸になります。
本格的な開発へ進む前には、開発範囲と投資効果を、次のように確かめます。
- 既製のマネージドサービスやツールで実現できる範囲を、最大限に活用する。
- それでも満たせない要件に限って、オーダーメイドの作り込みに絞る。
- 事前のPoCで費用対効果を確かめてから範囲を決めることが、過剰投資を防ぐ最も確実な方法です。
BigQueryなどのサーバーレスDWHに、成熟したコネクターやBIツールを組み合わせると、構築費を抑えられます。さらに、以前はフルスクラッチでしか実現できなかった高度な分析基盤も、より低コストで構築できます。
まとめ
BigQueryを使うデータ分析基盤のフルスクラッチ開発は、DWHエンジンの自作ではありません。マネージドなBigQueryを基盤にして、その上に自社固有のETL/ELT、集計ロジック、ダッシュボードを作る形が現実的です。
開発費の一般的な40〜60%はオーダーメイド部分が占めます。基盤やコネクター、BIツールは既製品に任せ、差別化につながる分析ロジックに投資することが、費用を抑える鍵です。
費用は小規模で100万〜300万円、中規模で300万〜1,500万円、大規模で1,500万〜3,000万円以上です。複雑な場合は1,000万円〜1億円以上となり、大規模開発の期間は6か月〜2年が目安です。
要件が流動的な分析プロジェクトでは、準委任契約によるアジャイルな進め方が主流です。
深い作り込みは、独自アルゴリズムが競争優位の源泉となる場合、機密上APIやSaaSに送信できない場合、既存ツールで複雑な要件を満たせない場合に限られます。それ以外の作り込みは、過剰投資になるおそれがあります。PoCで費用対効果を確認し、自社の要件に合った開発範囲を選びましょう。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。