
BigQueryの保守・運用費用は、保存データ量、クエリの処理量、運用体制によって、月額数千円から数十万円以上まで変わります。
仕組みを知らないまま使うと、請求額が想定を超えることもあります。全体像は、Google BigQuery導入の完全ガイドもご覧ください。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
データ基盤構築の費用の考え方や見積もりの注意点については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
▼見積依頼前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
BigQueryのランニングコストの全体像(料金体系)
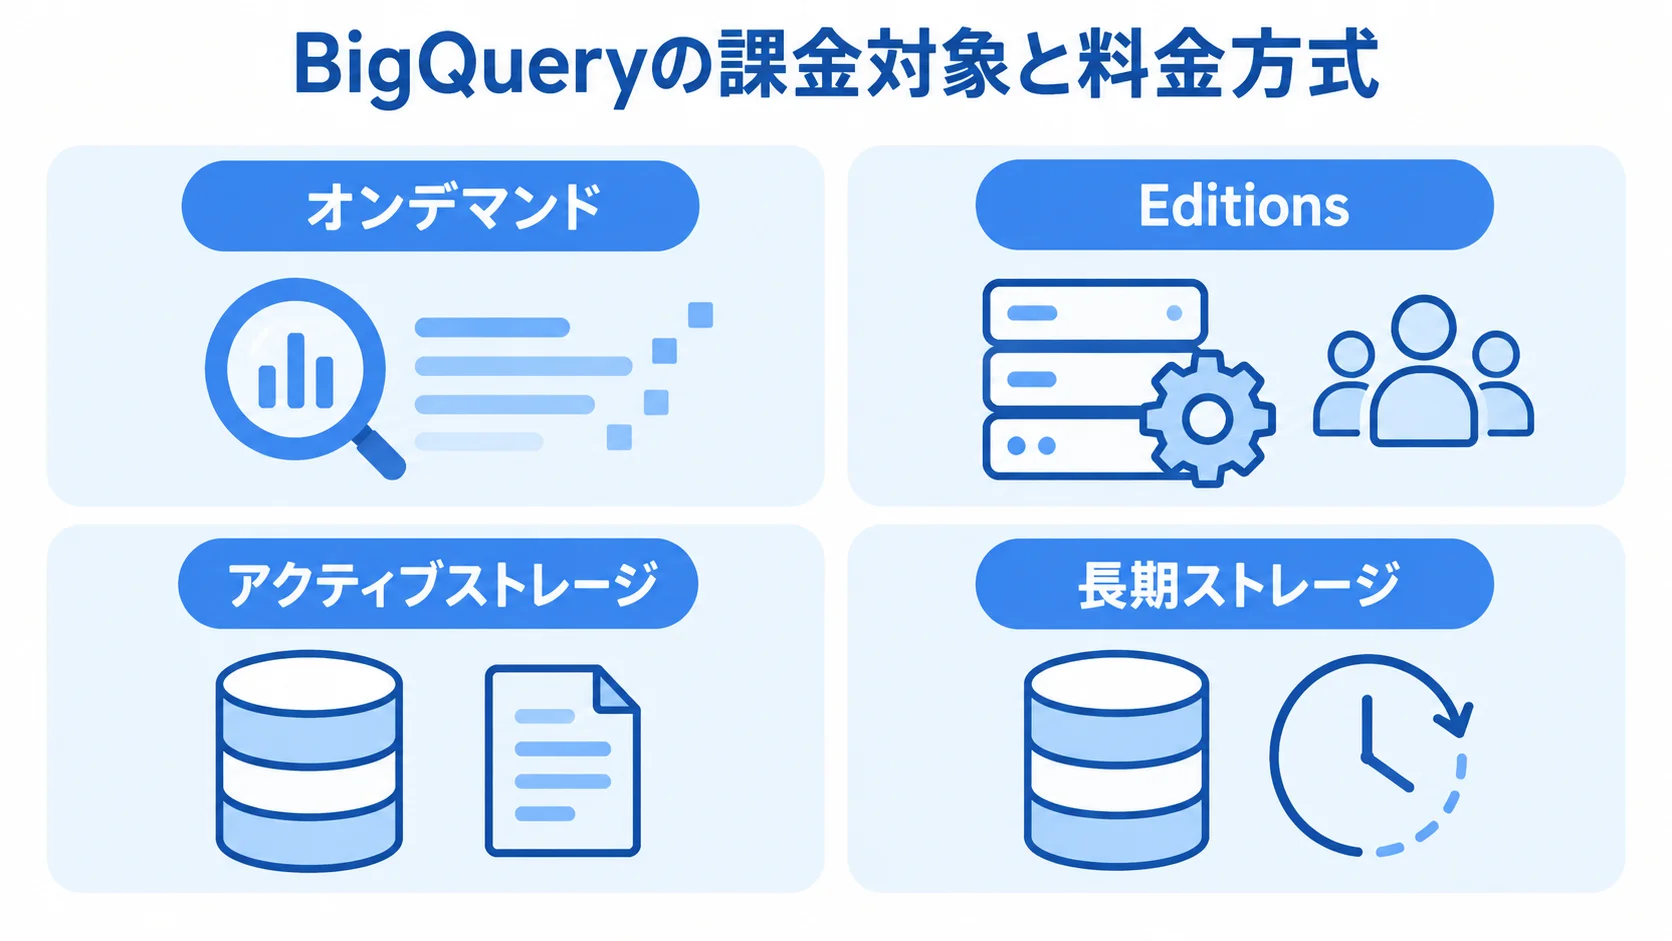
費用を予測するには、まずコンピュート課金とストレージ課金の二軸を理解しておく必要があります。利用パターンを見れば、どちらの課金が費用の中心になるかを判断できます。
従来のオンプレミスDWHやノード確保型のクラウドDWHでは、コンピュートとストレージを一体で確保します。そのため、使っていない時間帯にも固定費がかかります。
一方でBigQueryは、ストレージとコンピュートが分かれています。この分かれ方によって、保存中はストレージ、クエリ実行時はコンピュートに課金されます。この分離は、サーバーレスDWHの費用設計の根幹です。他のDWHで生じるクラスターの常時稼働費を、構造的に避けられます。
さらに、サーバーやクラスターを利用者が維持しない点も特徴です。利用パターンに合わせて費用を組み立てられます。
コンピュート課金とストレージ課金の2軸
コンピュート課金はクエリの実行に、ストレージ課金は保存量に応じて発生します。なかでも変動が大きいのはコンピュート費用で、コスト管理の中心になります。
- オンデマンド:クエリが処理したデータ量に応じた課金
- Editions:スロットの利用時間に応じた課金
- アクティブストレージ:頻繁に更新されるデータを保存
- 長期ストレージ:90日間変更のないテーブルが対象
オンデマンドの米国リージョンの参考単価は、約6.25ドル/TiBです。毎月最初の1TiB分は無料枠となっており、単価や無料枠は公式料金ページで確認してください。
Editionsで使われるスロットは、計算リソースの単位で仮想CPUに相当します。ストレージは米国リージョンで、アクティブが約0.02ドル/GiB・月です。
長期ストレージに移ったデータは、米国リージョンで約0.01ドル/GiB・月に自動で割り引かれます。ストレージには、毎月最初の10GiBまでの無料枠もあります。
保存量は、非圧縮の論理データ量で数えるか、圧縮後の物理データ量で数えるかを選べます。圧縮率が高ければ、物理課金のほうが安くなることもあります。
単価はリージョンごとに異なり、東京リージョンは米国リージョンより高めです。そのため、利用するリージョンの料金を見積もりに反映させる必要があります。
オンデマンドとBigQuery Editions(容量)の選び方
オンデマンドとEditions(容量ベース課金)のどちらを選ぶかは、ランニングコストを左右します。利用量と予算を照らし合わせ、実績を見ながら判断することが大切です。
- 利用量が不安定:スキャン量に応じて支払うオンデマンド
- 安定した利用:容量予約とコミットメントを組み合わせるEditions
- 定常分と突発分がある:Editionsとオンデマンドの併用
導入時に動作を試す場合や、月によって分析量が変わる場合は、オンデマンドが向いています。一方のEditionsは、Standard・Enterprise・Enterprise Plusの3階層で、スロット容量を時間単位で確保でき、オートスケールにも対応しています。
クエリ量が多く安定しており、予算を固定したい時期には、Editionsの容量予約とコミットメントが候補になります。オンデマンドより費用を抑えられ、予算を立てやすい場合もあります。
初期はオンデマンドで利用量を測り、安定してからEditionsへ移る進め方もあります。実績をもとに併用の組み合わせを見極めれば、コストの最適化につながります。
保守・運用費用の内訳と目安
月々の保守・運用費用は、クラウド利用料と人件費に分けて見積もるのが基本です。BigQueryは利用料の内訳が単純で予測しやすい一方、人件費は見落とされがちです。
分析基盤は、導入後もデータ連携の監視や、クエリ・ダッシュボードの改修が続きます。新しい要件への対応やコストの監視も必要になります。
クラウド利用料(従量課金の実態)
クラウド利用料は従量課金のため、利用の規模によって金額が変わります。保存データ量とクエリの処理データ量の二つを先に見積もると、月額費用を予測しやすくなります。
- 小規模利用:月額数千円〜数万円程度に収まる場合がある
- 複数部門での利用:月額数十万円以上に達することがある
- 見積もりの軸:保存データ量とクエリの処理データ量
数十GB〜数百GBのデータを保存し、日次でダッシュボードを更新するような場合は、無料枠と従量課金を組み合わせて使えます。さらに、BigQueryは使っていない夜間にもクラスターの固定費がかからず、データを保存するだけの期間はストレージ料金だけで済みます。こうした点が、利用料を抑えられる理由になります。
データが数TB規模になり、複数部門が日常的に多数のクエリを実行する段階では、Editionsの容量予約で単価を下げる方法があります。
DWH本体やBIツールを含む維持費は、月額数万円から数十万円以上が目安です。導入前にサンプルデータで代表的なクエリのスキャン量を測っておくと、本番の費用を試算しやすくなります。
保守・運用の人件費と体制
外部委託の保守・運用契約では、初期開発費の5〜15%程度が月額費用の目安になります。たとえば初期開発費が500万円であれば、月額は25万〜75万円程度です。
- 監視・障害対応:データ連携パイプラインの死活監視
- 仕様変更への対応:SaaSやデータソース側の変更への追随
- 分析と費用の改善:クエリ・ダッシュボード改修とコスト最適化
保守・運用の人件費は、クラウド利用料と同等か、それ以上の比重を占めることもあります。一方でBigQueryでは、OSパッチ適用やバックアップ、クラスターの増減をGoogle Cloud側が担います。そのため、他のDWHに比べてインフラ運用の負担が軽くなります。
専任のインフラエンジニアを常時抱えなくても、標準SQLとGUIで運用できます。ただし、データ品質の維持、コストの監視、分析ニーズへの対応は引き続き必要です。
内製にするか、開発パートナーに委託するか、両者を組み合わせるかは、自社のエンジニアリング体制に合わせて決めます。
BigQuery特有のコスト膨張リスク
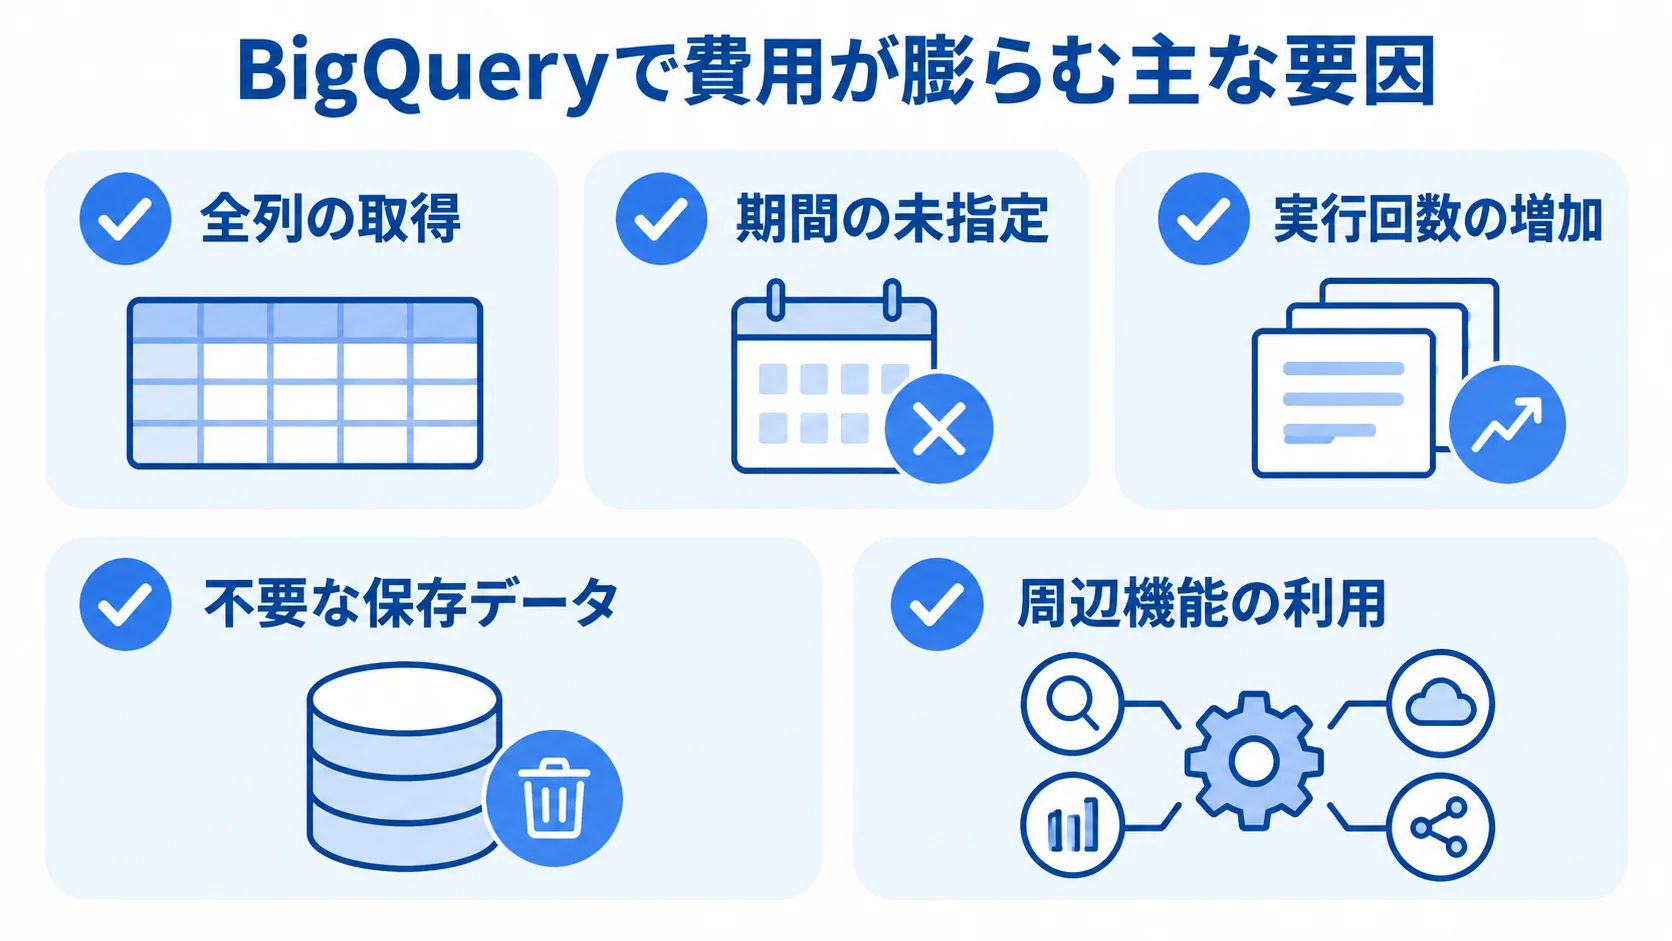
従量課金のBigQueryには、便利さの裏側に特有のコスト膨張リスクがあります。サーバーレスだから安いと思い込んで使うと、高額な請求につながることがあります。
注意したいのは、オンデマンドのクエリ課金と、ストレージや周辺業務の見えにくい費用です。まずリスクの背景を知ることが、対策の第一歩になります。
「青天井のクエリ課金」というリスク
オンデマンド課金では、スキャン量に応じて費用がかかります。クエリの設計を誤ると、一度の実行で大量のデータを読むことになり、請求額が上がることがあります。
- 全列の取得:必要な列を絞らずSELECT *を使う
- 期間の未指定:パーティションを絞らず全体を対象にする
- 実行回数の増加:BIの自動再実行や重いクエリの反復
BigQueryは列指向ストレージのため、参照する列を絞るほどスキャン量が減ります。逆に、読む列が多いほど、スキャン量は増えます。さらに、BIダッシュボードの自動更新や、多数のユーザーによる同じ重いクエリの反復も、実行回数を重ねてスキャン量を積み上げます。
根本的な対策は、パーティション・クラスタリングの設計とクエリ最適化の知識を、組織として持つことです。そのうえで、チーム全員が青天井のリスクを理解し、増加のパターンを事前に確認する習慣を付けておくと安心です。
ストレージとオペレーションの見えないコスト
クエリ課金以外にも、ストレージや周辺機能、監視業務の費用が積み上がります。そのため、保存データと利用機能の両方を定期的に確認する必要があります。
- 不要な保存データ:中間・一時テーブルや古いデータ
- 周辺機能の利用:データの書き込みや転送などの機能
- 運用作業:費用の監視と継続的な最適化
ストレージ単価は比較的安いものの、費用は見過ごされがちです。とくに日次でテーブルを生成するデータパイプラインでは、有効期限(TTL)による自動削除を設定しないと、保存料がかかり続けます。
ストリーミング挿入(リアルタイムでのデータ書き込み)、Storage Write/Read API、他リージョンへのデータ転送にも課金があります。さらに、BI Engine(インメモリ高速化)の予約容量も課金の対象です。主要なコンピュートやストレージの料金以外も把握しておかないと、請求の内訳が読みにくくなります。
サーバーレスでも、運用の監視は欠かせません。体制がないまま放置すると、非効率なクエリや無駄な保存データが見つからず、費用が膨らんでいきます。
利用状況は、Google Cloudの課金レポートやINFORMATION_SCHEMA(利用状況を確認できるメタデータ)でつかめます。プロジェクト・ユーザー・クエリごとの費用を、定期的に一覧にして見直しましょう。
ランニングコストを最適化する具体策
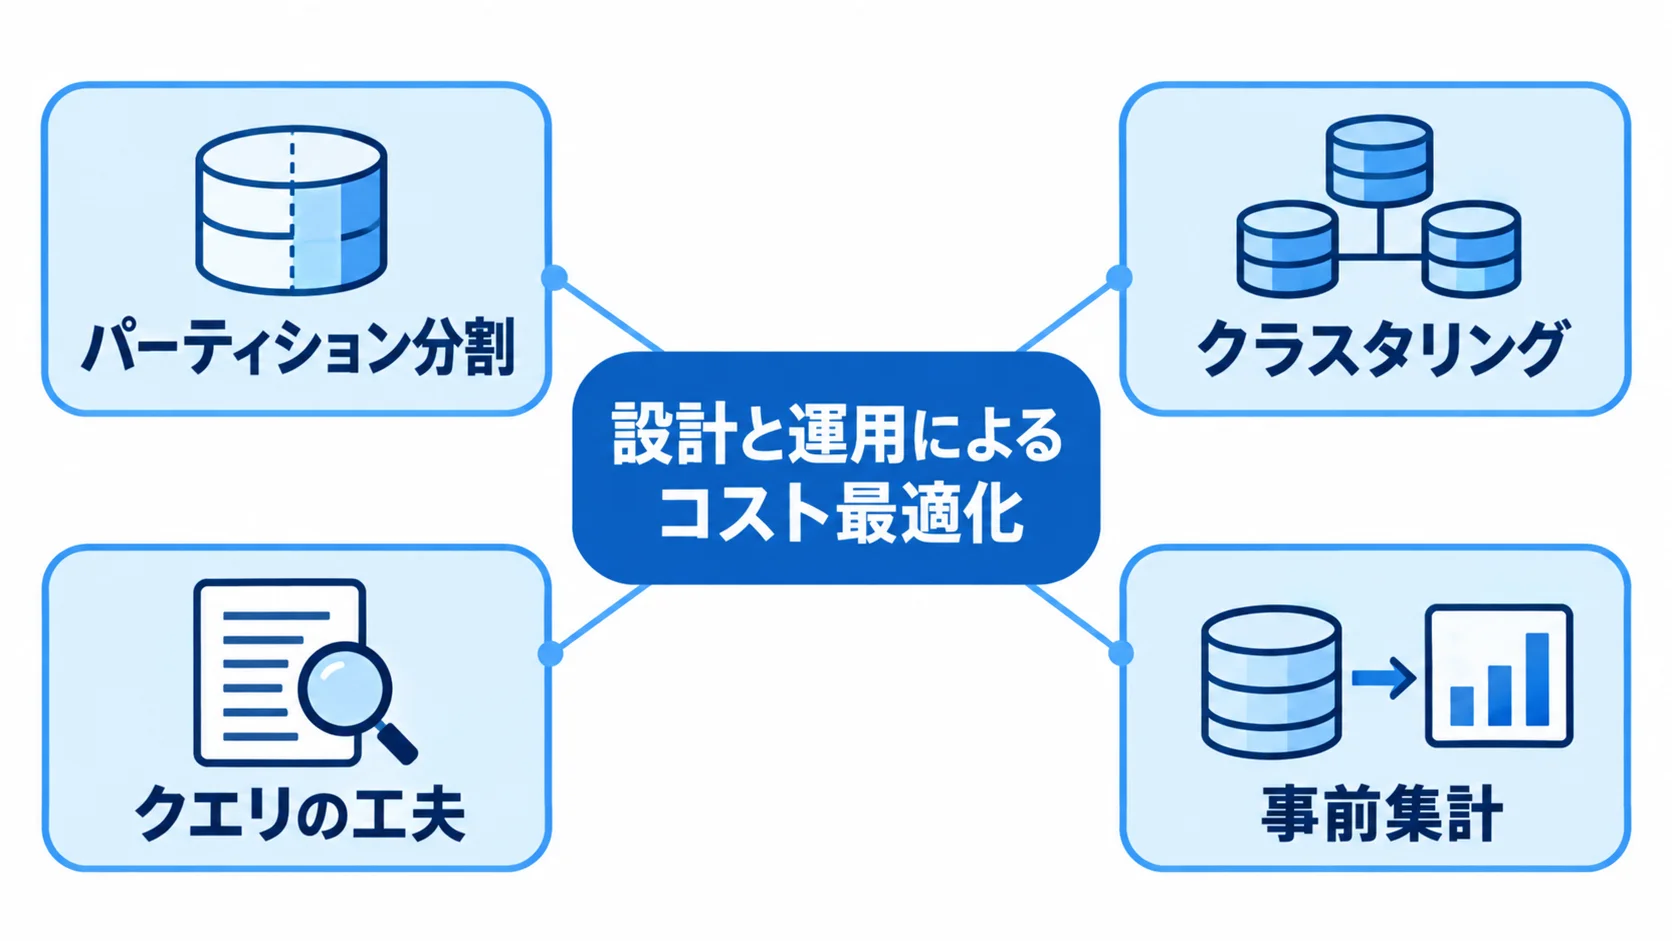
コストの膨張は、設計と運用ルールで抑えられます。料金体系はシンプルで透明性が高いため、勘所を押さえておけば、使った分に応じた費用で運用できます。最適化は、クエリ設計と予算管理の二つの面から進めます。
パーティション・クラスタリングとクエリ設計
テーブル設計とクエリの書き方を整えると、読むデータを減らし、スキャン量を抑えられます。
- パーティション分割:日付などで区切り、対象期間を限定
- クラスタリング:絞り込みに使う列でデータを整理
- クエリの工夫:必要列の指定と処理量の事前確認
- 事前集計:頻出集計をビューやスケジュールクエリで用意
たとえば、数年分のログを日付で分割しておけば、直近1か月を対象にするクエリは1か月分だけを読みます。全テーブルを読む場合に比べて、スキャン量を減らせます。
クラスタリングは、顧客IDや商品カテゴリなど頻繁に絞り込む列を基準にデータを並べて格納する方法です。該当するデータへ効率よくアクセスでき、その分だけスキャン量と費用が抑えられます。
対象期間と参照列を明確にすると、読むデータを絞れます。具体的には、WHERE句でパーティション列を指定し、SELECT *は避けます。また、実行前に処理予定のバイト数を確かめることが大切です。
頻繁に使う集計は、マテリアライズドビューやスケジュールクエリで事前に計算しておけます。元データを再スキャンする回数が減り、費用と応答速度の改善につながります。
これらの設計と運用ルールを決まった形にそろえておくと、クエリ課金が想定外に膨らむリスクを抑えられます。
コスト上限・予算アラートとEditionsのコミットメント
設計の最適化に加えて、予算管理の仕組みも整えておきます。BigQueryやGoogle Cloudには、コストの急増を防ぐための機能が用意されています。
- カスタムクォータ:日次のスキャン量に上限を設定
- 予算アラート:月次費用が閾値に達したら通知
- コミットメント:安定利用時に容量課金の単価を割引
- 併用:定常分をEditions、突発分をオンデマンドで処理
カスタムクォータは、クエリ・ユーザー・プロジェクト単位で1日にスキャンできるデータ量を制限します。上限を超えるとクエリが実行されないため、高額な処理を止められます。
予算アラートを使えば、費用の異常にいち早く気づけます。コミットメントは、1年または3年の期間で結ぶと単価が割り引かれ、月額も固定しやすくなります。
初期はクォータとアラートで利用量を把握し、安定後にEditionsを検討します。容量課金へ移ることで、従量費用の変動を抑え、予算を決めやすい形にできます。
定常的な処理はコミットメントでまかない、突発的な分析はオンデマンドで行えば、費用と柔軟性を両立できます。
費用面での他DWHとの違いと選定の考え方
BigQueryの費用を評価するときは、他DWHとの費用構造の違いも判断材料になります。Amazon RedshiftとSnowflakeを比べて、自社に合う選択を検討します。とくにサーバーレスの従量課金が費用にどう響くかは、利用の向き・不向きとあわせて見ておく必要があります。
サーバーレス従量課金という強みと向き不向き
各DWHは課金モデルが異なります。利用が断続的か、一定の負荷が続くかで比べると、費用面での向き不向きを判断しやすくなります。
- Amazon Redshift:ノードを確保し、使わない時間にも固定費が発生
- Snowflake:仮想ウェアハウスのサイズに応じて維持費がかかる傾向
- BigQuery:クエリ実行時にコンピュート課金が発生
Redshiftは、リザーブドインスタンスなどでノードを確保するリソース確保型が中心です。月額を一定にでき、予算を組みやすい点が特徴です。
Snowflakeは完成度が高い一方で、最小構成でも一定の費用がかかりがちです。対してBigQueryは、クエリ実行分に課金され、保存だけならストレージ料金で済みます。利用に波がある場合や初期段階では、無駄な費用を抑えながら始められます。
BigQueryは、断続的な分析や実験的なデータ活用に向いています。ただし、常時大量のクエリを実行する高負荷の環境では、オンデマンドが割高になることもあります。
高負荷が安定して続く場合は、Editionsの容量予約とコミットメントで、予算の固定や単価の削減を図れます。利用の段階に合わせて課金方式を選べる点も特長です。
スモールスタートとオーバースペック回避
費用を抑えるには、扱うデータ量と当面の要件に合う構成から始めることが基本です。
- 数TB未満でAI活用予定なし:高機能なDWHが不要な場合がある
- 小さく始める:既存DBやBigQueryの最小構成を検討
- 実績に応じて拡張:利用量に合わせて段階的にスケール
最初から高機能なDWHを入れると、必要以上の機能にまで費用をかけることになります。扱うデータが数TB未満で、複雑な非構造化データのAI活用も当面予定していないのであれば、フル装備のDWHは不要な場合もあります。
初期段階では、PostgreSQLの参照用レプリカなど既存のリレーショナルデータベースを分析に使えば、月額数千円〜数万円程度で十分な速度を得られる場合があります。
BigQueryを選ぶ場合も、無料枠と従量課金を活用すれば、最小構成で始められます。データ量や分析のニーズが増えたら、段階的に広げていきます。
BigQueryは、小さく始めた構成を途切れなく拡張できます。利用実績を見ながら必要な容量を確保すれば、キャッシュアウトを抑えられます。
将来を見込んで容量予約を先に契約すると、使い切れない分の固定費が続くことがあります。判断は、実際の利用量を見て行います。
まとめ
BigQueryは、クエリ処理量と保存量に応じて課金され、両者は分かれています。保存だけであれば、ノード確保型DWHのようなコンピュートの固定費はかかりません。
保守費用は、月額数千円〜数十万円以上のクラウド利用料に加えて、初期開発費の5〜15%程度を目安とする人件費もかかります。
サーバーレスのBigQueryは、インフラ運用の負担が軽く、費用と工数の両面で利点があります。課金方式は、初期はオンデマンド、安定後は容量ベース課金のEditionsが候補になります。1年または3年の契約では、コミットメント割引が適用され、予算を固定しやすくなります。
青天井になりやすいクエリ課金や、見えにくい保存費用には、パーティション設計とクエリ最適化、クォータと予算アラートで備えられます。また、スモールスタートで過剰な構成を避けつつ、無料枠を活かして利用実績に合う課金方式と運用体制を選びます。
単価は、リージョンや時期、エディションによって変わります。契約前に、Google Cloudの公式料金ページで最新の情報を確認してください。
▼全体ガイドの記事
・Google BigQuery導入の完全ガイド
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。