
Snowflake導入の開発期間は、データ量、連携システム数、分析要件の複雑さによって、2〜4か月から6〜12か月以上まで変わります。
仮想ウェアハウスは需要に応じて計算資源を即時に増減でき、この点はAWS専用のAmazon Redshiftや、機械学習基盤の性格が強いDatabricksとは異なる強みです。規模別の期間と工程ごとの配分、期間を短くする仕組みと方法、納期が遅れる要因を、この順に取り上げます。全体像はSnowflake導入の完全ガイドにもまとめています。
▼全体ガイドの記事
・Snowflake導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
Snowflake導入の開発期間の全体像
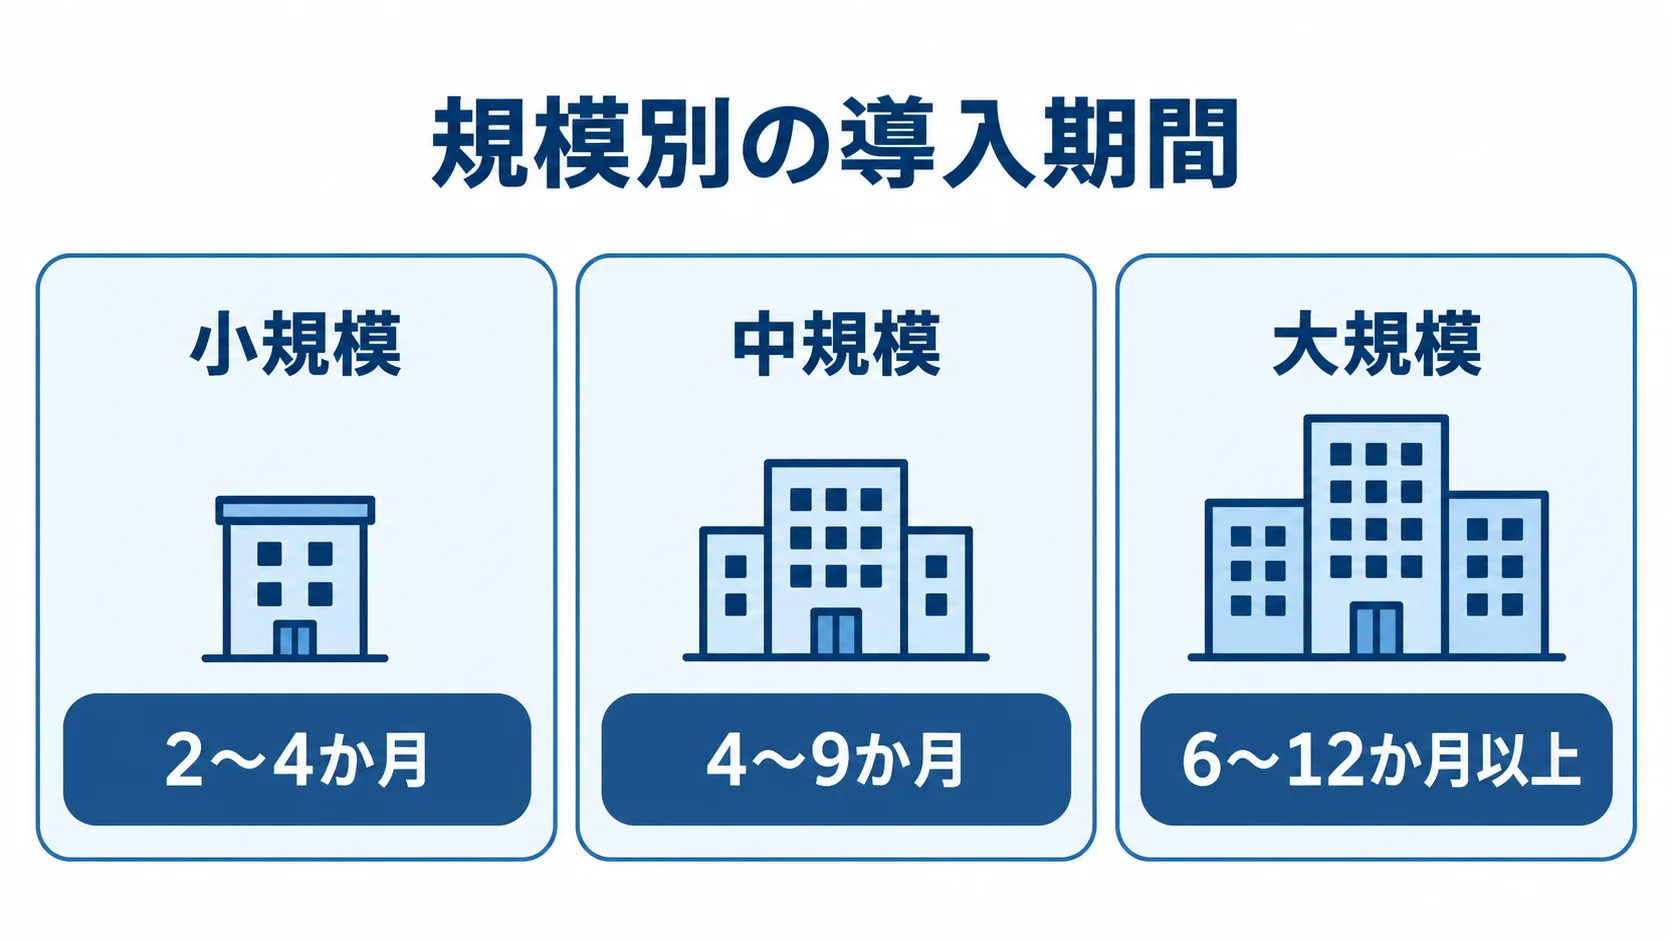
Snowflake導入の期間は、データ量、既存システム数、分析要件、クラウド構成によって決まります。規模別の目安を先に把握しておくと、現実的な計画を立てやすくなります。
全社のデータと分析を一度にすべて扱おうとすると、期間が延び、プロジェクトが頓挫することもあります。そこで推奨されるのが、事業課題に直結する1〜2のユースケースに絞り、3〜6か月で成果を出すMVP(実用最小限の製品)型です。
SnowflakeはSaaS型のフルマネージドサービスのため、エンジンの構築や調整より、データの移行・加工、データモデルの作成、ダッシュボードの作成に工数を使います。この特性が、納期見積もりの土台になります。
規模別の導入期間と費用の目安
規模ごとの期間と初期費用は、対象データや分析基盤の範囲によって異なります。
- 小規模:単一システムと限定テーマのダッシュボードが対象。期間は2〜4か月、費用は100万〜300万円程度。
- 中規模:複数システムの統合や部門横断KPIを扱う。期間は4〜9か月、費用は300万〜1,500万円程度。
- 大規模:全社基盤、データシェアリング、AI活用を含む。期間は6〜12か月以上、費用は1,500万〜5,000万円以上。
小規模は基幹システムやSaaSなど単一の業務システムを集約し、売上や在庫をダッシュボードで確認できる構成です。また、仮想ウェアハウス1台と最小限のスキーマで始め、ETLはFivetran、Snowpipe、dbtなどでシンプルに構成できます。
中規模は複数の基幹・SaaS・ログを統合し、部門横断KPIや権限管理、複数のダッシュボードを整えます。さらに、データモデルやETL/ELT、ロールも設計し、体制はデータエンジニア、BIエンジニア、プロジェクトマネージャーで組むのが標準です。
大規模では、マルチクラウド配置、厳格なガバナンス、クレジット設計、段階的な全社展開が必要です。データ共有やAI・機械学習の前処理を含む全社案件では、見積もりに十分な余裕を含めます。
ここに示した費用は導入・開発の目安です。なお、Snowflakeの利用料(クレジット・ストレージ)は別途、利用量に応じて発生します。
導入期間を左右する要因
中規模でも、4か月で済む場合と9か月かかる場合があります。差を生む条件を要件定義の段階で洗い出しておくと、納期を見積もりやすくなります。
- データ品質(最も影響大):表記ゆれ、重複、欠損が多いと、名寄せやクレンジングに数か月かかることがあります。
- 移行元と連携方式:単一か多数の基幹・SaaS・IoTログかで、ETL/ELTの設計・実装・テスト工数が変わります。
- クラウドとマルチクラウド:ネットワークとセキュリティは自社で設計します。複数クラウドへの配置や複製には、設計と検証が必要です。
- 分析要件と共有:指標やドリルダウンの複雑さ、他社・他部門との共有の有無によって、モデル・BI・ロールの作り込みの度合いが決まります。
アカウントは簡単に開けますが、データを読み込まなければ性能も価値も出ません。移行の設計と実装の工数が、期間を左右します。
工程別のスケジュールと期間配分
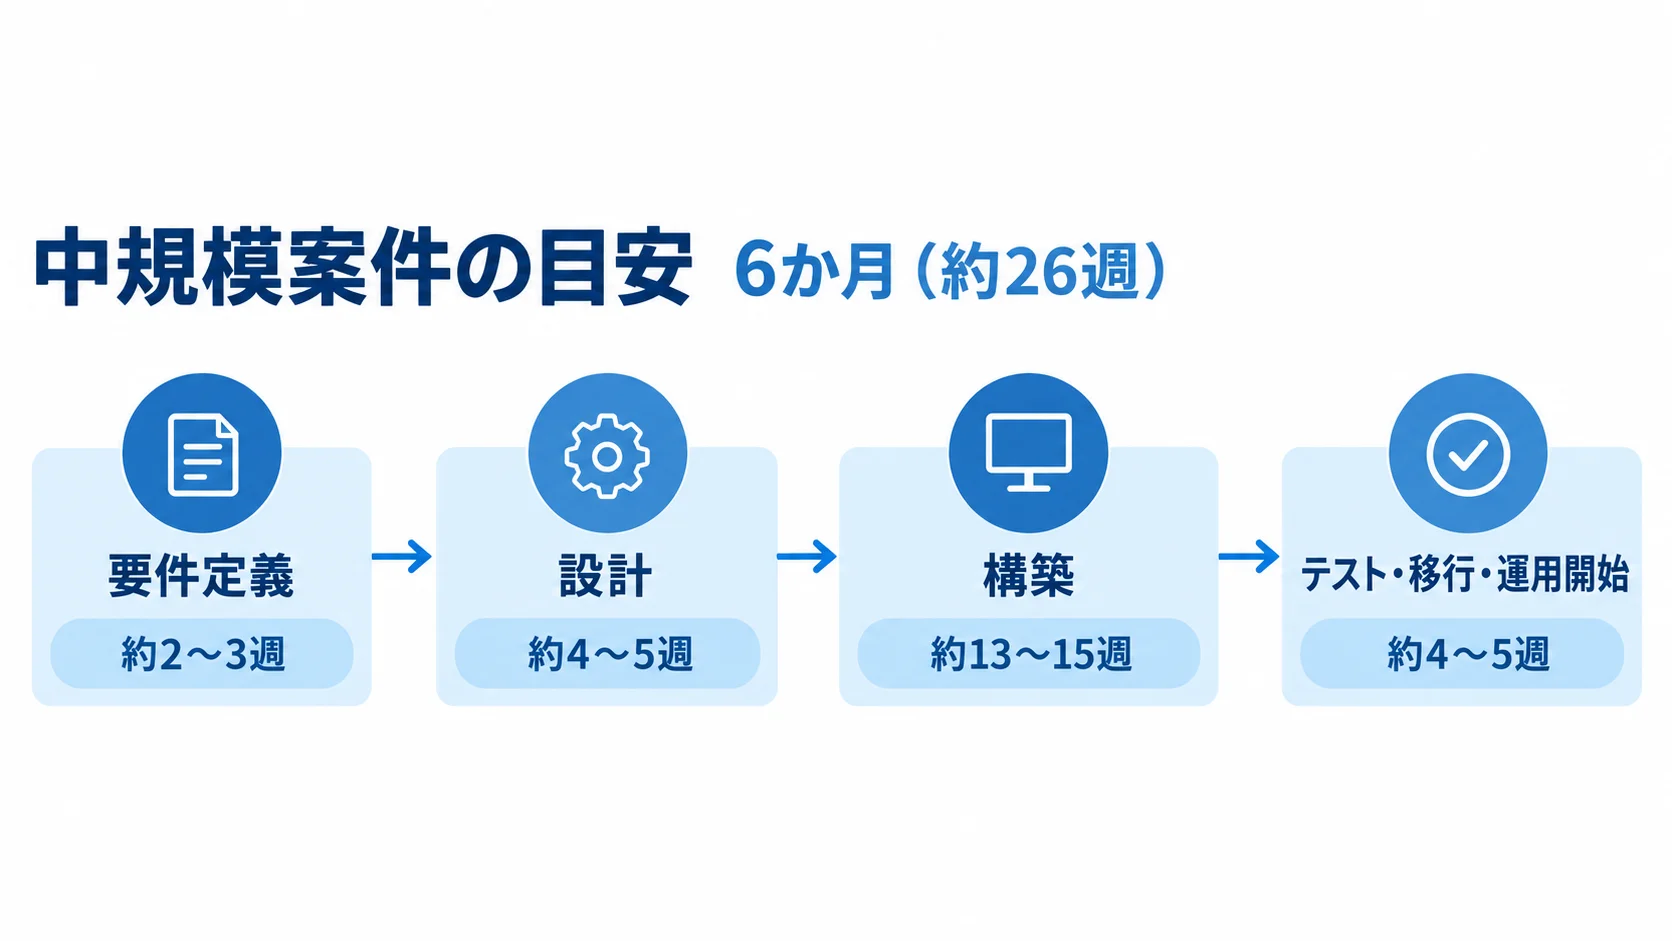
工程は3段階に分かれ、最初に要件定義と技術選定を、次に設計と構築を行います。最後はテスト・移行と運用開始です。各工程の配分を先に把握しておくと、計画の見通しが立ちます。
一般的な配分は、要件定義が約10%、設計が約10〜20%、開発(構築)が約40〜60%、テスト・移行が約10〜20%です。なかでも構築は工数が最も大きい山場で、データ基盤導入の特徴でもあります。
6か月(約26週)の中規模案件の目安は、要件定義が約2〜3週、設計が約4〜5週、構築が約13〜15週、テスト・移行・運用開始が約4〜5週です。
データの粒度やKPIを決めるデータ設計と、ワークロードごとのウェアハウスサイズを決めるコンピュート設計が、構築工数と運用コストを左右します。そのため、上流工程に十分な時間を確保すると、納期を守りやすくなります。
要件定義・技術選定フェーズ(全体の約10%)
事業課題から分析の範囲とKPIを定義し、技術選定の方針を固める工程です。Snowflake導入の成否を左右します。
- 分析要件:誰が何のデータを分析し、どの意思決定に使うか。KPI、データソース、発生量、更新頻度もあわせて確認します。
- 製品比較:Amazon Redshift、Google BigQuery、Databricksを比べます。
- クラウドとエディション:AWS・Azure・GCPと、Standard・Enterprise・Business Criticalなどの中から決めます。
- データレイクとETL/ELT:役割分担を決めたうえで、Fivetran、dbt、Snowpipeなどからツールを選びます。
- BIツール:Tableau、Power BI、Looker、Looker Studioなどが候補です。
クラウドに依存しない構成、組織間のデータ共有、標準SQLでの運用、適切なサイジングによるコスト管理と安定稼働を重視するなら、Snowflakeに強みがあります。
技術の話題性からSnowflakeを先に決めると、課題とずれることがあります。ただし、「小さく安く試す」だけが目的なら、従量課金のBigQueryが向く場合もあります。
選定方針を文書に残しておくと、後の工程での手戻りを防げます。このフェーズの期間は、1〜3週間が目安です。
設計・構築フェーズ(全体の約50〜70%)
設計・構築は全体の約5〜7割を占めます。設計と実装をスプリントで進め、途中の成果を定期的に確認します。
- 設計:データモデル、KPI、ダッシュボード、ロール(RBAC)によるアクセス権限を決めます。
- コンピュート:取込・変換、BIクエリ、アドホック分析のそれぞれに使うウェアハウスの大きさを見極めます。
- 構築:DB・スキーマ・ロール、取込パイプライン、初期の読み込みと差分連携、SQLやdbtによる変換処理、BI接続を作り込みます。
- 品質管理:変換ロジックをコードで管理し、レビューとテストを組み込みます。
仮想ウェアハウスは処理ごとに独立させられるため、性能の干渉を避けられます。たとえば、重いバッチとダッシュボードの表示を分ければ、双方の応答性を保てます。
インフラの準備、パッチ、バックアップ、スケーリングはSnowflakeが担うため、開発チームは加工ロジックとモデリングに集中できます。
スプリントは2週間〜1か月単位が適しています。中規模案件では、この工程に13〜16週程度を見込みます。
テスト・移行・運用開始フェーズ(全体の約10〜20%)
構築した基盤が要件を満たすか、集計が正しいかを検証してから本番へ移します。特に、既存の帳票や現行システムとの数値照合は欠かせません。
- 数値:集計ロジックや連携の欠損によるずれがないかを確かめます。
- 性能:想定データ量でクエリを動かし、ウェアハウスサイズとクラスタリングの状態を見ます。
- 権限:ロール設計が意図どおりに動くかを検証します。
- コスト:クレジットの消費を計測し、自動サスペンドやサイズを調整します。
数値の確認は、画面の実装以上に工数がかかることがあります。そのため、テスト期間を十分に確保しておきます。
ユーザー受け入れテスト(UAT)の後は、パイロット部門で運用し、利用者の声を集めます。そのうえで、データモデルやダッシュボードを改善します。
全部門へ一斉に広げず段階的に導入すると、運用上のトラブルを避けられます。リリース後も、クエリ性能とクレジット消費を監視し続けます。このフェーズは3〜5週程度が目安です。
Snowflakeならではの期間短縮の仕組み
Snowflakeは、データベースエンジンとインフラ運用の多くをSaaS型で管理するため、オンプレミスやフルスクラッチのDWHより導入を短縮しやすい仕組みです。
サーバーの調達や、OS・ミドルウェアの導入は不要です。さらに、パッチ、バックアップ、冗長化、スケーリングも要りません。コンソールでDBとウェアハウスを作れば、データの読み込みやクエリをすぐに始められます。
マルチクラウド対応とSaaS型フルマネージドによる立ち上げ加速
SaaS型のフルマネージドと、マルチクラウド対応が、Snowflake導入の期間を大きく短縮します。
- クラウド選択:AWS、Azure、Google Cloudの中から自社の環境に合わせて選び、既存環境との親和性を保って立ち上げられます。
- 標準SQL:RedshiftはAWSと密結合し、VPCやIAMの知識を前提とするのに対し、Snowflakeはクラウドの差を吸収します。
- 運用代行:サーバーやクラスタの構築は不要です。パッチ、バックアップ、障害復旧、スケーリングはSnowflakeが担います。
開発チームは、データの取込、モデリング、ダッシュボードの作成に早く着手できます。ただし、各クラウドのネットワークとセキュリティ設計は自社で行うため、その工数を計画に含めておく必要があります。
コンピュートとストレージの分離と仮想ウェアハウスの即時起動
Snowflakeは、コンピュート(計算処理)とストレージ(データ保存)を分離しているため、計算環境は必要に応じて使えます。
- 独立した拡張:従来のDWHは計算能力とデータ容量が一体のため、片方だけ増やす場合も全体のサイジングが必要でした。
- 即時実行:データはクラウドストレージに置き、必要なサイズの仮想ウェアハウスを起動します。ノード数を事前に確保せず、作成後すぐにクエリを実行できます。
- 自動停止:アイドル状態が続くと自動サスペンド(一時停止)し、コンピュートの課金も止まります。
- 並行開発:分析、バッチ、データサイエンスにそれぞれ別のウェアハウスを割り当てられるため、重い処理がダッシュボードに干渉しにくくなります。
即時起動と自動停止は、導入初期に実データで試すまでの時間を大幅に縮めます。さらに、要件定義と並行して検証でき、複数チームが同時に開発しても互いの予定を圧迫しにくくなります。全体の納期短縮にもつながります。
Snowflake導入で納期を短縮する具体的な方法
スコープを絞り、データシェアリングや短い開発サイクル、段階的な展開を活用すると、納期をさらに短縮できます。特に実務で効果的なのは、MVPで範囲を絞る方法と、共有データやアジャイルを使った段階展開です。
1〜2ユースケースに絞ったMVPアプローチ
最初のリリース範囲を絞ると、納期を短縮できます。全社のデータを一度に扱うと要件や連携先が増え、合意を得るのにも時間がかかります。
- 対象を限定:Phase 1(MVP)は、成果が出やすく事業への影響が大きい1〜2のユースケースに絞ります。
- テーマ例:商品・店舗別の月次売上・粗利や、施策ごとのCVRなど、意思決定に直結する題材です。
- 段階拡張:対象を絞れば連携先とモデルが限られ、必要なウェアハウスも小さくできます。
3〜6か月で成果を出せば、社内の理解と予算を得て、Phase 2以降へ進めます。
Snowflakeはストレージとコンピュートが分かれているため、後から用途を追加しても既存の構成を作り直さずに拡張できます。小さく作って育てる進め方とも相性がよく、早く価値を出してから広げるのが最短ルートです。
データシェアリング活用とアジャイル・段階的ロールアウト
範囲を絞ったうえで、構築を2週間〜1か月単位のスプリントに分け、アジャイルに進めます。要件をすべて固めてから作る方法と比べると、短いサイクルで成果を確認でき、データ活用の実態も把握しやすくなります。
- 反復開発:取込、集計、表示、フィードバックを繰り返し、指標や切り口の認識違いを早めに直します。
- 共有データ:MarketplaceやSnowflake利用企業のデータを、自前のETLやコピーなしで参照できる場合があります。
- 段階展開:パイロット部門で、運用上の問題、データ不整合、クレジット消費を見てから広げます。
各スプリントで動くダッシュボードを関係者に見せると、後工程での大きな作り直しを防げます。
共有データを使えば、データを整える工数を減らせます。段階展開は遠回りに見えても、大きな手戻りや運用トラブルによる遅れを防ぎ、全体の納期を守ります。
納期遅延の典型要因と対策
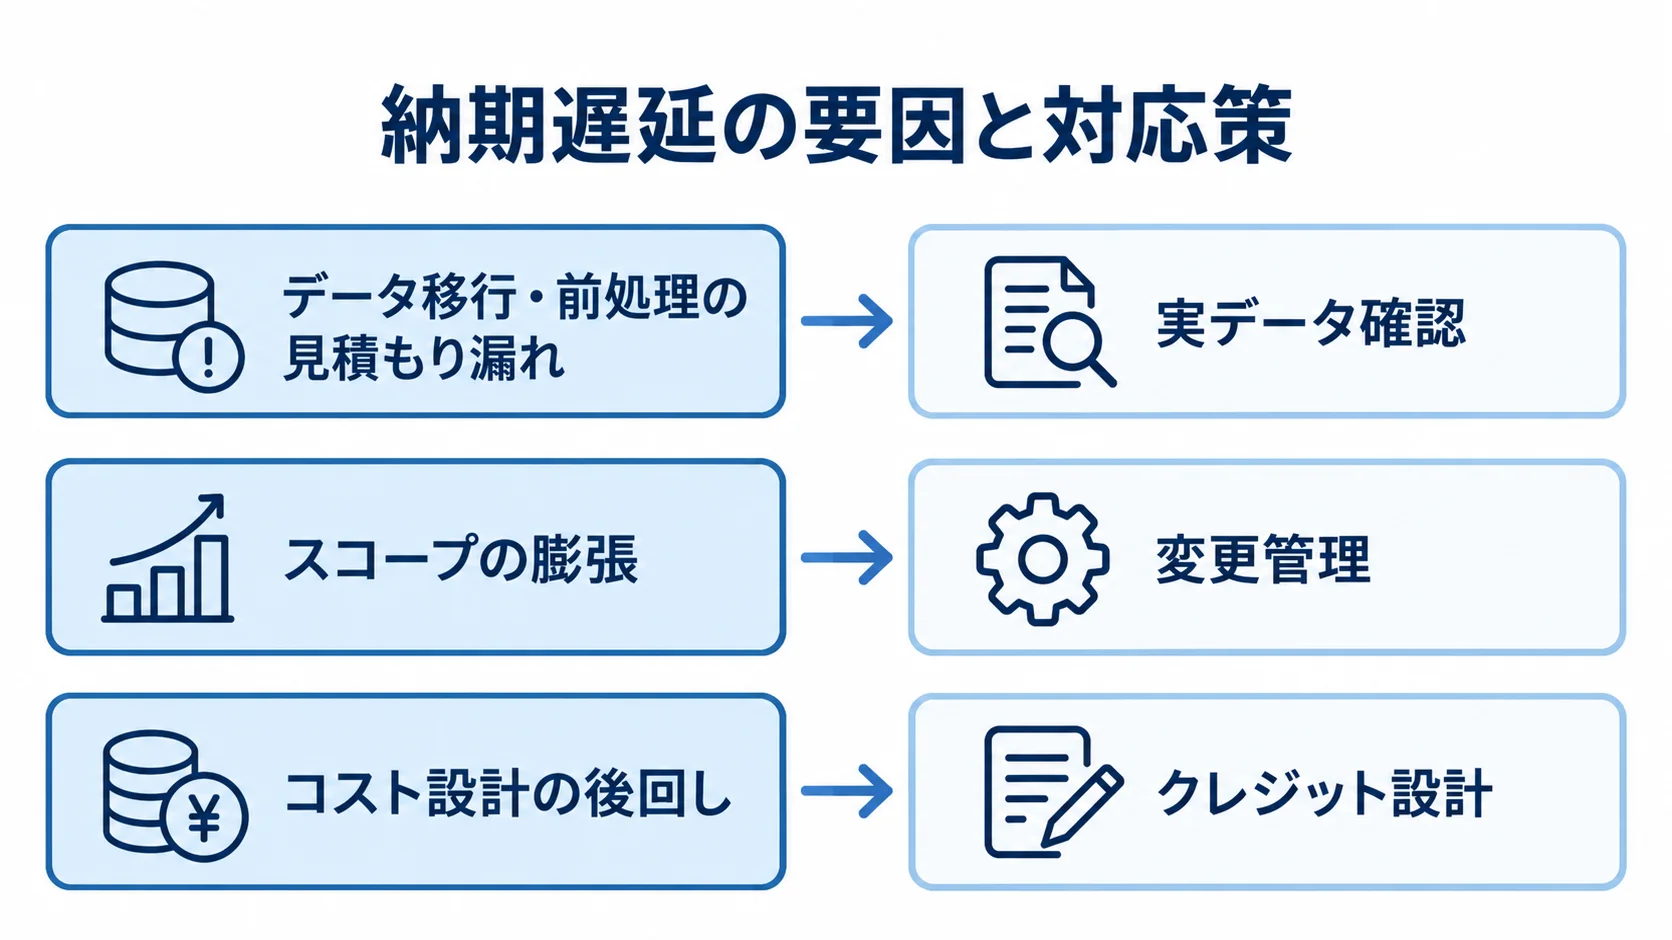
マネージドサービスは納期の短縮に役立ちます。ただし、データ基盤に特有の遅延リスクも残ります。
典型的な要因と対策を事前に把握すると、スケジュールの破綻を防げます。特に多いのは、データ移行・前処理の見積もり漏れと、スコープの膨張やコスト設計の後回しです。
データ移行・前処理の見積もり漏れ
最も多い遅延は、データ移行と元データの品質問題によるものです。アカウントは簡単に開けても、データを読み込まなければ性能も分析の価値も生まれないため、移行は後回しにできない工程です。
- 実データ確認:要件定義の段階でサンプルを見て、データの品質と移行元の状態をつかみます。
- 工数見積もり:データが整っている前提を置かず、移行と前処理の工数を見込みます。
- 段階的な整備:完璧なマスターデータを待たず、優先するユースケースに必要な範囲から整えます。
- 取込期間の確保:SnowpipeやStreams & Tasksで継続取込を自動化する場合も、設計とパイプライン構築の期間を計上します。
取込後に表記ゆれ、重複、欠損、形式の不統一が見つかると、名寄せやクレンジングに数か月かかることがあります。そこで遅れると、次の工程へ連鎖しかねません。
スコープの膨張とコスト設計の後回し
要件の膨張とコスト設計の後回しは、それぞれ別の遅延要因です。指標の追加や別の切り口の要望が続くと、データやモデルの手戻りが起きます。
- 変更管理:Phase 1の範囲を明確にし、追加要望は影響範囲と工数を見積もったうえで合意します。
- バックログ管理:追加要望はPhase 2以降に記録し、最初のリリースを守ります。
- クレジット設計:従量課金のため、サイズや自動サスペンドの設定が遅れると、テストやリリース後の消費が想定を超える場合があります。
- コスト調整:ワークロードごとのサイズと自動停止の時期を、構築と並行して決めます。
- 数値検証:テスト期間を確保したうえで、検証用サンプルデータと期待値を早めに用意します。
Snowflakeは、最小構成でも維持費が割高になりがちです。さらに、消費を見直すには、追加の調整工数と期間がかかる場合があります。
集計値の検証には、見た目の作り込み以上の工数がかかるため、ここを軽く見積もると、納期全体に響きます。
まとめ
Snowflake導入は、小規模で2〜4か月、中規模で4〜9か月、大規模で6〜12か月以上が目安です。工程の配分は、要件定義が約10%、設計が約10〜20%、構築が約40〜60%、テスト・移行が約10〜20%です。
フルマネージドとマルチクラウド対応によって、インフラ運用の負担を減らせます。標準SQLで始めやすいことに加え、コンピュートとストレージの分離や即時起動も立ち上げを支えます。
1〜2のユースケースに絞るMVP、2週間〜1か月のスプリント、データシェアリング、パイロットからの展開を組み合わせると、価値を早く届けられます。
移行・前処理の見積もり漏れ、スコープの膨張、コスト設計の遅れは、納期を損なう要因です。これに備えるには、実データの早期確認、変更管理、コスト設計を早めに進めることが有効です。
自社のデータ活用に合うスケジュールと体制は、ここで挙げた目安と要因をもとに検討してください。
▼全体ガイドの記事
・Snowflake導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。