
Snowflake導入でオーダーメイド開発を考えるなら、DWHエンジンを自作せず、Snowflakeを土台にデータ連携や分析機能を自社要件に合わせて開発するのが現実的です。
DWHエンジンを一から作ると、開発費は数千万円から億単位、期間は年単位に膨らみやすくなります。
▼全体ガイドの記事
・Snowflake導入の完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
フルスクラッチとSaaS型プラットフォーム導入の違い
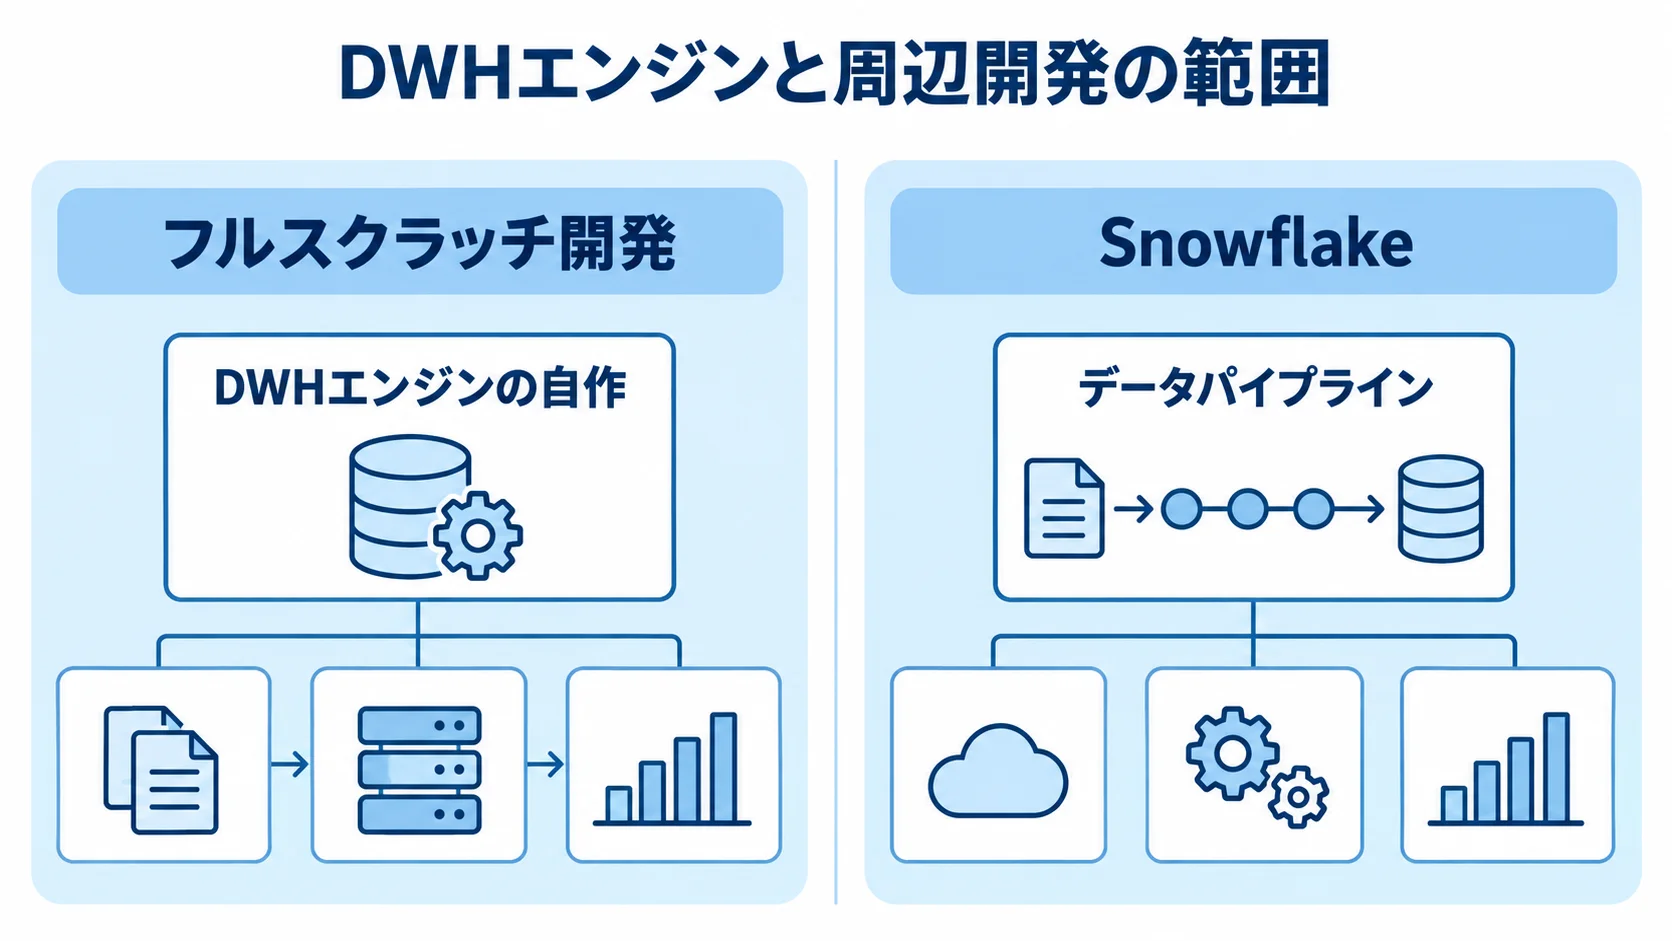
フルスクラッチ開発は、既製のプラットフォームに頼らず、DWHや周辺の仕組みをゼロから自社仕様で作る方法です。
SaaS型の導入では、Snowflakeのようなマネージドサービスを土台にし、その上に自社要件に合う設定や連携、可視化を組み上げます。
列指向ストレージや大規模並列処理、マルチクラウド対応といった機能は、自作するのが現実的ではありません。Snowflakeは長年の研究開発と莫大な投資で、これらの機能を築いてきました。一企業が同じものを再現しようとすれば、途方もない費用と年単位の期間がかかり、完成後も維持の負担が続きます。
これは「車輪の再発明」にあたり、避けるべき典型です。なお、ここでいうオーダーメイド開発は、Snowflakeの上に作る部分を指し、DWHエンジンの自作は含みません。
つまり、Snowflakeを導入したうえで、その上にパイプラインやデータモデル、ダッシュボードなどを自社要件に合わせて構築します。この理解が、方針を考える出発点になります。
DWHをフルスクラッチで作るデメリット
DWHやデータ基盤の中核を自作すると、コスト、導入期間、維持負担の3つの面で負担が大きくなります。
- コスト:高度な仕組みを一から作るため、開発費は数千万円から億単位に膨らみます。
- 導入期間:設計からテストまで年単位かかり、事業機会を逃すリスクがあります。
- 維持負担:運用・保守と機能拡張、セキュリティ対応を、自社で担い続けます。
中でも、分散処理エンジンやストレージ管理、クエリ最適化の自作は、Snowflake周辺の開発と比べて桁違いの投資になります。
Snowflakeなら、インフラ構築が要らず、数か月で価値を出し始められます。パッチ適用やスケーリング、新機能の追加もSnowflakeが継続して担うため、自社は業務ロジックとデータ活用に集中できます。
既製品で足りる機能まで自作すると、費用は10倍になっても精度や機能は1.2倍程度にとどまる、という失敗例があります。だからこそ、既製品を活用し、自社独自の価値になる部分だけを開発することが、投資を無駄にしない鉄則です。
Snowflakeが土台として優れる理由
オーダーメイド開発の土台としてのSnowflakeの強みは、クラウドを選べる柔軟性、分析用途の拡張性、扱いやすさにあります。
- 拡張性:用途ごとに仮想ウェアハウスを分け、互いに干渉させずに分析を追加できます。
- 扱いやすさ:標準SQLや充実したUI・ドキュメントで、構築と運用を進められます。
Amazon RedshiftはAWSとそのエコシステムに密結合しています。
Snowflakeは、AWS・Azure・GCPのいずれでも使えるため、自社のクラウド戦略に合わせて基盤を構築できます。
クラウドの違いを吸収する作りのため、将来の移行や複数クラウドでのデータ利用にも対応しやすい構成です。
扱いやすさの面では、標準SQLで学習コストが比較的低いため、専任のデータエンジニアがいない組織でも進めやすいのが特徴です。
DatabricksはApache SparkやNotebookを使えるエンジニアを前提とし、AI開発や非構造化データに強いサービスです。対照的に、SnowflakeはSQL中心で非エンジニアも扱えるBI分析向けの性格が強く、幅広い担当者がデータを使えるデータ民主化を進めやすいサービスです。
Snowflakeを土台にしたオーダーメイド開発の範囲
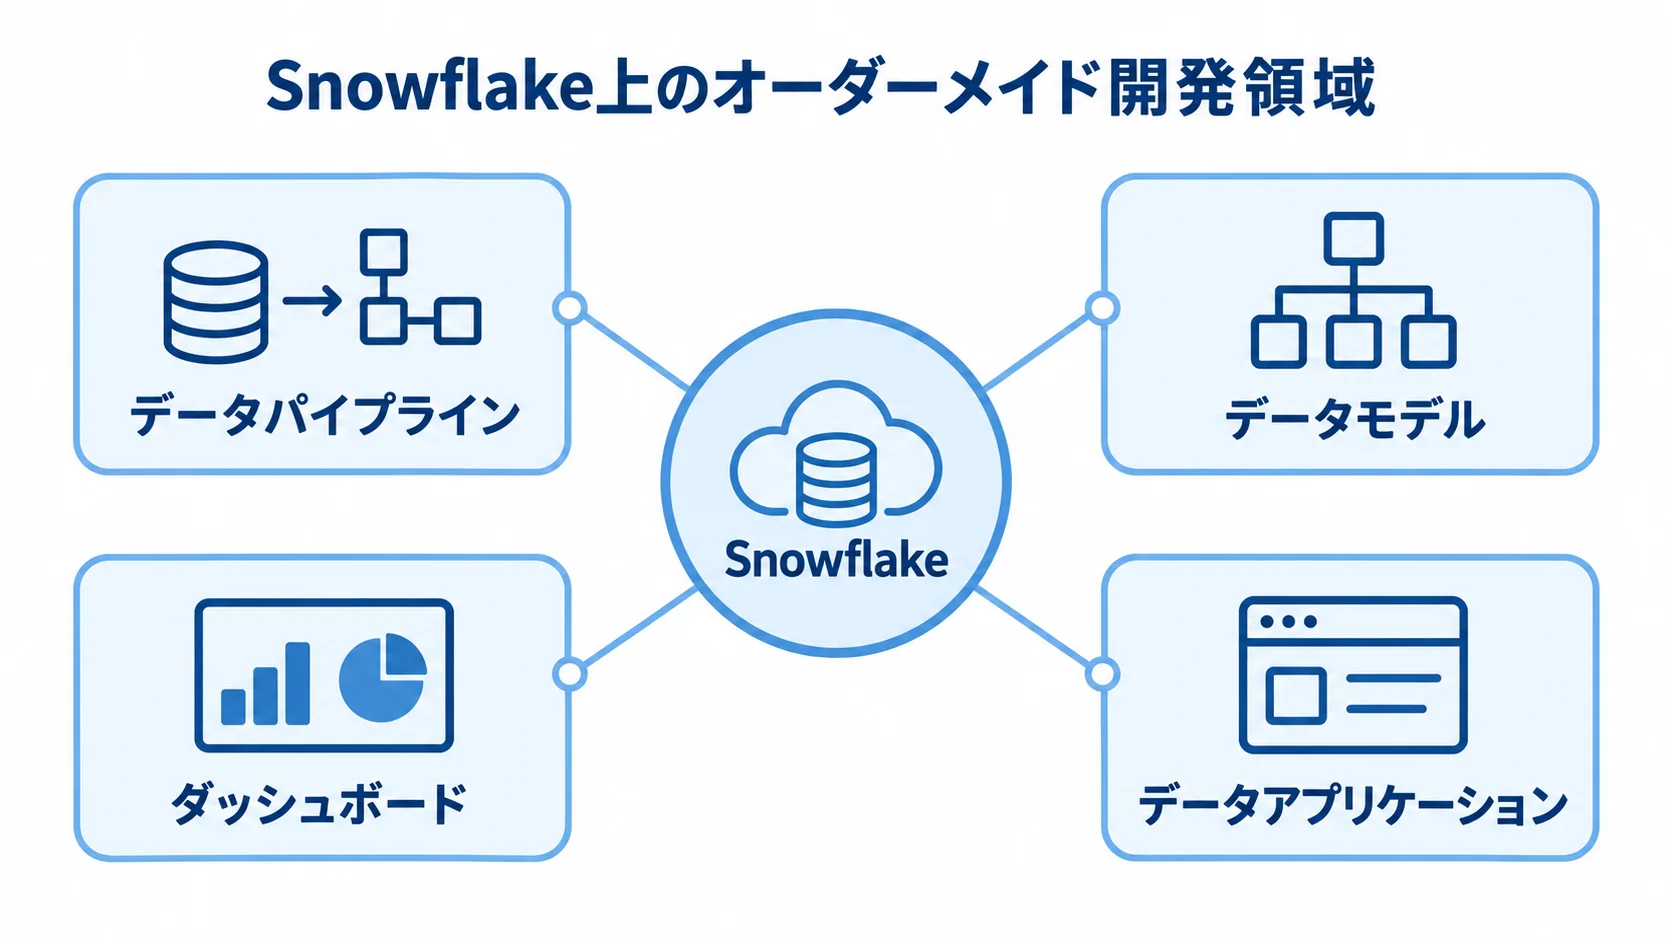
Snowflake導入後にどこまで作り込むかを整理すると、既製品で足りる部分と、独自に開発すべき部分の境目が見えてきます。Snowflakeは強力な土台ですが、それだけで自社業務に最適化された分析基盤になるわけではありません。
そこで構築するのが、データ取込のパイプライン、業務に合わせたデータモデル、意思決定に使うダッシュボードです。独自のデータアプリケーションも、同じ土台の上に作れます。
データパイプラインとデータモデルの構築
中心となる開発領域は、データパイプラインとデータモデルです。パイプラインとは、社内外のデータをSnowflakeに取り込み、分析に使える形へ整える一連の処理を指します。
- データ取込:SnowpipeやStreams & Tasks、Fivetranなどを組み合わせます。
- データ変換:dbtのロジックで、自社のデータソースに合う加工の流れを作ります。
- データモデル:スタースキーマやディメンショナル構造を、業務と分析要件に合わせて設計します。
- KPI設計:指標の定義や集計ロジックを、自社仕様に合わせて決めます。
Snowpipeは継続的な自動の読み込み、Streams & Tasksは変更データの捕捉とスケジュール実行に使う仕組みです。標準コネクタがない社内独自のシステムからデータを取得する場合は、API連携を自社で開発して橋渡しします。こうしたケースでは、オーダーメイドの作り込みが欠かせません。
データの粒度や指標の算出方法は企業ごとに異なるため、既製品では代替できないデータモデルが開発の中核になります。
実用的な基盤にするには、こうした仕組みをSnowflake上に要件どおり作り込むことが求められます。
データアプリケーションとAI活用の作り込み
可視化の先には、独自のデータアプリケーションやAI活用の開発があります。Snowparkを使うと、Snowflake上のデータに高度な処理や機械学習を実装できます。
- 独自分析:需要予測、異常検知、レコメンドを自社ロジックで実装できます。
- AI連携:SnowflakeからDatabricksへデータを渡し、本格的なモデルを構築できます。
Snowparkで使える言語はPython・Java・Scalaで、処理の構築と実行をSnowflake内で行えます。
金融サービスのように機密データを扱う場合や、データ品質とセキュリティを重視する組織では、データを外に出さずに処理できる点が価値になります。
まずはBI分析用のDWHとして導入し、後からDatabricksなどの機械学習環境へ連携する方法もあります。Snowflakeを、AIレディ基盤の中核に据える選択肢です。
自社は、Snowflakeのデータシェアリングやアプリ開発機能を土台に、社内向けツールや取引先向けのデータサービスも開発できます。
基盤はSnowflakeを使い、競争力に直結する独自の価値の部分を開発するのが賢明です。
フルスクラッチが適するケースと適さないケース
多くの企業にとっては、Snowflake導入と周辺のオーダーメイド開発が現実的です。ただし、限られた条件では、フルスクラッチが合理的になる場合もあります。
判断では、独自技術が競争優位になるか、規制上の理由で外部クラウドを使えないかを見極めます。
反対に、事業の初期段階では、Snowflakeが過剰になる場合もあります。
フルスクラッチが検討に値するケース
フルスクラッチが候補に入るのは、限られた条件が揃う場合です。そのうえで、条件ごとに、Snowflakeで代替できるかも確かめます。
- 独自技術:既製品では実現できない独自のアルゴリズムが、競争優位の源泉になっている場合。
- 外部利用の制約:規制上の理由で、データを外部クラウドに一切預けられないとき。
独自の仕組みが必要な場合でも、多くのケースは、Snowflake上のSnowparkなどで独自ロジックを作り込めます。
エンジンそのものを自作する必要があるのは、極めて特殊な性能要件や処理特性を持つ、ごく一部の先端事例に限られます。
データを外部クラウドに預けてよいかの判断には、機密性やコンプライアンス要件が関わります。Snowflakeには高いセキュリティと監査機能があり、金融サービスのリスク分析や不正検知でも採用されています。そこで、「クラウドだから使えない」と決めつける前に、要件を満たすかを先に検討します。
完全なオンプレミスや自社管理が必要な規制上の制約がある場合に初めて、自社構築が候補に入ります。
それ以外では、費用・期間・維持負担を踏まえて、Snowflake導入と周辺開発を選ぶのが合理的です。
スモールスタートではSnowflakeが過剰になる場合
事業のごく初期では、フルスクラッチとは逆に、Snowflakeが過剰(オーバースペック)になることがあります。最小構成でも維持費が割高になりがちだからです。
- 一般的なRDB:データ量が少なく、複雑な分析や大規模処理が不要な場合に検討します。
- 従量課金サービス:小さく安く試す段階では、Google BigQueryが向くこともあります。
Amazon RDSやPostgreSQLなら、一般的なリレーショナルデータベースで低コストに始められる場合があります。なお、BigQueryはクエリでスキャンした分だけ課金されるサービスです。
Snowflakeの本領は、複数のデータソースを一元化し、複数部門や複数のワークロードで使う段階で発揮されます。また、適切なサイジングで予算を固定しながら安定稼働させたい場合にも役立ちます。
フルスクラッチは要らなくても、Snowflakeにはまだ早い段階であれば、まずRDBで始める方法があります。データ量やAI活用の必要性が高まった時点で、Snowflakeへ移行する段階的な進め方も有効です。
自社の段階を見極め、フルスクラッチ、Snowflake導入、RDBでのスモールスタートから選ぶことが、投資対効果を高めます。
費用・期間の目安と発注時のポイント
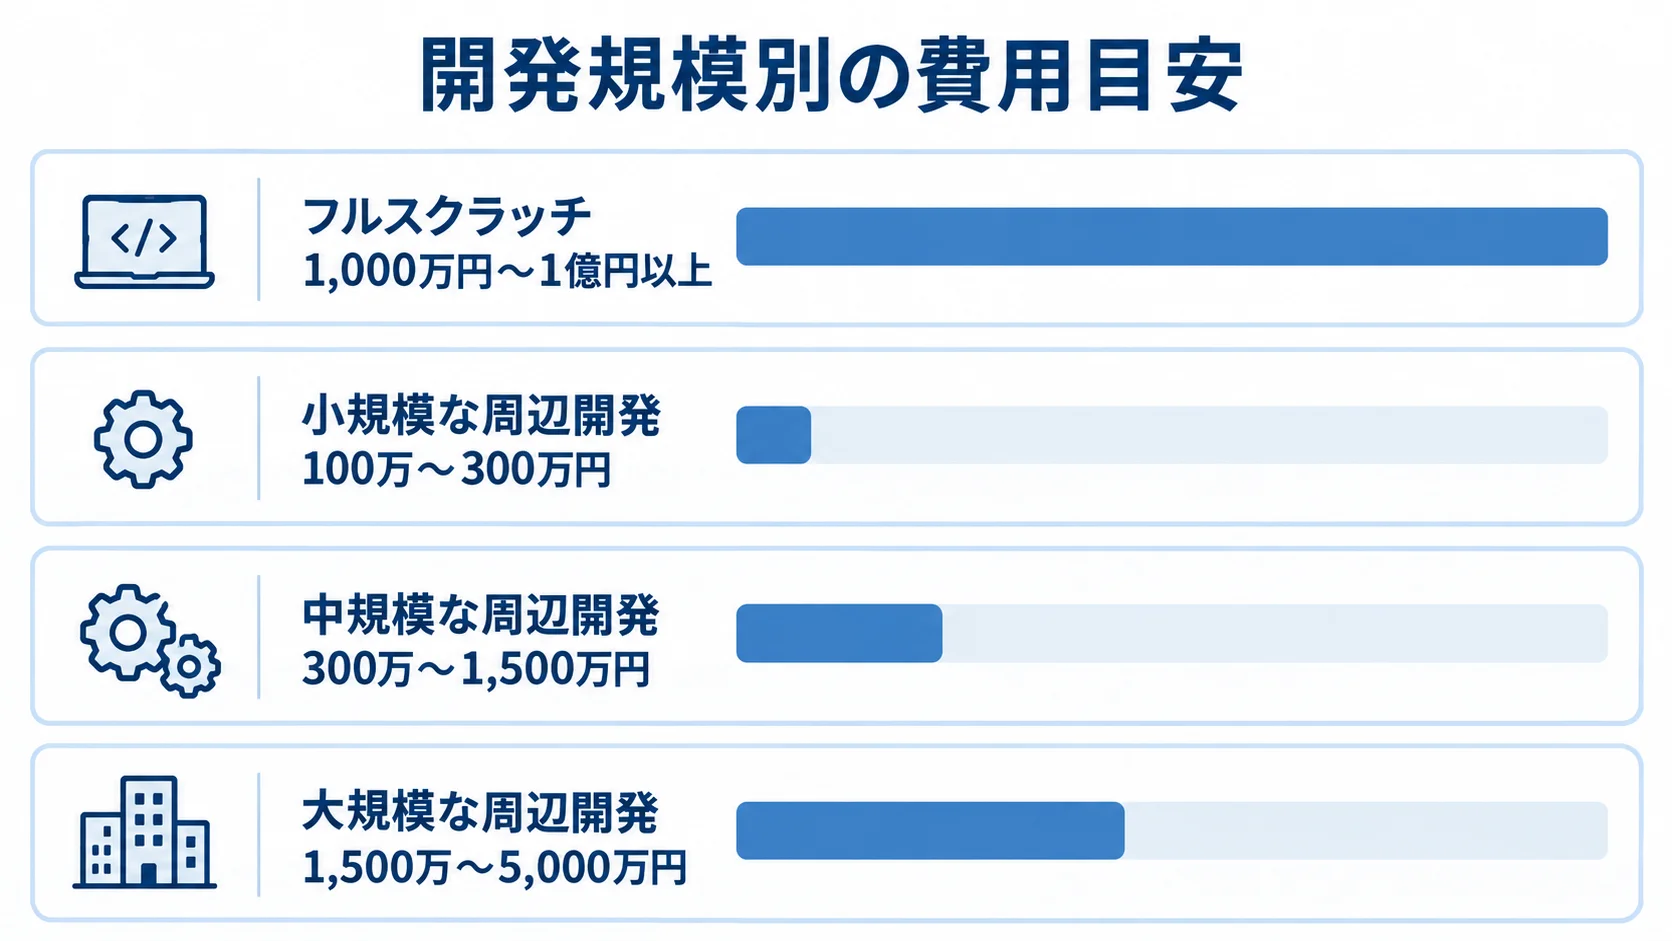
フルスクラッチと、Snowflake導入+周辺開発の費用・期間を比べると、判断材料がはっきりします。発注時の確認点も押さえておくと、意思決定の確度が上がります。
費用・期間の相場観
費用と期間は、基盤の中核まで作るか、Snowflake上の周辺機能を開発するかで大きく変わります。
- フルスクラッチ:1,000万円から1億円以上、期間は6か月から2年程度です。
- 小規模な周辺開発:100万〜300万円が目安です。
- 中規模な周辺開発:300万〜1,500万円が目安です。
- 大規模な周辺開発:全社基盤とAI活用を含み、1,500万〜5,000万円程度です。
フルスクラッチは、設計・実装・テスト・運用設計をゼロから行うため、規模が大きく、AIまで含む全社基盤ほど費用と期間が膨らみます。
Snowflake上にパイプラインやモデル、ダッシュボードを作る場合、期間は数か月から半年程度です。インフラ構築が要らず、取込やモデリング、可視化に集中できるため、費用と期間を抑えられます。
契約形態によっても費用は変わります。成果物の完成を約束する請負契約は、実工数に応じて支払う準委任契約と比べ、リスクプレミアム分を含めておおむね1.3〜1.5倍になる傾向です。
成果物が明確で要件が固まっていれば請負、要件が流動的でアジャイルに進めたい場合は準委任が基本です。
既製品で済ませられる部分を自作すると、費用が10倍かかっても効果は1.2倍程度にとどまりかねません。
つまり、自社独自の価値になる部分に絞って作り込むことが、費用対効果を高めます。
発注時に確認すべきポイント
Snowflakeを土台にした開発を外部に発注する際は、実績や開発範囲などを確認しておくと、失敗のリスクを下げられます。
- 構築・運用実績:Snowflakeを使った類似プロジェクトの経験があるかを見ます。
- 開発範囲:標準機能と独自開発の切り分けを、見積もりに明記してもらいます。
- 利用料:クレジットとストレージの想定と、最適化の方針です。
- 保守・拡張:運用支援の範囲と、将来の機能追加への対応を取り決めます。
データシェアリングなどの知見は、ウェアハウス設計やコスト最適化を含め、開発会社の実績によって品質が変わります。そのため、類似案件での経験を具体的に聞いておくことが大切です。
見積もりに、既製コネクタやツールで済む部分まで自作する内容が含まれていないかも、あわせて見ておきます。
運用後のランニングコストと最適化設計が、TCO(総所有コスト)を左右します。
Snowflakeは、ストレージとコンピュートが分離しているため、段階的に拡張しやすい仕組みです。
事前に確認項目を整理して複数社から相見積もりを取り、開発パートナーとの方針を見極めます。
まとめ
DWHエンジンを自作するのは、費用・期間・維持負担の面で現実的ではありません。そのため、Snowflakeを導入し、周辺機能を自社要件に合わせて開発するのが現実解です。
Snowflakeはマルチクラウドに対応しているため、ロックインを避けやすく、コンピュートとストレージの分離によって段階的に拡張できます。
標準SQLで扱いやすいため、RedshiftやDatabricksとは異なる担当者層にも開かれています。
開発の中核は、標準コネクタのない社内システムとのAPI連携と、業務に合うデータモデル、KPIです。
Snowparkを使えば、需要予測や異常検知などをデータを外部へ出さずに実装できます。
フルスクラッチが候補に入るのは、独自アルゴリズムが競争優位になる場合や、規制上データを外部に預けられない場合などです。多くの企業には、Snowflake導入と周辺開発が適しています。
費用と期間の目安は、フルスクラッチで1,000万〜1億円以上・6か月〜2年程度です。一方、Snowflake上の周辺開発では、100万〜5,000万円程度・数か月から半年程度です。
既製品を活用し、独自価値の部分だけを開発する方針を徹底します。加えて、実績のある開発会社を、範囲やコスト設計、拡張方針を合意したうえで選ぶことが大切です。
▼全体ガイドの記事
・Snowflake導入の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。