
データサイエンスコンサルは、ビジネス課題とKPIを明確にしたうえで、段階的に進める支援です。全体の流れは、課題定義とデータ調査から始まり、要件定義・設計、PoCを経て、本開発と運用へ進みます。
データサイエンスプロジェクトの85%以上は期待した成果を得られないとも言われ、進め方の理解が成功の鍵です。
▼全体ガイドの記事
・データサイエンスコンサルの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
データサイエンスコンサルの全体像
データサイエンスコンサルは、統計学・機械学習・データエンジニアリングの知識を使い、企業のビジネス課題をデータで解決する支援です。
本来の価値は、課題の定義から分析手法の選定、モデルの構築・運用、組織へのナレッジ定着まで、一気通貫で支援する点にあります。データ分析の受託作業とは、支援の範囲が異なります。
データサイエンスコンサルの担当範囲
支援は、分析の狙いを定める戦略立案と、モデルを現場で使える形にする技術実装に分かれます。
- 分析戦略:分析の対象と目的を明確にし、取り組む優先順位を整理します。
- 技術実装:モデルの構築・検証・本番実装から、継続的な改善まで担います。
分析技術だけを切り出して外部に任せると、ビジネス課題とのつながりが弱まり、データ活用が失敗する一因になります。
そのため、優れたコンサルタントには、経営・事業とエンジニアリングの双方の視点が求められます。「なぜこの分析をするのか」に答えられることが大切です。
CRISP-DM(Cross-Industry Standard Process for Data Mining)は、国際的な標準プロセスです。6段階を定めており、前半はビジネス理解、データ理解、データ準備の順に進みます。
後半はモデリング、評価、デプロイメントです。この6段階のサイクルを繰り返すことが、プロジェクト成功の基本とされています。
データサイエンスコンサルの支援タイプ
支援範囲は、課題や社内体制に応じて、主に3つのタイプから選べます。
- 戦略・企画フェーズ型:データ戦略の策定や分析ロードマップの作成を担います。
- 分析・モデリング型:統計分析や機械学習モデルの構築・評価を行います。
- エンド・ツー・エンド型:課題定義から本番実装・運用改善まで一貫して対応します。
依頼する企業の状況によって、適切な支援タイプは異なります。
データ活用の方向性がまだ定まっていない段階では、戦略・企画フェーズ型が有効です。一方で、課題が明確でモデル構築に特化したい場合は、分析・モデリング型が効率的です。
社内にデータエンジニアやインフラ担当者が少ない企業には、エンド・ツー・エンド型が向いています。また、初めてデータ活用に取り組む企業にとっても、失敗リスクを抑えやすい選択肢です。
データサイエンスコンサルの進め方・全体フロー
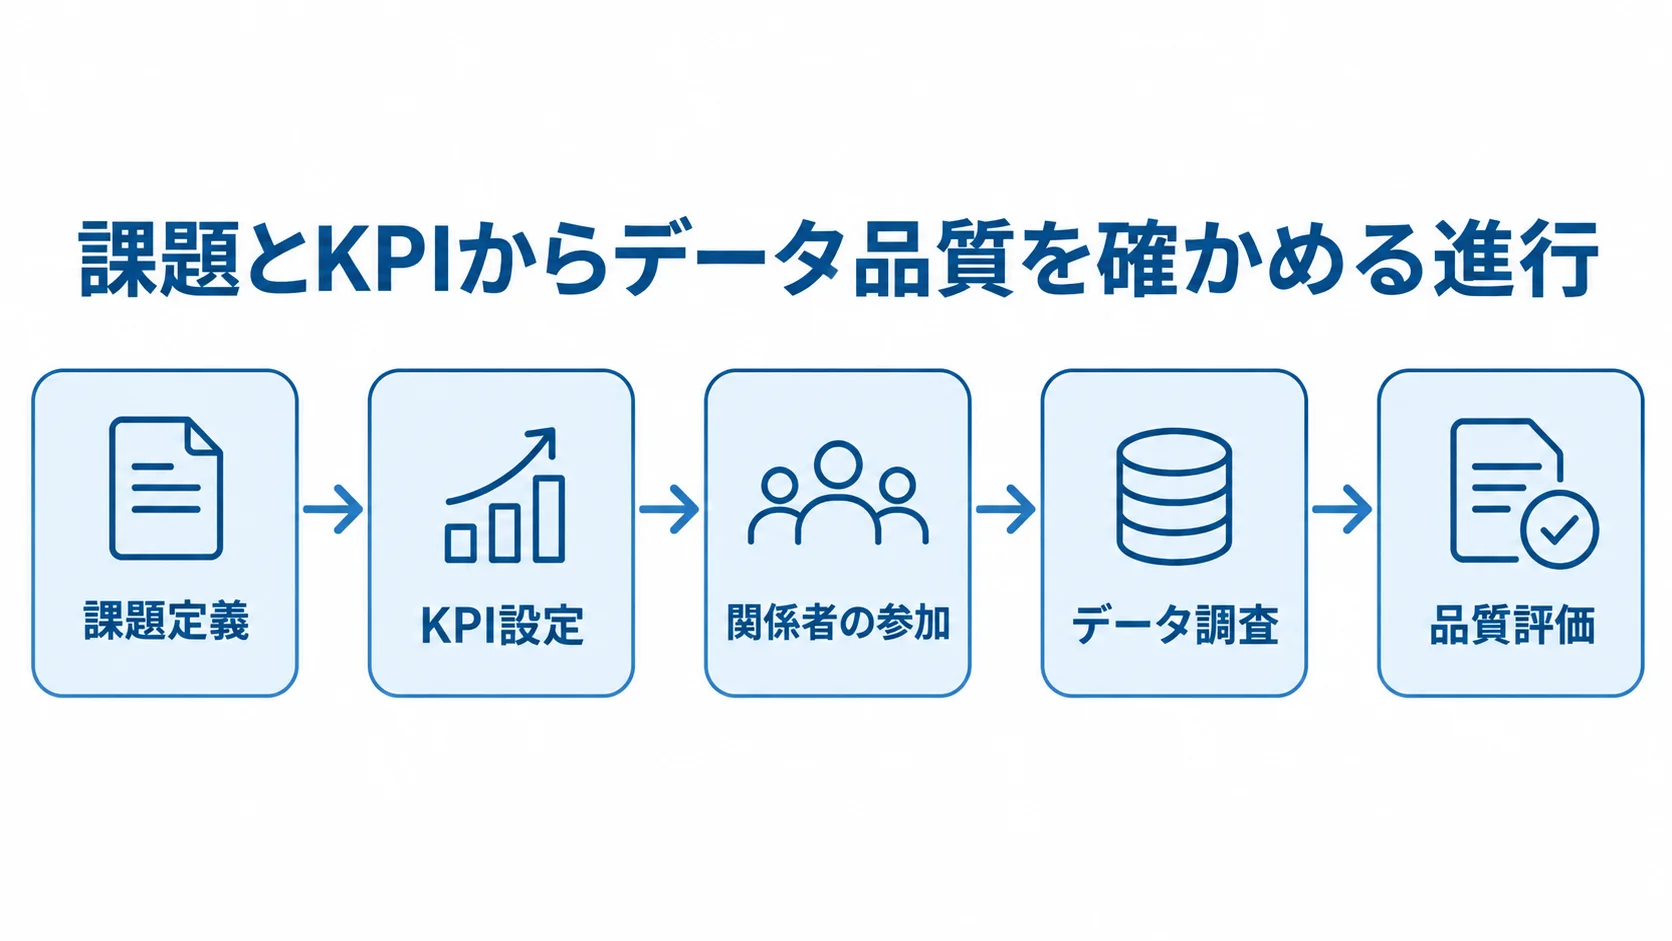
データサイエンスコンサルを成功させるには、標準的なプロセスを理解し、各フェーズで何を達成するかを明確にしておくことが大切です。
現場での実践経験をもとにすると、典型的な進め方は、課題の定義から運用までの各フェーズを順に進む形になります。
フェーズ1:ビジネス課題の定義とKPI設定
まず、事業上の課題を整理し、成果を判断するKPIまで決めておきます。
- 課題定義:売上低迷、解約率の高さ、在庫ロスなどを出発点に、データで解く問題へ落とし込みます。
- KPI設定:顧客離脱予測では、解約率を8%から5%以下へ下げる、F1スコアを0.75以上にする等を定めます。
- 関係者の参加:データサイエンティスト、事業担当者、マネジメント層でワークショップを行います。
KPIがないと最終的な評価基準が定まらず、成功か失敗かを判断できないまま終わるおそれがあります。
ビジネス側とデータ側の視点をそろえておくと、実装後に「使われないモデル」が生まれるリスクを減らせます。
フェーズ2:データ調査とデータ品質の評価
次に、課題を解くために必要なデータを洗い出し、利用できる状態かを確かめます。
- データ調査:データソースごとに量・更新頻度・粒度・欠損率を調べます。
- 品質評価:欠損値・外れ値・重複・データ型の不整合など、分析を妨げる問題を特定します。
- 工数の見積もり:国内企業では、データクレンジングに全体工数の50〜70%を費やすケースもあります。
データソースの洗い出しは、データカタログの整備とも呼ばれ、全体の範囲を決める重要な作業です。データが複数のシステムに分かれていたり、Excelで手作業管理されていたりすると、クレンジングの工数がかさみます。
実際のデータの状況を把握しておくと、後の工程でデータ不足や品質の問題により分析が止まる事態を避けやすくなります。
要件定義・設計フェーズの進め方
データの現状を把握できたら、実際に何を作るのかを具体的に決める要件定義・設計フェーズに進みます。
要件定義・設計では、分析手法を選び、データパイプラインを設計し、出力の形式(レポート、ダッシュボード、APIなど)を決めます。
分析手法・モデルの選定
分析手法は、解決するビジネス課題と、利用できるデータの特性に合わせて選びます。
- 予測系:売上予測・需要予測・故障予知には、時系列モデルや回帰モデルが有効です。
- 分類系:顧客セグメント・離脱予測・不正検知には、ランダムフォレスト・勾配ブースティング・ニューラルネットワークなどを使います。
- 最適化系:在庫最適化・価格最適化には、線形計画法や強化学習が適しています。
最先端の手法を選ぶことよりも、ビジネス課題に対して説明でき、現場で使い続けられることが大切です。
複雑なディープラーニングより、精度はわずかに劣っても解釈しやすい決定木の方が、現場に定着しやすい場合があります。
担当者が理解・運用できるモデルを提案できるかは、コンサルタントの信頼性を見極める一つの基準です。
データパイプラインとインフラ設計
分析基盤では、データを集めて活用するまでの流れと、本番運用に必要な安全対策を設計します。
- クラウド基盤:AWS・Google Cloud・Azureで、データウェアハウスやデータレイクを設計します。
- 既存システム連携:ETL(Extract/Transform/Load)パイプラインを構築します。オンプレミス環境では、APIや転送方式も検討します。
- セキュリティ:権限管理、暗号化、監査ログを、設計の段階から組み込みます。
データの収集から加工、蓄積、活用までを一貫して設計しておくと、分析基盤を安定して動かし続けられます。
個人情報保護法やGDPR(EU一般データ保護規則)への対応が必要な場合は、法務部門とも連携します。
PoC(概念実証)から本開発への進め方
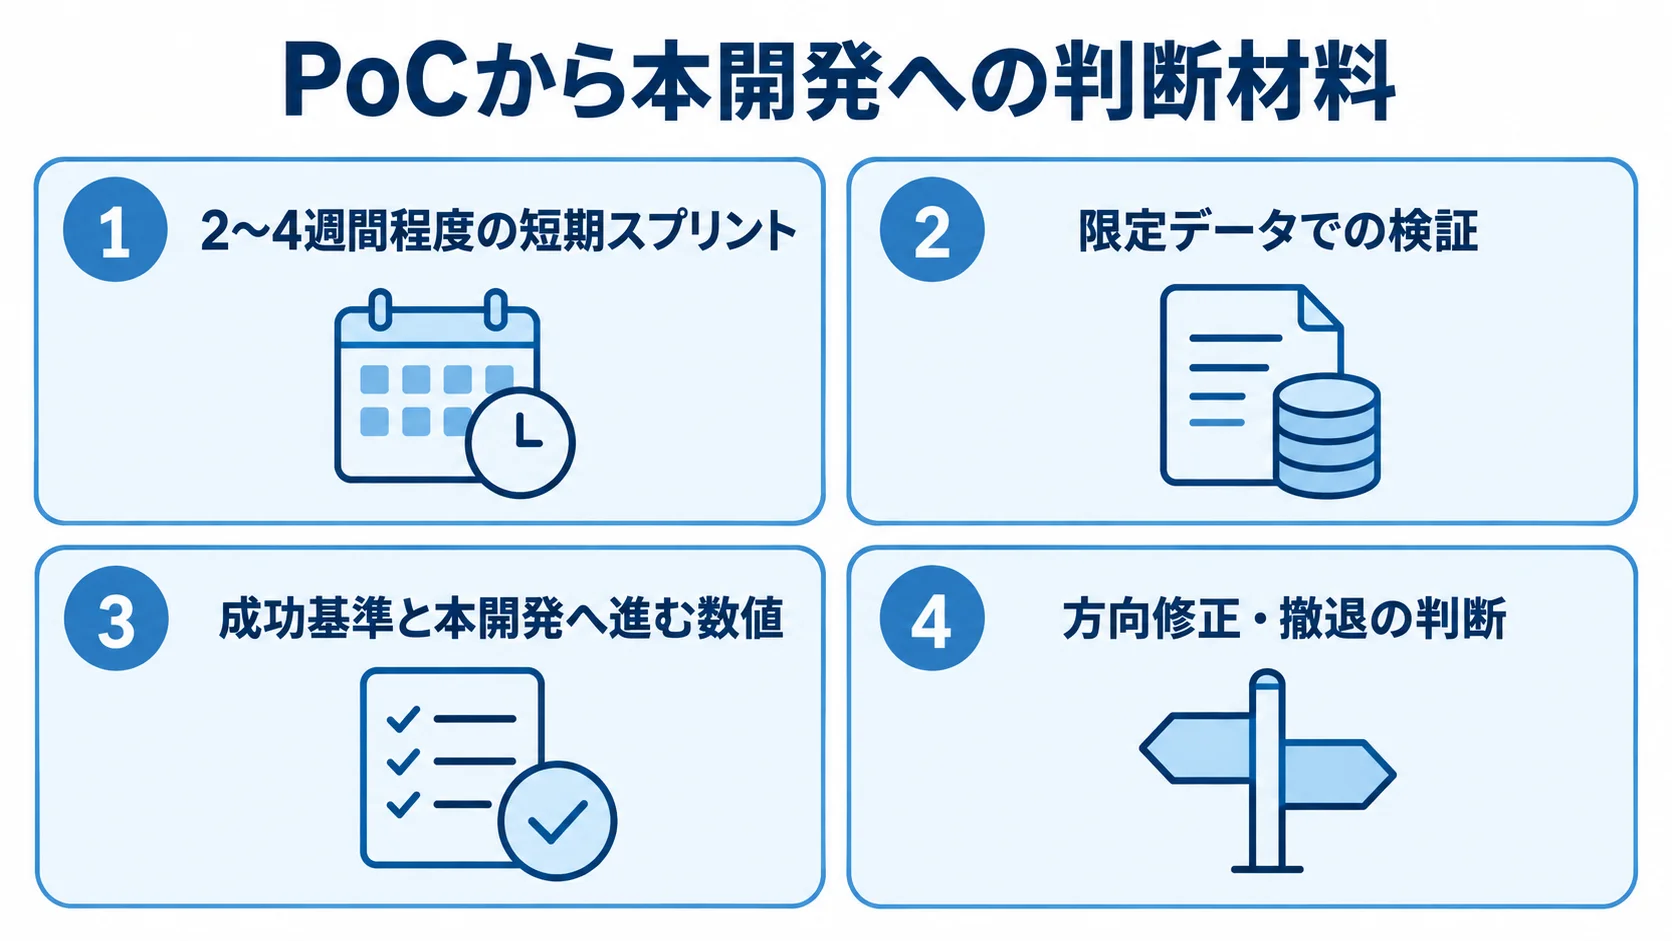
データサイエンスコンサルにおいて、PoC(Proof of Concept:概念実証)は非常に重要な工程です。
本格投資の前に小さな規模で仮説を検証し、技術面の実現可能性とビジネス面の価値を確かめることで、大きなリスクを避けられます。
PoCの進め方と評価基準の設定
PoCは、本格投資の判断材料を得るために、開始前から進め方を決めておく工程です。
- 期間:PoCは一般的に、2〜4週間程度の短期スプリントで行います。
- 検証:限定データで最小限のモデルを作り、事前に定めたKPIに対する精度や効果を確かめます。
- 比較:需要予測では過去データでバックテストを行い、人手による予測からの改善幅を測ります。
- 事前合意:成功基準と本開発へ進む数値を、開始前に合意しておきます。
- 結果への対応:基準を下回った場合は、方向修正か撤退かを判断します。
PoC開始前にKPIを設定していない企業では、本導入率が設定済み企業の半分以下というデータもあります。
結果が期待を下回った場合も、データ不足や仮説の誤り、技術的な制約などを分析すると、次の判断に活かせます。
本開発・本番実装への移行判断
PoCで有効性が確認できたら、試作モデルを本番環境で使える品質と規模に引き上げます。
- 本番化:パラメータを調整してAPIを実装し、データパイプラインの自動化と監視機能の追加まで行います。
- 段階展開:全社一斉に広げるより、1部門や1拠点から展開するほうが、問題を早く見つけられます。
- 事例:大手小売チェーンでは、全店舗への一斉展開に失敗したのち、2店舗のパイロットに切り替えて成功した例があります。
段階的に導入すると、現場のフィードバックを取り込み、モデルを改善するサイクルも作れます。
モデル運用・改善フェーズ(MLOps)の進め方
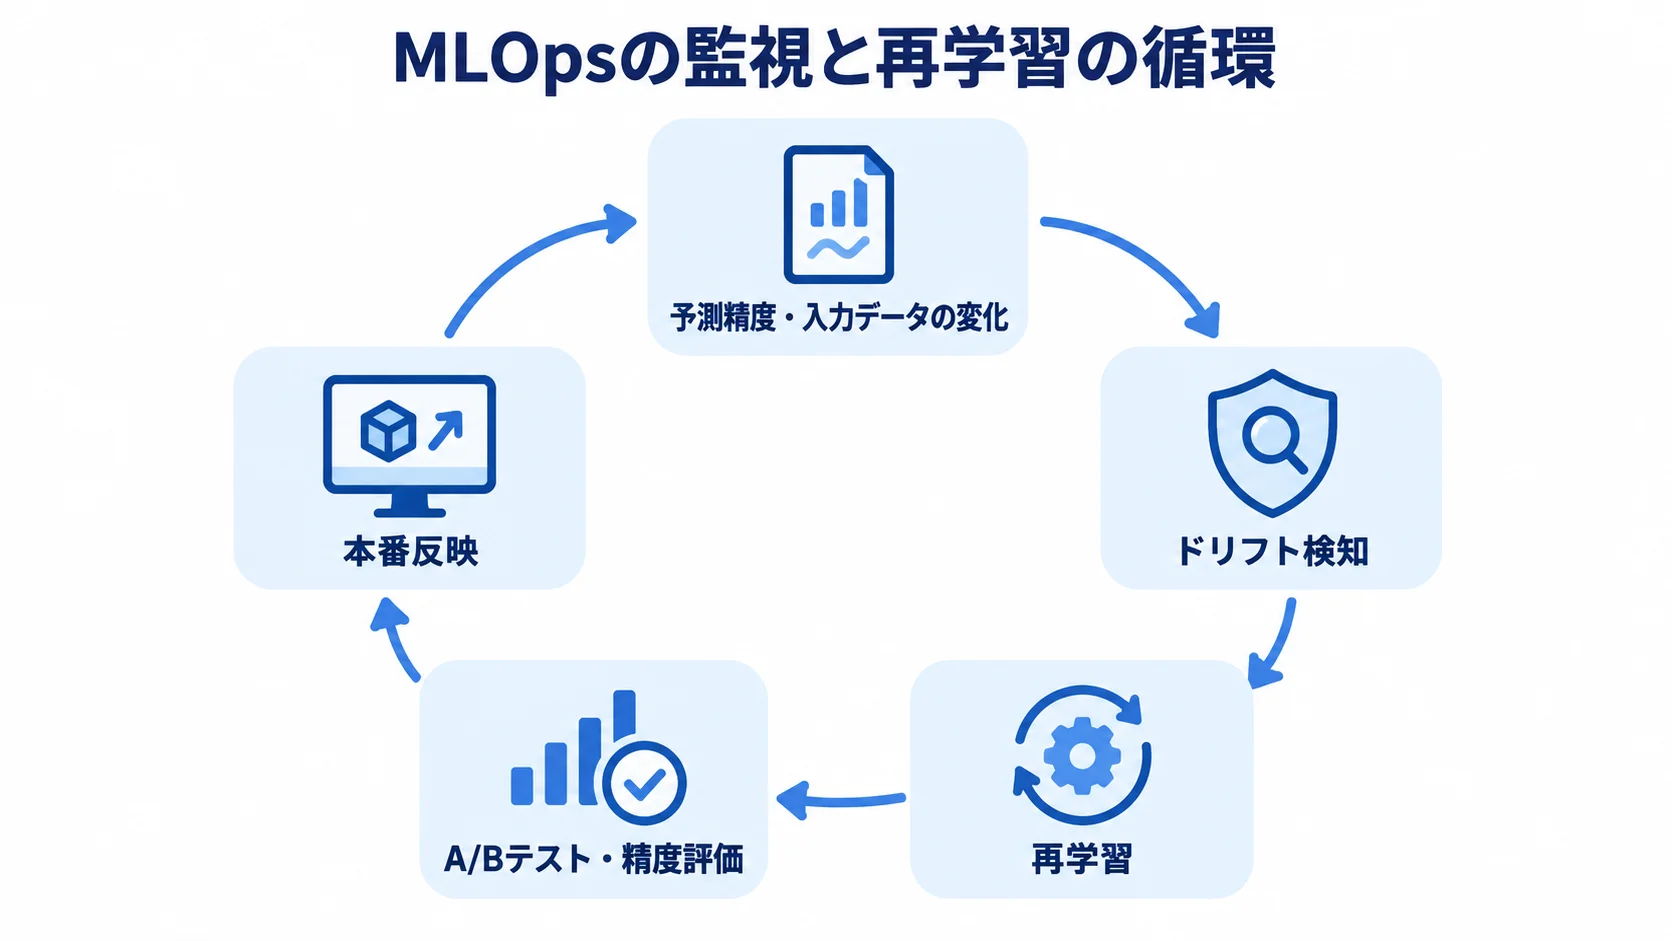
機械学習モデルは、本番環境へデプロイした後も、継続的な監視と改善が欠かせません。時間とともに精度が劣化する(データドリフト)ため、定期的な再学習と評価が必要です。
継続的な運用の体制は「MLOps(Machine Learning Operations)」と呼び、近年は急速に重要性が高まっています。
モデル監視と再学習の仕組み
本番モデルは、予測精度と入力データの変化を継続して確かめ、必要に応じて再学習します。
- 監視:予測精度、レイテンシ、データ品質の3点を継続して確認します。
- 精度低下への対応:予測値と実績の誤差を集計し、閾値を超えたら再学習を始めます。
- ドリフト検知:入力データの分布の変化を見て、学習時と異なる環境で動いていないかを確かめます。
- 再学習の頻度:ECの購買予測は月次、設備の故障予知は四半期ごとが適する場合があります。
- 本番反映:再学習後は、A/Bテストや精度評価を経てから本番に反映します。
再学習の周期は、ビジネス環境が変わる速さに合わせて設計します。
社内への知識移転と自立化
コンサルティングの終了後も、企業が自力でデータ活用を続けられるよう、知識移転と内製化を進めます。
- 知識共有:分析手法を文書にまとめ、社内担当者へハンズオントレーニングを行います。
- 環境整備:分析環境の用意も支援し、社内で作業を続けられる状態をつくります。
- 役割移行:当初はコンサルタントが主導し、成熟後は社内が主導して、コンサルタントはレビューする形へ移します。
コンサルタントへの依存を段階的に下げることは、長期的なコスト削減につながります。
役割の移行を意識して設計すると、持続可能なデータ活用の体制を組みやすくなります。
データサイエンスコンサルの費用相場とコスト構造
データサイエンスコンサルの費用は、プロジェクトの規模や複雑さ、期間、依頼先の種類によって大きく異なります。
コスト感を正確につかんで予算を立てることは、プロジェクトの範囲を適切に決めるうえでも欠かせません。
人件費と工数の内訳
費用の中心は人件費で、参加する専門職やプロジェクトの工程によって金額が変わります。
- 月額単価:2025年時点で、フリーランスは80万〜150万円、ファームへの外注は150万〜250万円が目安です。
- 複数職種:PM・データエンジニア・MLエンジニアが加わると、月額500万円を超える場合もあります。
- 工程別費用:フェーズ1の課題定義・データ調査は50万〜150万円、フェーズ2の要件定義・PoCは100万〜300万円です。
- 開発・運用:フェーズ3の本開発・実装は200万〜1,000万円以上、フェーズ4の運用・保守は月額30万〜100万円が目安です。
- データ整備:データクレンジングだけで50万円以上かかる場合もあります。
データクレンジングに時間がかかると、当初の人件費の見積もりに費用が上積みされます。
インフラ費用とランニングコスト
人件費のほかに、データ基盤や本番モデルを維持するランニングコストがかかります。
- 基盤利用料:AWS・GCP・Azureのデータウェアハウス利用料、ストレージ、モデル推論に、月額数万円〜数十万円かかります。
- 利用量の影響:データ量が増えるほど保管費が増え、リアルタイム推論では計算費用が高くなる傾向があります。
- 運用保守:本番稼働後の監視、再学習、改善には、月額30万〜100万円程度を想定します。
運用費用も、初期の予算計画に含めておくことが大切です。含めずに初期費用だけで見積もると、精度が劣化したモデルの再学習費を確保できず、効果が下がったまま使い続けるおそれがあります。
見積もりを取る際のポイントと発注先の選び方
発注を成功させるには、見積もりの取り方と発注先の選定が欠かせません。相見積もりは必須ですが、価格だけで比べると後悔するケースもあります。
要件の明確化とRFP(提案依頼書)の作成
見積もりの精度を上げるには、RFP(Request for Proposal:提案依頼書)で依頼内容を明確にします。
- 課題とKPI:解決したいビジネス課題と評価指標を書きます。
- データ:利用できるデータの概要と量を示します。
- 出力形式:ダッシュボード、API、分析レポートなど、期待する形式を記載します。
- 予算・期間:プロジェクトの期間と、想定する予算の規模を示します。
- 社内体制:担当者の技術レベルや利用できるリソースを書きます。
曖昧なRFPは、見積もりがばらつく原因になり、後の範囲変更による追加費用にもつながります。
依頼内容が固まっていない場合は、複数社に相談し、課題整理の支援を受ける方法もあります。
相見積もりの際は、担当するコンサルタントにデータサイエンティストが含まれるかも確認します。特に、営業担当が主導し、分析担当者との連携が薄い場合は、現場での実装力に不安が残ることがあります。
発注先の評価基準と比較ポイント
発注先は、価格だけでなく、技術と業務の両面から比較します。
- 技術力:自社の課題に近い業種や手法の実績を、具体的に説明できるかを確認します。
- 本番運用実績:PoCだけでなく、本番実装と継続運用の経験があるかを見ます。
- 対話力:課題や進捗を共有しながら、担当者と円滑に連携できるかどうかです。
- 継続支援:運用保守や改善まで担う体制があるかを比べます。
自社の業界や業務プロセスへの理解は、課題設定の質に影響します。
技術力だけでなく、ビジネス課題を理解するパートナーを選ぶことが、長期的な成功につながります。
注意すべきリスクと失敗を防ぐ対策
よくある失敗は、課題・データ・運用の前提を確かめないまま進めることです。
- 課題定義:「分析したい」「AIを導入したい」だけで始めず、ビジネス課題とKPIを明確にします。
- データ品質:社内にデータがあっても不完全な場合があるため、開始前に現状を調べます。
- 運用設計:開発だけで終わらせず、本番実装・監視・改善を含む支援内容を確認します。
運用の計画を立てずに進めると、モデルの精度が劣化して使われなくなるおそれがあります。そのため、発注先を選ぶ段階から運用をどう支援するかを確かめておくと、こうした失敗を防ぎやすくなります。
まとめ
データサイエンスコンサルは、フェーズごとに段階を踏んで進めるものです。
成功の出発点は、ビジネス課題とKPIを明確にすることです。そのうえで、データ調査と要件定義からPoC、本開発へと進み、MLOpsによる継続運用まで着実に進めます。
重要なのは、技術的な分析能力だけでなく、ビジネス課題への深い理解と、現場への定着まで見据えたパートナーを選ぶことです。
費用の相場を把握したうえで、RFPによる要件の明確化、複数社との相見積もり、担当者のスキル確認を徹底することが、プロジェクトの成功率を高めます。
データサイエンスコンサルは、一度で終わるプロジェクトではなく、継続的なデータ活用の体制を築くための取り組みです。
知識移転と自立化を意識した協業が、長期的なデータ活用の価値を高めます。まずは自社の課題を整理し、適したコンサルタントに相談しましょう。
▼全体ガイドの記事
・データサイエンスコンサルの完全ガイド
開発を相談する前に、次のホワイトペーパーもご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。