
データモダナイゼーションの開発期間は、要件定義から本稼働まで約6〜12ヶ月が目安です。移行アプローチやデータの汚れ具合で、数ヶ月から2年以上まで変わります。
期間を見積む出発点は、移行アプローチとデータ品質を先に確かめることです。確かめないまま進めると、経営層への説明とのズレや、稼働直後のデータ不整合を招きやすくなります。
▼全体ガイドの記事
・データモダナイゼーションの完全ガイド
レガシーシステム刷新の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「レガシーシステム刷新の完全ガイドブック」で詳しく解説しています。
データモダナイゼーションの定義と対象範囲(データ層)
データモダナイゼーションの開発期間を正しく見積もるには、まず対象を明確にしておく必要があります。ここでいうデータモダナイゼーションは、すでに稼働している老朽化したオンプレミスのRDBMS(Oracle、SQL Serverの古いバージョンなど)を扱います。部門ごとに個別に作り込まれたExcel・CSV・レガシーなファイル形式のデータ資産も含まれます。
それらをクラウドネイティブなDWH・データレイクへ移行し、データモデルそのものを正規化・再設計する取り組みです。長年の改修で継ぎ足された古いデータモデルは、アプリケーション側のコードをいくら新しくしても、変更速度・整合性・拡張性のボトルネックになり続けます。そのため、データそのものの刷新に踏み込まない限り、モダナイゼーションの効果は限定的にとどまります。
開発期間を見積む出発点は、このデータ資産の老朽化の度合いと、どの手法で解消するかの選定にあります。
アプリケーションのモダナイゼーションとの違い(アプリ層 vs データ層)
アプリケーションのモダナイゼーションは、ユーザーが直接操作する画面やロジック、つまりアプリケーション層の刷新に主眼を置きます。たとえば、モノリシックな構造のマイクロサービス化や、フロントエンドのモダンフレームワーク化が該当します。一方、データモダナイゼーションが扱うのは、そのアプリケーションが読み書きするデータベース・データ基盤そのものです。
両者は、独立して発生することもあれば、同じプロジェクトの中で並行して進むこともあります。対象とするレイヤーが異なるため、開発期間の見積もり方も別々に考える必要があります。実際、アプリケーション層の刷新だけを進めても、背後のデータモデルが古い継ぎ足し構造のままであれば、データ抽出や整合性維持のボトルネックは解消されません。
逆に、データ層だけを先行して刷新し、後からアプリケーション層を段階的にモダナイズしていく進め方も、データモダナイゼーション特有の現実的な選択肢です。
DWH導入(グリーンフィールド)との違い(Brownfield=既存データ基盤の刷新)
「DWH導入」を検討する際に多くの企業がイメージするのは、新規に分析基盤を立ち上げる「グリーンフィールド(Greenfield)」型のプロジェクトです。一方、データモダナイゼーションが扱うのは、すでにデータが蓄積・運用されている「ブラウンフィールド(Brownfield)」型のプロジェクトです。対象は、老朽化したオンプレRDBMSや個別に作り込まれたレガシーなデータ資産です。
移行元システムからの抽出方式の調査、長年の運用で蓄積された表記ゆれ・重複・欠損への対処、新旧基盤の並行稼働中の整合性検証など、ゼロから作るDWH導入にはない固有の論点が数多く発生します。この違いを理解しないまま新規DWH導入と同じ感覚で期間を見積もると、移行元データの品質調査とクレンジングにかかる期間を過小評価してしまいがちです。
開発期間・スケジュールの全体像(工程別の期間配分)
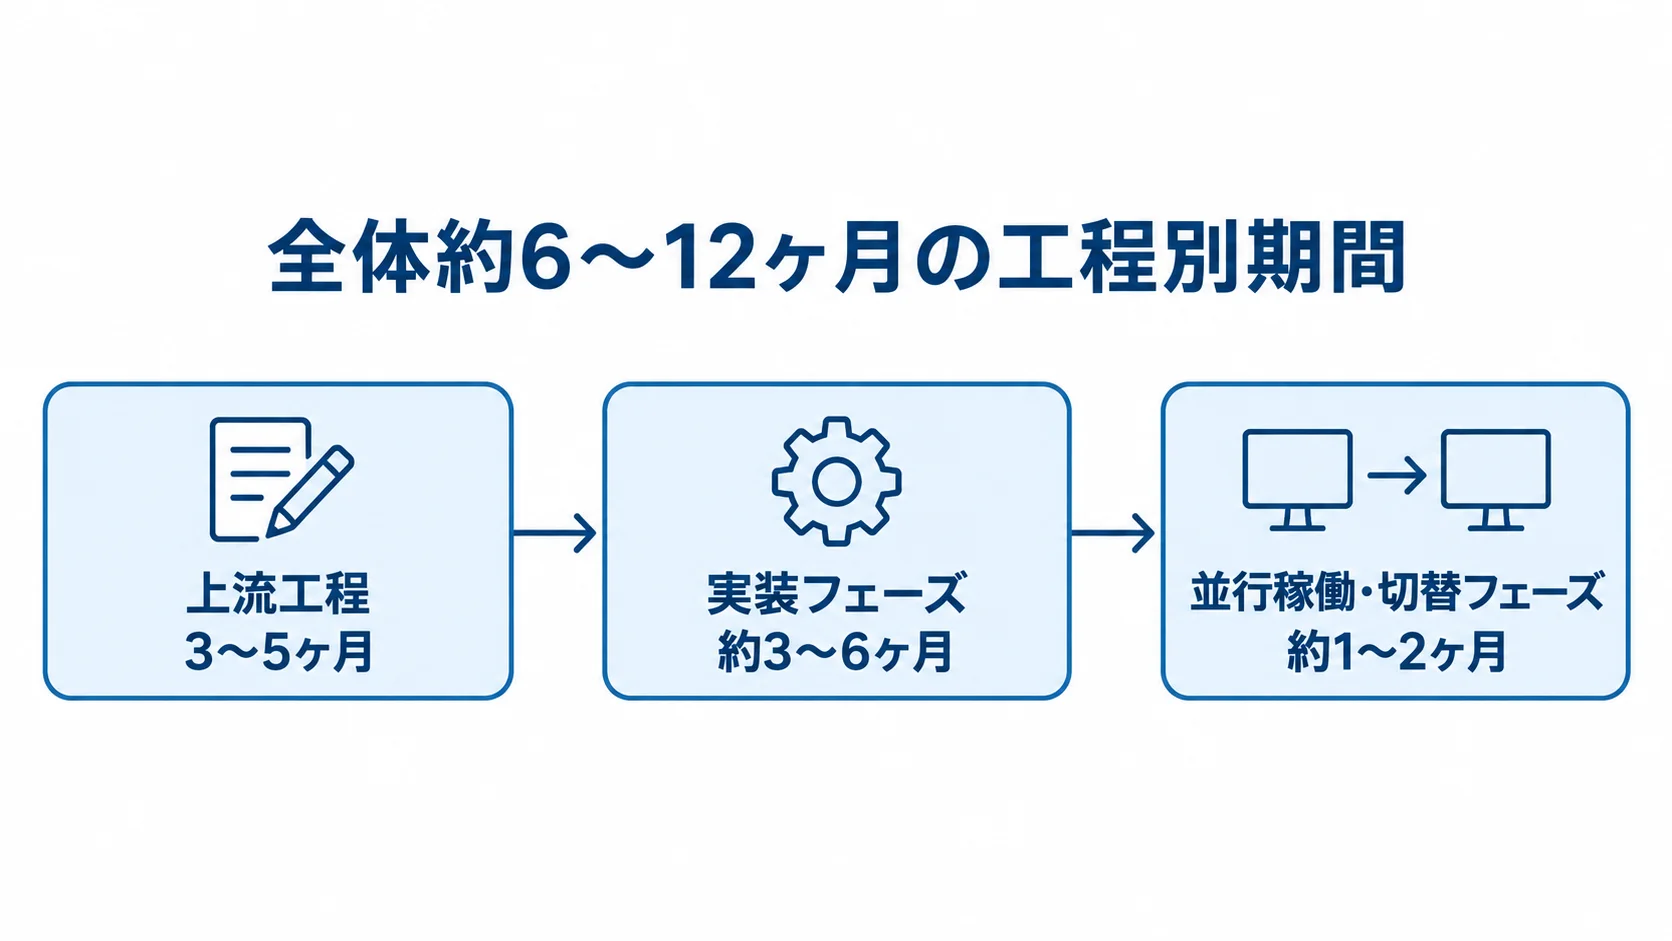
データモダナイゼーションのプロジェクト全体は、移行元システムの数やデータの汚れ具合に大きく左右されます。一般的な目安は、要件定義から本稼働までを合計して約6〜12ヶ月です。全体スケジュールを描くときは、実装フェーズだけでなく、その前の上流工程と本稼働後の定着化フェーズも含める必要があります。
実装に入る前の「現状データアセスメント〜移行計画策定」だけでも数ヶ月を要します。この段階の精度が後続フェーズの手戻りを大きく左右するため、工程ごとの期間の目安を順に見ていきます。
現状データアセスメント〜移行計画策定までの上流工程
上流工程は3つのステップで構成されるのが一般的です。1つ目の現状データアセスメントでは、移行元データベースのテーブル構造・依存関係・データ量を可視化します(約1〜2ヶ月)。その際、テーブル数・外部キー制約・ストアドプロシージャへの依存を洗い出し、データモデルにどこまで手を入れる必要があるかを見極めます。
2つ目はデータソース調査と分析要件の整理で、どのデータを誰がどう分析するかを一覧にします(約1ヶ月)。3つ目は移行手法の選定と計画策定で、対象データ領域ごとに5つのアプローチのどれを適用するか、どのクラウドDWH製品を選ぶかを決めます(約1〜2ヶ月)。この上流工程だけで合計3〜5ヶ月程度を要することが多いです。
ここを省略して実装に急ぐと、移行対象データの範囲やクレンジング方針を誤り、後工程で大きな手戻りが発生するリスクが高まります。
データパイプライン構築〜並行稼働・本稼働切替までの期間
計画が固まった後の実装フェーズは、データパイプライン(ETL/ELT)の構築とデータクレンジングが中心で、期間の目安は約3〜6ヶ月です。なかでも、ここはデータモダナイゼーション全体で最も工数の大きい山場になります。
移行元RDBMSから抽出したデータを分析に適した形へ変換し、表記ゆれ・重複・欠損を解消したうえでクラウドDWHへロードする一連の処理を構築します。あわせて、日次・時間次でのデータ差分連携の仕組みも整備します。パイプラインが構築できたら、新旧データ基盤を並行稼働させ、集計結果の数値が一致するかを検証します。
そのうえで、本稼働へ切り替え、移行・定着化フェーズに入ります。この並行稼働・切替フェーズには約1〜2ヶ月を見込んでおくのが現実的です。ここを「実装が終われば移行は一瞬で完了する」と誤解すると、本稼働直後にデータ不整合が発覚し、業務の意思決定に影響が及ぶリスクが高まります。
移行アプローチ別の開発期間の違い(データ層における5つの手法)
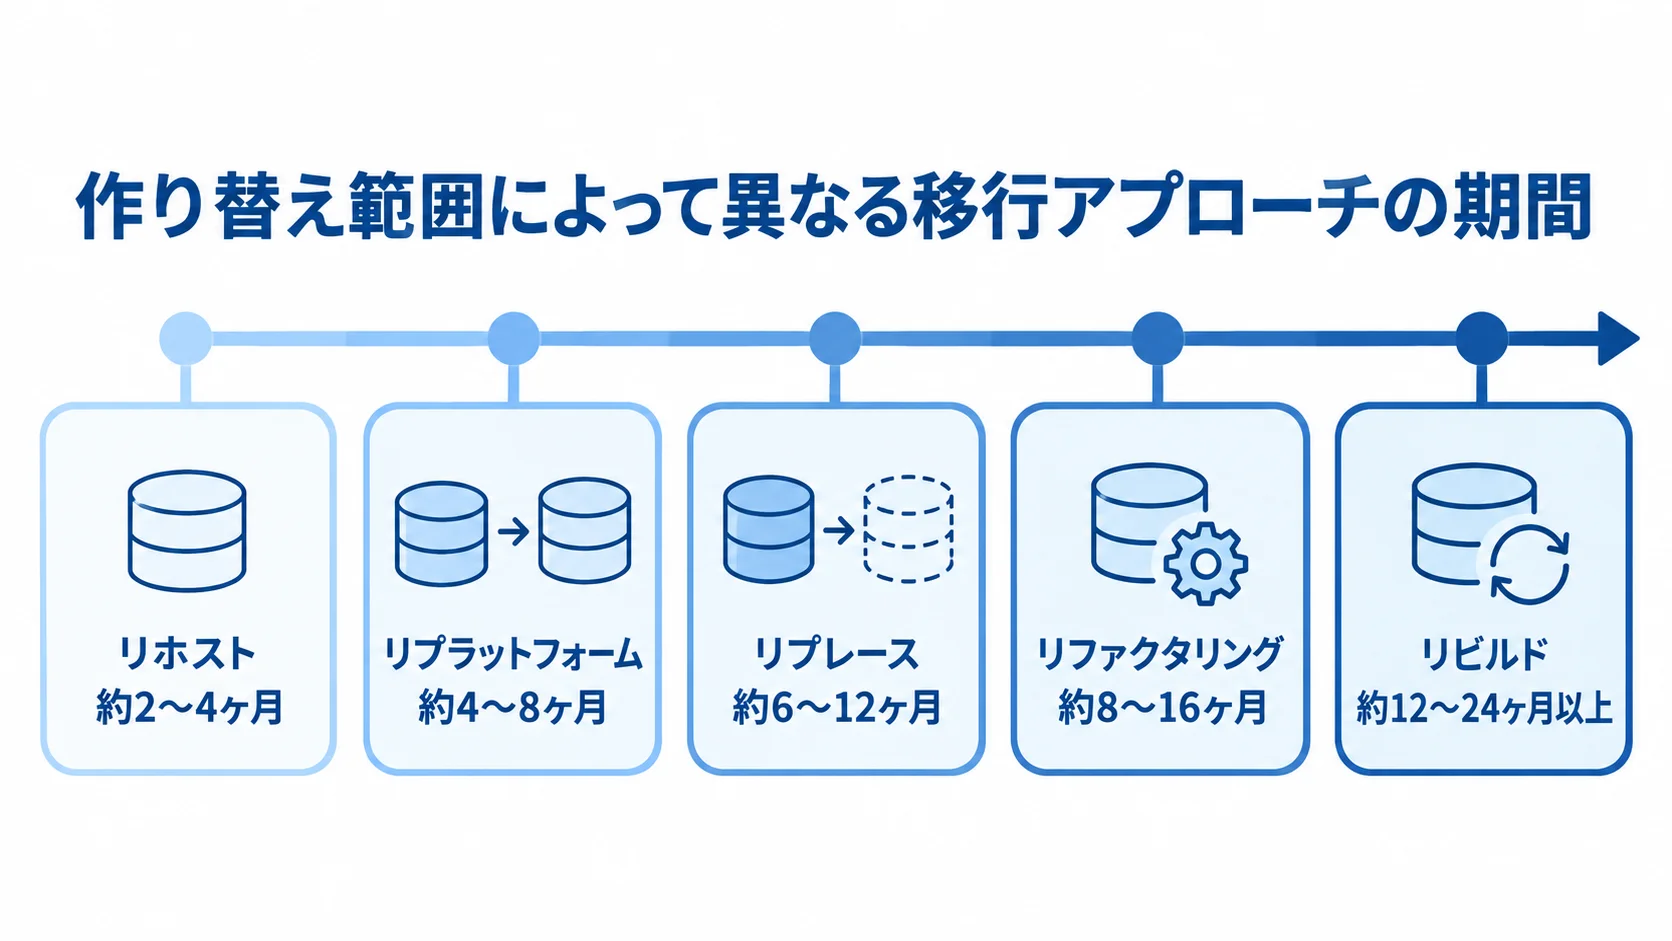
システムのモダナイゼーションで使われるリホスト・リプラットフォーム・リファクタリング・リビルド・リプレースの5つは、データ層に当てはめると開発期間の意味合いが変わります。具体的には、データベースを「どこまで作り替えるか」によって、数ヶ月で終わる移行と、2年近くを要する移行に分かれます。
短期間で完了するデータのリホスト・リプラットフォーム
データのリホストは、既存のデータベースエンジンとスキーマ構造を一切変えず、オンプレミスのサーバーからクラウドの仮想マシン上へそのまま移す「リフト&シフト」の手法です。期間の目安は約2〜4ヶ月と、最も短期です。
ハードウェアの保守期限切れ(EOS)対応など、まず物理的な老朽化リスクだけを早く解消したい場合に適しています。ただし、データモデル自体は古いままなので、分析基盤としての価値を高めるには別途手を入れる必要があります。
データのリプラットフォームは、スキーマ構造をおおむね維持したまま、データベースエンジンをクラウドのマネージドサービス(Amazon RDSやCloud SQLなど)に置き換える手法です。DBA(データベース管理者)によるパッチ適用やバックアップ運用の負荷を早く下げたい場合に選ばれます。期間の目安は約4〜8ヶ月で、次に述べるリファクタリングほど長くは要しません。
長期化しやすいデータモデル再設計を伴うリファクタリング・リビルド
データのリファクタリングは、既存のデータを維持しながら、データモデルを分析用のスタースキーマやディメンショナルモデルへ正規化・再設計し、クラウドDWHへ段階的に移行する手法です。期間の目安は約8〜16ヶ月です。長年の運用で蓄積された例外データの扱いや、正規化に伴うアプリケーション側の参照ロジックの修正が必要になるため、中〜長期間に及びます。
データのリビルドは、既存のデータ資産を刷新の起点にしつつ、レガシーな構造を廃棄します。そのうえで、データレイクハウスやリアルタイムストリーミング基盤(Change Data Captureによる差分連携など)をゼロから構築する手法です。期間の目安は約12〜24ヶ月以上で、最も長期化します。全社のデータ活用の中核になる基盤のため、段階的な拡張を前提とした計画が欠かせません。
データのリプレースは、自社でデータ基盤を保有・運用すること自体をやめ、既製のクラウドDWH・データ分析SaaSへ完全に移行する手法です。期間の目安は約6〜12ヶ月です。データベースエンジンそのものの開発が不要な分だけ難易度は下がりますが、移行元データのクレンジングとマッピング作業に予想以上の期間がかかる点に注意が必要です。
納期を左右する遅延要因と対策
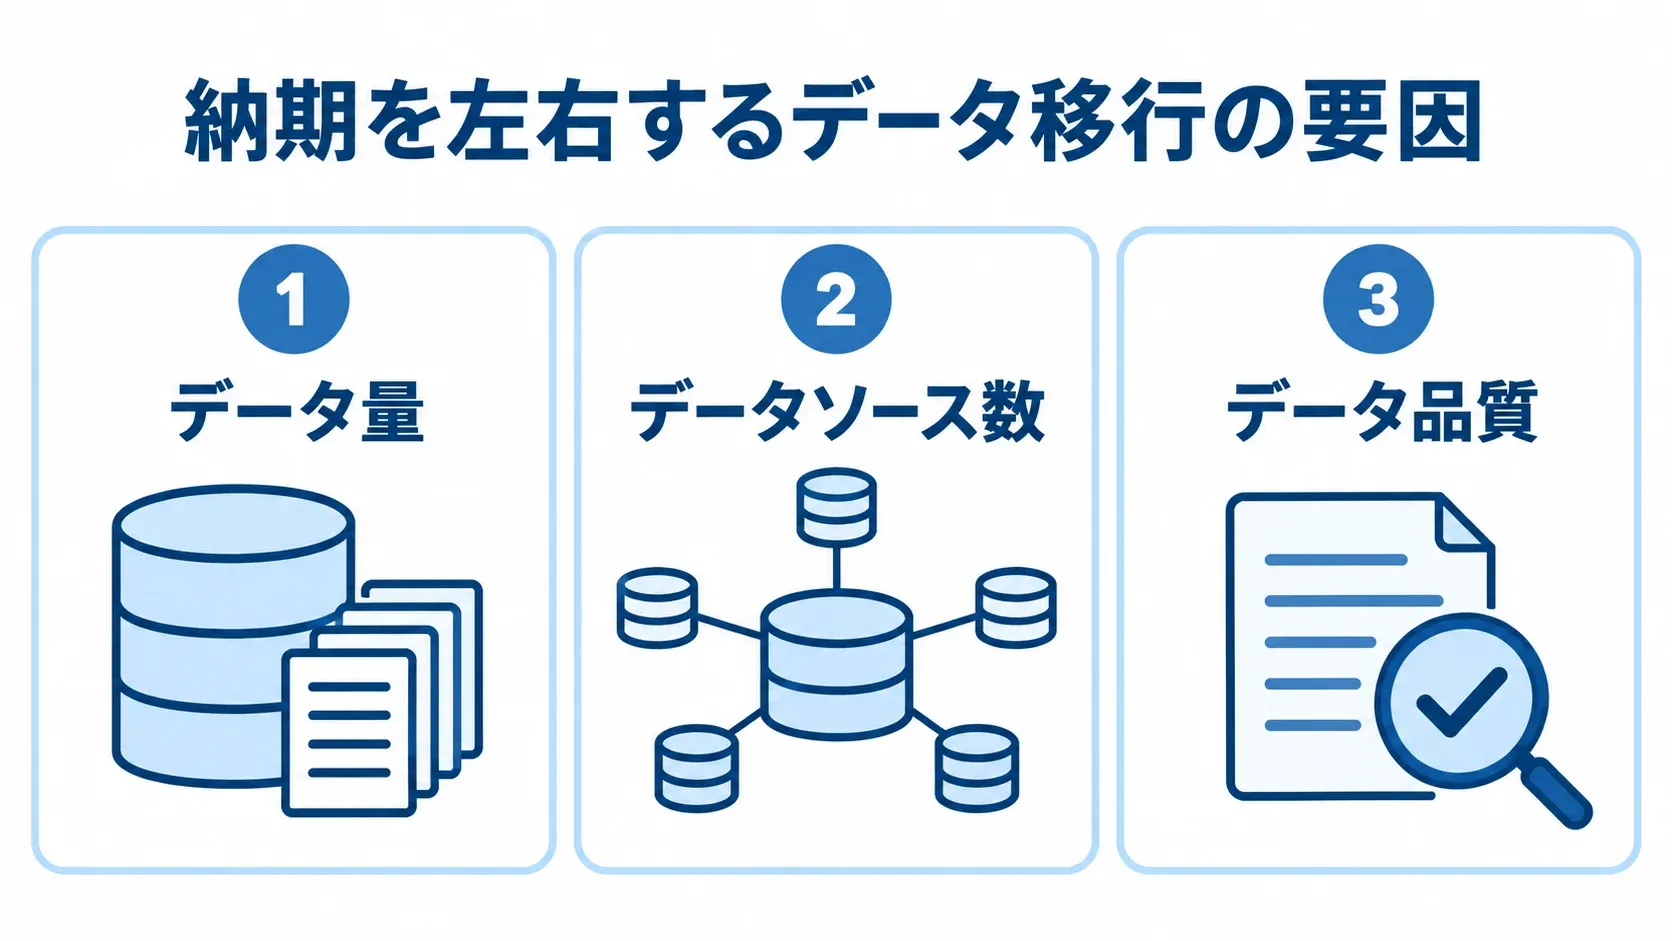
データモダナイゼーションのスケジュールが当初計画を超過する最大の原因は、移行手法の選定ミスよりも「データの実態を過小評価したまま計画を立ててしまうこと」にあります。アプリケーションの刷新と違い、データの品質問題は要件定義の段階では見えづらく、実データを触り始めて初めて表面化する点が特有の難しさです。
データ量・データソース数・データ品質が期間に与える影響
同じ「中規模のデータモダナイゼーション」でも、期間が6ヶ月で済む場合と14ヶ月かかる場合があります。その差を生む最大の変数は、「データの品質と前処理の量」です。たとえば、移行元のオンプレRDBMSに表記ゆれ・重複レコード・欠損値・複数システム間のマスタ不整合が大量にあると、名寄せやクレンジングといった前処理だけで数ヶ月かかることも珍しくありません。
第二の変数は「移行元システムの数」です。単一のオンプレDBを移行するのか、基幹システムや複数の部門システム、レガシーなファイルサーバーなど多数のデータソースを統合するのかで、ETL/ELTの設計・実装・テストの工数が大きく変わります。これらの変数は、現状データアセスメントの段階で洗い出しておくと、精度の高い納期見積もりにつながります。
新旧データ基盤の並行稼働とカットオーバー戦略
納期遅延を防ぐもう一つの鍵は、既存のオンプレDBを一気に停止して新データ基盤へ切り替える「ビッグバン方式」を避けることです。データ移行で一括切替を行うと、集計ロジックの誤りやデータ連携の欠損に気づかないまま本稼働してしまうリスクが高く、意思決定を誤らせる致命的な数値の誤りにつながりかねません。
そこで、新旧データ基盤を一定期間並行稼働させ、両者の集計結果を突き合わせて数値の整合性を検証します。そのうえで、問題のないデータ領域から段階的に新基盤へ切り替えていく進め方が有効です。
特に会計・売上といった経営判断に直結するデータ領域は、既存の帳票や現行システムの数値と突き合わせる「数値検証」に十分な期間を確保しておくことが、稼働直後の混乱を避けるうえで欠かせません。
依頼先選定が開発期間に与える影響
同じ規模・技術構成のレガシーデータ基盤でも、どのパートナー企業に依頼するかによって、開発期間は大きく変わります。期間を短くできるかどうかは、データベース設計とクラウドDWHの両方に通じた専門性を持つかどうかで決まります。
データエンジニアリング・ETL/ELTツールの実績確認
依頼先を選ぶ際の1つ目のポイントは、対象とするオンプレRDBMSの解析・移行実績です。移行元のデータベースエンジンの知見が豊富なパートナーであれば、現状アセスメントにかかる期間を大幅に短縮できます。
2つ目は、ETL/ELTツールとデータ変換フレームワーク(dbtなど)の活用実績です。データ変換ロジックをコードとしてバージョン管理し、テストとレビューを組み込める体制を持つパートナーであれば、手作業でのデータマッピングに比べて期間を大きく圧縮できます。
3つ目は、類似規模・類似業種でのデータ移行実績です。扱ったことのあるデータ量やデータソースの種類が近いほど、見積もりの精度と進行のスムーズさが向上します。契約前の提案段階で、これらの実績を具体的な数値とともに共有してもらうことが、期間見積もりの妥当性を検証する近道です。
発注前に確認すべき体制と協力工数
依頼先を決める前に、体制と進め方を確かめておくことは、期間の見通しを立てるうえで欠かせません。データエンジニアの経験とアサイン体制、各フェーズの成果物と完了基準、データ移行範囲の凍結や意思決定の時期について、事前にどう設定しているかを共有してもらうと見通しが立てやすくなります。
発注者側にどの程度の協力工数を求めるのかも、欠かせない確認事項です。移行元データの仕様説明、業務上の意味づけの共有、並行稼働期間中の数値検証への参加などが対象になります。これを把握しないまま契約すると、後半になって自社側のデータ有識者のリソース不足が判明し、遅延の原因になりかねません。
契約形態(準委任か請負か)は、データクレンジングの工数が要件定義の時点では見通しにくいというデータモダナイゼーションの特性を踏まえて、発注前に取り決めておくと安心です。
まとめ
ここまで、工程別の期間配分、5つのアプローチ別の期間の目安、納期を左右する遅延要因と対策、依頼先選定が期間に与える影響を見てきました。
開発期間を正しく見積む鍵は、このプロジェクトの性質を理解することにあります。ゼロから作るDWH導入とは違い、老朽化したオンプレRDBMSやレガシーなデータ資産からの脱却、つまり「データの技術的負債」の解消が目的です。
全体の目安は約6〜12ヶ月で、上流の現状データアセスメントは3〜5ヶ月、データパイプライン構築とクレンジングは3〜6ヶ月、並行稼働・切替は1〜2ヶ月を見込みます。また、アプローチによっては、リビルドのように12〜24ヶ月以上に及ぶこともあります。
遅延の最大要因は、データ品質の見積もり漏れとビッグバン方式による一括切替にあります。実データの早期確認と段階的なカットオーバーを徹底することが、納期を守るうえでの要になります。
オンプレRDBMSの解析実績とETL/ELTツールの活用実績を持つ信頼できるパートナーに、早めに相談することをお勧めします。
▼全体ガイドの記事
・データモダナイゼーションの完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・レガシーシステム刷新の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。
モダナイゼーションの判断を誤らないためには、見積もりを実態に近づける手順を省かないことが大切です。どれかを飛ばすと、後工程で手戻りが起きやすくなります。
- 移行方式とデータ品質を同時に確認する
- データの洗い出し、クレンジング、並行稼働を工程に組み込む
- データ状態と業務要件に合う範囲から始める