
データモダナイゼーションは、現状分析、目標設定、設計、移行、定着の5段階で進めるのが一般的です。
経済産業省が警鐘を鳴らした「2025年の崖」問題でも示されたように、レガシーシステムを抱えたまま経営を続けることは、競争力の低下やコスト増大という深刻なリスクを招きます。ただし、一度にすべてを刷新するとリスクが集中しやすいため、段階ごとに区切って進めます。各段階で何を決め、誰が動くのかを順に見ていきます。
▼全体ガイドの記事
・データモダナイゼーションの完全ガイド
レガシーシステム刷新の工程ごとの進め方と注意点については、無料ホワイトペーパー「レガシーシステム刷新の完全ガイドブック」で詳しく解説しています。
データモダナイゼーションの全体像
データモダナイゼーションを正しく進めるには、まず全体像と目的を理解しておくことが欠かせません。システムの移し替えそのものを目的にせず、データを経営に生かす変革プロジェクトとして捉えることが、成功の第一歩です。全体は、目的と定義、主要な手法の選び方、フェーズごとの手順という3つの要素で成り立ちます。
データモダナイゼーションの目的と定義
データモダナイゼーションとは、老朽化したデータ管理の仕組みや分断されたデータ基盤を、クラウドやモダンなデータアーキテクチャへ刷新する一連のプロセスを指します。具体的には、オンプレミスのデータウェアハウスをクラウドへ移す、バラバラに管理されたデータを統合する、リアルタイムでの分析を可能にするといった取り組みが含まれます。
デロイトをはじめとする大手コンサルティングファームの調査でも、DX(デジタルトランスフォーメーション)の成功にはデータモダナイゼーションが不可欠とされています。さらに、データモダナイゼーションは単なるIT投資の枠を超えた経営戦略上の優先事項として位置づけられています。つまり、ビジネスの未来を切り拓くための「土台づくり」にあたります。
データ量の爆発的な増加を背景に、IDCの調査では2025年に世界で生成・蓄積されるデータ量が175ゼタバイト(ZB)に達すると予測されています。この膨大なデータを活用できる企業と、できない企業との差は、急速に広がっています。また、AIや機械学習の活用が当たり前になりつつある今、データが整備されていなければ、これらを使いこなすのは困難です。
主要な手法とアプローチの種類
代表的な手法は、「リホスト(Rehost)」「リファクター(Refactor)」「リプラットフォーム(Replatform)」「リライト(Rewrite)」「リビルド(Rebuild)」の5つです。どの手法を選ぶかは、企業の状況や目標、既存データ資産の状態、予算、スケジュールを総合的に見て決める必要があります。これらを組み合わせて段階的に進めると、リスクを抑えながら近代化できます。
リホストは、既存のシステムやデータをほぼそのままの形でクラウドへ移す方法です。移行コストを抑えられる一方、レガシーの課題が残りやすいというデメリットがあります。リファクターは、既存のコードやデータ構造を整理・最適化しながら移行するため、品質の向上と並行して近代化を進められます。
リプラットフォームは、基本的な構造を維持しつつ、動作基盤をより現代的なプラットフォームへ変える手法です。リライトは、システムやデータ処理のロジックを現代的な言語・技術で書き直す手法で、大幅な改善が期待できる半面、工数も大きくなります。リビルドは、ゼロから新しいシステムを構築する最も抜本的なアプローチです。
データモダナイゼーションの進め方:フェーズ別手順
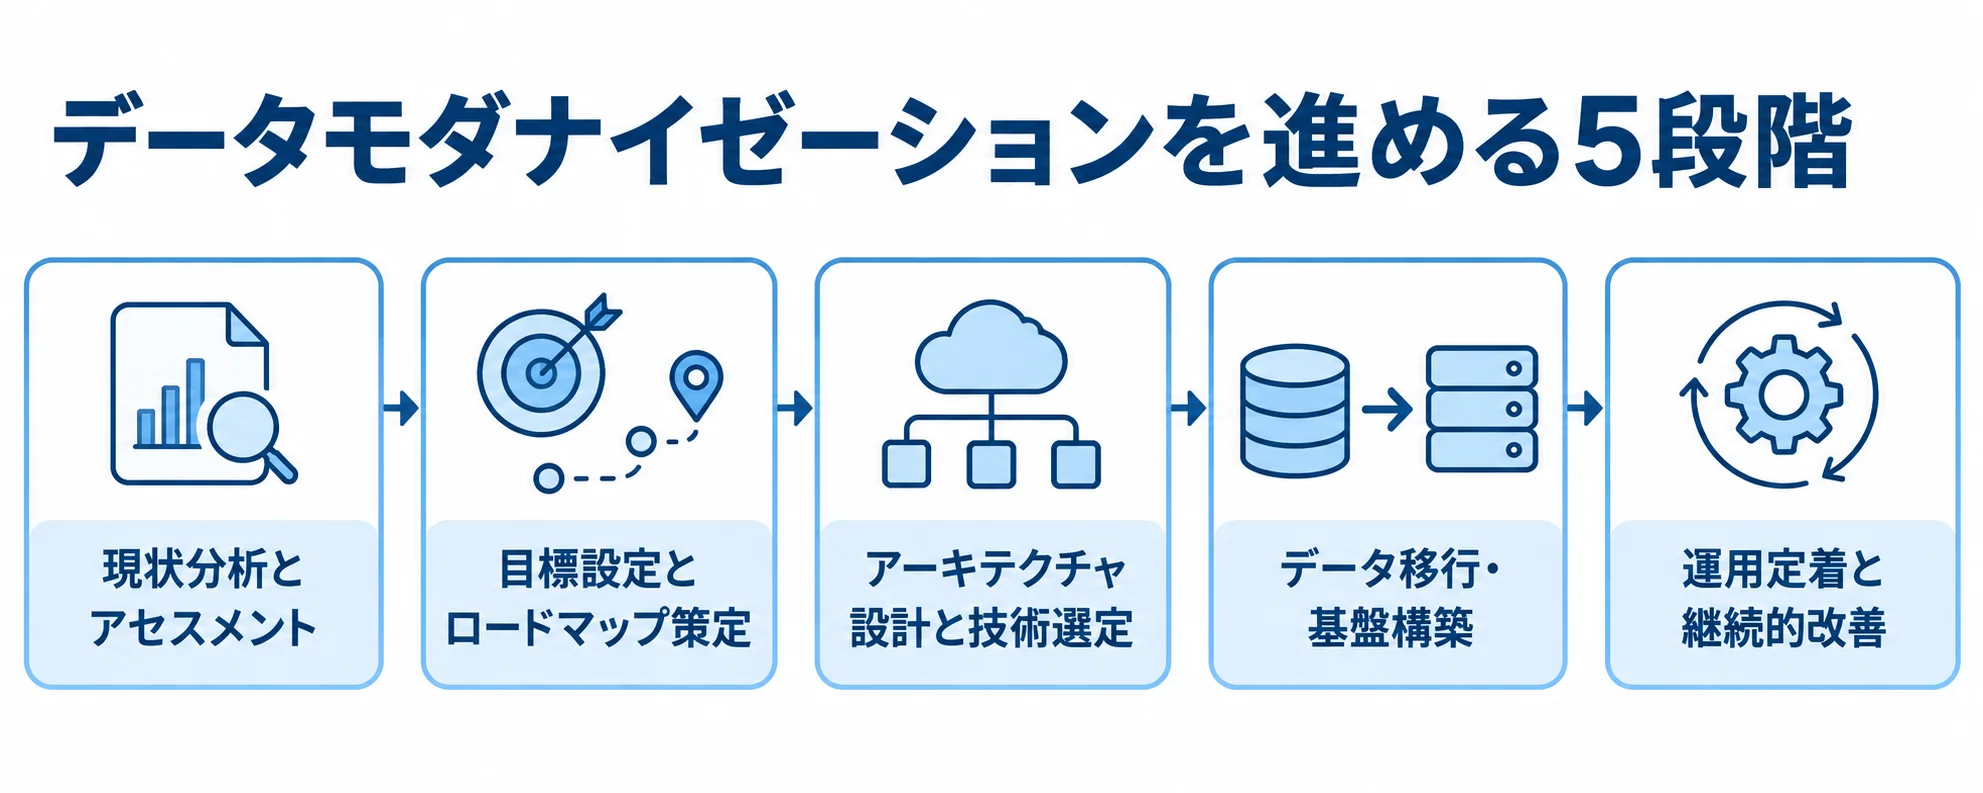
データモダナイゼーションを成功させるには、全体を複数のフェーズに分けて体系的に進めることが欠かせません。一気にすべてを刷新しようとすると、リスクが集中し、プロジェクトが頓挫する可能性が高まります。一般的に推奨されるフェーズは、現状分析から定着までの5段階で、各工程の進め方を順に見ていきます。
フェーズ1:現状分析とアセスメント
データモダナイゼーションの第一歩は、現状を徹底的に把握することです。まず、データの種類・量・品質・利用状況・管理者・更新頻度などを漏れなく洗い出し、どのシステムが何のデータを持つかも含め、「データインベントリ(資産台帳)」にまとめます。
多くの企業では、この調査で「こんなところにデータが眠っていた」「同じデータが複数の部門で別々に管理されていた」という事実が見つかります。現状分析では、既存システムの技術的な老朽度も評価します。「2025年の崖」問題でも指摘されているように、サポート切れのOS・データベース・ミドルウェアを使うケースは珍しくありません。
システムのブラックボックス化が進むと、後工程のコストやリスクを見積もることが極めて難しくなります。ブラックボックス化とは、設計書が整備されておらず、仕様を理解しているエンジニアがいない状態を指します。そのため、現状分析の段階でこれらの課題を把握しておくと、適切なモダナイゼーション戦略を立てるための確かな基盤が得られます。
フェーズ2:目標設定とロードマップ策定
現状分析が終わったら、「何のためにデータモダナイゼーションを行うか」という目標を、具体的で測定可能な形(KPI)で明確にします。たとえば、「データ分析の速度を3倍に向上させる」「部門間のデータサイロを解消して全社横断のダッシュボードを実現する」「AIを活用した需要予測システムを6ヶ月以内に稼働させる」といった形になります。
目標が曖昧なままだと、途中で方向性がぶれたり、成果を評価できなくなったりするおそれがあります。目標の設定と並行して、実現に向けたロードマップを策定します。ロードマップとは、どの順番で何を近代化するかを時系列で示した計画書です。
一度にすべてに取り組むより、ビジネスインパクトの大きい領域から着手する「フェーズドアプローチ」が推奨されます。たとえば、最も使われる顧客データの基盤を先にクラウドへ移し、次に在庫・販売データを統合して、最後に全社のデータプラットフォームを完成させる流れが考えられます。各フェーズに期間・予算・担当者・完了の定義を明記すると、進捗管理がしやすくなります。
フェーズ3:アーキテクチャ設計と技術選定
ロードマップが固まったら、アーキテクチャ設計と技術選定に入ります。現在主流となっているのは、クラウドベースのデータレイク、データウェアハウス、データレイクハウスといった構成です。その基盤として候補に挙がるのは、広く採用されている3社のクラウドプラットフォームです。
- AWS:Amazon Redshift、S3
- Google Cloud:BigQuery、Cloud Storage
- Microsoft Azure:Azure Synapse Analytics、ADLS
各プラットフォームの特性を理解したうえで、自社の要件に合うものを選ぶことが求められます。特に重要なのは、「将来的な拡張性」と「既存システムとの連携性」です。いくら優れた技術でも、既存の業務システムとうまく連携できなければ、現場での活用は進みません。
また、データガバナンス(データの品質管理・セキュリティ・アクセス制御)の仕組みも、この段階で設計しておく必要があります。さらに、データの収集・蓄積・加工・提供という一連のパイプライン(ETLまたはELTプロセス)の設計も、この段階の重要な作業です。データエンジニアやアーキテクト、セキュリティ担当者、ビジネス側の関係者が協力することが、成功の鍵となります。
データ移行・基盤構築の工程と注意点
アーキテクチャ設計が完了したら、実際のデータ移行と新しいデータ基盤の構築に入ります。この工程は、リスクも技術的な難しさも全体の中で最も大きい段階です。計画どおりに進めるには、入念な準備と段階的なアプローチが欠かせません。
データクレンジングと品質確保の進め方
データ移行の前に必ず行うべき作業が、データクレンジングです。長年蓄積されたデータには、重複・欠損・不整合・表記ゆれ・古い情報など、さまざまな品質の問題が潜んでいます。これらを移行前に見つけて修正しておかないと、問題のあるデータが新しい基盤に引き継がれ、分析結果の信頼性が損なわれます。
実際の現場では、移行対象データの20〜40%にクレンジングが必要になるケースも珍しくありません。そのため、この工程に予想以上の時間がかかることを見越して、スケジュールを組む必要があります。このプロセスで信頼できるデータを作ることが、後工程の分析やAI活用の品質を左右します。
まず、現状のデータを分析して問題点を把握する「データプロファイリング」を行います。次に、クレンジングのルールを定義します(例:全角・半角を統一する、電話番号の形式を揃える、住所表記を標準化するなど)。そのルールに基づいてデータを修正し、修正後のデータが正しいかを検証します。
段階的なデータ移行の実施手順
データ移行は、段階的に進めるのが鉄則です。移行対象を「クリティカル度(業務への影響度)」と「複雑度(技術的な難易度)」の2軸で分類し、クリティカル度が高く複雑度が低いものから着手します。最初の移行では、規模の小さなデータセットや業務への影響が限定的なデータを選んで試験的に移行し、手順や問題点を確認します(パイロット移行)。
試験で得られた知見を生かして手順を改善してから、本格的な移行に取り組みます。移行の実施中は、旧システムと新システムを並行して稼働させる「パラレル運用」を設けます。一定期間、同じ業務処理を両方のシステムで行い、処理結果が一致することを確かめます。
これにより、万が一新システムで問題が起きても、旧システムに切り戻せます。また、移行後のデータが正確に移されているかを確かめる「データ整合性検証」も欠かせません。移行前後でデータの件数・合計値・サンプリングによる内容確認などを行い、移行品質を担保します。
テスト・検証と本番リリースの流れ
新しいデータ基盤が完成したら、本番リリース前に徹底的なテストを実施します。テストは、「機能テスト」「パフォーマンステスト」「セキュリティテスト」「ユーザー受け入れテスト(UAT)」の4種類を、少なくとも実施することが推奨されます。機能テストでは、データパイプラインが正しく動き、データが期待どおりに変換・蓄積されているかを確認します。
パフォーマンステストでは、業務ピーク時の処理量に耐えられるか、クエリの応答速度が要件を満たすかを検証します。セキュリティテストでは、不正アクセスの防止、データの暗号化、アクセス権限の設定が適切かを確かめます。ユーザー受け入れテスト(UAT)では、実際にデータを使う現場の担当者に新システムを試してもらい、業務上の問題がないかをチェックします。
テストで見つかった問題は、必ず修正してから本番リリースに進みます。本番リリース後も、一定期間は旧システムを残したまま新システムの安定稼働を確認する移行期間を設けることが大切です。この期間は監視体制を強化し、異常があれば迅速に対応できるよう準備しておきます。
データガバナンスと組織体制の整備
データモダナイゼーションの成功には、技術面に加えて、データを正しく管理・活用する「データガバナンス」の仕組みと、それを支える組織体制が欠かせません。多くの企業がつまずく原因は、技術面よりも、このガバナンス・組織面の課題にあります。
データガバナンスの仕組みづくり
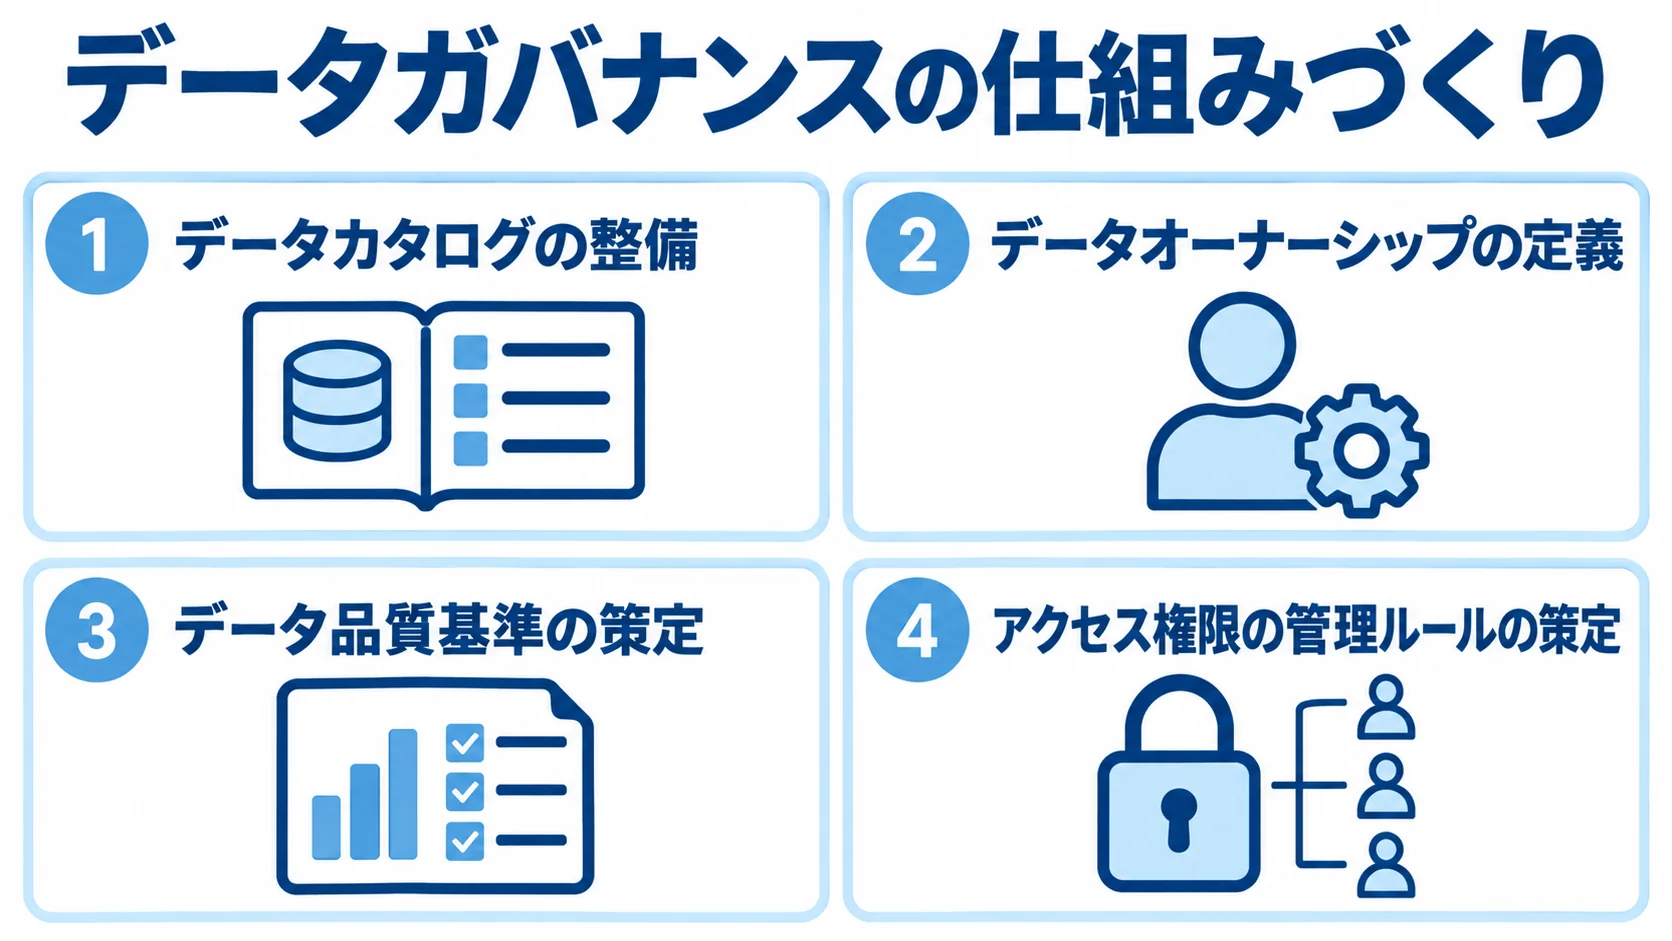
データガバナンスとは、「誰が・どのデータを・どのように管理・利用するか」のルールと責任体制を、組織全体で定めることです。具体的には、データカタログの整備、データオーナーシップの定義、データ品質基準の策定、アクセス権限の管理ルールの策定などが含まれます。
データカタログは、どのデータがどこにあるかを一覧化したものです。データオーナーシップは、各データの管理責任者を明確にすることを指します。これらが整備されていないと、せっかくデータ基盤を近代化しても、「どれが正しいデータか分からない」「不必要に多くの人が機密データにアクセスできる」といった問題が生じます。
個人情報保護法やGDPRなどの法規制への対応は特に大切で、非準拠の場合は罰則のリスクもあります。個人データのマスキング(匿名化・仮名化)、保持期間の管理、本人からの削除要求への対応といった仕組みを、設計段階から組み込んでおくことが欠かせません。後から対応すると改修費が膨らむため、「プライバシー・バイ・デザイン」の考え方を初期から取り入れることが推奨されます。
推進体制と人材育成の進め方
データモダナイゼーションを推進するには、適切な組織体制の構築が求められます。一般的に必要な役割は、全体戦略を統括するCDOやデータ戦略リーダー、技術アーキテクチャを設計するデータアーキテクトなどです。そのほか、データパイプラインを担うデータエンジニア、データ品質を管理するデータスチュワード、分析・AIモデルを担うデータサイエンティストやアナリストも挙げられます。
少なくとも、推進の中核となるチームを明確にしておくことが大切です。役割のすべてを社内で賄う必要はありません。社内のデータ人材の育成も、並行して進める必要があります。
現場の担当者がセルフサービスでデータを分析できる「データリテラシーの向上」は、長期的な競争力の源泉となります。定期的な研修や社内勉強会、データに基づく意思決定を評価する組織文化の醸成も、成否を左右する大切な取り組みです。外部のコンサルティングファームや専門ベンダーと連携しながら、段階的に社内の自走力を高めていくのが現実的です。
費用・期間の目安と成功のためのポイント
データモダナイゼーションの費用や期間は、対象システムの規模・複雑さ・選択する手法によって大きく変わります。一般的な目安と、投資対効果を高めるためのポイントを順に見ていきます。
規模別の費用目安と期間の考え方
データモダナイゼーションの費用は、プロジェクトの規模によって大きく異なります。中小規模の企業が特定のデータ基盤をクラウドへ移行するケースでは、数百万円から数千万円程度が一般的な相場です。一方、大企業が全社的なデータプラットフォームを刷新する大規模プロジェクトでは、数億円から数十億円規模に及ぶこともあります。
費用を左右する主な要因は、移行対象データの量と複雑さ、クラウドサービスの種類と利用料です。そのほか、データクレンジングやパイプライン開発の工数、テスト・移行支援の費用も関わります。期間も幅があり、小規模なら3〜6ヶ月程度で終わることもあれば、全社的な取り組みでは1〜3年かかることも珍しくありません。
重要なのは、初期段階で実現可能な範囲を絞り込んだ「クイックウィン」を設定し、早期に成果を出して組織の理解と支持を得ることです。最初の6ヶ月以内に可視化された成果を出すことが、プロジェクト継続の推進力となります。予算を確保するには、ランニングコストを含めた長期的な投資対効果(ROI)を試算し、経営層の承認を得ることが欠かせません。
失敗しやすいパターンと対策
失敗しやすいパターンの筆頭は、「スコープの肥大化」です。プロジェクト開始後に「どうせやるなら全部刷新しよう」という考えから対象範囲が広がり、コストと期間が当初見込みの2〜3倍に膨らむケースが多く見られます。これを防ぐには、開始前にスコープを明確に定義し、変更時は正式な変更管理プロセスを通すことをルール化しておきます。
IT部門だけで進めてビジネス部門を巻き込まないことも、失敗の原因となります。データモダナイゼーションの最終的な目的はビジネス成果の向上であるため、ビジネス部門のリーダーをプロジェクトオーナーに据えて推進するのが理想的です。もう一つよく見られる失敗は、データ品質を過小評価することです。
「まず移行してからデータを整理しよう」と進めると、品質の悪いデータがそのまま新基盤に入り、分析結果の信頼性と現場の信頼を失います。そのため、着手前にデータ品質の改善を必須工程として位置づけ、十分な時間とリソースを確保することが失敗回避の鍵です。加えて、移行は業務プロセスの変更を伴うため、現場の抵抗には研修と丁寧なコミュニケーションで応える変革マネジメントが欠かせません。
成功に導く3つのポイント
成功に導く第一のポイントは、「経営層のコミットメント」です。データモダナイゼーションは企業全体の変革を伴うため、経営トップが明確なビジョンと優先度を示し、予算・人材・時間を確保することが、プロジェクトの原動力となります。部門の壁を越えたデータ統合や全社的なデータ文化の醸成は、現場レベルの取り組みだけでは実現しにくいものです。
第二のポイントは、「段階的かつ継続的な改善アプローチ」です。完璧を目指して一度にすべてを解決するより、小さな成功を積み重ねながら範囲を広げていく「アジャイルアプローチ」が、データモダナイゼーションには適しています。
第三のポイントは、「外部専門家の活用」です。データモダナイゼーションには高度な技術と実践経験が必要なため、社内リソースだけで抱えると学習コストが増え、プロジェクトが長期化するおそれがあります。経験豊富なコンサルタントや開発ベンダーと協力すればリスクを抑えて確実に成果を出せ、特に初回のプロジェクトでは外部の知見を社内のノウハウとして蓄積する姿勢が大切です。
運用定着と継続的改善の進め方
新しいデータ基盤は、リリースしてからが本当のスタートです。本番稼働後の運用定着と継続的な改善こそが、データモダナイゼーションの成果を生み出す段階になります。多くのプロジェクトがリリース後の定着段階で失速する傾向があるため、この段階への投資と注力が欠かせません。
モニタリングとデータ品質の継続管理
本番稼働後は、データパイプラインやデータ基盤の稼働状態を継続的に監視する体制を整えます。具体的には、処理遅延・エラー発生・データ欠損などを自動で検知するアラートを構築します。そのほか、データ品質指標(正確性・完全性・一貫性・適時性)を定期的に測定して報告し、インフラのコストも監視・最適化します。
クラウドは使用量に応じて費用が変動するため、定期的なコスト分析と最適化(リソースのスケールダウン、不要なデータの削除、ストレージ層の見直しなど)が欠かせません。データ品質の継続管理では、「データ品質ダッシュボード」を設けて、主要なデータセットの品質スコアを定期的に見える形で共有することが効果的です。
品質基準を下回るデータが見つかったら、原因を調べて改善するPDCAサイクルを回します。新しいデータソースの追加や業務プロセスの変更があれば、データカタログやデータ辞書も更新する運用ルールを設けておくと、データの信頼性を長期的に保てます。データ品質の管理は、継続的に取り組む業務として位置づけておきます。
ビジネス価値創出に向けた継続的な改善サイクル
データ基盤が安定稼働し始めたら、その上でビジネス価値を生むユースケースを継続的に広げる段階に移ります。最初の段階で得た成功事例(例:売上予測精度の向上、在庫ロスの削減、顧客離脱率の改善など)を社内で共有し、他部門への「横展開」を進めます。こうした成功事例が積み重なると、データに基づく意思決定が自然と組織文化として定着していきます。
また、技術の進化に合わせて、データ基盤そのものも継続的に更新していく必要があります。たとえば、クラウドプロバイダーは頻繁に新機能や新サービスを出しており、それらを積極的に取り込むことで、コスト削減や機能向上を実現できます。
特に近年は、生成AIとデータ基盤の連携が急速に進んでおり、NTTデータの調査では、生成AIを活用したモダナイゼーションで開発工数を大幅に削減できる事例が報告されています。生成AIをデータモダナイゼーションのプロセスそのものに活用するという視点も、今後ますます重要になるでしょう。
まとめ
ここまで、データモダナイゼーションの進め方を、フェーズごとに解説してきました。実行の際は、次の5段階を順に進めます。
- 現状分析:データ資産と課題の把握
- 目標設定:ロードマップによる方向性の決定
- 設計:アーキテクチャと技術の選定
- 移行:クレンジング、段階移行、テストの実施
- 定着:ガバナンスと継続改善の運用
まず現状分析とアセスメントで自社のデータ資産と課題を把握し、目標設定とロードマップ策定で方向性を定めます。次にアーキテクチャ設計と技術選定で近代化の全体設計を固め、クレンジングと段階的な移行を経て、テスト後に本番リリースへ進みます。さらに、データガバナンスと組織体制の整備、そして本番稼働後の運用定着と継続的改善が、データモダナイゼーションの成功には不可欠です。
データモダナイゼーションは簡単ではありませんが、正しい手順と方法で取り組めば、企業のデータ活用力を大きく高められます。「どこから手をつければよいか分からない」「社内に専門知識を持つ人材がいない」といった課題を抱える場合は、経験豊富な専門パートナーに相談することが、プロジェクトを成功させる確実な方法の一つです。
riplaでは、コンサルティングからシステム開発・運用支援まで一気通貫でサポートしています。貴社のデータモダナイゼーション推進を強力にバックアップします。ぜひお気軽にご相談ください。
▼全体ガイドの記事
・データモダナイゼーションの完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・レガシーシステム刷新の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。