
データモダナイゼーションの製品は、移行先の基盤本体と、既存データの収集・変換を担うデータ連携製品に分けると比べやすくなります。
そのうえで料金と契約内容も同じ前提で比べ、課題に合う候補をPoCで確かめます。各テーマの詳細は、下に載せた関連記事でも確認できます。
▼全体ガイドの記事
・データモダナイゼーションの完全ガイド
レガシーシステム刷新の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「レガシーシステム刷新の完全ガイドブック」で詳しく解説しています。
パッケージ型とクラウド型データモダナイゼーション基盤の違い
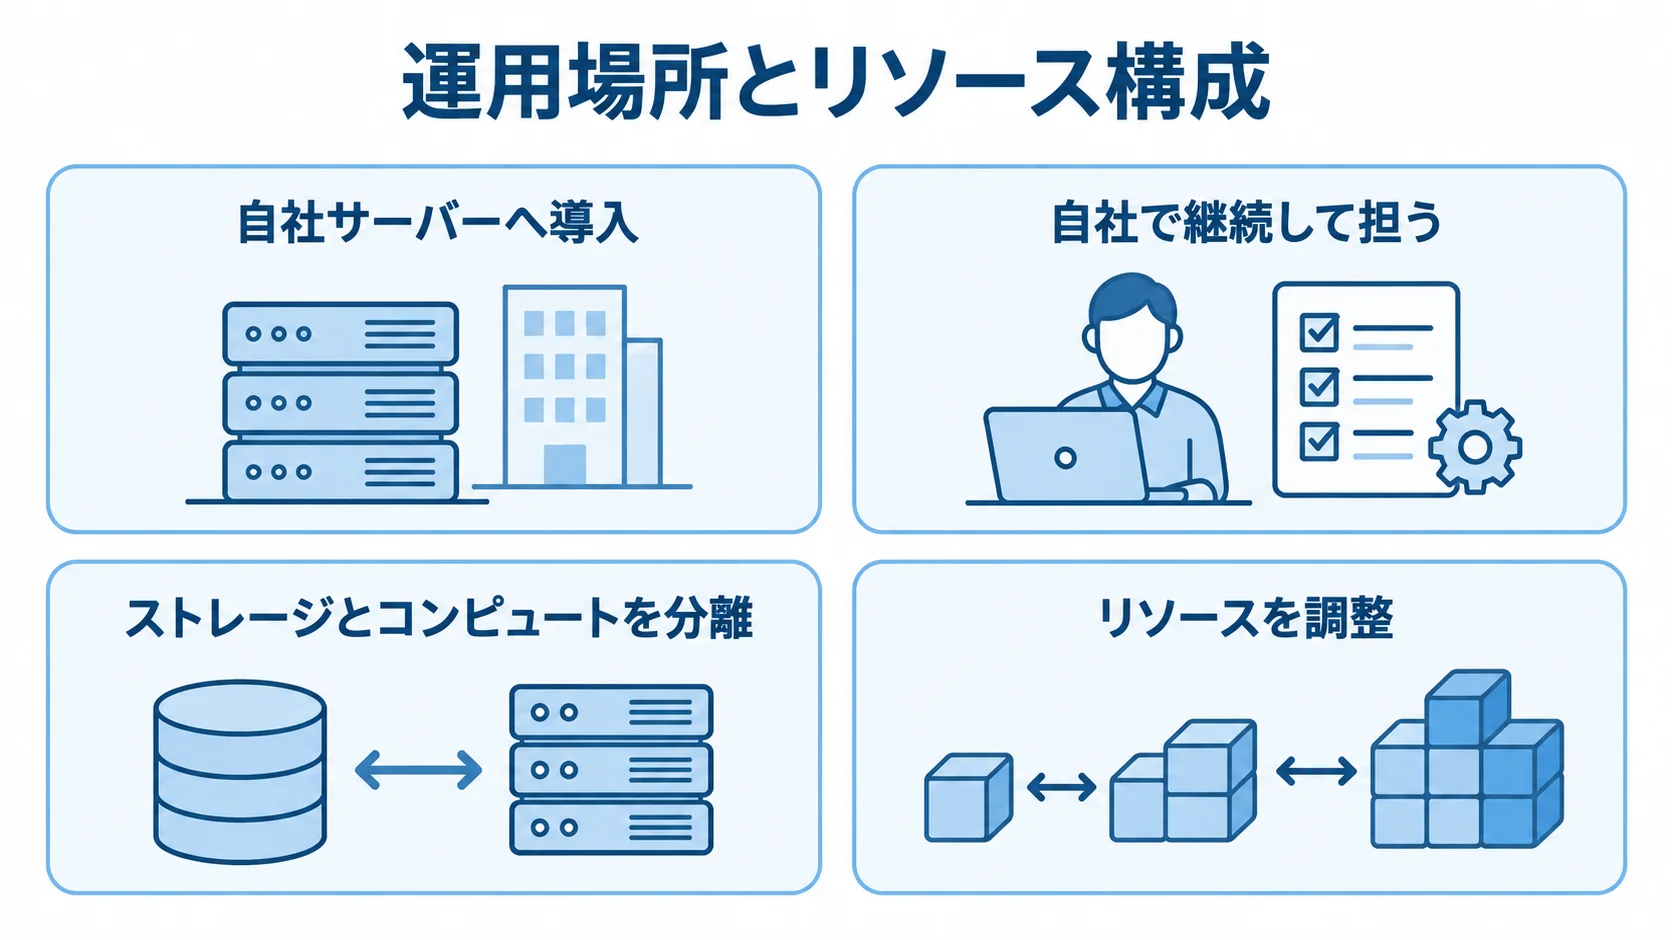
従来のパッケージ製品は、ソフトウェアを買い切って自社サーバーへ導入する形態が一般的です。
現在、移行先として比べやすいのは、ベンダーが運用するクラウド型のデータウェアハウスやデータレイクハウスです。そのためこの記事でも、現行情報を確認できたクラウド型を取り上げます。
パッケージ型は自社運用の継続が論点
自社サーバーへ導入する買い切り型では、閉域網や独自のセキュリティ基準に対応しやすい場合があります。ハードウェアの調達、監視、バックアップ、バージョンアップは、自社で継続して担うことになります。
老朽化したオンプレミスRDBMSも、多くはこの形態です。その維持そのものが、解消したい課題の一因になることもあります。
クラウド型はストレージとコンピュートの分離が前提
クラウド型は、サーバーを調達せずに利用を始められます。ストレージとコンピュートを分離しているので、データ量や処理負荷に応じてリソースを調整できます。
ベンダーが機能更新やセキュリティ対応を続けるため、法改正や基準の変化への追随も期待できます。
データ活用には、クラウドの選定と並行して、自社のデータモデルとガバナンス設計も整える必要があります。
製品比較で見る共通の観点
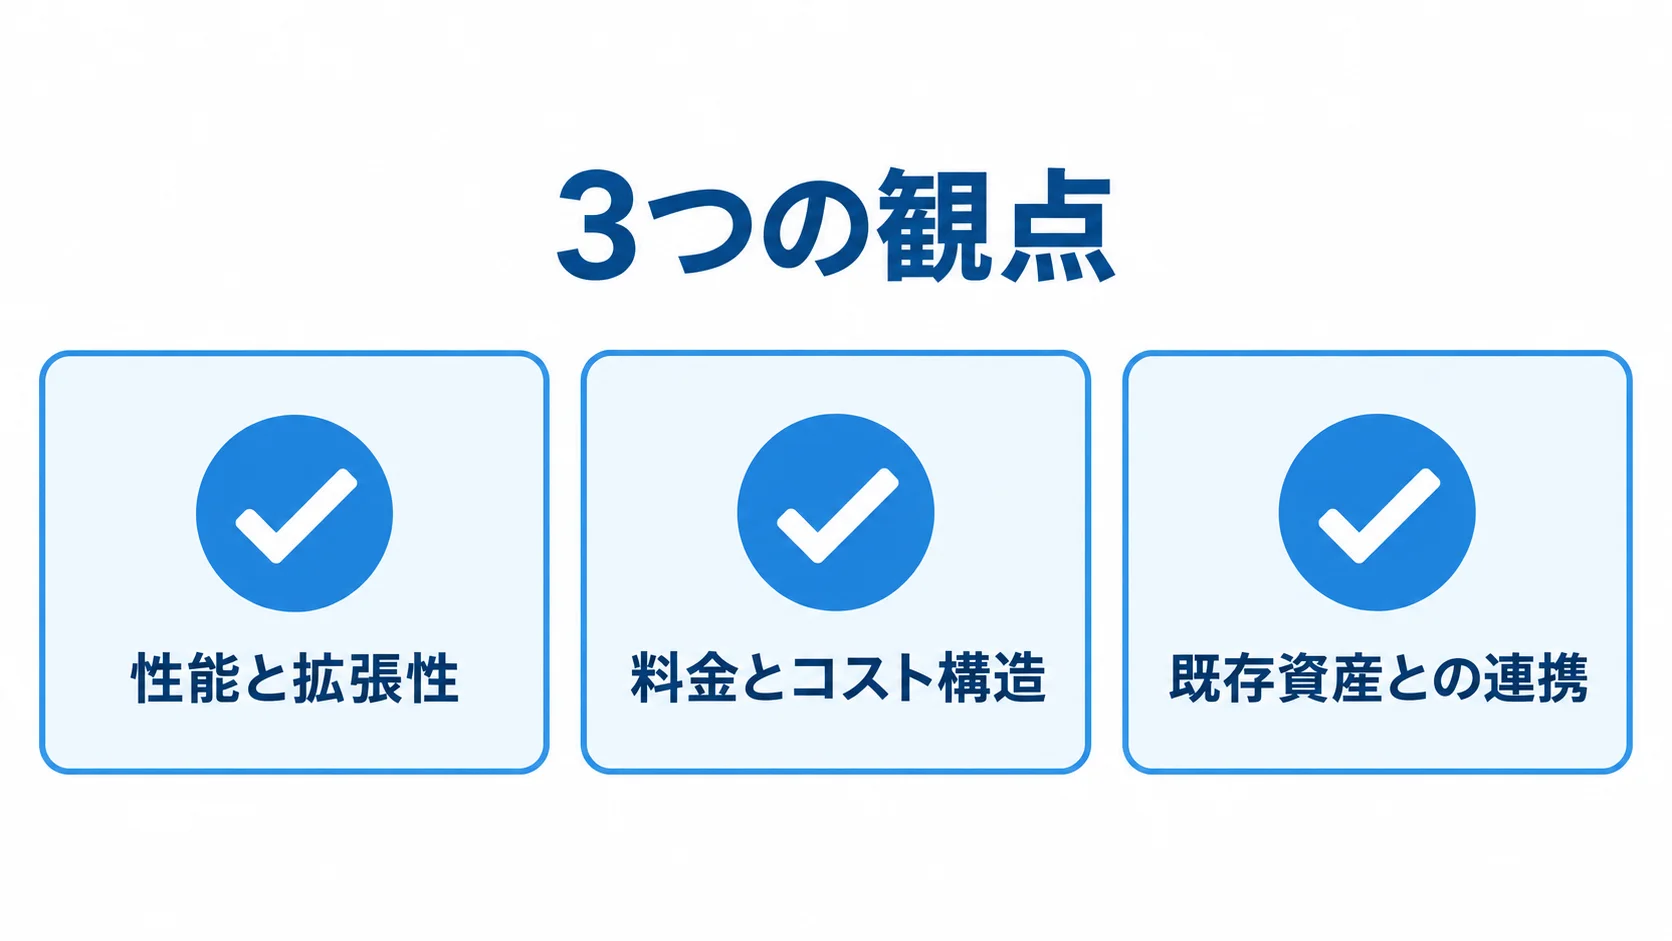
機能一覧だけでは、自社のデータ移行に合うかを判断しにくいものです。候補を同じ条件で比べるため、観点をそろえて確認しておきます。
- 性能と拡張性:自社のデータ量やクエリでの処理速度
- 料金とコスト構造:課金単位と利用条件をそろえる
- 既存資産との連携:移行元システムとの接続しやすさ
処理性能とスケーラビリティの比べ方
「大規模データに対応」と書かれていても、自社のデータ量やクエリでの性能は分かりません。ストレージとコンピュートの分離、必要なときのリソース増減、同時実行できる分析ジョブ数の制約を確かめます。そのうえで、実データに近い条件で試すことが欠かせません。
既存資産との連携性と移行のしやすさ
既存のオンプレミスRDBMSや業務システムから、どのような方法でデータを取り込むかを見ていきます。ETL/ELTのコネクタが自社システムに対応しているかも、あわせて確かめます。
標準コネクタで対応できないと個別開発が必要になり、そのぶん費用や期間が想定を上回ることがあります。
詳しい評価手順は、データモダナイゼーションの選定ポイント・選び方・種類で整理しています。
データモダナイゼーションの主要クラウド製品5選
ここでは、2026年7月時点で公式ページと提供内容を確認できた5製品を紹介します。掲載の順番は、ランキングではありません。
データウェアハウスやデータレイクハウスは移行先となる製品で、ETL/ELT製品は既存システムからのデータ収集や変換を担います。両者の役割を分けて捉え、重視する機能に応じて確認してください。
Snowflake
Snowflakeを候補にするかは、用途の広さや構成の特徴に加えて、料金の試算を進められるかで判断します。
- 用途:取り込み、処理、分析、AIアプリの構築や共有に対応
- 導入実績:公式サイトでは、フォーブス・グローバル2000企業の多くが利用していると紹介。幅広い企業で現行稼働を確認できる
- 構成:ストレージとコンピュートを分離し、複数部門の同時アクセスでも性能が干渉しにくい
- 料金:具体額は公式サイトにないため、データ量とクエリ頻度を伝えて専用ページや見積もりで試算
Google Cloud「BigQuery」
BigQueryの機能と料金の仕組み、既存クラウドとの連携を、次の項目で見ていきます。
- 機能:Google Cloud Platformのデータウェアハウス。大規模データのSQL分析、BI、機械学習に対応
- 分析料金:クエリ実行時にスキャンしたデータ量に応じる従量課金
- 保存料金:データ保存量に応じる従量課金
- 試算:単価は時期やリージョンで変わるため、公式シミュレーターで自社のデータ量から試算する
- 連携:Google Cloudを使っている企業は、他サービスと連携しやすい
Amazon Web Services「Amazon Redshift」
Amazon Redshiftの機能、利用形態、料金の確かめ方を、順に見ていきます。
- 製品:AWSのクラウドデータウェアハウス。分析やエージェント型AI向けのコストパフォーマンスを訴求
- 機能:SQL分析、リアルタイムに近い分析、機械学習モデル構築に対応
- 利用形態:サーバーレスでも利用可能。AWS上に業務システムや基盤がある企業は既存サービスと連携しやすい
- 料金:公式トップに具体額はなく、専用の料金ページで確認したうえで、データ量とクエリパターンを踏まえて見積もる
Databricks
Databricksは扱えるデータの幅が広い一方で、料金と運用の面では事前に確かめたい点があります。
- 基盤:統合、保存、処理、ガバナンス、共有、分析、AIを一つの構成で扱うデータレイクハウス
- 対象データ:構造化データに加え、ログや画像などの非構造化データにも対応
- 活用:機械学習や生成AIを見据えた基盤刷新にも向いている
- 料金・運用:公式ページに具体額はなく、料金シミュレーターで確認する。運用のしやすさは、専門人材や支援パートナーの有無で変わる
primeNumber「trocco」
troccoでは、機能と移行先との役割分担、料金の確かめ方を押さえておきます。
- 機能:primeNumber Inc.提供の国内発クラウド型データ統合サービス。ETL(データ転送・変換)、ワークフロー、権限管理に対応
- 導入状況:公式サイトで2,000以上の企業・団体が導入と紹介され、現行稼働を確認
- 役割:既存システムのデータを収集・変換し、移行先の本体は担わない
- 連携先:オンプレミスRDBMSや業務システムから、SnowflakeやBigQueryなどへデータを流す
- 料金:公式サイトに具体額やプランはなく、個別に問い合わせて確認する(移行先の本体と組み合わせて検討)
自社の課題別に候補を絞る方法
5製品をすべて細部まで比べると手間がかかるため、最も大きな課題を一つ決め、必須要件で候補を絞るほうが効率的です。移行先を選ぶ課題と、既存データの収集・変換を効率化する課題では、優先する製品タイプが異なります。
移行先のデータ基盤そのものを選びたい場合
移行先の基盤は、扱うデータの種類と分析の目的によって候補が分かれます。
- Snowflake:構造化データの分析基盤候補
- Google BigQuery:Google Cloud利用企業の候補
- Amazon Redshift:AWS利用企業の候補
- Databricks:非構造化データや機械学習も重視する場合
全社で標準のクラウドを使っている場合は、そのベンダーの製品から検討を始めると、既存の権限管理や請求の仕組みと整合を取りやすくなります。
既存データの収集・変換を効率化したい場合
老朽化したオンプレミスRDBMSや複数の業務システムから、移行先の基盤へデータを流す工程に課題がある場合は、ETL/ELT専業サービスが候補になります。troccoもその一つです。
移行先はすでに決まっていて、データの収集・変換だけを効率化したい場合は、移行先製品の標準コネクタで足りるかを先に確かめます。そのうえで、足りない部分があれば専業のETL製品を組み合わせるかどうかを見極めます。
料金・契約前の確認事項
公開されている料金モデルだけで安いと判断すると、実際のデータ量やクエリ頻度によっては、想定外の費用が生じることがあります。
判断の際は、月額費用の目安だけでなく、移行作業、データクレンジング、教育に加えて、将来の解約時に必要になるデータの取り出しも、総保有コストに含めて考えます。
課金の対象と単位
クラウド基盤は、製品によって課金の単位が異なります。比べるときは、次の項目ごとに料金がどう決まるかを確かめます。
- ストレージ:保存するデータ量
- クエリ:実行時にスキャンする量
- コンピュート:リソースの稼働時間
- データ転送:転送するデータ量
各社へは、現在のデータ量だけでなく、1年後や3年後の増加ペースも伝えておきます。同じ条件で試算を依頼することが、比較の前提になります。
公式サイトに金額を載せていない製品も多いため、確認できていない項目を推測で比較表に埋めないよう注意します。
データ保管場所・ガバナンス・解約条件の契約書での確認
クラウド基盤には、取引データや個人情報が蓄積されていきます。そのため、契約前に次の管理条件を確かめておきます。
- アクセスと保護:権限管理、操作ログ、通信・保存時の暗号化
- 保管と復旧:データの保管リージョン、障害時の復旧体制
- 解約と規制:取り出し形式、保管場所や委託先の制約
業界固有の規制がある場合は、候補製品が規制の条件を満たすかを、早い段階で見極めます。
デモとPoCによる製品一覧の最終絞り込み
資料で比べて2〜3製品まで絞り込んだら、移行対象のデータを使ってデモまたはPoCを行います。
情報システム部門だけでなく、データを日常的に使う現場部門も参加すると、導入後の使い勝手をめぐる行き違いを減らせます。
実データの一部を使った移行から分析までの流れ
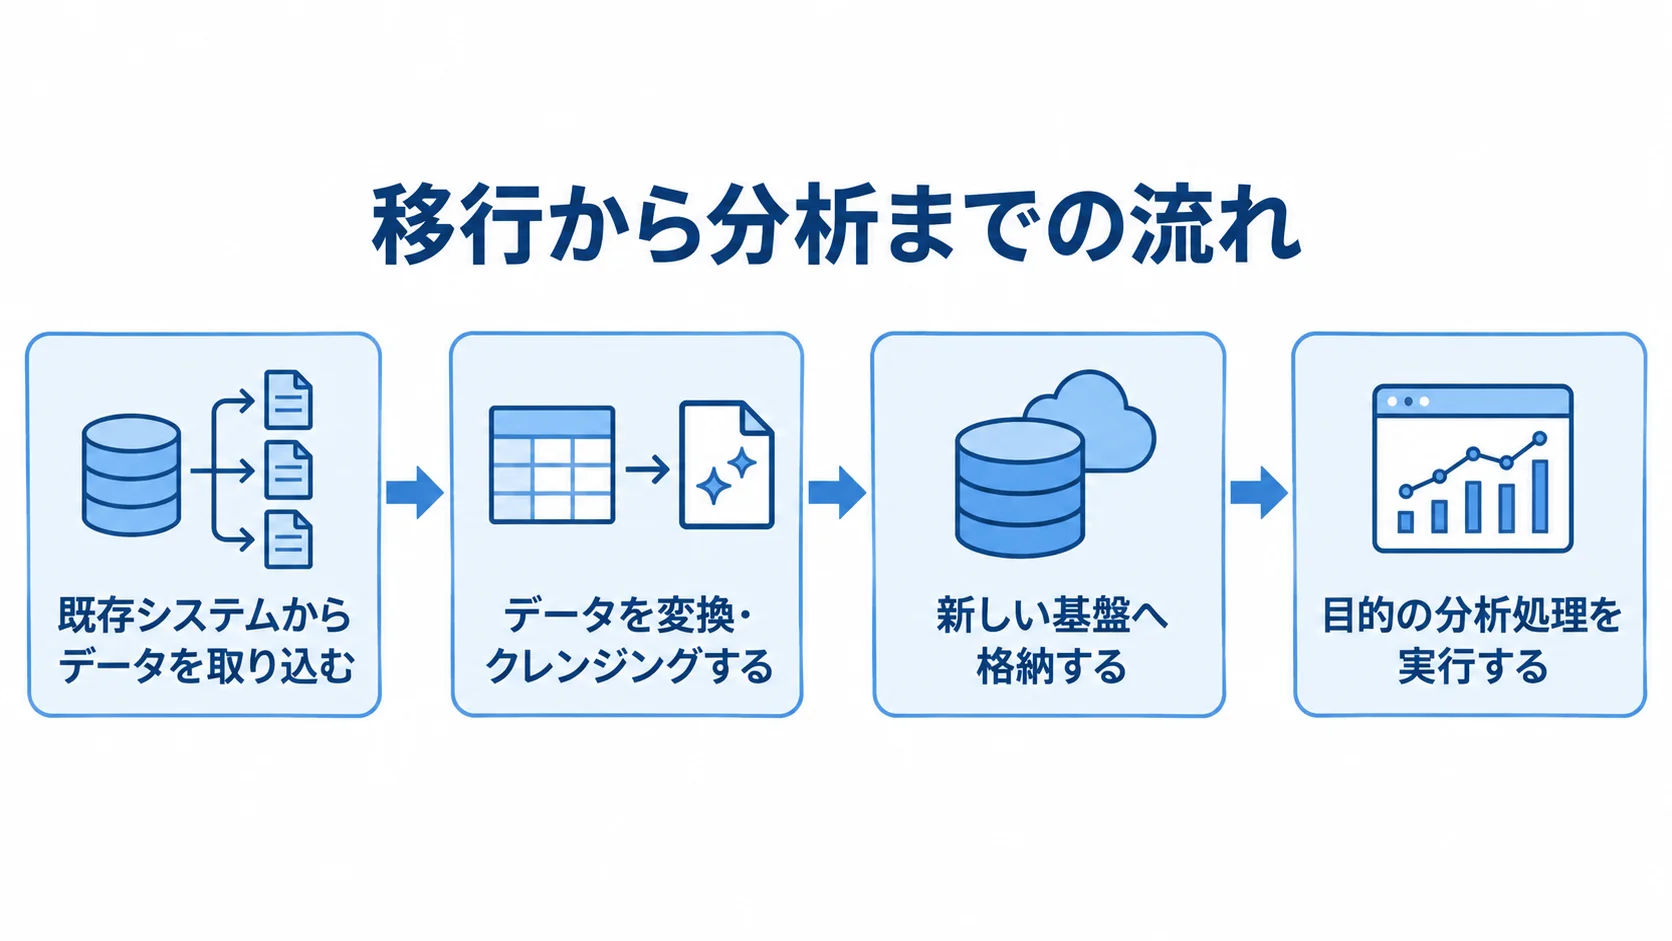
優先度の高い1〜2データソースで、次の流れを一通り試します。
- 既存システムからデータを取り込む
- データを変換・クレンジングする
- 新しい基盤へ格納する
- 目的の分析処理を実行する
欠損や表記ゆれのある実データも、あえて含めておきます。クレンジングの手間と処理時間を実測すれば、資料では見えない運用の負荷をつかめます。
コスト削減効果の自社データによる実測
PoCの前に、現在のバッチ処理時間、ハードウェアや保守の費用、データ照会の待ち時間を記録しておきます。PoC後の実測値と比べることで、効果を確かめられます。
他社の削減事例は参考にとどめ、自社のデータ量とクエリで従量課金を試算します。そのうえで、移行費用と運用体制の変更にかかる工数も差し引き、投資対効果を判断します。
データモダナイゼーションの製品比較で押さえておきたいポイント
自社のデータ量、既存システム、運用体制を同じ条件で比べると、知名度やおすすめ順位に左右されにくくなります。選定の場で判断が分かれやすいのは、基盤を独自に作るか既製品を使うか、どの製品が自社の重視点に合うか、料金をどう比べるかの3点です。
データ基盤本体をフルスクラッチで作る必要性
多くの企業では、データウェアハウスやデータレイクハウスのエンジンを独自開発する必要はありません。
極めて低いレイテンシやペタバイト級データなど特殊な要件がある場合を除き、既製クラウド製品を土台にできます。
データパイプラインや独自の業務連携の部分だけを個別に開発する組み合わせが現実的です。
自社の重視ポイントによるおすすめ製品の違い
全企業に共通して1位となる製品はなく、優先課題に合う製品を選ぶことになります。
- クラウド連携:既存ベンダーとの親和性
- データ活用:非構造化データの利用予定
- データ連携:収集・変換の効率化
必須要件で2〜3製品に絞ったうえで、同じデータを使ったデモまたはPoCで比べてください。
料金が公式サイトに載っていない場合の比較方法
今回確認した5製品は、いずれも公式製品ページに具体的な金額がありませんでした。
同じデータ量、クエリ頻度、保存期間を各社に示して、個別の見積もりを取ります。移行費用や運用工数も含めて、総保有コストで比べます。
まとめ
製品比較では、移行先となるデータウェアハウスやデータレイクハウスと、既存データの収集・変換を担うETL/ELT製品を分けて考えます。
Snowflake、Google BigQuery、Amazon Redshift、Databricks、troccoには、それぞれ異なる強みがあります。
既製クラウド製品か独自基盤かは、標準化する部分と独自要件を分けて判断します。ただし、既製品の標準コネクタや連携機能では、老朽化した基幹システム固有の形式や業界規制に対応できない場合があります。
標準機能に無理に合わせると、データの手作業による加工が残ります。
riplaはフルスクラッチ開発の立場から、比較で分かった連携要件の整理や、既存基幹システムと新基盤をつなぐ開発を支援します。
▼全体ガイドの記事
・データモダナイゼーションの完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・レガシーシステム刷新の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。