
Javaで開発された業務システムのドキュメントが失われると、どこから手をつければよいか迷うことが多くなります。そこで、Javaのリバースエンジニアリングは、対象と目的の確認から始め、解析環境の準備、静的解析と動的解析、設計への抽象化、成果物化へと、6つの工程を順に踏んで進めます。
▼全体ガイドの記事
・Javaのリバースエンジニアリングの完全ガイド
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
Javaのリバースエンジニアリングの概要
Javaのリバースエンジニアリングとは、コンパイル済みのバイトコード(.classファイルやJARファイル)から、元のソースコードに近い形を復元し、システムの仕様・設計・業務ロジックを解析する作業です。また、Javaはコンパイル後も比較的高い抽象度のバイトコードが残るため、他のネイティブバイナリ言語と比べて解析しやすい特性があります。
他言語との違い・Javaバイトコードの特性
Javaのリバースエンジニアリングが他言語と大きく異なる点は、バイトコード(.class形式)というJVM向けの中間表現が存在することです。C言語やC++がネイティブバイナリにコンパイルされるのとは異なり、Javaのバイトコードにはクラス名・メソッド名・型情報が残っています。
そのため、JD-GUI、CFR、Procyon等の専用逆コンパイラを使えば、元のソースコードに非常に近いJavaコードを自動生成できます。ただし、「比較的復元しやすい」ということは、同時に「悪意ある第三者にも解析されやすい」ということでもあります。
このため、商業アプリケーション、特にAndroidのAPKファイルには、ProGuardやR8による難読化が施されていることが多いです。難読化後のバイトコードでは、変数名やクラス名が一文字の記号に置き換えられ、解析難易度が大幅に上昇します。
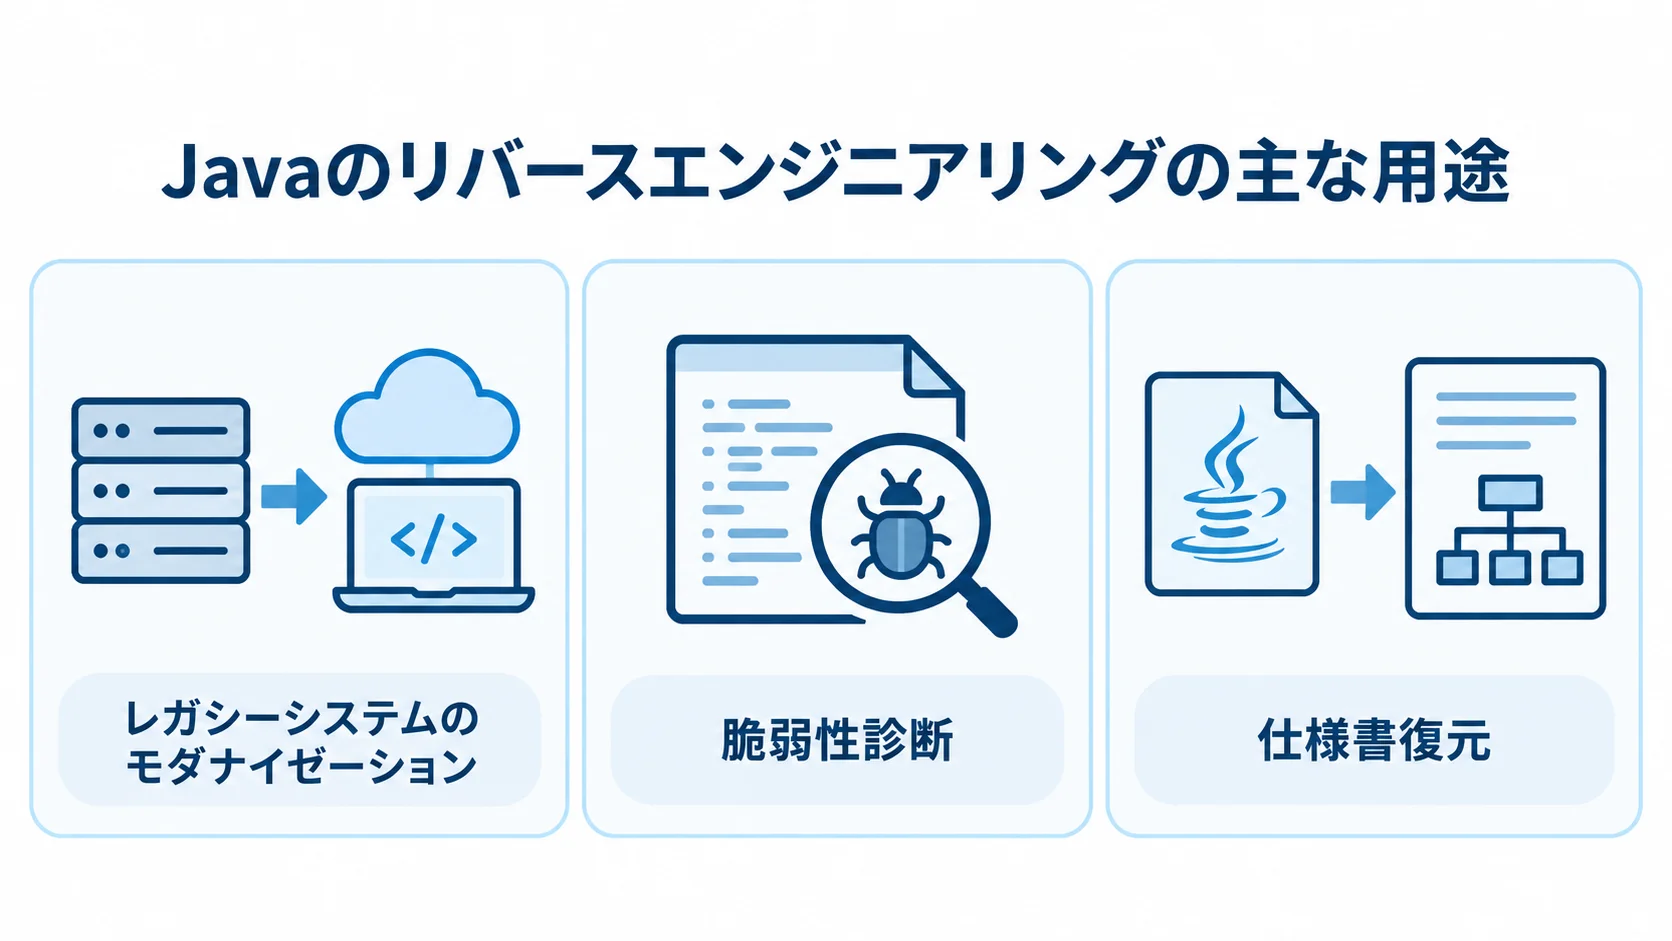
主な用途(レガシー移行/脆弱性診断/仕様書復元)
Javaのリバースエンジニアリングが実務で活用される場面は大きく3つあります。第一はレガシーシステムのモダナイゼーションです。EJB(Enterprise JavaBeans)やStrutsで構築された2000年代の業務システムは、10年以上前から現在まで多くの企業で稼働しています。こうした業務システムでは、開発者の退職や文書の散逸によってブラックボックス化が進んでいます。
こうしたシステムをSpring Bootへ移行する際には、リバースエンジニアリングで業務ロジックを復元することが増えています。第二は脆弱性診断です。自社Javaアプリケーションのセキュリティ監査や、オープンソース製品の改変状況確認(ライセンスコンプライアンス)において、バイトコードレベルでの解析が必要になります。
特に、OSSライブラリのバイトコードを解析して不正改変や禁止ライセンスの混入を確認するユースケースは、企業のコンプライアンス担当者から関心を集めています。第三は仕様書復元です。設計書が存在しないシステムの全体像を把握し、新システム開発の要件定義に活用する場合は、LOC(行数)あたり数十円の費用感で実施できます。
Javaのリバースエンジニアリングの6工程
Javaのリバースエンジニアリングを成功させるには、工程を決めて順番に進めることが必要です。場当たり的に逆コンパイルツールを動かすやり方では、十分な成果は得られません。
目的の明確化から成果物化まで、体系的な6つの工程を踏むことで、後工程の手戻りを防ぎ、質の高いアウトプットを得られます。
- 工程1:対象の選定と目的の明確化
- 工程2:解析環境とJava特化ツールの準備
- 工程3:逆コンパイルとクラス構造の静的解析
- 工程4:デバッガと実行トレースによる動的解析
- 工程5:実装から設計・仕様への抽象化
- 工程6:仕様書や新システム設計への成果物化
1. 対象選定・目的明確化
最初の工程では、解析対象のJavaシステムの全体像を把握し、プロジェクトの目的を明確に定義します。対象がJARファイルかWARファイルかEARファイルかによって、解析アプローチが変わります。さらに、解析の目的が「仕様書復元」なのか「脆弱性診断」なのか「モダナイゼーション前の業務ロジック抽出」なのかによって、解析の深度と成果物の形式が異なります。
特に事前に確認したいのは、ProGuardなどによる難読化の有無です。難読化が施されている場合は、解析工数が2〜3倍以上に膨らむ可能性があるため、見積もりの前提条件として必ず確認しておく必要があります。
Springなど大規模フレームワークを使用しているシステムでは、フレームワーク依存の設計意図が失われやすくなります。たとえば、なぜこのBean定義になっているのか、といった設計判断がそれにあたります。そのため、フレームワークのバージョンやDIコンテナの設定ファイルも解析対象に含めることを検討します。
2. 解析環境・ツール準備(Java特化ツール)
Javaのリバースエンジニアリングに特化した逆コンパイラとして、JD-GUI、CFR(Class File Reader)、Procyonの3つが代表的です。JD-GUIはGUIベースで操作が直感的であり、手軽に.classファイルを可視化できます。
CFRはコマンドラインで動作し、最新のJava構文(ラムダ式やswitch式など)への対応が優れているため、バッチ処理に向いています。Procyonは内部構造の復元精度が高く、特にジェネリクスを多用したコードの解析に強みがあります。このように特性が異なるため、用途に応じて使い分けることが大切です。
APKファイル(AndroidアプリのJavaバイトコードを含む)の解析には、apktools でリソースを展開します。そのうえで、dex2jar でDEXファイルをJARに変換してからJD-GUIで開くのが標準的なワークフローです。さらに、解析環境はインターネットから切り離した専用端末を用意し、解析過程をログとして残すと、後述の法的リスク回避にも役立ちます。
3. 静的解析(逆コンパイル・クラス構造の把握)
静的解析では、実際にプログラムを実行せずに、コードの構造・クラス間の依存関係・メソッドの呼び出し関係を解析します。逆コンパイルツールで生成したJavaコードをIDEにインポートし、クラス図やシーケンス図を自動生成すると、全体アーキテクチャを俯瞰できます。
EclipseやIntelliJ IDEAには、デコンパイル済みのコードから自動でUMLダイアグラムを生成するプラグインが存在します。
Springフレームワークを使用したシステムでは、XMLベースのBean定義ファイルやアノテーション(@Service、@Repository、@Transactionalなど)を手がかりにします。解析の観点は2つに分けて考えます。
- 設計意図の読み取り:DIコンテナの設計意図を、定義ファイルから読み取る
- 動的解析との組み合わせ:フレームワークが隠蔽している処理(AOPによるトランザクション制御など)は、静的解析だけでは把握しにくいため、動的解析で補う
4. 動的解析(デバッガ・実行トレース)
動的解析では、実際にJavaアプリケーションを起動し、実行時の振る舞いをデバッガやプロファイラでトレースします。JVMにはJDWP(Java Debug Wire Protocol)というデバッグプロトコルが標準で組み込まれており、リモートデバッグ接続を使えば実行中のプロセスにアタッチできます。これにより、変数の状態やスタックトレースをリアルタイムで観察できます。
特にEJBのトランザクション境界やStrutsのActionクラスの遷移を追跡する際は、ログ出力を増やしたデバッグ用環境を別途構築し、実際のビジネストランザクションを流しながら挙動を記録する手法が有効です。さらに、Wiresharkを使ったネットワークトレースと組み合わせれば、外部システムとのI/F仕様も同時に把握できます。
動的解析は、静的解析では見えなかった「実際に使われているコードパス」と「デッドコード(未使用機能)」を明確にするうえで欠かせない工程です。
5. 抽象化(Design Recovery:実装→設計→仕様)
抽象化工程では、静的・動的解析で得られた実装レベルの情報を、設計レベル・仕様レベルへと段階的に抽象化します。具体的には、逆コンパイルで得られたJavaコードをベースに、業務フローチャート・クラス設計書・データモデル(ER図)・画面遷移図へと変換していきます。
この工程は、リバースエンジニアリング全体の価値を決める最も重要なフェーズです。特に難しいのは、「コードが何をしているか(How)」は把握できても、「なぜそのロジックになっているか(Why)」がコードからは読み取れない点です。
たとえば、特定の条件分岐に業務上の意味がある場合でも、変数名が難読化されていたり、コメントが存在しなかったりすると、その意図を解析者が正確に理解することは困難です。そのため、このWhyを補うには、業務部門の担当者へのヒアリングやドメインエキスパートの協力が不可欠です。
6. 成果物化(仕様書/新システム設計への接続)
最終工程では、抽象化した設計情報を成果物として文書化します。成果物の粒度は発注時に明確に合意しておく必要があり、「単純なフローチャート」「業務仕様書(画面・DB設計含む)」「新システム開発に直接使える詳細設計書」の3段階によって、費用と期間が大きく異なります。
Javaシステムをモダナイゼーションする場合の例には、StrutsからSpring Boot、EJBからSpring Frameworkへの移行があります。この場合、成果物の詳細設計書が、新システムのAPI定義・クラス設計・DB設計の直接のインプットとなります。
この段階で、現行機能をすべて移植するか、不要な機能(過去の遺物)を洗い出して省くかを決め、モダナイゼーションの範囲を確定させます。範囲が定まっていると、後工程の効率化と費用の抑制につながります。
Javaのリバースエンジニアリングにおける固有の注意点
Javaの解析では、技術的な難しさを大きく左右する固有の要素があります。事前にこれらを把握しておくと、プロジェクト計画の精度が上がり、予期しないコスト超過を防げます。
典型的な失敗パターン:Springフレームワーク依存の落とし穴
Springフレームワークを使ったシステムで最もよく見られる失敗は、「コードは読めたが業務ルールの意図が分からず、移行後にバグが多発する」というケースです。Springは依存性注入(DI)やアスペクト指向プログラミング(AOP)によって、業務ロジックとインフラ処理が分離されています。しかし、この分離が、解析者にとって「どこに何の処理があるか」を分かりにくくします。
EJBシステムの解析では、CMT(コンテナ管理トランザクション)の境界がアノテーションやXML設定に隠蔽されているため、トランザクション制御ロジックを見落とすリスクがあります。
また、StrutsのActionクラスはサーブレットと業務ロジックが密結合しているため、逆コンパイル後のコードがスパゲティ状になりやすく、解析者にとっても保守担当者にとっても読みにくい状態になります。このような複雑性を過小評価して工数見積もりをすると、プロジェクト後半で大幅な手戻りが発生します。
ProGuardによる難読化への対処と限界
AndroidアプリのAPKに含まれるJavaバイトコードは、ProGuardやR8による難読化が標準的に施されています。難読化後のコードでは、クラス名がa.b.cのような意味のない記号になり、メソッド名もa()・b()・c()と変換されるため、逆コンパイル自体は成功しても、コードの意味を解読することが格段に難しくなります。
対処法としては、ProGuardのマッピングファイル(mapping.txt)が入手できる場合は、それを使って元の名称に復元する方法が最も効果的です。ただし、マッピングファイルが存在しない場合は、実行時のログ出力や例外スタックトレースを手がかりに、意味のあるクラス名を推定・付与する作業(リネーミング)が必要になります。
リネーミング作業は非常に時間を要するため、難読化されたAPKの解析費用は、通常の非難読化コードの解析と比べて2〜4倍になるケースが多いです。
法的リスクの回避とコンプライアンス対応
Javaのリバースエンジニアリングを実施する前に、法的リスクを正確に理解しておく必要があります。特に、OSSのライセンスコンプライアンス確認でバイトコード解析を行う場合は、著作権法の要件を満たした手順を踏むことが、企業のリスク管理の観点からも求められます。
クリーンルーム手法の実務運用
平成30年(2018年)の著作権法改正(第30条の4)により、非享受目的(仕様書復元・セキュリティ調査・マルウェア解析など)のリバースエンジニアリングは原則として合法化されました。ただし、ソースコードの無断複製や競合製品への転用は、依然として著作権侵害となります。
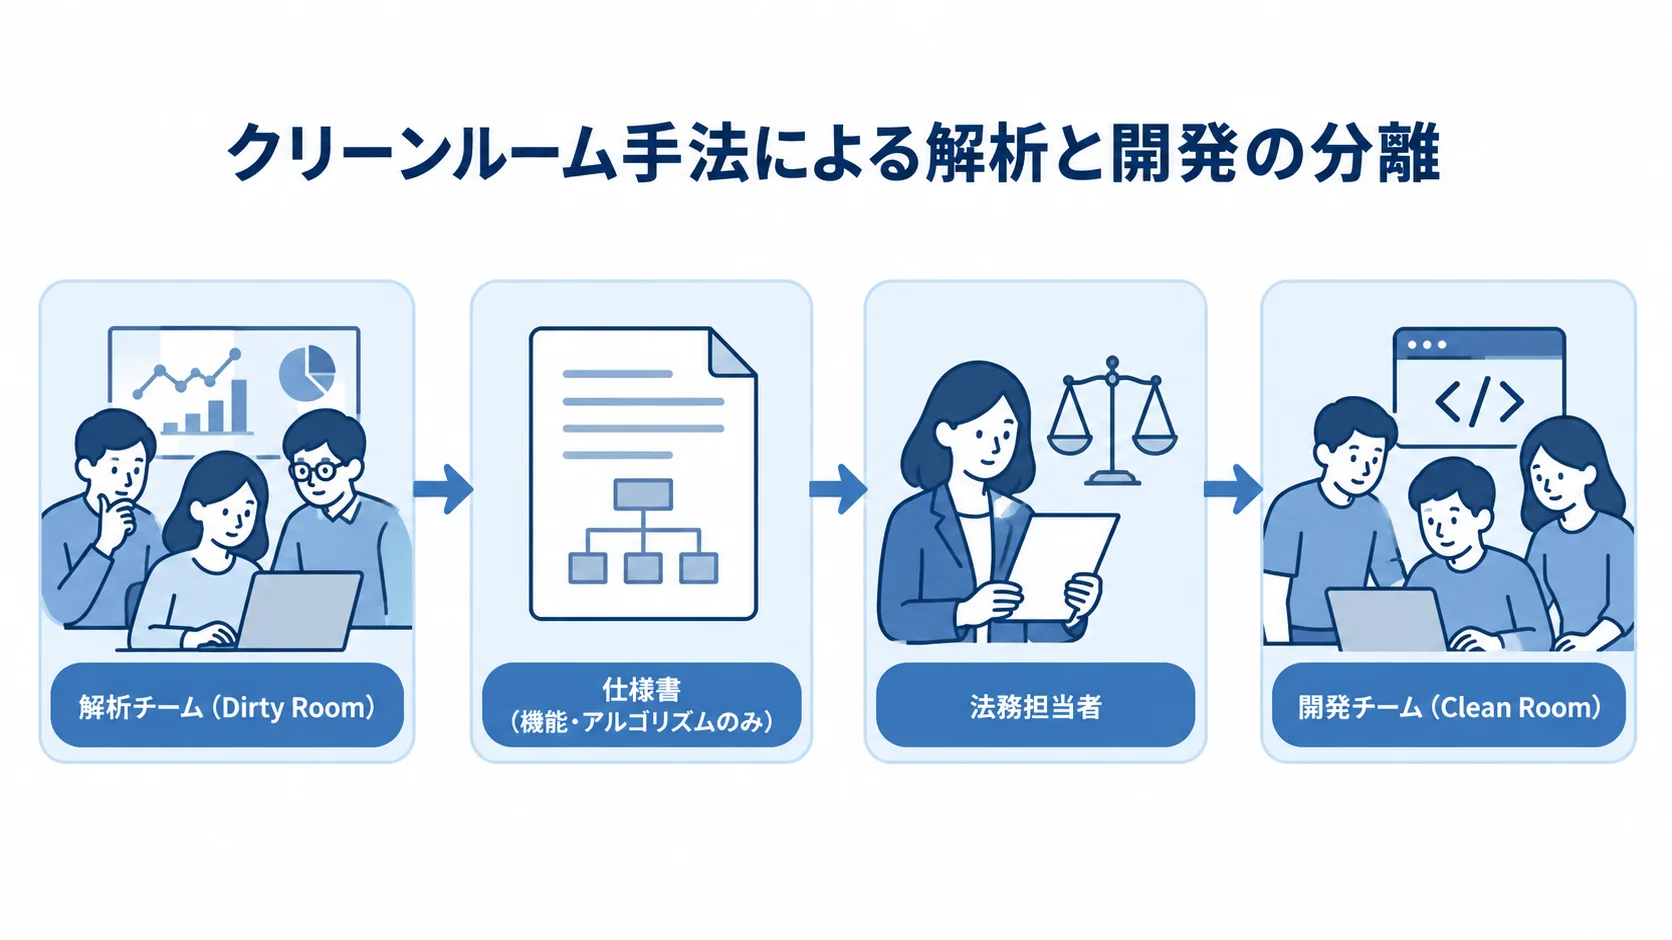
そこで、著作権侵害リスクを確実に回避するための手法が、クリーンルーム手法です。解析チーム(Dirty Room)と開発チーム(Clean Room)を完全に分離します。解析チームが作成した仕様書(機能・アルゴリズムのみを記述し、元コードの表現は含まない)のみを開発チームに渡し、新システムを開発させます。
両チームの間には法務担当者を配置し、仕様書に著作権保護対象の表現が混入していないかを検査する体制が理想です。また、この手法は、IBM BIOS互換製品を開発したフェニックス・テクノロジーズの事例で有効性が実証されています。
非享受目的の立証と記録管理
著作権法第30条の4の適用を受けるためには、「非享受目的」であることを立証できる記録を残しておくことが大切です。
具体的には、解析専用のパソコンを用意して解析作業を実施すること、解析過程をレポートとして記録することが有効です。さらに、解析した情報をプログラムの実行による享受(ゲームのプレイ、映像の視聴など)ではなく技術的分析に使ったことを示す文書を整備しておくことも役立ちます。
OSSライセンスのコンプライアンス確認でJavaバイトコードを解析する場合は、特に記録の整備が欠かせません。GPLやLGPLのライブラリが自社製品に不正に組み込まれていないかをバイトコードレベルで確認する作業は、コンプライアンス上の正当な目的として認められます。そのうえで、プロセスと目的を文書化しておくと、第三者からの疑義に対して明確に説明できます。
外注 vs 内製の判断軸
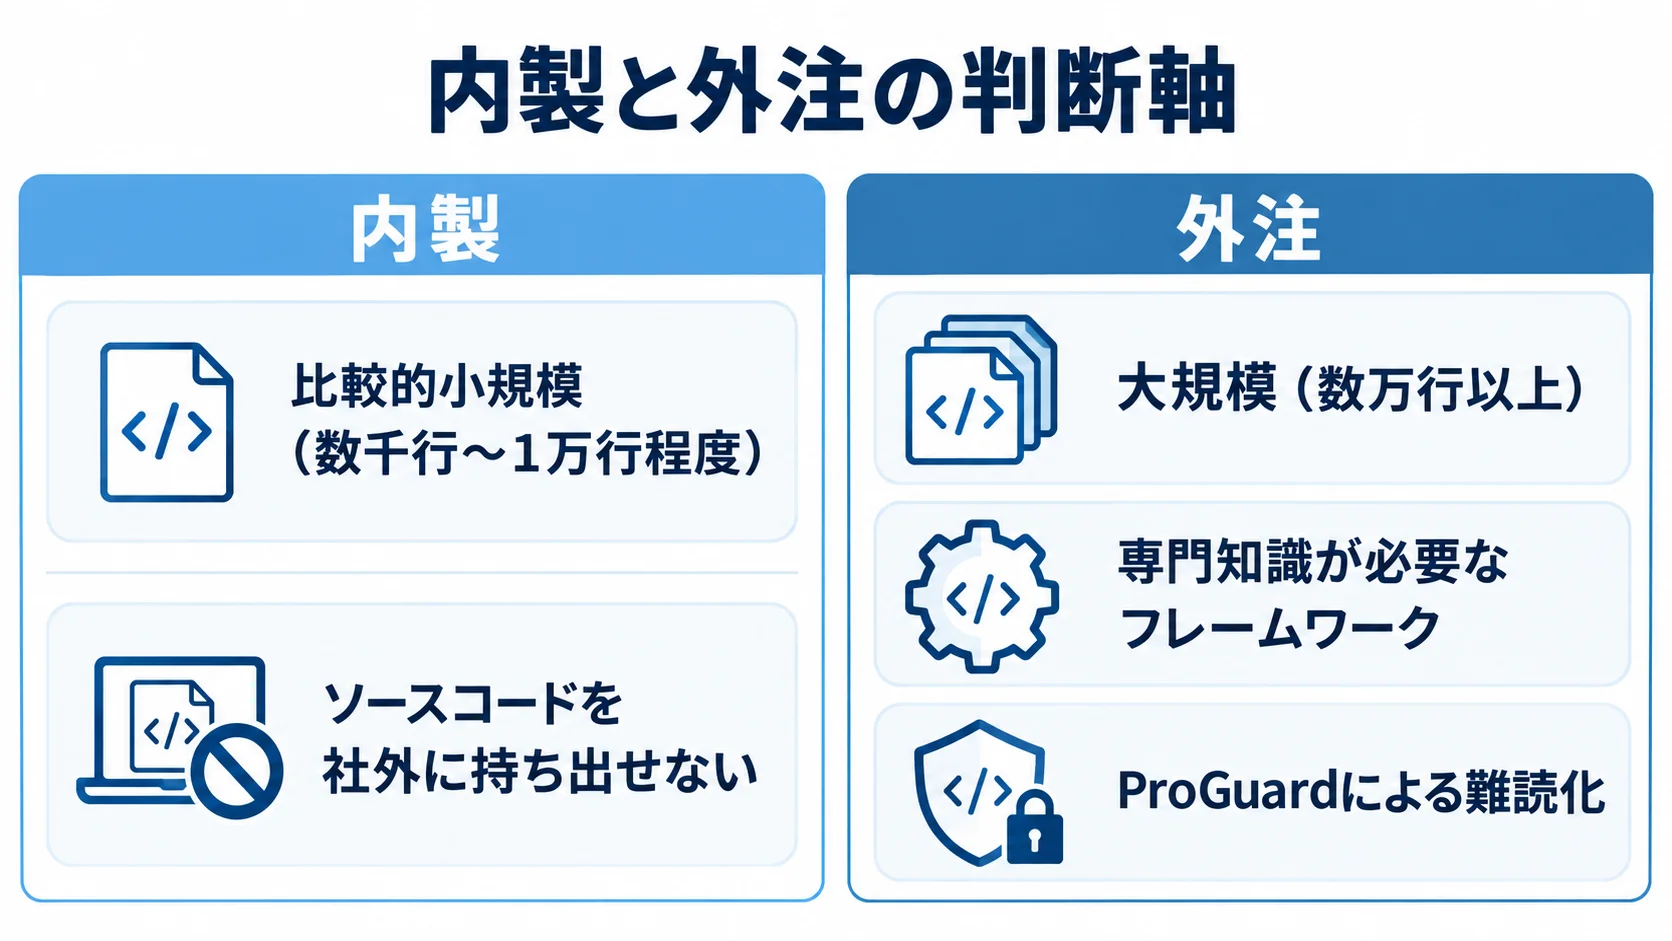
Javaのリバースエンジニアリングを自社で実施するか外注するかは、プロジェクトの規模・緊急度・社内技術リソースによって異なります。自社の状況に合わせて選ぶには、内製と外注それぞれが向いているケースを比べるとよいでしょう。
内製が向いているケースと条件
内製が適しているのは、自社にJava経験が豊富なシニアエンジニアがいる、解析対象が比較的小規模(数千行〜1万行程度)、業務ロジックの詳細を知る担当者が社内にいる、という条件が揃っているケースです。また、セキュリティ上の理由からソースコードを社外に持ち出せない場合も、内製が必要になります。
内製の場合も、JD-GUIやCFRといったツールの習熟には時間がかかるため、少なくともパイロットフェーズは、試算以上の工数を見込んでおく必要があります。
外注が向いているケースと選定ポイント
解析対象が大規模(数万行以上)、EJBやStrutsなど専門知識が必要なフレームワークが絡む、ProGuardによる難読化が施されている、という場合は外注が合理的です。外注先を選ぶ際は、Javaの解析実績(特にモダナイゼーション案件)があるか、クリーンルーム手法を自社プロセスとして確立しているか、成果物の粒度と品質基準を事前に示せるかを確かめておくとよいでしょう。
費用目安として、ソースコード解析による仕様書復元はLOCベースで30万円(4,000行まで)が基本料金となり、超過分は1行あたり50円程度が相場です。さらに、Springなど複雑なフレームワークを使用したシステムや、難読化が施されたAPKの場合は、この単価に割増係数をかける必要があります。
モダナイゼーション全体(リファクタリング〜リビルド)では、2億〜5億円以上の投資規模になるケースも珍しくなく、リバースエンジニアリングはその前段階の調査コストと位置づけるのが適切です。
まとめ
Javaのリバースエンジニアリングは、バイトコードという中間表現があるため、C言語などネイティブバイナリを扱う言語と比べて解析の出発点が高くなります。JD-GUI・CFR・Procyonといった専用ツールを使えば、比較的高品質な逆コンパイルが可能です。
Java固有の難しさとして、ProGuardによる難読化やSpringフレームワークの設計意図の喪失、EJB/Strutsシステムの業務ロジックの複雑さなども存在します。
成功のカギは、目的と成果物粒度を明確にすること(工程1)と、適切なツールを選ぶこと(工程2)にあります。加えて、静的・動的解析を組み合わせること(工程3・4)と、業務部門と連携して抽象化すること(工程5)も大切です。また、法的リスクを管理したクリーンルーム体制(工程6)も欠かせません。
特に古いJavaのEJB/Struts製業務システムのSpring Bootへのモダナイゼーション案件では、設計書が失われているケースが多いため、リバースエンジニアリングが最も現実的な出発点となります。そのうえで、外注する場合は、Java案件の実績・クリーンルーム体制・成果物基準の3点を必ず確認してください。
▼開発を相談する前に読みたい無料ホワイトペーパーはこちらをご覧ください。
・【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。