
PL/Iのリバースエンジニアリングは、対象と目的を決めることから始め、静的・動的解析を経て、仕様書にまとめる流れで進みます。
PL/I特有のデータ型や実行環境への深い理解が欠かせず、COBOLの対応経験がある会社でも対応しきれないケースは少なくありません。
▼全体ガイドの記事
・PL/Iのリバースエンジニアリングの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
PL/Iのリバースエンジニアリングの概要
PL/I(Programming Language One)は、1960年代に IBM が汎用業務向けに開発したプログラミング言語です。FORTRAN の数値計算能力と COBOL の業務処理能力を融合させた設計が特徴で、COBOL と並ぶ基幹業務向け言語として、IBM 大型汎用機(メインフレーム)上のシステムを支えてきました。
保険会社の保険金計算システムや証券会社の清算システム、大規模な官公庁の給付管理システムなど、ミッションクリティカルな基幹業務の中核を担ってきました。こうしたシステムで行われるリバースエンジニアリングとは、現行の PL/I プログラムのソースコードやバイナリを解析し、失われた設計書や仕様書を復元する、専門性の高い作業を指します。
他言語との違い・特性
PL/I のリバースエンジニアリングが COBOL や C 言語と大きく異なるのは、言語固有のデータ型が複雑な点です。POINTER 型による動的メモリ管理、BASED 変数(ポインタが指すメモリ領域に割り当てられる変数)、AREA 属性による動的メモリプール管理などが、逆コンパイル後のコードを著しく難読にします。
COBOL では変数の役割を比較的容易に特定できるのに対し、PL/I で特に差が出るのは、次の点です。
- ポインタ追跡:BASED 変数のポインタを追うだけで解析工数の数割を占めるケースがある
- 実行環境:IBM メインフレーム固有のミドルウェアと密接に結びついている
- 連携部分:JCL(Job Control Language)や IMS/DB などとの連携は、PL/I ソースだけでは意味が読み取れず、実行環境全体の俯瞰が必要
- 人材:COBOL に比べてもエンジニアの人口が少なく、この実行環境を熟知した解析者の確保自体が大きなハードル
JCL によるバッチ制御、IMS/DB によるデータベースアクセス、VSAM ファイルの直接操作、CICS トランザクション制御は、PL/I のソースを読むだけでは意味が分かりません。そのため、実行環境全体を俯瞰して解析する必要があります。
主な用途(レガシー移行/脆弱性診断/仕様書復元)
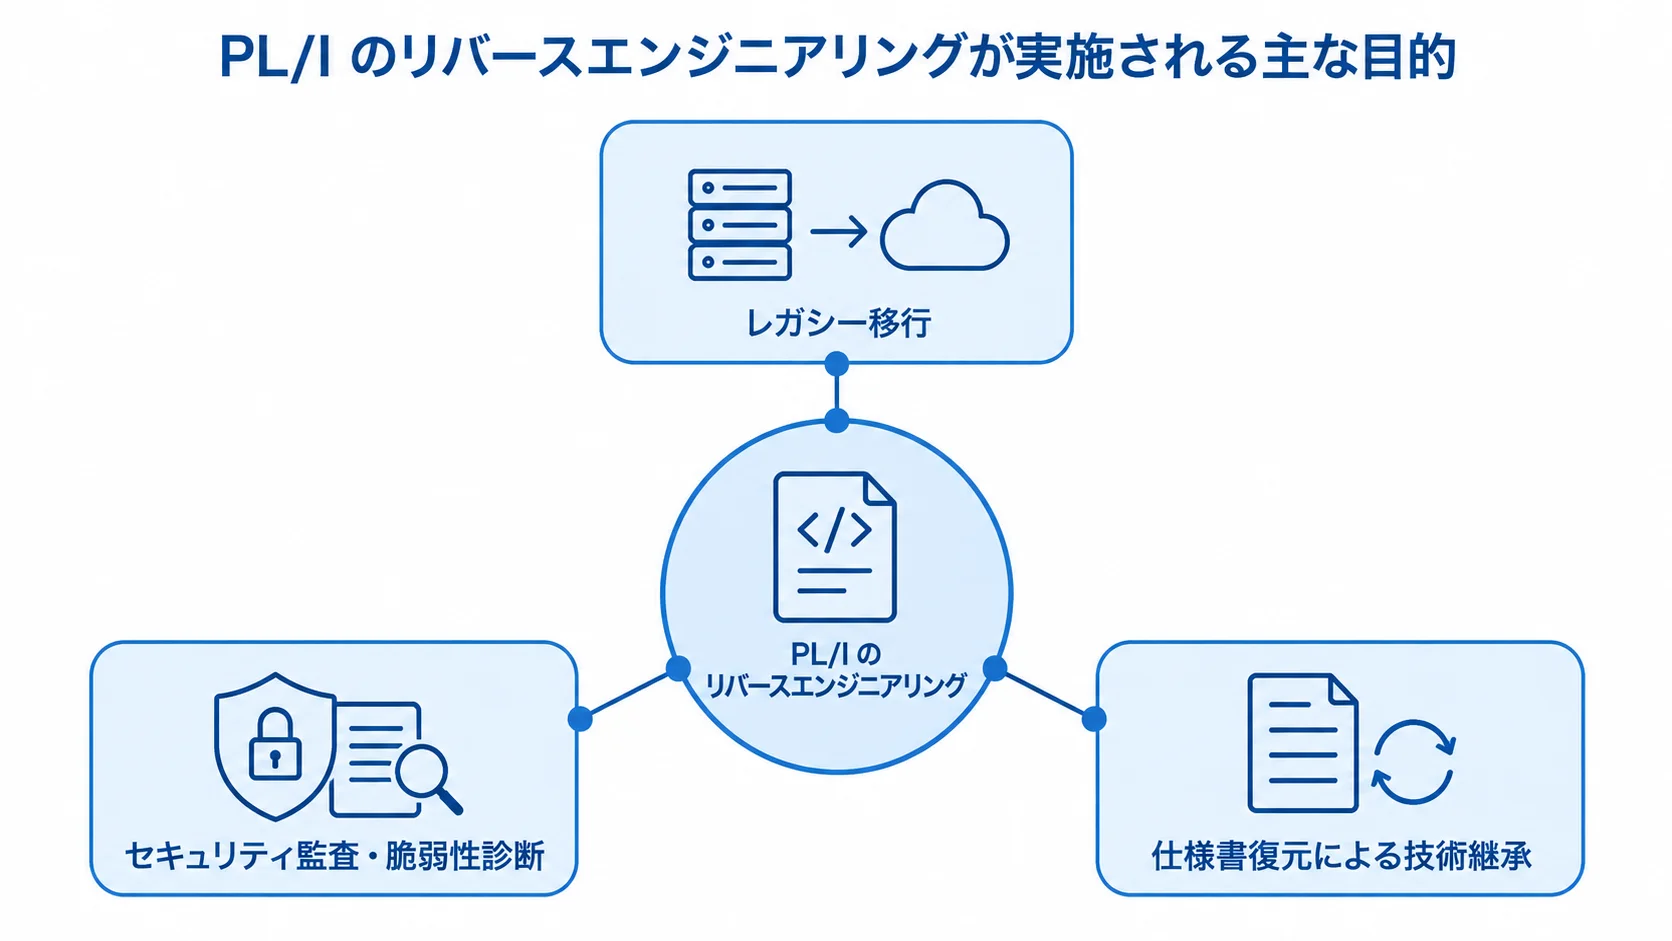
PL/I のリバースエンジニアリングが実施される主な目的は 3 つに大別されます。第一は、メインフレームからオープン系やクラウド基盤へのモダナイゼーション(レガシー移行)です。設計書が消失しているか、初めから整備されていない場合には、リバースエンジニアリングで業務仕様を復元し、新システムの要件定義書として活用します。
第二は、セキュリティ監査・脆弱性診断です。長年稼働してきたシステムに潜む脆弱なロジックを特定するため、静的解析と動的解析を組み合わせて実施します。
第三は、仕様書復元による技術継承です。PL/I を扱えるエンジニアの退職や高齢化が進むなか、属人的に保持されていた業務知識をドキュメント化し、次世代の担当者が保守できる状態にすることが目的となります。
PL/Iのリバースエンジニアリング 6 工程
PL/I のリバースエンジニアリングを成功させるには、場当たり的に解析するより、体系化された工程に沿うことが大切です。実際のプロジェクトでは、6つの工程を順に踏みます。
- 工程1:対象の選定と目的の明確化
- 工程2:解析環境とツールの準備
- 工程3:静的解析
- 工程4:動的解析
- 工程5:実装から設計・仕様を抽象化
- 工程6:仕様書や新システム設計書の成果物化
工程1:対象選定・目的明確化
プロジェクトの開始前に、「何のためにリバースエンジニアリングを行うか」を決めておくことが、工数と費用を大きく左右します。PL/I システムは、一つの基幹システムが数百から数千のプログラムモジュールで構成されることも珍しくありません。そのため、全量を解析するか特定の業務領域に絞るかで、期間と費用が数倍単位で変わります。
また、最終的な成果物が「フローチャートレベルの処理概要」なのか、「新システム開発に直接使える詳細業務仕様書」なのかを、最初に合意しておきます。この合意があれば、後工程での手戻りを防げます。
対象の選定では、JCL の JOB 定義から実行されるプログラム一覧を洗い出し、業務上の重要度と変更頻度から優先順位をつける方法が有効です。さらに、IMS/DB や VSAM のデータセット名とプログラムの対応関係をマトリクスにまとめて影響範囲を一覧にすると、解析の起点となる「コアモジュール」を特定できます。
工程2:解析環境・ツール準備
PL/I の解析環境は、他のオープン系言語と比べて特殊な準備を要します。IBM メインフレーム上でコンパイルされた PL/I プログラムは EBCDIC エンコーディングで記述されているため、解析ツールやテキストエディタも EBCDIC に対応したものを選ぶ必要があります。
解析の準備では、次の資料を集めておくことが欠かせません。
- ソースリスト:コンパイラが出力する詳細なリスティング。あれば最大限に活用
- データ構造:変数の宣言部(DCLS)から全データ構造をマッピングする、解析の基礎となる作業
- ミドルウェアの設定ファイル:CICS のトランザクション定義、IMS/DB のセグメント定義など
IBM Rational Developer for z/OS や Micro Focus Enterprise Analyzer などのメインフレーム専用ツールは、PL/I のコード構造解析に対応しています。一方、一般的な Ghidra や IDA Pro はネイティブバイナリの解析に優れますが、PL/I の高水準構造体(STRUCTURE、UNION)やポインタ操作の意味論的解析は苦手です。
このため、PL/I ソースコードが入手できる場合は、ソースベースの解析ツールを優先します。
工程3:静的解析(逆コンパイル/制御フロー分析)
静的解析では、プログラムを実行せずにソースコードやコンパイル済みバイナリを読み解きます。PL/I では特に、BASED 変数とポインタの追跡が重要です。さらに、制御フロー分析では、PL/I の ON 条件(例外処理)に特別な注意が必要です。
データ構造の生成と破棄、例外処理の分岐、モジュールの入口は、いずれも見落とすと仕様が欠けるため、特に注意して追います。
- ALLOCATE 文と FREE 文:全プログラムにわたって追い、どのモジュールがデータ構造を生成・変更・破棄しているかを特定
- ON 条件(例外処理):ONCODE 関数の入れ子で例外時の分岐を別に追わないと、異常系処理を見落とすおそれ
- 複数のエントリポイント:CALL 文と ENTRY 文で入口が複数あるモジュールは一般的で、見落とすと業務ロジックの一部が欠けた仕様書になる
ALLOCATE 文と FREE 文の追跡は、データの所有者と生存期間を明確にするために欠かせず、後の業務仕様書作成でデータフロー図の基礎になります。
工程4:動的解析(デバッガ・実行トレース)
動的解析では、実際にプログラムを実行しながら挙動を観察します。PL/I の動的解析はメインフレーム環境での実施が前提となるため、z/OS 上の Xpediter(Compuware 製のデバッガ)や IBM Debug Tool を使ったトレースが主な手段です。
本番環境での動的解析はリスクが高いため、通常はテスト環境(LPAR:論理パーティション)を用意し、本番と同一のデータ(マスキング処理済み)で実行トレースを取得します。特に価値が高いのは、CICS トランザクションの入力データと IMS/DB への書き込みデータの対応関係を、実際のデータで確認できる点です。
静的解析では「このフィールドに何が入るか」が曖昧なケースもありますが、実行トレースで業務上の実際の値を確認でき、計算ロジックの意味解釈の精度が飛躍的に向上します。また、月次バッチや年度更新処理のように特定の業務イベントでのみ発火する分岐条件は、静的解析では発見が難しく、動的解析との組み合わせが必須です。
工程5:抽象化(Design Recovery:実装→設計→仕様)
静的・動的解析で得た情報を、実装レベルから設計レベル、さらに業務の仕様レベルへと段階的に抽象化するのが Design Recovery です。PL/I の場合、この過程で最も難しいのは、コードが何をしているか(How)は分かっても、なぜその実装なのか(Why)が分からないことです。
たとえば、特定の計算ロジックが「業法上の規制に基づく特例計算」なのか「過去の障害対応で追加されたパッチ」なのかは、コードからは判断できません。そこで、業務部門の担当者や当時の開発に関与した人材へのインタビューが欠かせません。
解析チームが「このロジックの業務上の意味は何か」「この閾値はどの規定から来ているか」といった質問リストを作り、業務部門と定例の確認会議を重ねることで、Why の部分を埋めていきます。したがって、業務部門との協働なしに、新システム開発に使える精度の高い仕様書を完成させることは困難です。
工程6:成果物化(仕様書/新システム設計)
解析と抽象化の結果を、ドキュメントとして整備します。成果物のレベルは、プロジェクト当初の目的設定に基づいて「フローチャート」「業務仕様書」「詳細設計書(画面遷移図・DB 設計含む)」の 3 段階に分かれます。
フローチャートレベルは処理の概要をつかむ用途に適し、費用・期間が最も短く収まります。一方、詳細設計書レベルでは、VSAM ファイルや IMS/DB のセグメント定義を新システムの DB 設計へそのまま転換できる水準まで情報を整備します。そのぶん費用・期間は大幅に増えますが、新システム開発での手戻りを最小化できます。
成果物には、変数名の意味と役割、業務ルールの背景(Why)、例外処理の業務的な意味を、必ずコメントとして書き込むよう仕様に含めることを推奨します。機械的な解析だけで生成されたスパゲティコードのような成果物では、新システムの開発者が仕様を誤解するおそれがあり、保守性の低いシステムにつながります。
PL/I固有の注意点
PL/I には、他言語では見られない特有の技術的難所が複数存在します。これを事前に把握しておかないと、解析工数が大幅に膨らんだり、重要な業務ロジックを見落としたりします。
典型的な失敗パターン
PL/I のリバースエンジニアリングで最も多い失敗は、BASED 変数とポインタ操作の追跡漏れです。PL/I では、同一の BASED 変数が実行時に複数の異なる構造体を指すよう切り替わるコーディングが珍しくありません。そのため、「このポインタが実行時にどの構造体を指しているか」を、静的解析の結果だけで確定させるのは難しくなります。
この結果、業務上のデータ変換ロジックが不完全にしか復元されず、新システム移行後にデータ不整合が多発するケースがあります。また、AREA 属性(動的メモリプール)を使ったバッファ管理では、プログラム間で AREA を受け渡して大量データを効率的に処理します。この受け渡し構造を見落とすと、複数モジュールにまたがるデータフローの全体像を把握できなくなります。
さらに、長年の運用のなかでパッチ適用により追加された「暗黙的な業務ルール」が散在するケースも多く、たとえば特定の顧客コード範囲だけ計算方法が異なるといった条件が含まれます。これをすべて文書化するには、業務担当者との丁寧なヒアリングが欠かせません。
難読化・環境依存への対処
PL/I プログラムそのものへの難読化は一般的ではありませんが、メインフレーム固有の環境依存が解析の壁になります。たとえば、IBM MACRO ライブラリを使ったアセンブラ呼び出しが混在し、そのアセンブラルーチンの動作仕様が失われていると、呼び出し元の PL/I コードの意味を正確に解釈できません。
同様に、CICS の BMS(Basic Mapping Support)で定義された画面マップと PL/I プログラムの COMMAREA の対応関係は、設計書がないと追跡が難しいケースがあります。対処策としては、IBM の公式マニュアル(IBM Knowledge Center)と合わせて、社内に残る運用手順書や運用マニュアルを総動員することが有効です。
また、CICS の DFHCSDUP コマンドや IMS の DBD/PSB 定義からミドルウェア側の仕様を抽出し、解析の補助資料として活用します。メインフレーム固有の「環境依存の謎」を一つずつ解消していく手法が、実務では一般的です。
法的リスクの回避
PL/I のリバースエンジニアリングでは、著作権法・不正競争防止法・特許法など複数の法律に適合しているかを、事前に確認しておく必要があります。特に、自社開発でないシステム(他社から導入したパッケージ等)を対象とする場合は、法的な整理を慎重に進めます。
クリーンルーム手法の実務
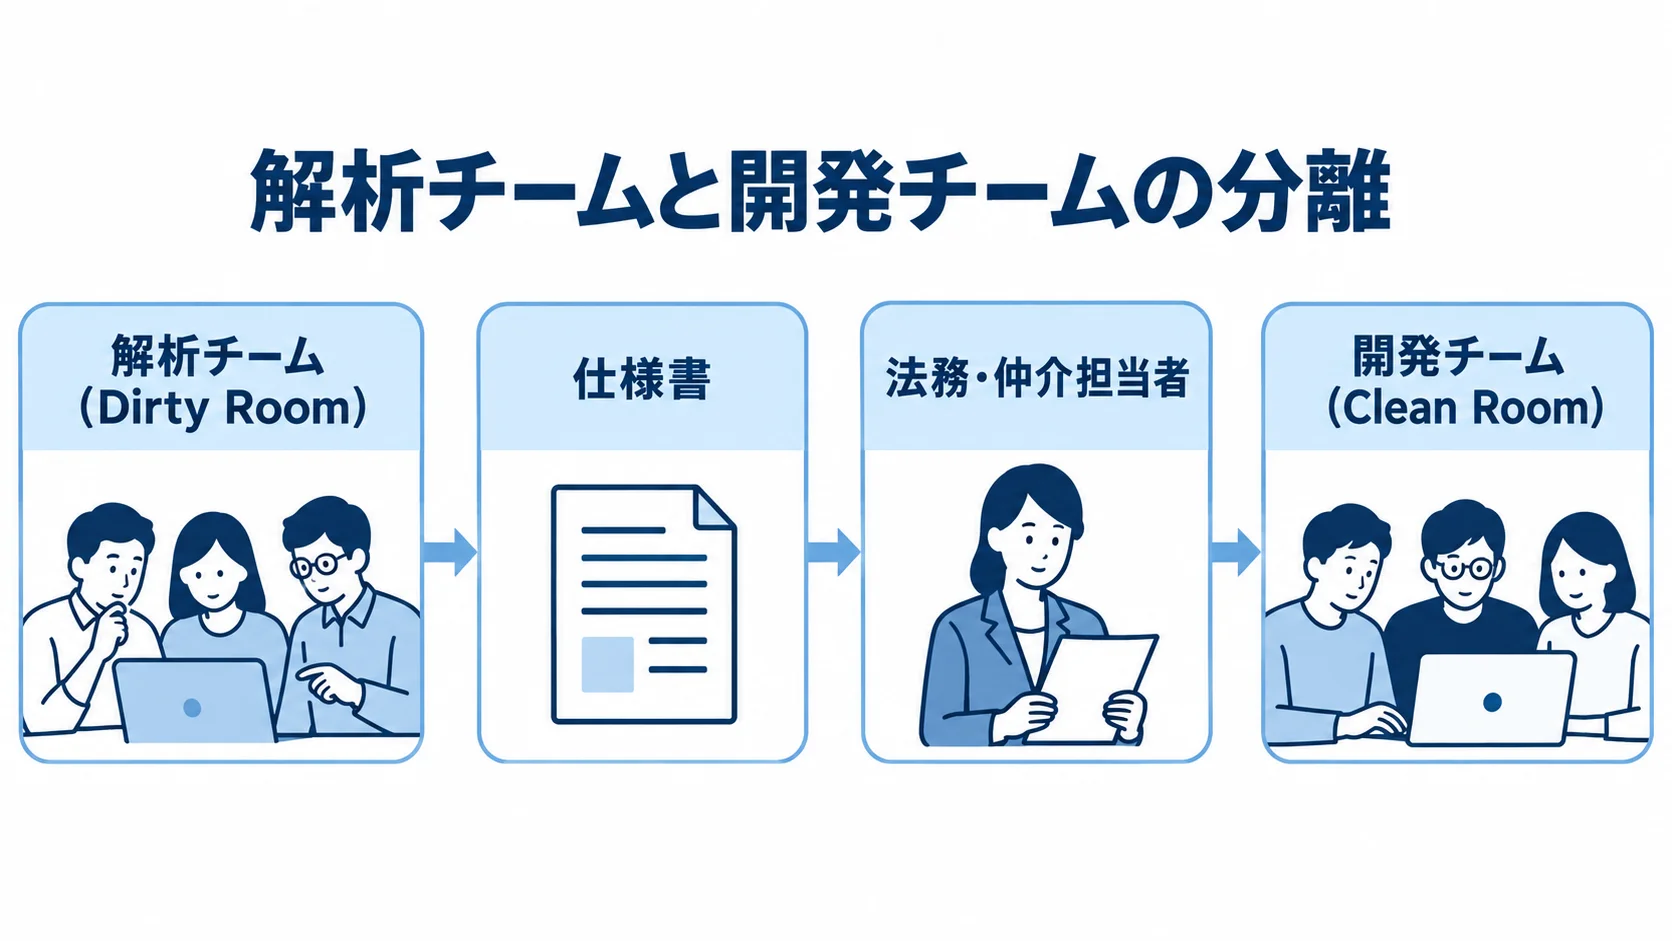
クリーンルーム手法とは、解析チーム(Dirty Room)と開発チーム(Clean Room)を完全に分け、開発チームは解析チームの作成した仕様書だけを基に新システムを開発する手法です。これにより、著作権侵害の要件である「依拠性」(元の著作物に依拠して作成したこと)を法的に否定できます。
1980 年代のフェニックス・テクノロジーズ vs IBM BIOS 訴訟で、この手法の有効性が確立されており、現在も業界のスタンダードとして採用されています。実務では、解析チームと開発チームの間に「法務・仲介担当者」を置き、仕様書に著作権で保護された「表現」が混入していないかを確認したうえで、開発チームに渡します。
セガ対アッコレード事件の教訓として、この法務フィルタリングのステップを省略すると、仕様書に元コードの「創作的表現」が残り、著作権侵害と判断されるリスクがあります。そのため、ベンダー選定の際は、外注先がこの手法を自社プロセスとして確立しているかを確かめます。
非享受目的での記録方法
平成 30 年の著作権法改正(第 30 条の 4)により、情報解析・システム開発・保守などの「非享受目的」であれば、著作物をリバースエンジニアリングすることが原則として合法になりました。ただし、「非享受目的」であったことを後から立証できる記録の残し方が大切です。
具体的には、解析専用の隔離された PC または仮想環境を用意し、解析の目的・対象・手順・結果をプロジェクト日報として記録します。加えて、解析過程で得たコードや仕様情報を業務目的以外に転用しないことを誓約する社内規程を整備し、プロジェクト参加者全員が署名することも有効な記録手段です。
外注 vs 内製の判断軸
内製で行うか外注するかは、社内の技術資源と人材状況によって大きく変わります。判断の基準は、PL/I の実務経験を持つエンジニアが社内にいるかどうかと、対象システムの業務知識が社内に備わっているかどうかの2点です。
外注が適しているケース
PL/I を扱えるエンジニアが社内にいない場合や、メインフレーム環境の運用経験が乏しい場合は、外注が現実的な選択肢になります。PL/I エンジニアは COBOL エンジニアよりも人材市場での流通量が少ないため、即戦力を採用・育成するコストと時間を考えると、専門ベンダーへの外注が総コスト面でも有利です。
クリーンルーム手法の法務プロセスを自社で構築・運用するのは体制面の負担が大きく、専門ベンダーの既存プロセスを活用するメリットもあります。
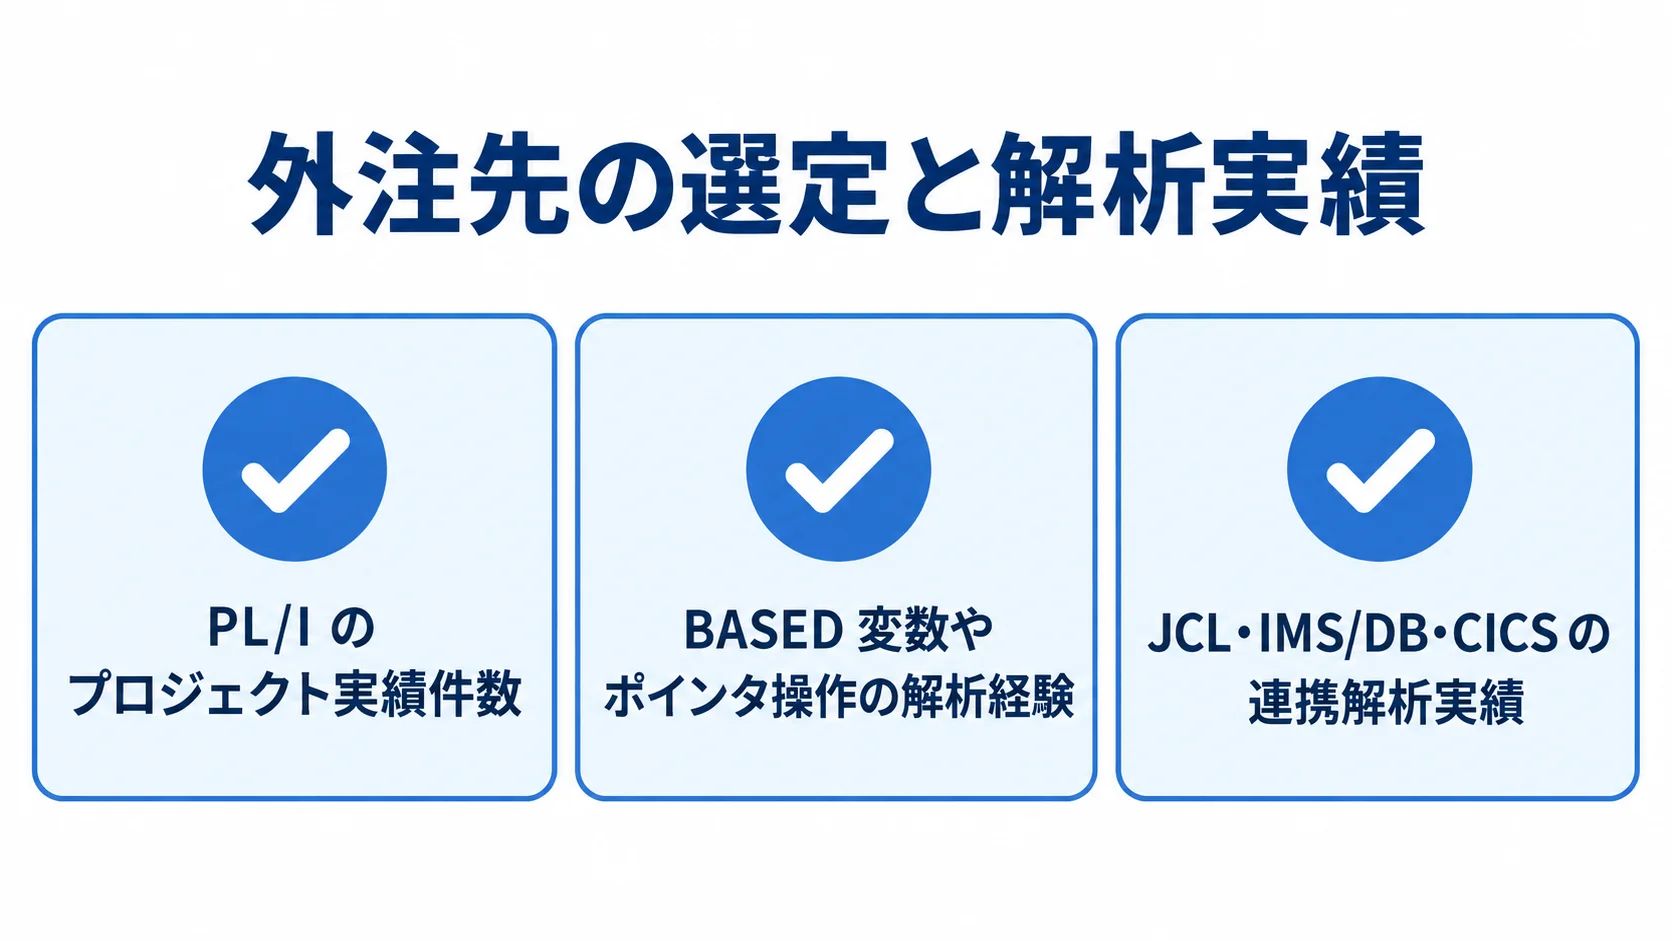
ただし、外注先の選定には十分な注意が必要です。「メインフレーム対応」を謳っていても、PL/I の実務経験がなく COBOL 中心の実績しかない会社や、CICS や IMS/DB の連携部分を扱えない会社は少なくありません。依頼前に、「PL/I のプロジェクト実績件数」「BASED 変数やポインタ操作の解析経験」「JCL・IMS/DB・CICS の連携解析実績」を具体的に確認しておくことが大切です。
内製が適しているケース
社内に PL/I の実務経験を持つシニアエンジニアがおり、対象システムの業務知識も備わっている場合は、内製でのリバースエンジニアリングが有効に機能します。特に、保険の特別料率計算や規制対応の特例処理など、業務固有の複雑なビジネスルールは、業務知識のある内部担当者でなければ正確に意味を解釈できない部分が多くあります。
外注先の技術者がいかに優秀でも、業務の意味の解釈は社内担当者の支援なしには難しいものです。そこで現実的な落とし所として、ソースコードの技術的解析・ドキュメント化は外注、業務意味の確認・補完は内部の業務部門が担当するハイブリッド体制が、多くの PL/I リバースエンジニアリング案件で採用されています。
このハイブリッド体制を成立させるには、外注先との定期レビュー会議の設計と、業務部門からの担当者のアサインを発注前に確定させておくことが成功の鍵となります。
まとめ
PL/I のリバースエンジニアリングは、COBOL 以上に専門性が求められる高難度の作業です。POINTER・BASED 変数・AREA 属性などの固有データ型や、JCL・IMS/DB・VSAM・CICS との連携部分の解析が、成功の核心にあります。
さらに、業務ロジックの「Why」を業務部門と協働で補完するプロセスも欠かせません。6 つの工程(対象選定→環境準備→静的解析→動的解析→Design Recovery→成果物化)を体系的に踏みます。そのうえで、クリーンルーム手法による法的リスク管理を並行して行うことで、保守性の高い設計書と新システム要件定義書を生み出せます。
外注と内製の判断は、社内の PL/I 技術者の有無と業務知識の深さを基準に行い、多くの場合はハイブリッド体制が現実解となります。対応できるベンダー自体が極めて少ないこの領域だからこそ、信頼できる専門パートナーを早期に選定することが、プロジェクト全体の成否を左右する最初の重要な意思決定です。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。