
Pythonのリバースエンジニアリングを外注するには、発注前の準備、発注範囲の定義、発注先の選定とRFP作成、契約、プロジェクトの推進の順に進めます。
退職者のスクリプトには業務背景が欠けていることが多く、配布形式によって工程も変わります。そのため、段階ごとに整理する内容を先に決めておきます。
▼全体ガイドの記事
・Pythonのリバースエンジニアリングの完全ガイド
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
Pythonリバースエンジニアリングを外注する前の準備
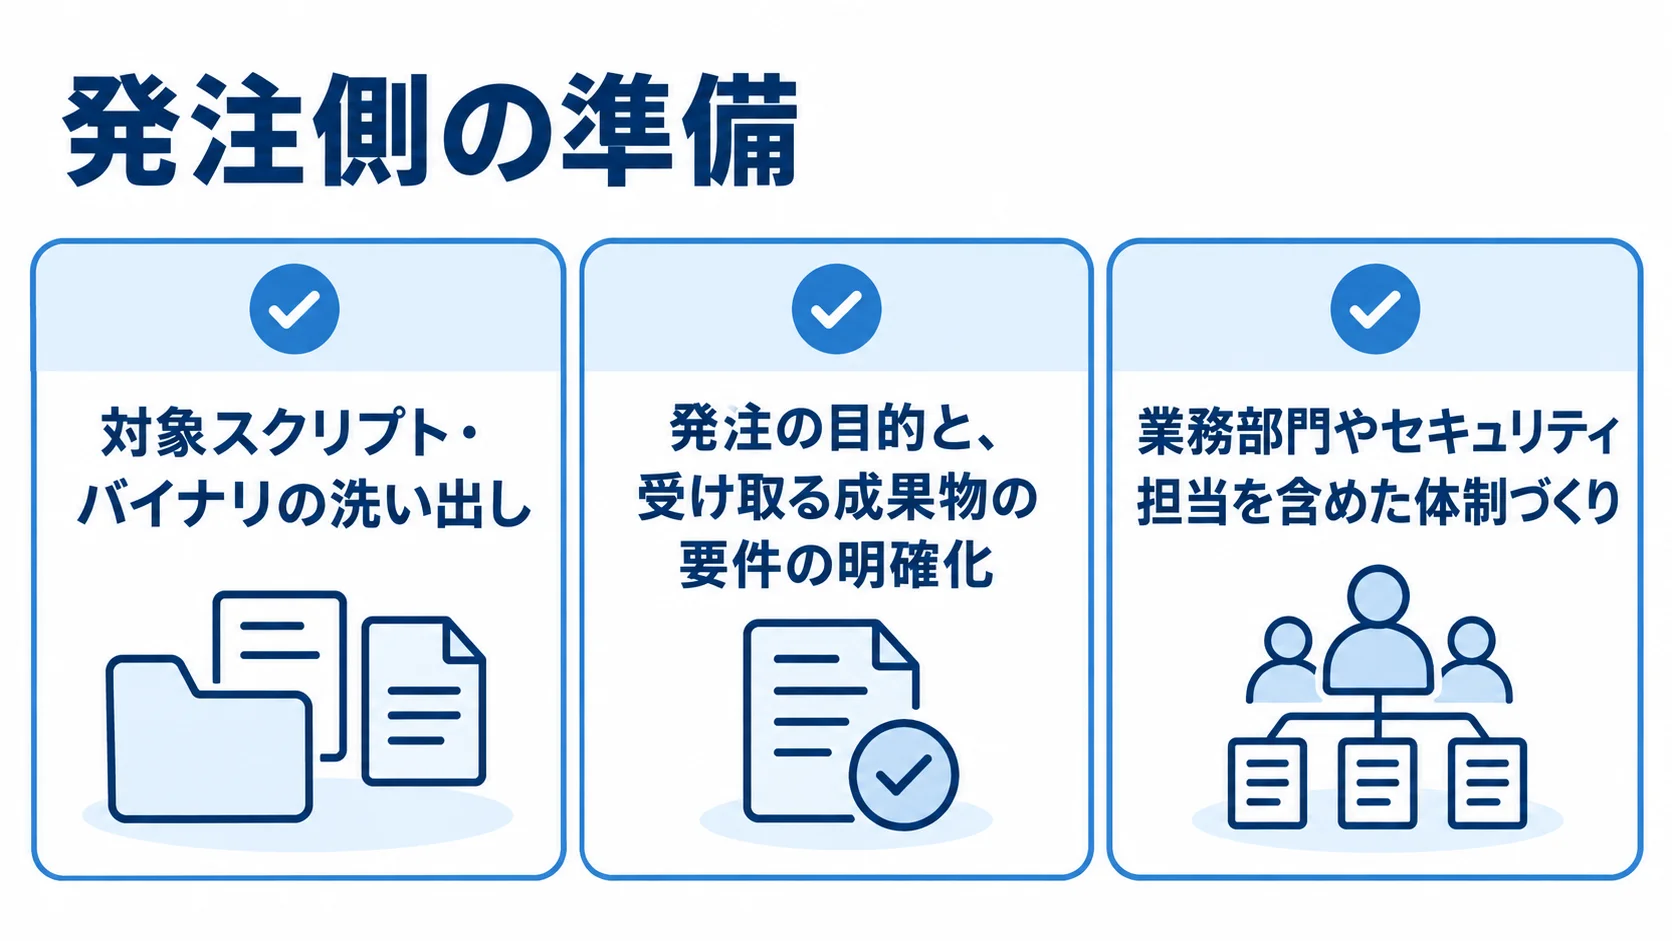
Pythonリバースエンジニアリングの外注を成功させるには、発注側の準備が欠かせません。「とにかく解析してください」という丸投げの発注は、成果物の品質低下、費用超過、期間延長の主な原因になります。
ベンダーが見積もりを立てるには、発注側が対象の範囲と成果物の要件を先に決め、社内の役割も定めておく必要があります。
- 対象スクリプト・バイナリと配布形式の洗い出し
- 発注の目的と、受け取る成果物の要件の明確化
- 業務部門やセキュリティ担当を含めた体制づくり
これら3点を事前に整理しておくと、ベンダーとのやり取りが円滑になり、プロジェクトを効率よく進められます。
対象スクリプト・バイナリの棚卸し
最初に、解析対象のPythonシステムを正確に洗い出し、次の5項目を確認します。
- 対象ファイル:.py / .pyc / EXEなどの形態
- Pythonバージョン:2.7 / 3.6 / 3.10など
- 依存ライブラリ:そのバージョン(requirements.txtがあれば共有)
- 実行環境:Windows / Linux / macOS
- 外部システムとの連携:API・DB・ファイル連携の有無
機械学習パイプラインの場合は、訓練済みモデルのファイル(.pkl / .h5 / .pt)も洗い出しの対象に加えます。洗い出しの際には、誰がどのタイミングで書いたコードかという履歴も手がかりになります。
退職した担当者のスクリプトは、コメントが少なく、変数名が省略形だったり個人の命名規則に基づいていたりするため、解析の難易度が上がります。また、複数人が長期間にわたって継ぎ足してきたスクリプトは、書かれた時期によってPythonバージョンが混在していることもあります。このような背景情報をベンダーに共有すると、より正確な見積もりが得られます。
配布形式の確認(.pyc / PyInstaller / Cython)
Pythonの配布形式は、解析の工程と費用を大きく左右します。ソースコード(.py)がそのまま手に入る場合は、難読化の解除と業務設計意図の解読が主な工程になります。
一方、PyInstallerで単一EXEにパッケージされている場合は、pyinstxtractorなどのツールでアンパックしたうえで、.pyc(コンパイル済みバイトコード)を逆コンパイルする2段階の工程が必要です。この工程は通常のPythonコード解析とは異なる専門性が求められるため、工数が1.5〜2倍程度になることがあります。
Cythonでコンパイルされた.so / .pydファイルなら、バイナリ解析ツール(Ghidra・IDA Proなど)で逆アセンブルする工程が加わります。PyArmorで保護されている場合は静的解析が難しいため、デバッガを使ったランタイムトレースなどの動的解析が中心になります。発注前にこれらの形式を正確に伝えておくと、見積もりの精度が上がり、途中の追加費用交渉を防げます。
目的と成果物要件の明確化
次に、「なぜリバースエンジニアリングを行うのか」という目的を書面にまとめます。目的によって、解析の深さや成果物の形式、期間と費用が大きく変わります。目的を書面にしないまま進めると、「ベンダーが出してきた成果物が当初期待していたものと違う」というトラブルに直結します。
主な目的には、業務仕様書の復元(担当者退職・引き継ぎ対応)、セキュリティ脆弱性の発見と対策、モダナイゼーションのための設計情報取得があります。残りは、機械学習モデル・パイプラインの移行・改良と、PyInstaller製業務ツールのソース復元です。目的を特定したら、「何を成果物として受け取るか」を具体的に定めます。
たとえば、フローチャートだけか、業務仕様書(画面遷移図・DB設計を含む)まで必要か、詳細設計書(新システム開発に即使えるレベル)まで求めるかを決めておきます。粒度が合わないと、「業務仕様書を要求したのに、フローチャートレベルしか作ってもらえなかった」というトラブルが起きます。そこで、サンプルフォーマットをRFPに添付すると、このリスクを大きく減らせます。
Python案件特有の発注範囲の定義
Pythonのリバースエンジニアリングは、COBOLやC言語などのレガシー言語とは性質が大きく異なります。そのため、発注範囲を定める前に、Python案件特有の論点を理解しておく必要があります。
特に「ソース解読」と「バイナリアンパック」は全く異なる工程で、機械学習パイプラインの解析には専門的なMLエンジニアの参加が必要になる場合もあります。
「ソース解読」と「バイナリアンパック」の違い
「ソース解読」は、.pyファイルが手元にある状態で業務ロジックを理解し、設計書や仕様書として文書化する作業です。技術的な逆コンパイルは不要で、主な工程は「コードリーディング→業務ヒアリング→設計意図の復元→ドキュメント化」です。費用相場は解析対象の行数やコードの複雑度によりますが、4,000行程度の業務スクリプトで30〜50万円が目安です。
一方、「バイナリアンパック」は、PyInstallerでパッケージされたEXEや.pycのみが手元にある状態から解析する作業です。まず、pyinstxtractorなどのツールでEXEを分解し、内包された.pycを取り出します。次に、uncompyle6やdecompyleplusなどの逆コンパイラで.pycを.pyに変換します。
ただし、変換後のコードはオリジナルのソースと完全には一致せず、変数名が失われたり、クラス構造が一部崩れたりすることがあります。この追加工程により、同じ規模のプロジェクトでも費用と期間が1.5〜2倍になるため、発注前に把握しておくことが大切です。
AIモデル・データパイプライン解析の特殊性
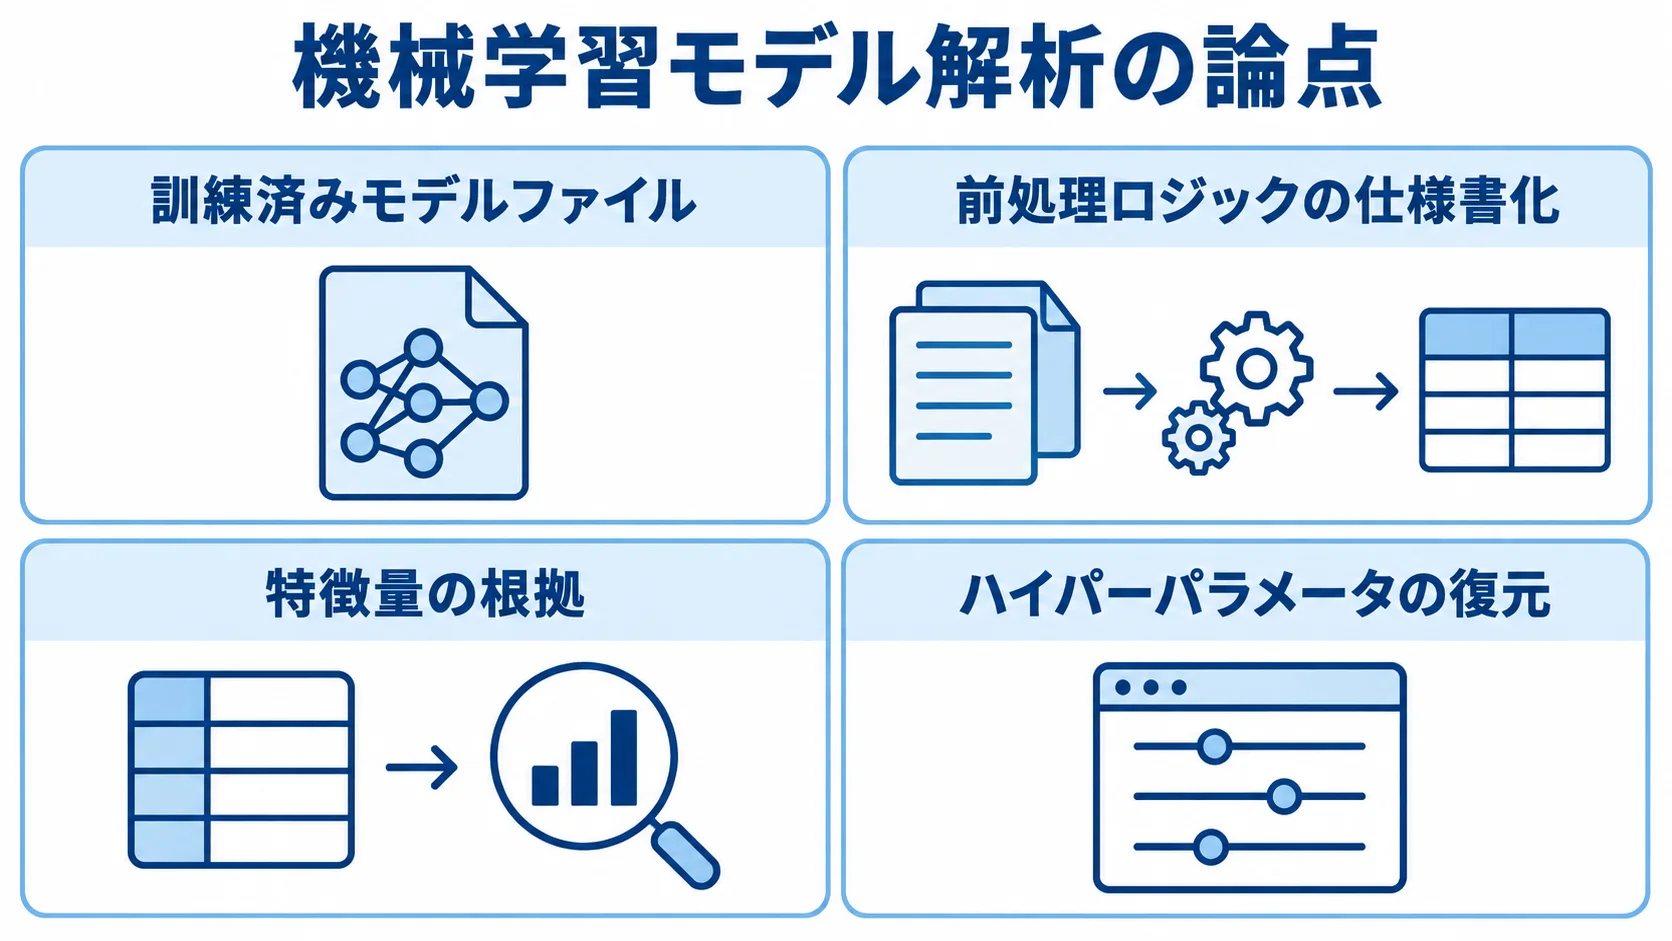
機械学習モデルやデータパイプラインの解析には、通常のPythonコード解析とは異なる専門性が必要です。典型的なのは、訓練済みモデルファイル(.pkl / .h5 / .pt)からハイパーパラメータを復元することです。ほかに、前処理ロジック(スケーリング・エンコーディング・欠損値処理のルール)の仕様書化と、特徴量の根拠(どの変数をどう組み合わせているか)の解明があります。
これには、Pythonのコードを読む力に加えて機械学習の知識も必要なため、MLエンジニアの参加を発注時に明示して求めることが欠かせません。MLエンジニアが参加しないと、「コードは読めたがなぜその特徴量を選んだのか分からない」「ハイパーパラメータの調整根拠が不明で、同じ精度でモデルを再現できない」という問題が生じます。
発注範囲には、モデルアーキテクチャの解析と前処理ロジックの仕様書化を個別項目として明記します。さらに、ハイパーパラメータの復元と評価指標の選択根拠の解明も個別項目とし、それぞれについてベンダーの対応能力(MLエンジニアの配置有無)を確認します。
発注先の選定とRFP作成
準備が整ったら、発注先の候補を絞り込み、提案依頼書(RFP:Request for Proposal)を作成して複数社に送付します。RFPは最低3社に同時に送り、提案内容を比較評価するのが基本です。
Python案件では、発注先の種類によって得意領域が異なるため、案件の性質に応じた使い分けが欠かせません。
Python系SIerとセキュリティ企業の使い分け
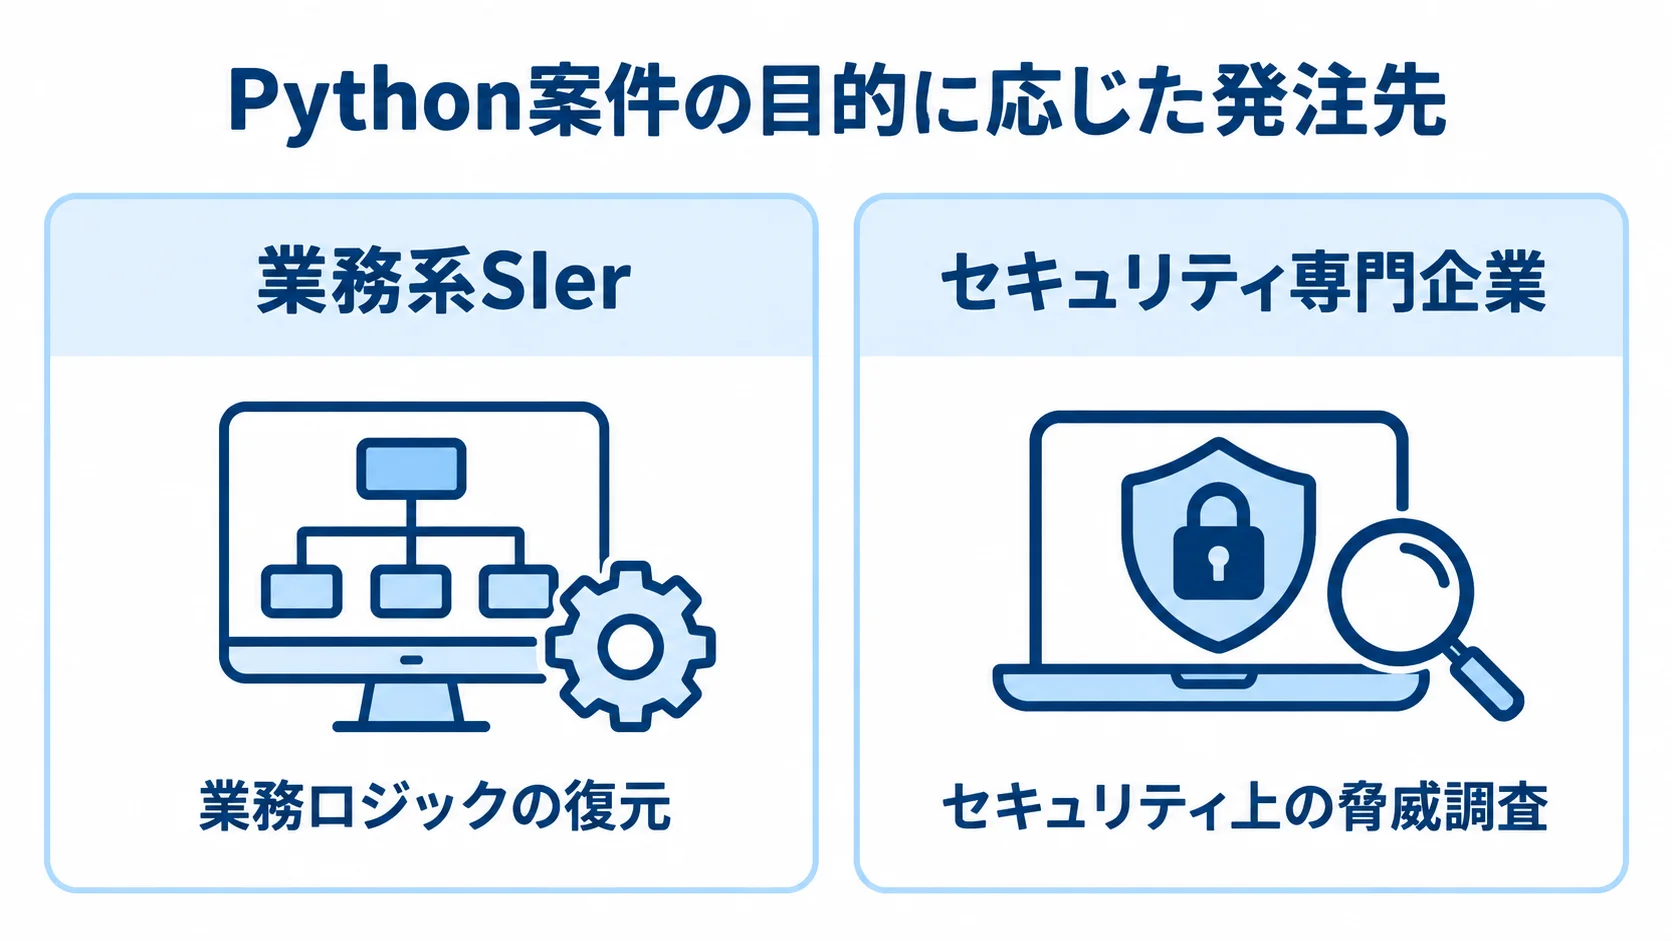
発注先は、大きく「業務系SIer」と「セキュリティ専門企業」の2種類に分けられます。業務系SIerは、業務スクリプトの仕様書復元、モダナイゼーション支援、レガシーシステムの移行設計に強みを持ちます。担当者退職後の業務Pythonスクリプトの引き継ぎや、社内自動化ツールの仕様書化など、「業務ロジックの復元」が主目的の案件はSIerへの発注が適しています。
一方で、マルウェア解析・脆弱性診断・PyInstaller製の不審な実行ファイルの解析など、「セキュリティ上の脅威調査」が目的の案件は、セキュリティ専門企業への発注が適しています。機械学習パイプラインの解析は、どちらにも明確に当てはまりません。そのため、PythonとMLの両方に実績のある会社を選ぶ必要があります。
選定時は、実績と体制の両面を必ず確認します。実績面では、Pythonのリバースエンジニアリングの件数と業種、詳細設計書まで作成した実績を見ます。体制面では、クリーンルーム手法を自社プロセスとして運用しているか、MLエンジニアが社内に在籍しているかを押さえます。
RFPのPython固有記載事項(実行環境・依存ライブラリ)
一般的なシステム開発RFPの項目に加えて、Python固有の情報を必ず記載します。
- 対象システムの形態:.py / .pyc / PyInstaller EXE / Cython拡張 / PyArmor保護
- Pythonバージョンと依存ライブラリ:requirements.txtやPipfile.lockのリスト
- 解析対象の規模と既存ドキュメント:ファイル数とコード行数の概算、README・コメント・設計書の残存状況
- 解析環境の制約:オンプレミスか、クラウドへのデータ転送が可か
- 機械学習の条件:モデルの種類(PyTorch / TensorFlow / scikit-learn等)、訓練データへのアクセス可否、精度・AUCなどの目標値
依存ライブラリのバージョンは特に重要です。たとえば、Django 1.x系で構築されたWebアプリのスクリプトと4.x系のものでは、記述パターンが大きく異なります。
scikit-learn 0.20系と1.0系では、APIの変更で同じコードが動かないこともあります。このような差異は解析工数に直接影響するため、requirements.txtがない場合も、判明している範囲でバージョンを書いておきます。
契約・法的リスク管理
Pythonリバースエンジニアリングの契約では、システム開発の一般的な条項に加えて、著作権法に特化した条項が必要です。解析対象に、EULAでリバースエンジニアリングを禁止する第三者製品が含まれる場合は、そのリスクをベンダーと共有し、法律専門家の見解を得てから進めます。
NDA・クリーンルーム手法の条項
NDA(秘密保持契約)に加えて盛り込む条項は、次のとおりです。まずは、クリーンルーム手法の適用(解析チームと開発チームの分離、法務仲介担当者の配置義務)と、解析過程の記録・保管義務(著作権法第30条の4の非享受目的を事後的に立証するため)です。
残りは、解析専用環境の使用義務(専用パソコン・インターネット非接続環境での実施)と、成果物の著作権帰属(発注側への完全移転か、ベンダーとの共有か)です。クリーンルーム手法とは、解析チーム(ダーティルーム)と開発チーム(クリーンルーム)を完全に分離し、両者の間に法務担当者を配置する手法です。
解析チームが作成した仕様書を法務担当者がチェックして、著作権保護対象の「表現」が混入していないことを確認した上で、開発チームに渡します。1980年代のフェニックス・テクノロジーズ対IBMのBIOS互換訴訟でその有効性が実証されており、現在でも著作権侵害リスクの回避手段として広く用いられています。
OSSライセンス(MIT / Apache / GPL)の整理
Pythonはオープンソースライブラリが豊富で、多くのシステムでnumpy・pandas・Djangoなどが使われています。ほかにも、FastAPI・scikit-learn・PyTorchなども広く使われています。リバースエンジニアリングの成果物を新システムに使う場合は、OSSのライセンス条件が利用方法に影響します。
MITライセンスやApache 2.0ライセンスは比較的自由度が高い一方、GPLライセンスは、コードを組み込むと派生物のソースコード公開が求められる場合があります。特にGPL v2/v3のライブラリを組み込んでいると、解析した仕様書をもとに新システムを開発する際にGPL汚染が生じる可能性があります。
発注前に、解析対象システムで使われているOSSのライセンスを一覧にしておくことが大切です。そのうえで、ベンダーには「解析成果物にOSSの著作物が混入しない形での成果物作成」を条件として明記します。OSSライセンスの整理支援を作業範囲に含めるかどうかは、RFPの段階で確認することが推奨されます。
プロジェクト推進とよくあるトラブル
Pythonリバースエンジニアリングを成功させるには、業務部門・IT部門・ベンダーの3者が役割を分担して連携することが欠かせません。
発注側とベンダー双方の準備不足や認識のずれから、特定のトラブルパターンが繰り返されています。そのため、主要なトラブルと回避策を事前に把握しておくことが大切です。
業務ロジックのWhy復元のための業務部門協力
「コードは読めたが業務ルールの意図が分からず、移行後にバグが多発した」というトラブルは、最も深刻な失敗パターンです。Pythonの自動化スクリプトや機械学習パイプラインには、担当者が暗黙知として持っていた特殊なデータ処理ルールが埋め込まれており、コードから業務背景を読み取るのは難しいです。データサイエンティストが退職した後の機械学習パイプラインでは、このリスクが特に高くなります。
「特定の顧客コードへの例外処理」「季節性を考慮した分岐条件」「データクレンジングの特殊ルール」は、コードの外観からは理解できないことが多いです。回避策の第一は、業務部門の巻き込みを発注前に確定させることです。業務部門の有識者が解析期間中のヒアリングに協力できる体制(週1回程度・1〜2時間のセッション)を整えずに発注すると、ベンダーは「このコードの意図が不明で確認が取れない」状態で止まります。
第二は、退職した元担当者へのヒアリングが可能かを事前に確認し、在籍していた期間の業務ロジックの意図を把握できれば、成果物の品質が大幅に上がります。第三は、解析中の不明点リストをベンダーから週次で共有してもらう仕組みを、プロジェクト開始時に設けることです。これにより、不明点が積み残されたまま解析が進むのを防げます。
ライブラリバージョン差異による工数膨張対策
Pythonプロジェクトでは、ライブラリのバージョン差異による工数膨張も多く報告されています。古いPythonバージョン(たとえばPython 2.7や3.5系)で動くシステムは、現代の解析環境と互換性がないため、専用環境の構築工程が発生します。依存ライブラリのバージョンが特定されていないと、解析者が挙動差異を試行錯誤で調べる工数が加わります。
対策として最も有効なのは、発注前に可能な範囲でrequirements.txtや依存ライブラリのバージョン情報を集めておくことです。それが困難な場合は、解析対象のシステムが稼働する本番環境に接続して「pip freeze」でライブラリ一覧を出力できないか、ベンダーと協力して確認します。
契約時には、バージョン差異に起因する追加工数の上限(キャップ)または変更管理プロセスを条項として設けておくと、見積もり外の追加費用が発生した際の対応を事前に合意できます。また、PyInstaller製バイナリのアンパック時にPythonバージョンが不明な場合は、その特定作業を独立した工程として発注範囲に含めるよう設計します。
まとめ
Pythonのリバースエンジニアリングを外注で成功させるには、まず発注前の準備が出発点です。対象スクリプト・バイナリの洗い出し、配布形式(.pyc / PyInstaller / Cython)の確認、目的と成果物要件の明確化を徹底します。
Pythonはソースコードが読める場合でも、退職した担当者のスクリプトには業務背景が欠けていることが多く、この「Why」の復元には業務部門の協力が欠かせません。
発注範囲の定義では、「ソース解読」と「バイナリアンパック」の違いを正しく把握します。そのうえで、機械学習パイプラインの解析には、MLエンジニアの参加を発注時に明示して求めることが大切です。
発注先は、業務ロジックの復元が主目的なら業務系SIer、セキュリティ調査が主目的ならセキュリティ専門企業を選びます。RFPには、Pythonの実行環境・依存ライブラリ・配布形式を具体的に記載します。
契約では、NDAに加えてクリーンルーム手法の適用と解析過程の記録義務を明記します。OSSライセンスの整理と成果物の著作権帰属も定めます。さらに、ライブラリバージョン差異に起因する追加工数の変更管理プロセスを合意しておくことで、プロジェクトを成功に導けます。
▼開発を相談する前に読みたい無料ホワイトペーパーはこちらをご覧ください。
・【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。